

Introduktion til operativsystemer
Hej, Habr! Jeg vil gerne præsentere for dig en serie af artikeloversættelser af en interessant litteratur — OSTEP. Dette materiale undersøger grundigt, hvordan unix-lignende operativsystemer fungerer, nemlig hvordan man arbejder med processer, forskellige scheduler, hukommelse og andre lignende komponenter, der udgør et moderne OS. Originalen af alt materiale kan du se her . Vær opmærksom på, at oversættelsen er lavet uprofessionelt (temmelig frit), men jeg håber, at jeg har bevaret den overordnede mening.
Laboratoriearbejder om dette emne kan findes her:
Andre dele:
Og du kan også tjekke min kanal på =)
Introduktion til scheduler
Kernen af problemet: Hvordan man udvikler en scheduler politik
Hvordan bør de grundlæggende rammer for schedulerpolitikker udvikles? Hvilke nøgleforudsætninger skal der være? Hvilke metrikker er vigtige? Hvilke grundlæggende teknikker blev brugt i tidlige computersystemer?
Forudsætninger for arbejdsbelastning
Før vi diskuterer mulige politikker, lad os først lave nogle forsimplede oplysninger om de processer, der kører i systemet, som tilsammen kaldes arbejdsbelastning. Når man definerer arbejdsbelastning som en kritisk del af udviklingen af politikker, jo mere du ved om belastningen, desto bedre politik kan du skrive.
Lad os gøre følgende antagelser om de processer, der kører i systemet, nogle gange også kaldet jobs (opgaver). Næsten alle disse antagelser er urealistiske, men nødvendige for at udvikle tankerne.
- Hver opgave kører i samme mængde tid,
- Alle opgaver startes samtidigt,
- Den anlagte opgave kører indtil sin afslutning,
- Alle opgaver bruger kun CPU,
- Tidspunktet for hver opgaves udførelse er kendt.
Scheduler-metrikker
Udover nogle antagelser om belastningen er der også brug for et værktøj til at sammenligne forskellige scheduling-politikker: scheduler-metrikker. En metrik er bare et mål for noget. Der findes et antal metrikker, der kan bruges til at sammenligne schedulere.
Som eksempel vil vi bruge en metrik, der hedder omvendelsestid (turnaround time). Omvendelsestiden for en opgave defineres som forskellen mellem afslutningstidspunktet for opgaven og tidspunktet for, hvornår opgaven kom ind i systemet.
Tturnaround=Tcompletion−Tarrival
Da vi antog, at alle opgaver ankom på én gang, er Ta=0 og dermed Tt=Tc. Dette værdien vil naturligvis ændre sig, når vi ændrer ovenstående antagelser.
En anden metrik — fairness (retfærdighed, ærlighed). Ydeevne og retfærdighed er ofte modstridende egenskaber i planlægning. For eksempel kan en planlægger optimere ydeevnen, men på bekostning af ventetid for andre opgaver, hvilket reducerer retfærdigheden.
FIRST IN FIRST OUT (FIFO)
Den mest grundlæggende algoritme, vi kan implementere, kaldes FIFO eller first come (in), first served (out). Denne algoritme har flere fordele: den er meget enkel at implementere, og den lever op til alle vores antagelser, hvilket resulterer i en god ydeevne.
Lad os se på et simpelt eksempel. Antag, at 3 opgaver blev indsendt samtidig. Men lad os antage, at opgave A kom lidt før de andre, så den vil stå øverst på udførelseslisten, ligesom B i forhold til V. Antag, at hver af dem vil blive udført i 10 sekunder. Hvad vil gennemsnitstiden for disse opgaver være?
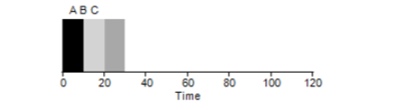
Ved at tælle værdierne — 10+20+30 og dividere med 3, får vi en gennemsnitlig udførelsestid for programmet på 20 sekunder.
Lad os nu prøve at ændre vores antagelser. Specifikt antagelse 1, og vi vil ikke længere antage, at hver opgave udføres i samme tidsrum. Hvordan vil FIFO klare sig denne gang?
Som det viser sig, har forskellige udførelsestider for opgaverne en meget negativ indvirkning på produktiviteten af FIFO-algoritmen. Antag, at opgave A vil køre i 100 sekunder, mens B og V fortsat kører i 10 sekunder hver.
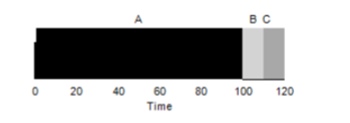
Som illustreret i diagrammet, vil den gennemsnitlige tid for systemet være (100+110+120)/3=110. Denne effekt kaldes konvoieffekten, hvor nogle kortvarige forbrugere af en ressource skal stå i kø bag en tung forbruger. Det ligner en kø i supermarkedet, når der er en kunde foran dig med en fyldt vogn. Den bedste løsning på problemet er at prøve at skifte kasse eller tage det roligt og trække vejret dybt.
Shortest Job First
Er der en måde at løse en sådan situation med tunge processer? Selvfølgelig. En anden type planlægning kaldesShortest Job First (SJF). Dets algoritme er også ret primitivt - som navnet antyder, vil de korteste opgaver blive kørt først, én ad gangen.
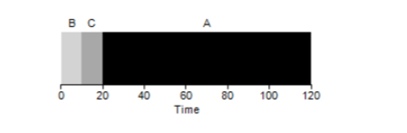
I dette eksempel vil resultatet af at køre de samme processer forbedre den gennemsnitlige programcyklus og vil være lig med 50 i stedet for 110, hvilket er praktisk talt dobbelt så godt.
Derfor, under den givne antagelse om, at alle opgaver ankommer på samme tid, virker SJF-algoritmen som den mest optimale algoritme. Men vores antagelser synes stadig ikke realistiske. Denne gang vil vi ændre antagelse 2 og forestille os, at opgaverne kan ankomme når som helst, ikke alle samtidig. Hvilke problemer kan dette føre til?
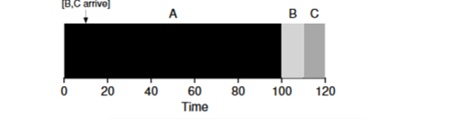
Lad os sige, at opgave A (100s) ankommer først og begynder at køre. På tidspunktet t=10 ankommer opgaverne B, C, som hver vil tage 10 sekunder. Gennemsnitlig køretid er derfor (100+(110-10)+(120-10))3 = 103. Hvad kunne planlæggeren gøre for at forbedre situationen?
Shortest Time-to-Completion First (STCF)
For at forbedre situationen vil vi droppe antagelse 3 om, at programmet kører og fungerer til det er færdigt. Derudover har vi brug for hardwareunderstøttelse, og som du måske har gættet, vil vi bruge en timer til at afbryde den kørende opgave og skifte kontekster. Således kan planlæggeren tage skridt, når opgaverne B, C kommer ind - stoppe udførelsen af opgave A og sætte opgaverne B og C i behandling, og efter deres afslutning fortsætte med at køre proces A. Sådan en planlægger kaldes STCFeller Preemptive Job First.
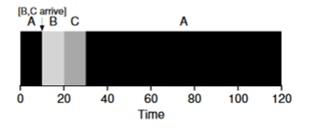
Resultatet af denne planlægers arbejde vil være: ((120-0)+(20-10)+(30-10)) / 3 = 50. Således bliver en sådan planlægger endnu mere optimal til vores opgaver.
Metrik Reaktionstid (Response Time)
Derfor, hvis vi kender tiden for opgavernes arbejde og ved, at disse opgaver kun bruger CPU, vil STCF være den bedste løsning. Og engang i de tidlige dage fungerede disse algoritmer ganske godt. Men nu bruger brugeren det meste af tiden foran terminalen og forventer et produktivt interaktivt samspil. Således blev den nye metrik - respons tid (reaktionstid) født.
Reaktionstid beregnes som følgende:
Tresponse = Tfirstrun − Tarrival
Således vil responstiden for det tidligere eksempel være: A=0, B=0, C=10 (abg=3,33).
Det viser sig, at STCF-algoritmen ikke er så god i situationer, hvor 3 opgaver ankommer samtidig — den skal vente, indtil de små opgaver er helt afsluttet. På denne måde er algoritmen god til måling af turnaround-tid, men dårlig til interaktivitet. Forestil dig, at du, mens du sidder ved terminalen og forsøger at indtaste tegn i editoren, skal vente mere end 10 sekunder, fordi en anden opgave optager processoren. Det er ikke særlig behageligt.
På denne måde står vi overfor et andet problem — hvordan kan vi bygge en scheduler, der er responsiv?
Round Robin
For at løse dette problem blev der udviklet en algoritme Round Robin (RR). Grundideen er ret enkel: I stedet for at køre opgaverne til de er helt afsluttet, vil vi køre en opgave i et bestemt tidsrum (kendt som et tidskvant), og derefter skifte til en anden opgave i køen. Algoritmen gentager sit arbejde, indtil alle opgaver er afsluttet. Her skal programmet køre i intervaller, der er et multiplum af den tid, hvor timeren vil forstyrre processen. For eksempel, hvis timeren underbryder processen hvert x=10 ms, så skal størrelsen af udførelsesvinduet være et multiplum af 10 og være 10, 20 eller x*10.
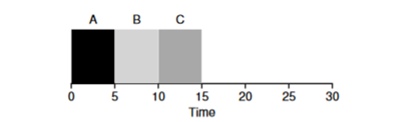
Lad os overveje et eksempel: Opgaverne ABC ankommer samtidig til systemet, og hver ønsker at arbejde i 5 sekunder. SJF-algoritmen vil fuldføre hver opgave, inden den starter en anden. I modsætning til det vil RR-algoritmen med et vindue på 1 sekunde gennemgå opgaverne på følgende måde (se fig. 4.3):
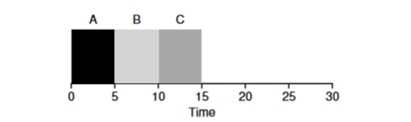
(SJF Igen (Dårlig for responstid)
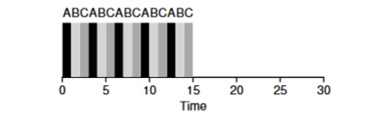
(Round Robin (God for responstid)
Den gennemsnitlige responstid for RR-algoritmen (0+1+2) / 3 = 1, mens det for SJF (0+5+10) / 3 = 5.
Det er logisk at antage, at tidsvinduet er en meget vigtig parameter for RR; jo mindre det er, desto hurtigere er svartiden. Dog kan det ikke være for lille, da tiden til kontekstskift også spiller en rolle i den samlede ydeevne. Valget af udførelsestidspunkt bestemmes derfor af OS-arkitekten og afhænger af de opgaver, der planlægges at blive udført. Kontekstskift er ikke den eneste operation, der bruger tid — det kørende program håndterer også mange andre aspekter, såsom forskellige caches, og ved hvert skift skal dette miljø gemmes og gendannes, hvilket også kan kræve meget tid.
RR er en fremragende planlægger, hvis det kun handler om svartidsmetrik. Men hvordan vil opgavens gennemløbstid opføre sig med denne algoritme? Lad os overveje eksemplet ovenfor, hvor A, B og C kører i 5 sekunder og ankommer på samme tid. Opgave A slutter kl. 13, B kl. 14 og C kl. 15, hvilket giver en gennemsnitlig gennemløbstid på 14 sekunder. Dermed er RR den dårligste algoritme for gennemløbsmetrikken.
Med andre ord er enhver RR-agtig algoritme retfærdig; den deler CPU-tiden ligeligt mellem alle processer. På den måde er disse metrikker i konstant konflikt med hinanden.
Derfor har vi flere modsatrettede algoritmer, og der er stadig nogle antagelser — om at opgavernes tid er kendt, og at opgaven kun bruger CPU.
Blanding med I/O
For det første fjerner vi antagelse 4, at processen kun bruger CPU, hvilket ikke er tilfældet, da processer også kan interagere med andet udstyr.
Når en proces anmoder om en input/output-operation, skifter den til en blokeret tilstand, mens den venter på, at I/O skal afsluttes. Hvis I/O sendes til harddisken, kan denne operation tage op til flere millisekunder eller længere, og CPU’en vil være inaktiv i mellemtiden. I denne tid kan planlæggeren optage CPU’en med en anden proces. Den næste beslutning planlæggeren skal træffe er, hvornår processen afslutter sin I/O. Når det sker, vil der være et afbrydelse, og OS vil ændre den proces, der har anmodet om I/O, til klar tilstand.
Lad os se på et eksempel med flere opgaver. Hver enkelt kræver 50 ms processtid. Men den første vil kalde I/O hvert 10. ms (som også vil køre hver 10. ms). Proces B bruger blot 50 ms proces uden I/O.
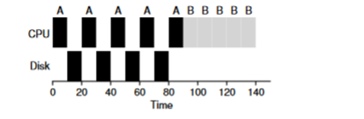
I dette eksempel vil vi bruge STCF-planlæggeren. Hvordan vil planlæggeren reagerer, når proces A køres? Den vil handle på følgende måde — først køre proces A helt færdig, og derefter proces B.
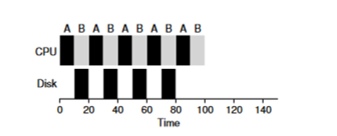
Den traditionelle tilgang til at løse dette problem er at fortolke hver 10 ms underopgave af proces A som en separat opgave. Således, når man starter med STJF-algoritmen, er valget mellem den 50 ms opgave og den 10 ms opgave åbenlyst. Når underopgaven A er færdig, vil proces B og I/O blive startet. Efter afslutningen af I/O, vil der blive taget beslutning om at starte den 10 ms proces A igen i stedet for proces B. På den måde er det muligt at implementere overlapping, hvor CPU brugen er i gang med en anden proces, mens den første venter på I/O. Og i sidste ende udnyttes systemet bedre — i det øjeblik hvor interaktive processer venter på I/O, kan andre processer køre på CPU'en.
Oraklet er ikke længere.
Lad os nu forsøge at slippe af med antagelsen om, at tidsforbruget for en opgave er kendt. Dette er generelt den værste og mest urealistiske antagelse på listen. Faktisk ved normale operativsystemer generelt meget lidt om, hvor lang tid opgaverne tager at udføre. Hvordan kan vi så bygge en planlægger uden at vide, hvor lang tid en opgave vil tage? Måske kunne vi bruge nogle principper fra RR til at løse dette problem?
Resultat
Vi har gennemgået de grundlæggende ideer om opgaveplanlægning og set på to familier af planlæggere. Den første kører den korteste opgave først og dermed øger gennemløbstiden, mens den anden deler tiden ligeligt mellem alle opgaver og dermed forbedrer svartiden. Begge algoritmer er dårlige, hvor den anden families algoritmer er gode. Vi har også set hvordan parallel brug af CPU og I/O kan forbedre ydelsen, men har ikke løst problemet med operativsystemets forudseenhed. I næste session vil vi se på en planlægger, der ser i den nærmeste fortid og forsøger at forudsige fremtiden. Den kaldes multi-level feedback queue.
Kilde: habr.com
