

Hvis man bruger en tidsserie-database (timeseries db, ) som det primære lager til en statistik hjemmeside, kan man få mange problemer i stedet for at løse opgaven. Jeg arbejder på et projekt, hvor en sådan database anvendes, og nogle gange har InfluxDB, som vil blive omtalt, givet helt uventede overraskelser.
Ansvarsfraskrivelse: de nævnte problemer relaterer sig til version InfluxDB 1.7.4.
Hvorfor tidsserie?
Projektet går ud på at spore transaktioner i forskellige blockchains og vise statistikker. Konkret - vi ser på emission og forbrænding af stablecoins (). Baseret på disse transaktioner skal der opbygges grafer og vises oversigtstabeller.
Ved analysen af transaktioner kom idéen om at bruge tidsserie-databasen InfluxDB som det primære lager. Transaktioner er punkter i tiden og passer godt ind i tidsserie-modellen.
Desuden så funktionerne til aggregering ganske praktiske ud - de er perfekte til behandling af grafer over lange perioder. Brugeren har brug for en graf for et år, men databasen har et datasæt med et tidsinterval på fem minutter. At sende alle hundrede tusinde punkter ville være meningsløst - udover den lange behandling kan de heller ikke vises på skærmen. Man kan skrive sin egen implementering af tidsintervalsforøgelse eller bruge de indbyggede aggregeringsfunktioner i Influx. Med deres hjælp kan data grupperes pr. dag, og de nødvendige 365 punkter kan sendes.
Det forvirrede lidt, at sådanne databaser normalt anvendes med det formål at indsamle metrics. Overvågning af servere, IoT-enheder, alt hvad der 'strømmer' millioner af punkter som: [<tid> — <metrics værdi>]. Men hvis databasen fungerer godt med store datamængder, hvorfor skulle et lille volumne så skabe problemer? Med denne tanke begyndte vi at implementere InfluxDB.
Hvad andet er praktisk ved InfluxDB
Udover de nævnte aggregeringsfunktioner er der endnu en fantastisk ting - continuous queries (). Det er en indbygget planlægger i databasen, der kan behandle data efter en tidsplan. For eksempel kan man hver 24. time gruppere alle optegnelser for dagen, beregne gennemsnittet og skrive et nyt punkt ind i en anden tabel uden at skrive sine egne løsninger.
Der er også retention policies () — indstilling af sletning af data efter en bestemt periode. Nyttefuld, når man f.eks. skal opbevare CPU-belastning i en uge med målinger hvert sekund, men sådan præcision ikke er nødvendig over en periode på par måneder. I sådan en situation kan man gøre sådan:
- oprette en kontinuerlig forespørgsel til aggregering af data i en anden tabel;
- for den første tabel definere en politik for sletning af metrics, der er ældre end den nævnte uge.
Og Influx vil automatisk reducere datastørrelsen og slette det unødvendige.
Om de gemte data
Der gemmes ikke mange data: omkring 70.000 transaktioner og yderligere en million punkter med markedsinformation. Tilføjelse af nye poster — højst 3000 punkter om dagen. Der er også metrics for webstedet, men der er ikke mange data, og ifølge retention-policy opbevares de ikke længere end en måned.
Problemer
Under udvikling og efterfølgende test af tjenesten opstod der gradvist mere og mere kritiske problemer ved brugen af InfluxDB.
1. Sletning af data
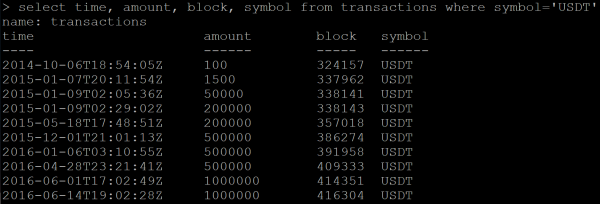
Der er en dataserie med transaktioner:
SELECT time, amount, block, symbol FROM transactions WHERE symbol='USDT'Resultat:
Sender kommandoen til sletning af data:
DELETE FROM transactions WHERE symbol='USDT'Derefter laver jeg en forespørgsel for at få de allerede slettede data. Og Influx returnerer i stedet for et tomt svar en del af de data, der skulle være slettet.
Prøver at slette tabellen helt:
DROP MEASUREMENT transactionsTjekker sletningen af tabellen:
SHOW MEASUREMENTSJeg kan ikke se tabellen på listen, men en ny dat forespørgsel returnerer stadig det samme sæt transaktioner.
Problemet opstod kun én gang for mig, da situationen med sletning er en enestående begivenhed. Men denne opførsel i databasen passer tydeligvis ikke ind i rammerne for «korrekt» funktion. Senere fandt jeg på GitHub en åbent problem fra næsten et år siden om dette emne.
Som følge heraf hjalp det at slette og derefter genoprette hele databasen.
2. Flydende tal
Matematiske beregninger ved brug af de indbyggede InfluxDB-funktioner giver præcisionsfejl. Det er ikke noget usædvanligt, men ubehageligt.
I mit tilfælde har dataene en finansiel dimension, og jeg ville gerne behandle dem med høj præcision. På grund af dette planlægger jeg at fravælge kontinuerlige forespørgsler.
3. Kontinuerlige forespørgsler kan ikke tilpasses til forskellige tidszoner
Tjenesten har en tabel med daglige transaktionsstatistikker. For hver dag skal alle transaktioner for den dag grupperes. Men dagen starter på forskellige tidspunkter for hver bruger, og derfor vil datasættet over transaktioner også variere. Ifølge UTC er der for forskydninger, hvor data skal aggregeres.
I InfluxDB kan man angive en forskydning ved gruppering efter tid, for eksempel for Moskva-tid (UTC+3):
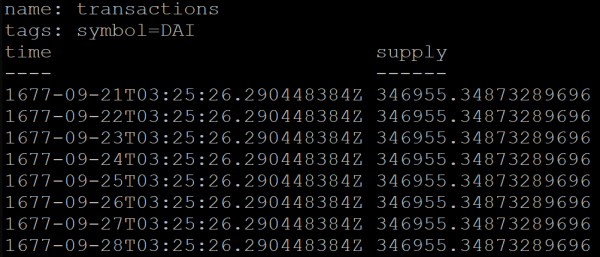
SELECT MEAN("supply") FROM transactions GROUP BY symbol, time(1d, 3h) fill(previous)Men resultatet af forespørgslen vil være ukorrekt. Af en eller annen grund vil de dagligt grupperede data starte helt tilbage i 1677 (InfluxDB understøtter officielt tidsperioden fra det år):
For at omgå dette problem er tjenesten midlertidigt overført til UTC+0.
4. Ydeevne
Der er mange benchmarks på internettet, der sammenligner InfluxDB med andre databaser. Ved første øjekast så de ud som marketingmateriale, men nu mener jeg, at der er en vis sandhed i dem.
Jeg vil fortælle om min sag.
Tjenesten tilbyder en API-metode, der returnerer statistikken for de sidste 24 timer. Ved beregningerne anmoder metoden databasen tre gange med følgende forespørgsler:
SELECT * FROM coins_info WHERE time <= NOW() GROUP BY symbol ORDER BY time DESC LIMIT 1SELECT * FROM dominance_info ORDER BY time DESC LIMIT 1SELECT * FROM transactions WHERE time >= NOW() - 24h ORDER BY time DESCForklaring:
- I den første forespørgsel får vi de sidste punkter for hver mønt med markedsdata. I mit tilfælde otte punkter for otte mønter.
- Den anden forespørgsel får det nyeste punkt.
- Den tredje forespørgsel anmoder om en liste over transaktioner for de sidste 24 timer; der kan være flere hundrede.
Lad mig præcisere, at i InfluxDB opbygges indeks automatisk efter tags og tid, hvilket accelererer forespørgslerne. I den første forespørgsel symbol er et tag.
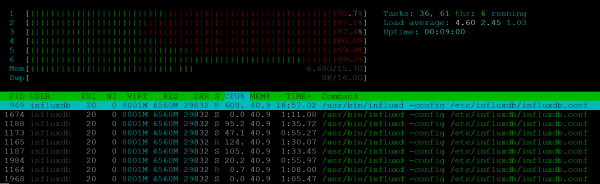
Jeg udførte en stresstest for denne API-metode. Ved 25 RPS viste serveren, at alle seks CPU'er var helt belastede:
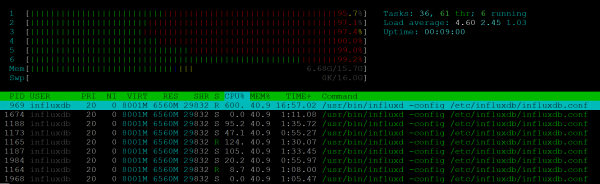
Samtidig gav NodeJs-processen overhovedet ikke belastning.
Hastigheden af udførelsen forværredes allerede ved 7-10 RPS: hvis én klient kunne få et svar på 200 ms, så måtte 10 klienter vente et sekund. 25 RPS er grænsen, hvor stabiliteten blev påvirket, og klienterne fik 500-fejl.
Med sådan ydeevne er det umuligt at bruge Influx i vores projekt. Desuden: i et projekt, hvor overvågning skal vises for mange kunder, kan der opstå lignende problemer, og metrics serveren vil blive overbelastet.
Output
Den vigtigste konklusion fra de opnåede erfaringer er, at man ikke må inkludere en ukendt teknologi i projektet uden tilstrækkelig analyse. En simpel screening af åbne tickets på GitHub kunne have givet information, der havde forhindret os i at vælge InfluxDB som den primære datalagring.
InfluxDB skulle have været godt egnet til opgaverne i mit projekt, men som praksis har vist, opfylder denne database ikke behovene og laver mange fejl.
I projektets repository kan man allerede finde version 2.0.0-beta, og man kan håbe, at der vil komme betydelige forbedringer i anden version. Imens vil jeg gå i gang med at studere dokumentationen til TimescaleDB.
Kilde: habr.com
