

I denne artikel vil vi fortælle om, hvordan og hvorfor vi har udviklet – en mekanisme, der overfører information mellem klientapplikationer og 1C:Enterprise-servere – fra opgavens formulering til design af arkitektur og implementeringsdetaljer.
Interaktionssystemet (herefter – IS) er et distribueret fejlsikkert system til meddelelsesudveksling med garanteret levering. IS er designet som en højt belastet service med høj skalerbarhed, tilgængelig både som en online service (leveret af 1C) og som et kommercielt produkt, der kan implementeres på egne serverressourcer.
IS bruger en distribueret lagringsløsning og en søgemaskine . Der vil også blive talt om Java og hvordan vi horisontalt skalerer PostgreSQL.
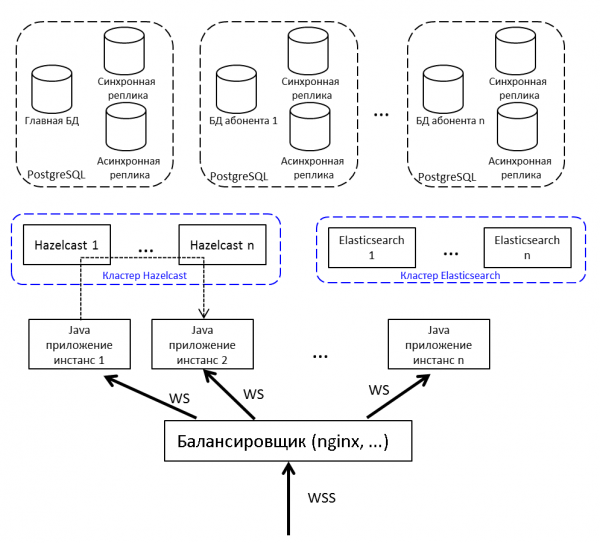
Problemformulering
For at forstå, hvorfor vi lavede Interaktionssystemet, vil jeg kort fortælle, hvordan udviklingen af forretningsapplikationer er arrangeret i 1C.
For begyndelsen – lidt om os for dem, der endnu ikke ved, hvad vi laver :) Vi udvikler den teknologiske platform "1C:Enterprise". Platformen inkluderer et udviklingsmiljø til forretningsapplikationer samt en runtime, der giver forretningsapplikationer mulighed for at arbejde i et tværplatformsmiljø.
Klient-server paradigmet for udvikling
Forretningsapplikationer, der er skrevet på "1C:Enterprise", fungerer i en trelags arkitektur "DBMS – applikationsserver – klient". Anvendelseskoden, skrevet i , kan udføres på applikationsserveren eller på klienten. Alt arbejde med anvendelsesmæssige objekter (referencer, dokumenter osv.) samt læsning og skrivning til databasen udføres kun på serveren. Funktionaliteten af formularer og kommandogrænsefladen er også implementeret på serveren. På klienten udføres modtagelse, åbning og visning af formularer, "kommunikation" med brugeren (advarsler, spørgsmål…), små beregninger i formularer, der kræver hurtig reaktion (f.eks. multiplikation af pris med mængde), arbejde med lokale filer, arbejde med hardware.
I koden for procedurer og funktioner skal man tydeligt angive, hvor koden skal udføres — ved hjælp af direktiver &НаКлиенте / &НаСервере (&AtClient / &AtServer i den engelsksprogede version af sproget). Udviklere i 1C vil nu retfærdiggøre mig ved at sige, at direktiver faktisk , men for os er det ikke væsentligt lige nu.
Fra klientkoden kan man kalde serverkode, men man kan ikke kalde klientkode fra serverkoden. Dette er en fundamental begrænsning, vi har indført af flere årsager. Især fordi serverkoden skal være skrevet sådan, at den kan udføres ens, uanset hvor den kaldes fra — fra klienten eller serveren. Og i tilfælde af, at serverkode kaldes fra en anden serverkode, findes klienten ikke længere. Og fordi, når serverkoden udføres, kunne den klient, der kaldte den, være blevet lukket ned eller forladt applikationen, og serveren vil derfor ikke have nogen at kalde.

Koden, der behandler knaptryk: at kalde serverprocedure fra klienten vil fungere, men at kalde klientprocedure fra serveren vil ikke.
Det betyder, at hvis vi fra serveren ønsker at sende en meddelelse til klientapplikationen, for eksempel at den 'langvarige' rapport er færdig, og rapporten kan ses — så findes der ikke en sådan metode. Vi må finde på alternative løsninger, for eksempel at klientkoden periodisk spørger serveren. Men denne tilgang belaster systemet med unødvendige kald, og ser også ikke særlig elegant ud.
Og der er også behov for, for eksempel, at ved en indkommende telefon -opkald informere klientapplikationen om dette, så den kan finde nummeret på den kaldende part i databasen og vise brugeren oplysninger om den kaldende virksomhed. Eller, for eksempel, når en bestilling ankommer til lageret, at underrette klientapplikationen om dette. Generelt er der mange tilfælde, hvor en sådan mekanisme ville være nyttig.
Egentlig formål
At skabe en mekanisme til udveksling af beskeder. Hurtig, pålidelig, med garanteret levering, med mulighed for fleksibel søgning af beskeder. Baseret på denne mekanisme at implementere en messenger (beskeder, videoopkald), der fungerer inden for 1C-applikationer.
At designe et system, der er horisontalt skalerbart. Den stigende belastning skal kunne håndteres ved at øge antallet af noder.
Implementering
Vi besluttede at implementere serverdelen af SV som et selvstændigt produkt og ikke integrere det direkte i 1C:Enterprise platformen. API'et kan kaldes fra koden i 1C-applikationer. Dette valg blev truffet af flere årsager, hvoraf den primære var ønsket om at muliggøre kommunikation mellem forskellige 1C-applikationer (for eksempel mellem Handelsstyring og Regnskab). Forskellige 1C-applikationer kan køre på forskellige versioner af 1C:Enterprise platformen, være placeret på forskellige servere osv. I sådanne omstændigheder er implementeringen af SV som et selvstændigt produkt, der er 'udenom' installationerne af 1C, den optimale løsning.
Så vi besluttede at lave SV som et selvstændigt produkt. For små virksomheder anbefaler vi at benytte SV-serveren, som vi har installeret i vores cloud (wss://1cdialog.com), for at undgå omkostninger ved lokal installation og konfiguration af serveren. Store klienter kan dog finde det fornuftigt at installere deres egen SV-server på deres ressourcer. En lignende tilgang har vi anvendt i vores cloud-baserede SaaS produkt. – det udgives som et standard produkt til installation hos kunderne og er også udrullet i vores cloud. .
Applikation
For at fordele belastningen og sikre høj tilgængelighed vil vi ikke udrulle et enkelt Java-applikation, men flere, og placere en belastningsbalancer foran dem. Hvis det er nødvendigt at overføre en besked fra node til node, bruger vi publish/subscribe i Hazelcast.
Kundens kommunikation med serveren sker via websocket. Det er velegnet til realtidsystemer.
Distribueret cache
Vi overvejede mellem Redis, Hazelcast og Ehcache. Det er 2015. Redis havde lige udgivet en ny klynge (for ny, skræmmende), der er Sentinel med masser af begrænsninger. Ehcache kan ikke danne klynger (denne funktionalitet kom senere). Vi besluttede at prøve Hazelcast 3.4.
Hazelcast danner klynge 'ud af boksen'. I en enkelt node-tilstand er det ikke særlig nyttigt og kan kun bruges som cache – det kan ikke gemme data på disk, hvis vi mister den eneste node – mister vi data. Vi udruller flere Hazelcast-instanser, imellem hvilke vi sikkerhedskopierer kritiske data. Cachen sikkerhedskopierer vi ikke – den er ikke værd at bekymre sig om.
For os er Hazelcast:
- Et lager til bruger-sessioner. Hver gang at hente sessionen fra databasen tager for lang tid, så vi lægger alle sessioner i Hazelcast.
- Cache. Leder du efter brugeren – tjek i cachen. Har skrevet en ny besked – læg den i cachen.
- Emner til kommunikation af applikationsinstanser. Noden genererer en hændelse og placerer den i Hazelcast-emnet. Andre noder i applikationen, der har abonneret på dette emne, modtager og behandler hændelsen.
- Klynge-locks. For eksempel opretter vi en diskussion baseret på en unik nøgle (singleton-diskussion inden for 1C-databasen):
conversationKeyChecker.check("BENSINSTATION");

      doInClusterLock("BENSINSTATION", () -> {

          conversationKeyChecker.check("BENSINSTATION");

          createChannel("BENSINSTATION");
      });
Vi har kontrolleret, at kanalen ikke findes. Tog lås, kontrollerede igen, oprettede den. Hvis vi ikke tjekker efter at have taget låsen, er der en risiko for, at en anden tråd også har kontrolleret og nu forsøger at oprette den samme diskussion – og den eksisterer allerede. Det er ikke muligt at låse gennem synchronized eller almindelig java Lock. Gennem databasen er langsomt, og det er en skam at belaste databasen; gennem Hazelcast er det netop, hvad vi har brug for.
Vælger DBMS
Vi har stor og succesfuld erfaring med PostgreSQL og samarbejde med udviklerne af denne DBMS.
Det er ikke nemt med klyngen i PostgreSQL – der er , , , men det er alt i alt ikke noSQL, som skaleres ud af boksen. Vi overvejede ikke noSQL som primært lager, det var tilstrækkeligt, at vi tager Hazelcast, som vi ikke havde arbejdet med før.
Når vi skal skalere en relationel DB – betyder det, . Som du ved, når vi shard'er, deler vi databasen op i separate dele, så hver enkelt kan flyttes til en separat server.
Den første variant af vores sharding forudsatte muligheden for at fordele hver af tabellerne i vores applikation på forskellige servere i forskellige proportioner. Mange meddelelser på server A – selvfølgelig, lad os flytte en del af denne tabel til server B. Denne løsning råbte næsten på for tidlig optimering, så vi besluttede at nøjes med en multi-tenant tilgang.
Du kan læse om multi-tenant, for eksempel på siden .
I SV findes begrebet applikation og abonnent. En applikation er en konkret installation af en forretningsapplikation, f.eks. ERP eller Regnskab, med sine egne brugere og forretningsdata. Abonnent er en organisation eller en fysisk person, der registrerer applikationen på SV-serveren. En abonnent kan have registreret flere applikationer, og disse applikationer kan kommunikere indbyrdes. Abonnent er blevet lejer (tenant) i vores system. Beskeder fra flere abonnenter kan befinde sig i en fysisk database; hvis vi ser, at en abonnent begynder at generere meget trafik, flytter vi dem til en separat fysisk database (eller endda en separat DB-server).
Vi har en hoveddatabase, hvor der opbevares en routingtabel med information om placeringen af alle abonnentdatabaser.
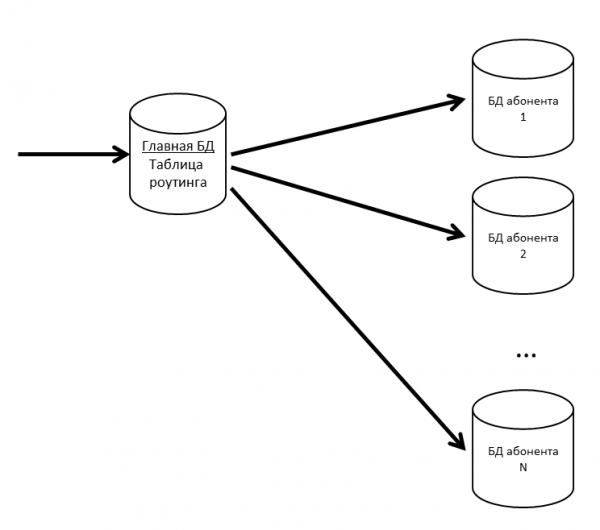
For at hoveddatabasen ikke skal blive et flaskehals, opbevarer vi routingtabellen (og andre ofte efterspurgte data) i cachen.
Hvis abonnentens database begynder at blive langsom, vil vi internt skære den op i partitioner. I andre projekter bruger vi til partitionering af store tabeller .
Da det er dårligt at miste brugerbeskeder, understøtter vi vores databaser med replikaer. Kombinationen af synkrone og asynkrone replikaer gør, at vi kan være på forkant i tilfælde af tab af hoveddatabasen. Tab af beskeder vil kun ske, hvis både hoveddatabasen og dens synkrone replika fejler samtidig.
Hvis den synkrone replika går tabt, bliver den asynkrone replika synkron.
Hvis hoveddatabasen går tabt, bliver den synkrone replika hoveddatabasen, og den asynkrone replika bliver den synkrone replika.
Elasticsearch til søgning
Da SV også er en messenger, er der brug for en hurtig, behagelig og fleksibel søgning, der tager højde for morfologi og ved unøjagtige match. Vi har besluttet ikke at opfinde hjulet igen og bruge det frie søgesystem Elasticsearch, udviklet på basis af biblioteket . Elasticsearch opsætter vi også i et cluster (master – data – data) for at undgå problemer, hvis applikationsnoder fejler.
På github fandt vi for Elasticsearch and use it. In the Elasticsearch index, we store the roots of words (defined by the plugin) and N-grams. As the user types text for searching, we search for the entered text among the N-grams. When saving in the index, the word 'texts' will be broken down into the following N-grams:
[te, tek, teks, tekst, tekster, ek, eks, ekst, ekstner, ks, kst, ksty, st, sty, ty],
The root word 'text' will also be saved. This approach allows searching at the beginning, in the middle, and at the end of the word.
Overall picture
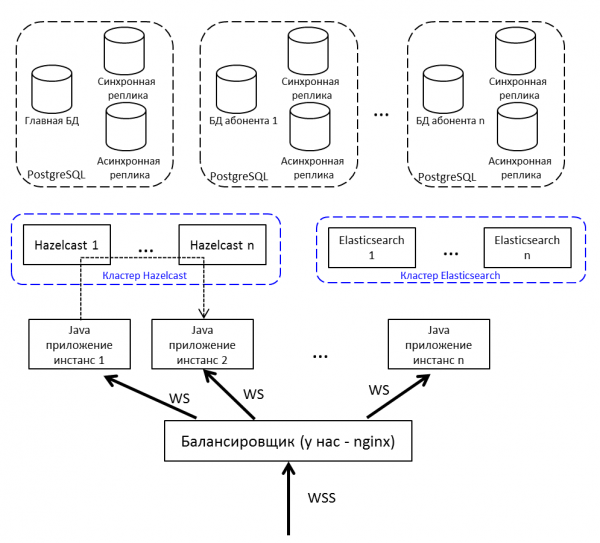
Repeat of the initial picture of the article, but with clarifications:
- A load balancer set up on the internet; we use nginx, but it can be any.
- Java application instances communicate with each other through Hazelcast.
- For working with WebSocket we use .
- The Java application is written in Java 8, consists of bundles . Plans include migrating to Java 10 and transitioning to modules.
Development and Testing
During the development and testing of the system, we encountered several interesting features of the products we used.
Load testing and memory leaks
The release of each version of the system involves load testing. It is considered successful if:
- The test ran for several days without service failures
- Response time for key operations did not exceed comfortable limits
- Performance degradation compared to the previous version is no more than 10%
We fill the test base with data – for this, we obtain information from the production server about the most active subscriber, multiplying their numbers by 5 (number of messages, discussions, users) and test accordingly.
We conduct load testing of the interaction system in three configurations:
- Stress test
- Only connections
- Subscriber registration
During the stress test, we launch several hundred threads that continuously load the system: sending messages, creating discussions, retrieving the message list. We simulate the actions of normal users (retrieve a list of my unread messages, write to someone) and program solutions (send a packet to another configuration, process a notification).
For example, this is what part of the stress test looks like:
- A user logs into the system
- Requests their unread discussions
- With a 50% probability, reads messages
- With a 50% probability, writes messages
- Hereafter, the user:
- Has a 20% chance of creating a new discussion
- Randomly selects any of their discussions
- Enters inside
- Requests messages, user profiles
- Creates five messages addressed to random users from this discussion
- Exits the discussion
- Repeats 20 times
- Logs out, returns back to the beginning of the scenario
- A chatbot logs into the system (emulating message exchanges from application code)
- Has a 50% chance to create a new channel for data exchange (special discussion)
- Has a 50% chance to send a message in any of the existing channels
The "Connections Only" scenario didn't appear out of nowhere. Sometimes users connect the system but haven't engaged yet. Each user turns on their computer at 09:00, establishes a connection to the server, and remains silent. These guys are dangerous; there are many of them – they only send PING/PONG packets, but they keep the connection to the server (they can't let it go – what if there’s a new message?). The test mimics a scenario where a large number of such users try to authorize within half an hour. It resembles a stress test, but the focus is on that first entry – to avoid errors (a person doesn’t use the system, but it already drops connections – it's hard to think of anything worse).
The subscriber registration scenario begins with the first launch. We conducted a stress test and were confident that the system does not lag in messaging. However, as users began to join, registration started to time out. During registration, we used , which is tied to the system's entropy. The server couldn’t gather enough entropy in time, and when requesting new SecureRandom, it froze for dozens of seconds. There are many solutions to this problem, for instance: switching to the less secure /dev/urandom, installing a special board that generates entropy, generating random numbers in advance and storing them in the pool. We temporarily addressed the issue with a pool, but since then we've been running a separate test for registering new subscribers.
As a load generator, we use . It doesn’t natively work with websockets, a plugin is needed. The first results in the search for "jmeter websocket" show , which recommend .
That’s where we decided to start.
Næsten straks efter begyndelsen af alvorlig testning opdagede vi, at der begyndte at være hukommelseslækager i JMeter.
Plugin'et er en helt anden historie, med 176 stjerner har det 132 forks på GitHub. Selve forfatteren har ikke committet til det siden 2015 (vi tog det i 2015, dengang vækkede det ikke mistanker), flere GitHub-issues om hukommelseslækager, 7 ufærdige pull requests.
Hvis du beslutter at udføre belastningstest med dette plugin, skal du være opmærksom på følgende diskussioner:
- I et flertrådet miljø blev der brugt en almindelig LinkedList, hvilket resulterede i i runtime. Dette løses enten ved at skifte til ConcurrentLinkedDeque eller ved at bruge synchronized-blocks. Vi valgte selv den første mulighed ().
- Hukommelseslækage, ved disconnection bliver forbindelsesoplysningerne ikke slettet ().
- I streaming-tilstand (når websocket ikke lukkes i slutningen af prøven, men bruges videre i planen) fungerer Response patterns ikke ().
Det er fra de, der er på GitHub. Hvad vi gjorde:
- Vi tog (@elyrank) – i den er problem 1 og 3 rettet
- Vi løste problem 2
- Vi opdaterede jetty fra 9.2.14 til 9.3.12
- Vi indkapslede SimpleDateFormat i ThreadLocal; SimpleDateFormat er ikke tråd-sikker, hvilket førte til NPE i runtime
- Vi eliminerede endnu en hukommelseslækage (forbindelsen blev ikke korrekt lukket ved disconnection)
Og alligevel lækker den!
Hukommelsen begyndte ikke at løbe tør på en dag, men efter to. Der var næsten ikke tid tilbage, så vi besluttede at køre færre tråde, men på fire agenter. Det skulle være nok til mindst en uge.
To dage er gået…
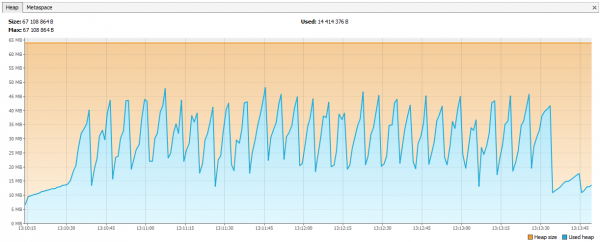
Nu begyndte hukommelsen at løbe tør hos Hazelcast. I loggene var det synligt, at efter et par dages testning begyndte Hazelcast at klage over mangel på hukommelse, og efter nogen tid kollapsede klyngen, og noderne fortsatte med at falde enkeltvis. Vi tilsluttede JVisualVM til hazelcast og så en "stigende sav" – den kaldte regelmæssigt GC, men kunne ikke rydde hukommelsen.
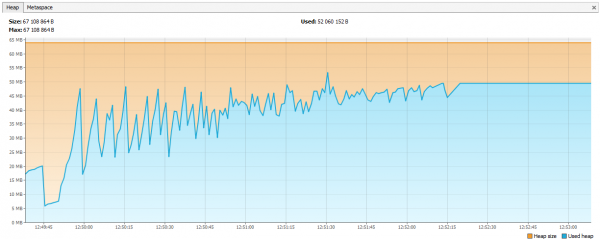
Det viste sig, at i hazelcast 3.4 bliver hukommelsen ikke frigivet fuldstændigt ved sletning af map / multiMap (map.destroy()):
Fejlen er nu rettet i 3.5, men dengang var det et problem. Vi oprettede nye multiMaps med dynamiske navne og slettede i henhold til vores logik. Koden så cirka sådan ud:
public void join(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.put(auth.getUserId(), auth);
}

public void leave(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.remove(auth.getUserId(), auth);

    if (sessions.size() == 0) {
        sessions.destroy();
    }
}
Kald:
service.join(auth1, "NYE_BESKEDER_I_DEBATTEN_UUID1");
service.join(auth2, "NYE_BESKEDER_I_DEBATTEN_UUID1");
multiMap blev oprettet for hver abonnement og fjernet, når den ikke var nødvendig. Vi besluttede os for at oprette en Map, hvor nøglen ville være navnet på abonnementet, og værdierne ville være sessionernes identifikatorer (som senere kan bruges til at få brugeridentifikatorer, hvis nødvendigt).
public void join(Authentication auth, String sub) {
    addValueToMap(sub, auth.getSessionId());
}

public void leave(Authentication auth, String sub) {
    removeValueFromMap(sub, auth.getSessionId());
}
Grafikkerne er blevet justeret.
Hvad mere har vi lært om belastningstestning
- JSR223 skal skrives i groovy og inkludere compilation cache - det er meget hurtigere. .
- Jmeter-Plugins grafikker er lettere at forstå end de standarder. .
Om vores erfaring med Hazelcast
Hazelcast var et nyt produkt for os, vi begyndte at arbejde med det fra version 3.4.1, nu kører vi version 3.9.2 på vores produktionsserver (på tidspunktet for denne artikel er den seneste version af Hazelcast - 3.10).
ID-generering
Vi startede med heltal identifikatorer. Lad os forestille os, at vi har brug for endnu en Long for en ny enhed. Sekvensen i databasen er ikke passende, da tabellerne deltager i sharding - det vil resultere i, at der er en besked med ID=1 i DB1 og en besked med ID=1 i DB2, som ikke kan gemmes i Elasticsearch efter sådan et ID, i Hazelcast heller ikke, men det værste er, hvis du vil samle data fra to databaser til en (for eksempel, hvis du beslutter, at én database er nok til disse abonnenter). Du kan oprette flere AtomicLong i Hazelcast og holde tælleren der, så præstationen for at få et nyt ID - incrementAndGet plus tiden på forespørgslen til Hazelcast. Men der er noget mere optimalt i Hazelcast - FlakeIdGenerator. Hver klient får et interval af ID'er, når de anmoder, for eksempel den første - fra 1 til 10.000, den anden - fra 10.001 til 20.000 og så videre. Nu kan klienten selv udstede nye identifikatorer, indtil den tildelte interval er opbrugt. Det fungerer hurtigt, men når applikationen (og Hazelcast-klienten) genstartes, begynder en ny sekvens - heraf mangler osv. Desuden er det ikke helt klart for udviklerne, hvorfor ID'er er heltal, men stadig kommer så meget i uorden. Vi har vejet det hele og skiftet til UUID'er.
For those who want to be like Twitter, there is a library called Snowcast – it's an implementation of Snowflake on top of Hazelcast. You can check it out here:
But we haven't gotten around to it yet.
TransactionalMap.replace
Another surprise: TransactionalMap.replace does not work. Here's such a test:
@Test
public void replaceInMap_putsAndGetsInsideTransaction() {

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            context.getMap("map").put("key", "oldValue");
            context.getMap("map").replace("key", "oldValue", "newValue");

            String value = (String) context.getMap("map").get("key");
            assertEquals("newValue", value);

            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}

Expected : newValue
Actual : oldValue
I had to write my own replace using getForUpdate:
protected  boolean replaceInMap(String mapName, K key, V oldValue, V newValue) {
    TransactionalTaskContext context = HazelcastTransactionContextHolder.getContext();
    if (context != null) {
        log.trace("[CACHE] Replacing value in a transactional map");
        TransactionalMap map = context.getMap(mapName);
        V value = map.getForUpdate(key);
        if (oldValue.equals(value)) {
            map.put(key, newValue);
            return true;
        }

        return false;
    }
    log.trace("[CACHE] Replacing value in a non-transactional map");
    IMap map = hazelcastInstance.getMap(mapName);
    return map.replace(key, oldValue, newValue);
}
Test not only regular data structures but also their transactional versions. Sometimes, IMap works while TransactionalMap does not.
Deploy a new JAR without downtime
Initially, we decided to store our class objects in Hazelcast. For example, we have a class Application, and we want to save and read it. We save it:
IMap map = hazelcastInstance.getMap("application");
map.set(id, application);
Reading:
IMap map = hazelcastInstance.getMap("application");
return map.get(id);
Everything works. Then we decided to build an index in Hazelcast for searching:
map.addIndex("subscriberId", false);And when writing a new entity, we started receiving ClassNotFoundException. Hazelcast tried to update the index but knew nothing about our class and wanted us to provide a JAR with that class. We did so, it all worked, but a new problem arose: how to update the JAR without completely stopping the cluster? Hazelcast does not pick up the new JAR during a rolling update. At that moment, we decided that we could live without search by index. After all, if we use Hazelcast as a key-value store, everything should work, right? Not quite. Here again, IMap and TransactionalMap behave differently. Where IMap doesn’t care, TransactionalMap throws an error.
IMap. Vi gemmer 5000 objekter, og læser dem. Alt som forventet.
@Test
void get5000() {
    IMap map = hazelcastInstance.getMap("application");
    UUID subscriberId = UUID.randomUUID();

    for (int i = 0; i < 5000; i++) {
        UUID id = UUID.randomUUID();
        String title = RandomStringUtils.random(5);
        Application application = new Application(id, title, subscriberId);

        map.set(id, application);
        Application retrieved = map.get(id);
        assertEquals(id, retrieved.getId());
    }
}
Men det virker ikke i transaktionen, vi får ClassNotFoundException:
@Test
void get_transaction() {
    IMap map = hazelcastInstance.getMap("application_t");
    UUID subscriberId = UUID.randomUUID();
    UUID id = UUID.randomUUID();

    Application application = new Application(id, "qwer", subscriberId);
    map.set(id, application);

    Application retrievedOutside = map.get(id);
    assertEquals(id, retrievedOutside.getId());

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            TransactionalMap transactionalMap = context.getMap("application_t");
            Application retrievedInside = transactionalMap.get(id);

            assertEquals(id, retrievedInside.getId());
            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}
I version 3.8 blev mekanismen User Class Deployment introduceret. Du kan tildele én hovednode og opdatere JAR-filen på den.
Nu har vi helt skiftet tilgang: vi serialiserer selv til JSON og gemmer i Hazelcast. Hazelcast behøver ikke at kende strukturen af vores klasser, og vi kan opdatere uden nedetid. Versionsstyring af domæneobjekter håndteres af applikationen. Forskellige versioner af applikationen kan køre samtidigt, og der kan opstå situationer, hvor den nye applikation skriver objekter med nye felter, som den gamle applikation ikke kender til endnu. Samtidig læser den nye applikation objekter, som er skrevet af den gamle applikation, og som ikke har de nye felter. Vi håndterer sådanne situationer internt i applikationen, men for enkelhedens skyld ændrer eller sletter vi ikke felter, vi udvider kun klasserne ved at tilføje nye felter.
Hvordan vi sikrer høj ydeevne
Fire opkald til Hazelcast – godt, to til databasen – dårligt
At hente data fra cachen er altid bedre end fra databasen, men det er heller ikke ønskeligt at opbevare ubrugte poster. Vi udsætter beslutningen om, hvad der skal caches, til den sidste fase af udviklingen. Når den nye funktionalitet er kodet, aktiverer vi logning af alle forespørgsler i PostgreSQL (log_min_duration_statement sat til 0) og kører belastningstest i cirka 20 minutter. Ved hjælp af logfilerne kan værktøjer som pgFouine og pgBadger generere analytiske rapporter. I rapporterne leder vi først og fremmest efter langsomme og hyppige forespørgsler. For langsomme forespørgsler opbygger vi en eksekveringsplan (EXPLAIN) og vurderer, om en sådan forespørgsel kan accelereres. Hyppige forespørgsler med de samme inputdata egner sig godt til cachen. Vi forsøger at holde forespørgslerne 'flade', med én tabel pr. forespørgsel.
Drift
CV som online service blev taget i brug foråret 2017, og som et separat produkt blev CV lanceret i november 2017 (på det tidspunkt i beta-status).
I mere end et år med drift har der ikke været nogen alvorlige problemer med online service CV. , vi indsamler og implementerer fra .
Serverdistributionen af CV leveres i form af native pakker: RPM, DEB, MSI. Desuden tilbyder vi for Windows en samlet installatør som en enkelt EXE, som installerer serveren, Hazelcast og Elasticsearch på én maskine. I starten kaldte vi denne installationsmetode 'demonstrationsversion', men nu står det klart, at dette er den mest populære distributionsmetode.
Kilde: habr.com
