

Logfiler er en vigtig del af systemet, som gør det muligt at forstå, om det fungerer, som det skal. I en mikroservices-arkitektur bliver arbejdet med logfiler en egen disciplin. Man skal løse en række spørgsmål med det samme:
- hvordan man skriver logfiler fra applikationen;
- hvor man skal skrive logfiler;
- hvordan man transporterer logfiler til opbevaring og behandling;
- hvordan man behandler og opbevarer logfiler.
Anvendelsen af de populære containeriseringsteknologier tilføjer ekstra udfordringer til løsningen af opgaven.
Det handler netop om dette i oplægget fra Yuri Bushmelev "Kort over problemer i indsamling og levering af logfiler".
Hvis nogen er interesseret, så kom ind under kat.
Mit navn er Yuri Bushmelev. Jeg arbejder hos Lazada. I dag vil jeg tale om, hvordan vi har lavet vores logfiler, hvordan vi indsamler dem, og hvad vi skriver i dem.
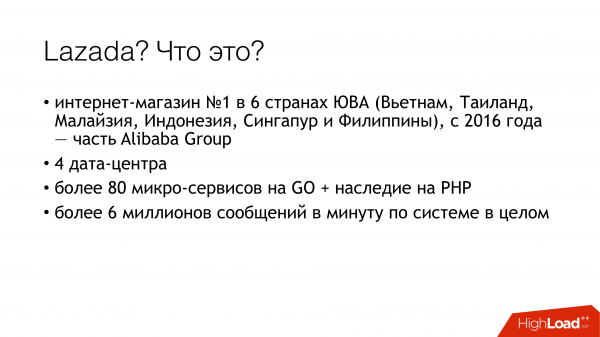
Hvor er vi fra? Hvem er vi? Lazada er den største online butik i seks lande i Sydøstasien. Disse lande er fordelt på vores datacentre. I alt har vi nu 4 datacentre. Hvorfor er det vigtigt? Fordi nogle løsninger var bestemt af, at der er en svag forbindelse mellem centrene. Vi har en mikroservices-arkitektur. Jeg blev overrasket over at opdage, at vi allerede har 80 mikroservices. Da jeg startede med logfilerne, var der kun 20. Derudover har vi en ganske stor del PHP legacy, som vi også må leve med. Alt dette genererer i øjeblikket mere end 6 millioner beskeder i minuttet i systemet som helhed. Derefter vil jeg vise, hvordan vi prøver at leve med dette, og hvorfor det er sådan.
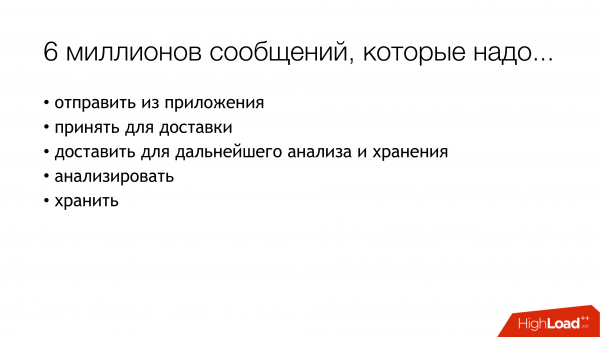
Man skal på en eller anden måde leve med disse 6 millioner beskeder. Hvad skal vi gøre med dem? 6 millioner beskeder, som skal:
- sendes fra applikationen
- modtages til levering
- leveres til analyse og opbevaring.
- analyze
- opbevares på en eller anden måde.
Da der tredje million beskeder kom, havde jeg cirka det samme udtryk. For vi startede med nogle småpenge. Det er klart, at der skrives logfiler for applikationerne. For eksempel kunne ikke forbinde til databasen, kunne forbinde til databasen, men kunne ikke læse noget. Men udover dette skriver hver af vores mikroservices også en access-log. Hver anmodning, der kommer til mikroservicen, falder ind i loggen. Hvorfor gør vi dette? Udviklerne ønsker at have mulighed for tracing. I hver access-log ligger der et felt traceid, som et specielt interface derefter bruger til at udfolde hele kæden og smukt viser trace. Trace viser, hvordan anmodningen blev behandlet, og det hjælper vores udviklere med at håndtere diverse uidentificerede problemer hurtigere.
Hvordan lever vi med dette? Nu vil jeg kort fortælle om mulighederne — hvordan denne problemstilling generelt løses. Hvordan man løser opgaven med indsamling, overførsel og opbevaring af logs.
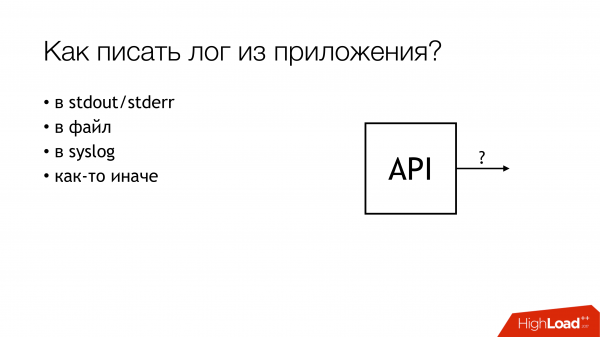
Hvordan skriver man fra applikationen? Det er klart, at der er forskellige metoder. Især er der best practices, som de fashionable personer fortæller os om. Der er old school i to former, som bedsteforældrene fortalte. Der er andre metoder.
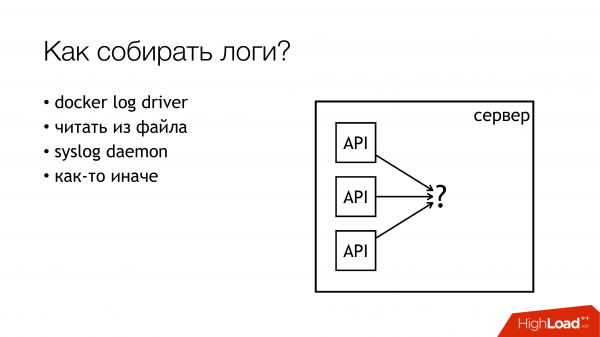
Situation med logindsamling er omtrent den samme. Der er ikke så mange løsninger på denne specifikke del. De er blevet flere, men der er stadigvæk ikke så mange.
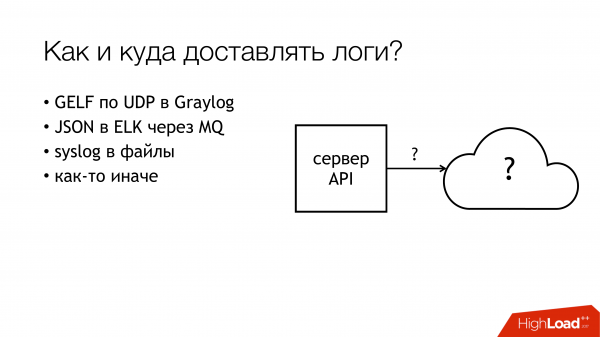
Men hvad angår levering og efterfølgende analyse — antal variationer begynder at eksplodere. Jeg vil ikke beskrive hver enkelt variant nu. Jeg tror, at de grundlæggende muligheder er velkendte for alle, der har været interesseret i emnet.
Jeg vil vise, hvordan vi gjorde det i Lazada, og hvordan det hele begyndte.
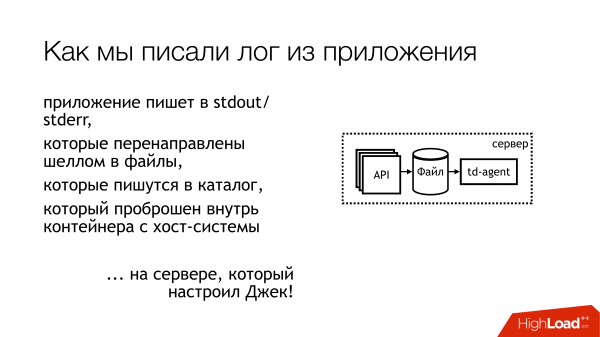
For et år siden kom jeg til Lazada, og jeg blev sendt til projektet om logs. Det så cirka sådan her ud. Loggen fra applikationen blev skrevet til stdout og stderr. Alle gjorde det trendy. Men derefter smed udviklerne det ud fra standardstrømmene, og så måtte specialisterne inden for infrastruktur finde ud af det. Mellem infrastrukturnørderne og udviklerne er der også releasers, som sagde: "øh... okay, lad os bare pakke dem ind i en fil med shell, og så er det det". Og da alt dette foregår i en container, pakkede vi det direkte i selve containeren, mappede det ind i kataloget og lagde det der. Jeg tror, at det er ret indlysende for alle, hvad der kom ud af det.
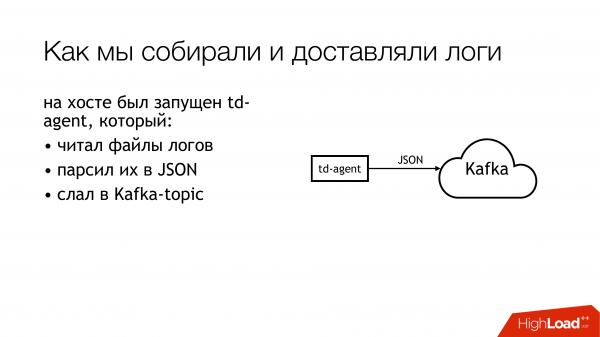
Lad os tage et kig lidt længere frem. Hvordan vi transportede disse logs. Nogen valgte td-agent, som i virkeligheden er fluentd, men ikke helt fluentd. Jeg har stadig ikke helt forstået forholdet mellem disse to projekter, men de handler angiveligt om det samme. Og denne fluentd, skrevet i Ruby, læste logfiler, parsede dem til JSON via nogle regulære udtryk. Derefter sendte den dem til Kafka. Faktisk havde vi 4 separate emner i Kafka for hver API. Hvorfor 4? Fordi der er live, der er staging, og fordi der findes stdout og stderr. Udviklerne opretter dem, og infrastrukturrådgiverne skal oprette dem i Kafka. Desuden blev Kafka styret af en anden afdeling. Derfor skulle man oprette en ticket, så de kunne oprette 4 emner for hver API. Alle glemte det. Det var i bund og grund kaos og ballade.
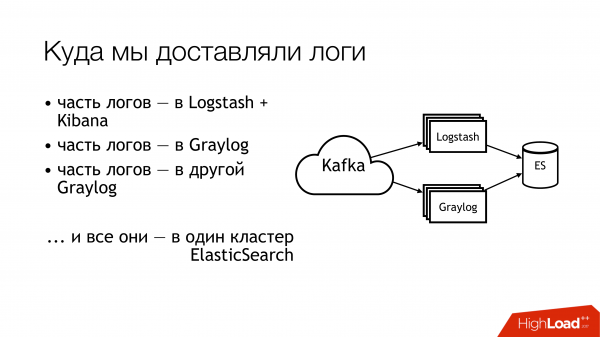
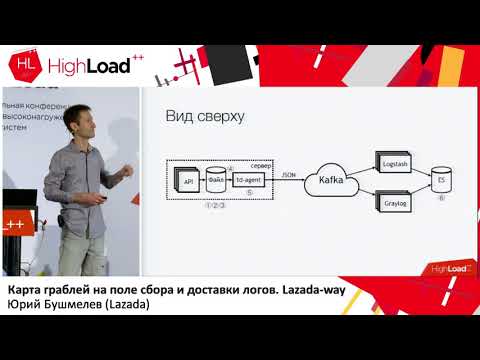
Hvad gjorde vi så med det? Vi sendte det til Kafka. Derefter fløj halvdelen af loggene ind i Logstash. Den anden halvdel af loggene blev delt. Nogen fløj ind i én Graylog, mens andre fløj ind i en anden Graylog. I sidste ende havnede det hele i en Elasticsearch-klynge. Altså, alt det kaos landet der til sidst. Sådan skal man ikke gøre!
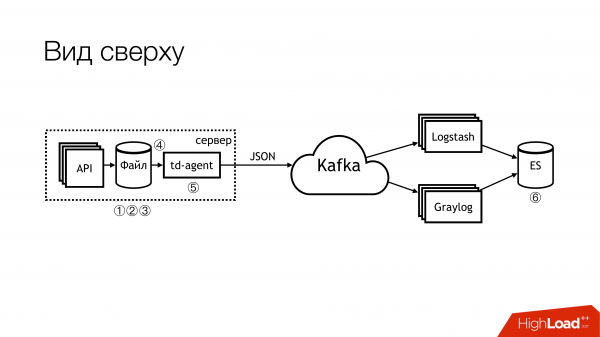
Sådan ser det ud, hvis man kigger lidt ovenfra. Man skal ikke gøre sådan! Her er de problematiske steder straks markeret med tal. Der er faktisk flere, men 6 er de helt kritiske, som vi skal gøre noget ved. Jeg vil nu tale om dem særskilt.
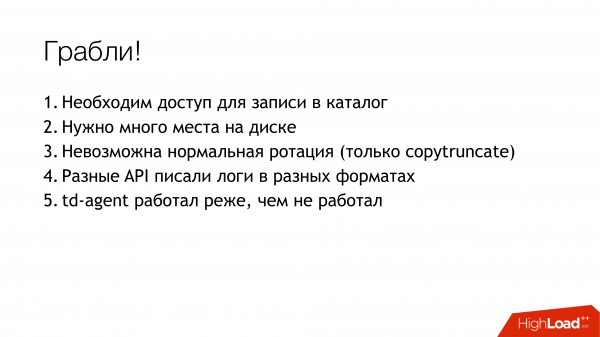
Her (1,2,3) skrives vores filer, og derfor er der straks tre faldgruber.
Det første (1) — vi skal skrive dem et eller andet sted. Man ønsker ikke altid at give API'et muligheden for at skrive direkte til fil. Det er ønskeligt, at API'et er isoleret i en container, og endnu bedre – at det er read-only. Jeg er systemadministrator, så jeg har en lidt alternativ opfattelse af disse ting.
Det andet punkt (2,3) — vi modtager mange forespørgsler i API'et. API'et skriver mange data til fil. Filene vokser. Vi er nødt til at rotere dem. Ellers vil der ikke være nok diskplads. Det er problematisk at rotere dem, fordi de er lavet med en omdirigering gennem shell ind i en katalog. Vi kan ikke rotere den. Man kan ikke sige til applikationen, at den skal genåbne deskriptorerne. For udviklerne vil se på dig som om du var skør: „Hvilke deskriptorer? Vi skriver overhovedet til stdout.“ Infrastrukturfolket lavede copytruncate i logrotate, som simpelthen laver en kopi af filen og trimmer originalen. Følgelig er det ofte mellem disse kopieringsprocesser, at der ikke er mere plads på disken.
(4) Vi havde forskellige formater i forskellige API'er. De adskilte sig lidt, men det var nødvendigt at skrive forskellige regexp'er. Da alt dette blev styret af Puppet, var der en stor samling klasser med deres egne problemer. Plus at td-agent største delen af tiden kunne spise hukommelse, være langsom, han kunne simpelthen lade som om han arbejdede, mens han ikke gjorde noget. Udefra var det umuligt at forstå, at han ikke gjorde noget. I bedste fald ville han falde, og så ville nogen genstarte ham. Mere præcist ville en alert komme, og nogen ville så fysisk genstarte ham.
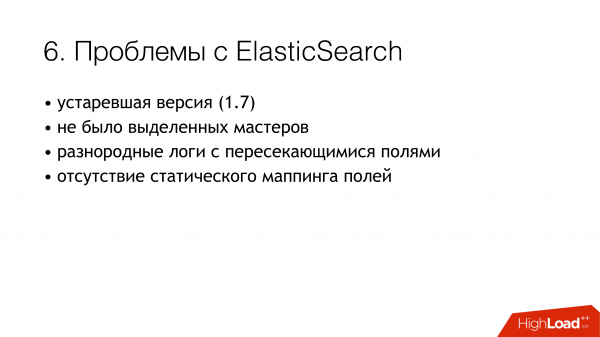
(6) Og det mest kaotiske var elasticsearch. Fordi det var en gammel version. Fordi vi ikke havde dedikerede mestre på det tidspunkt. Vi havde heterogene logs, hvor felterne kunne krydse hinanden. Forskellige logs fra forskellige applikationer kunne blive skrevet med de samme feltnavne, men indeni kunne der være forskellige data. Det vil sige, at en log kommer med Integer i feltet, for eksempel level. En anden log kommer med String i feltet level. Uden statisk mapping resulterer det i en fantastisk situation. Hvis den første meddelelse efter rotationen af indekset i elasticsearch kommer som en streng, så klarer vi os fint. Men hvis den første der kommer er en Integer, så bliver alle efterfølgende meddelelser, der kommer som strenge, simpelthen afvist. Fordi felttypen ikke matcher.
Vi begyndte at stille os selv disse spørgsmål. Vi besluttede ikke at lede efter syndere.
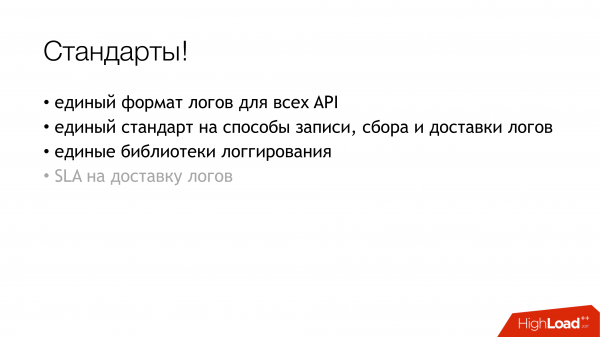
Men skal der gøres noget! Det er en åbenlys ting – der skal indføres standarder. Nogle standarder havde vi allerede. Nogle indførte vi lidt senere. Heldigvis var der allerede godkendt et ensartet logformat for alle API'er på det tidspunkt. Det er skrevet direkte ind i standarderne for samspil mellem tjenesterne. Derfor skal dem, der ønsker at modtage loggene, skrive dem i dette format. Hvis nogen ikke skriver loggene i dette format, kan vi ikke garantere noget.
Dernæst ønsker jeg at indføre en fælles standard for måderne at registrere, levere og samle logs på. Egentlig, hvor de skal skrives, og hvordan de skal leveres. Den ideelle situation er, når projekterne bruger det samme bibliotek. Der er et separat logningsbibliotek til Go, og et separat bibliotek til PHP. Alle, vi har – skal bruge dem. På nuværende tidspunkt vil jeg sige, at vi har det tilført omkring 80%. Men nogle fortsætter med at spise kaktuser.
Og der (på sliden) begynder "SLA for levering af logs" så småt at fremstå. Den eksisterer ikke endnu, men vi arbejder på det. Fordi det er meget praktisk, når infrastrukturen siger, at hvis I skriver i et bestemt format på et bestemt sted og ikke mere end N meddelelser per sekund, så vil vi med en bestemt sandsynlighed levere det dertil. Det fjerner en hel del hovedpine. Hvis SLA'en eksisterer, så er det direkte fantastisk!
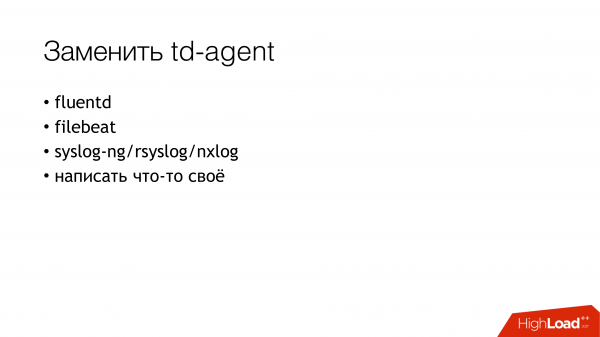
Hvordan begyndte vi at løse problemet? Den største udfordring var med td-agent. Det var uklart, hvor vores logs blev af. Leveres de? Samles de? Hvor er de overhovedet? Derfor blev det som første punkt besluttet at erstatte td-agent. Jeg har kort skitseret mulighederne for, hvad man kan erstatte det med.
Fluentd. For det første har jeg haft erfaring med det fra mit tidligere arbejde, og det faldt også der en gang imellem. For det andet er det det samme, bare mere specialiseret.
Filebeat. Hvad gjorde det praktisk for os? Dens fordel var, at den er skrevet i Go, og vi har stor ekspertise i Go. Derfor kunne vi, hvis det var nødvendigt, lave nogle tilpasninger til det. Men vi valgte ikke at tage den. For at der ikke skulle være nogen fristelse til at begynde at omskrive det.
Et åbenlyst valg for systemadministratorer forbliver alle mulige syslogs i sådan en mængde (syslog-ng/rsyslog/nxlog).
Eller skrive noget eget, men det skrinlagde vi, ligesom filebeat. Hvis der skulle skrives noget, så er det bedre at skrive noget nyttigt for forretningen. Til leveringen af logs er det bedre at vælge noget færdigt.
Derfor var valget i princippet et valg mellem syslog-ng og rsyslog. Jeg hældede mod rsyslog, simpelthen fordi vi allerede havde klasser til rsyslog i Puppet, og jeg fandt ikke nogen åbenlyse forskelle mellem dem. Der er syslog der, og der er syslog her. Ja, nogen har dårligere dokumentation, mens andre har bedre. Den ene kan det, og den anden kan noget andet.
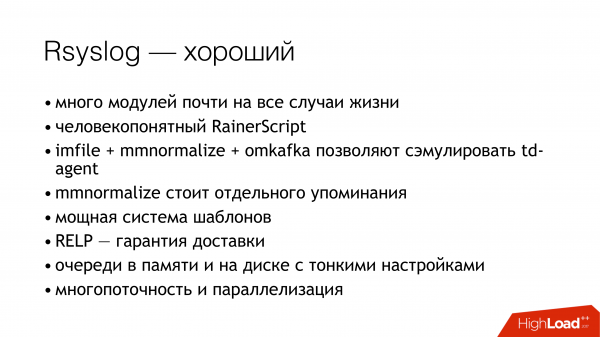
Og lidt om rsyslog. For det første er det fantastisk, fordi det har mange moduler. Det har et menneskevenligt RainerScript (et moderne konfigurationssprog). En fantastisk bonus er, at vi kunne simulere adfærden af td-agent ved hjælp af standardværktøjer, så for applikationerne ændrede intet sig. Så vi skifter td-agent ud med rsyslog, mens alt det andre forbliver uændret. Og vi får straks en fungerende levering. Desuden er mmnormalize en fantastisk funktion i rsyslog. Den tillader parsning af logs, men ikke ved hjælp af Grok og regexp. Den laver et abstract syntax tree. Den behandler logs på en måde, som en compiler behandler kildekode. Det gør det muligt at arbejde meget hurtigt, bruge lidt CPU og generelt er det virkelig en fremragende ting. Der er en masse andre fordele. Jeg vil ikke stoppe ved dem.
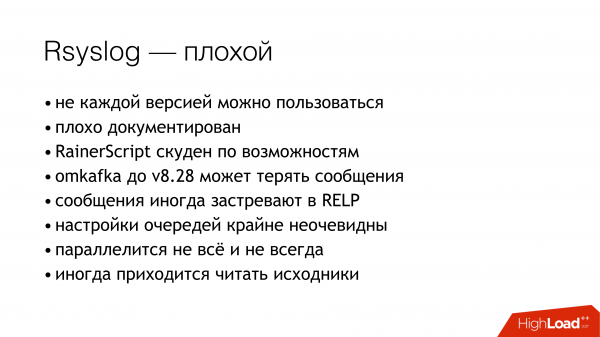
Rsyslog har også mange ulemper. De er cirka de samme som fordelene. De primære problemer er, at man skal vide, hvordan man konfigurerer det, og man skal finde den rigtige version.
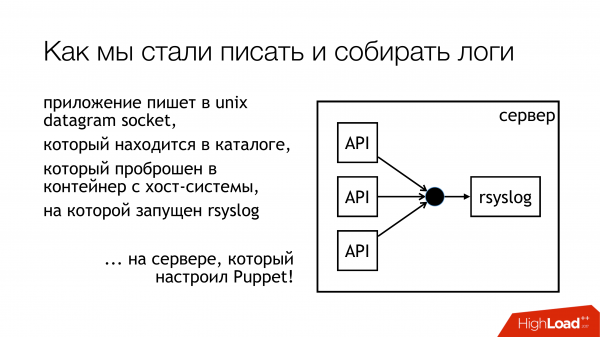
Vi besluttede, at vi ville skrive logs i en unix socket. Og ikke i /dev/log, fordi der har vi en blanding af systemlogs, der journald i denne pipeline. Så lad os skrive til en tilpasset socket. Vi vil tilknytte den til et separat ruleset. Vi vil ikke blande noget. Alt vil være gennemsigtigt og forståeligt. Det er præcis det, vi gjorde. Kataloget med disse sockets er standardiseret og gøres tilgængeligt for alle containere. Containerne kan se den socket, de har brug for, åbne den og skrive til den.
Hvorfor ikke en fil? Fordi alle læste , der forsøgte at videregive en fil i docker, og det blev opdaget, at efter en genstart af rsyslog ændrede file descriptor, og docker mistede denne fil. Den holder noget andet åbent, men ikke længere den socket, som der skrives til. Vi besluttede, at vi ville omgå dette problem, og samtidig omgå problemet med blokering.
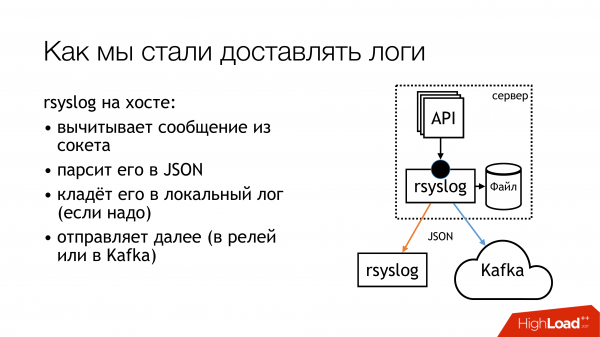
Rsyslog udfører handlingerne angivet på slide og sender logs enten til relay eller til Kafka. Kafka svarer til den gamle metode. Relay er, at jeg forsøgte at bruge rent rsyslog til loglevering. Uden Message Queue, med standard værktøjer fra rsyslog. I princippet fungerer det.
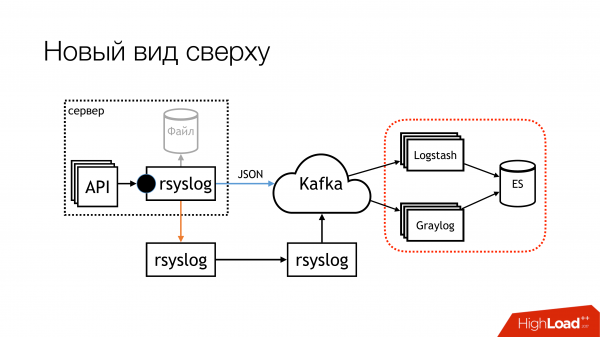
Men der er nuancer i forhold til, hvordan man senere presser dem ind i denne del (Logstash/Graylog/ES). Denne del (rsyslog-rsyslog) bruges mellem datacentre. Her er en komprimeret TCP-forbindelse, der gør det muligt at spare båndbredde og dermed øge sandsynligheden for, at vi modtager nogle logs fra et andet datacenter, når forbindelsen er overbelastet. Fordi vi har Indonesien, hvor alt er skidt. Der er dette konstant problem.
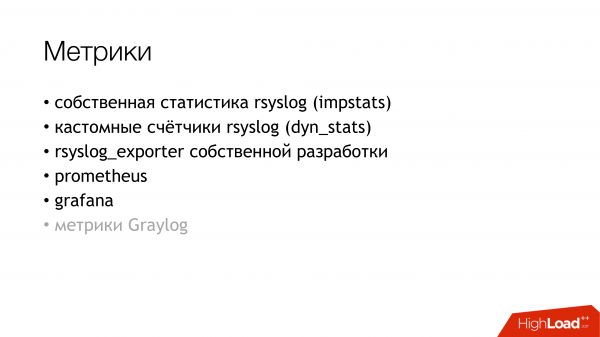
Vi har tænkt over, hvordan vi konkret kan overvåge, med hvilken sandsynlighed logs, som vi har registreret fra applikationen, når frem til den anden ende? Vi besluttede at oprette metrics. rsyslog har sin egen statistikopsamlingsmodul, som indeholder nogle tællere. For eksempel kan det vise dig størrelsen på køen, eller hvor mange beskeder der er kommet i en bestemt handling. Derfra kan vi tage noget. Desuden har det brugerdefinerede tællere, som kan konfigureres, og det vil vise dig, for eksempel, hvor mange beskeder en bestemt API har registreret. Derefter skrev jeg rsyslog_exporter i Python, og vi sendte det hele til Prometheus og byggede grafer. Vi ville meget gerne have Graylog-metrics, men vi nåede ikke at konfigurere dem endnu.
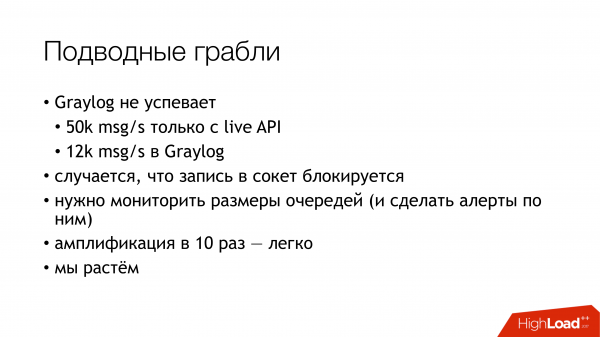
Hvilke problemer opstod? Problemerne opstod, da vi pludselig opdagede, at vores Live API'er sender 50.000 beskeder i sekundet. Dette er kun Live API'er uden staging. Og Graylog viser os kun 12.000 beskeder i sekundet. Og det rejste et rimeligt spørgsmål: hvor er resterne? Heraf konkluderede vi, at Graylog simpelthen ikke kan følge med. Vi kiggede, og ja, Graylog og Elasticsearch kunne ikke håndtere denne strøm.
Dernæst gjorde vi andre opdagelser i processen.
Skrivning til soklen bliver blokeret. Hvordan skete det? Da jeg brugte rsyslog til levering, ødelagde vi på et tidspunkt forbindelsen mellem datacentrene. Leveringen stoppede på ét sted, og så stoppede den på et andet sted. Alt dette nåede frem til maskinen med API'er, der skriver til rsyslog-soklen. Der blev køen fyldt. Så blev køen til skrivning til unix-soklen fyldt, som som standard har 128 pakker. Og den næste write() i applikationen blokeres. Da vi kiggede i det bibliotek, vi bruger i vores Go-applikationer, stod der, at skrivning til soklen sker i ikke-blokerende tilstand. Vi var sikre på, at intet blev blokeret. Fordi vi læste. , som skrev om dette. Men der er et punkt. Rundt om denne opkald var der også en uendelig løkke, hvor der konstant blev forsøgt at putte en besked i socketen. Det var det, vi ikke tog mærke til. Vi måtte omskrive biblioteket. Siden da har det ændret sig flere gange, men nu har vi elimineret låsninger i alle undersystemer. Derfor kan vi stoppe rsyslog, og intet vil falde.
Vi skal overvåge størrelsen på køerne, hvilket hjælper med at undgå disse faldgruber. For det første kan vi overvåge, hvornår vi begynder at miste beskeder. For det andet kan vi overvåge, at vi overhovedet har problemer med levering.
Og endnu en uheldig ting — amplification i 10 gange i mikrotjenesterarkitekturen — det er meget nemt. Vi har ikke så mange indgående anmodninger, men på grund af grafen, som disse beskeder løber videre på, på grund af adgangsloggene, øger vi virkelig belastningen på loggene med cirka ti gange. Jeg har desværre ikke fået tid til at beregne de præcise tal, men mikrotjenester — de er sådan. Det skal man have i mente. Det viser sig, at i øjeblikket er logindsamlingssystemet det mest belastede i Lazada.
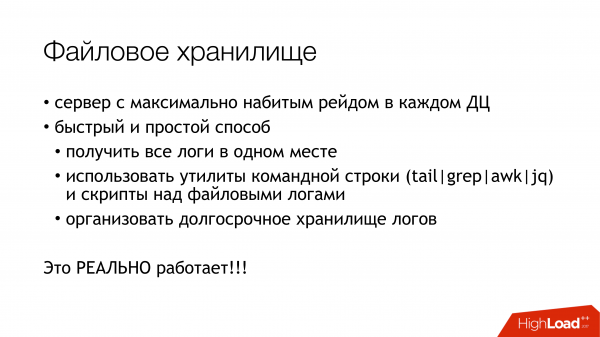
Hvordan løser man problemet med elasticsearch? Hvis du hurtigt har brug for at få loggene et sted, så du ikke skal løbe rundt på alle maskinerne og samle dem, så brug et filstorage. Det fungerer garanteret. Det laves fra enhver server. Du skal bare stikke nogle diske derhen og sætte syslog op. Derefter har du garanteret alle loggene et sted. Derefter kan du stille og roligt begynde at konfigurere elasticsearch, graylog, eller noget andet. Men du har allerede alle loggene, og du kan opbevare dem, så længe diskområderne rækker.
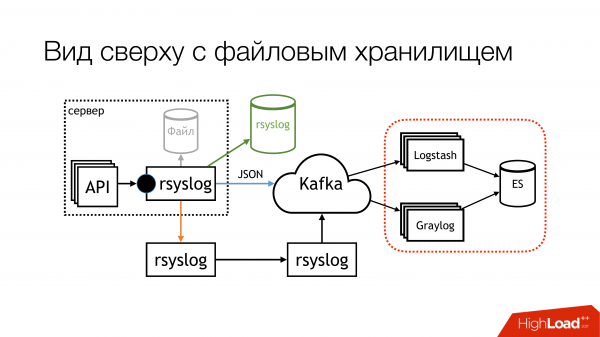
På tidspunktet for mit foredrag så skemaet sådan ud. Vi er stort set blevet stoppet med at skrive til filer. Nu slukker vi sandsynligvis for resten. På de lokale maskiner, hvor API'erne kører, stopper vi med at skrive til filer. For det første er der et filstorage, som fungerer rigtig godt. For det andet løber der konstant pladsmangel på disse maskiner, og det skal overvåges kontinuerligt.
Denne del med Logstash og Graylog, den er virkelig frustrerende. Derfor skal vi slippe af med den. Vi skal vælge et enkelt system.
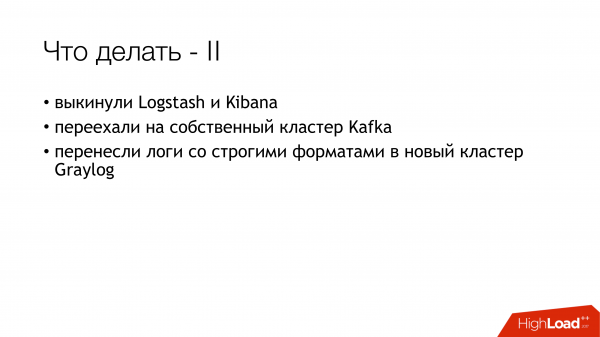
Vi har besluttet at skrotte Logstash og Kibana. Fordi vi har et sikkerhedsafdeling. Hvad er forbindelsen? Forbindelsen er, at Kibana uden X-Pack og uden Shield ikke giver mulighed for at adskille adgangen til logfilerne. Derfor valgte vi Graylog. Det er ikke mit favoritværktøj, men det fungerer. Vi købte nyt hardware, installerede den nyeste Graylog på det og flyttede alle logs med strenge formater til en særskilt Graylog. Vi har løst problemet med forskellige typer af identiske felter organisatorisk.
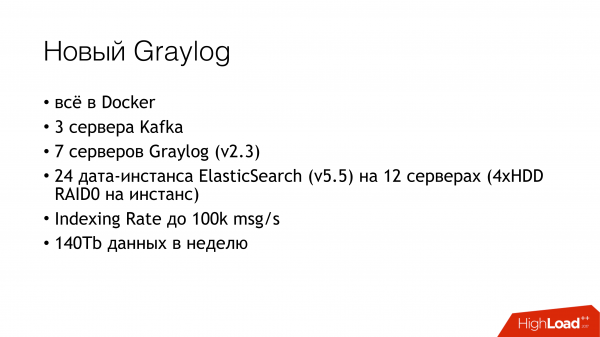
Hvad der faktisk er inkluderet i den nye Graylog. Vi har blot skrevet alt ned i Docker. Vi tog en masse servere, satte tre instanser af Kafka op og syv Graylog-servere version 2.3 (fordi vi ønskede Elasticsearch version 5). Alt dette blev kørt på RAID med HDD. Vi så en indekseringshastighed på op til 100.000 beskeder i sekundet. Vi så tallet 140 terabyte data om ugen.
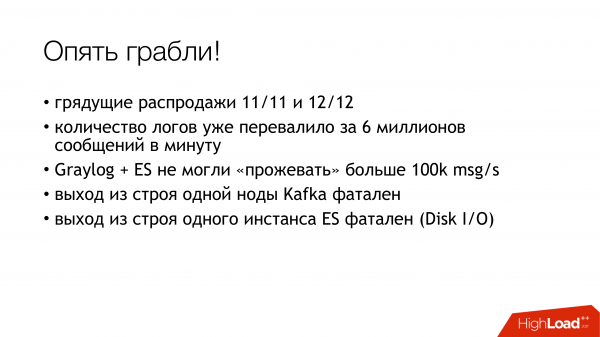
Og igen bump! Vi står over for to udsalg. Vi er flyttet over 6 millioner beskeder. Vores Graylog kan ikke følge med. Vi må finde en måde at overleve igen.
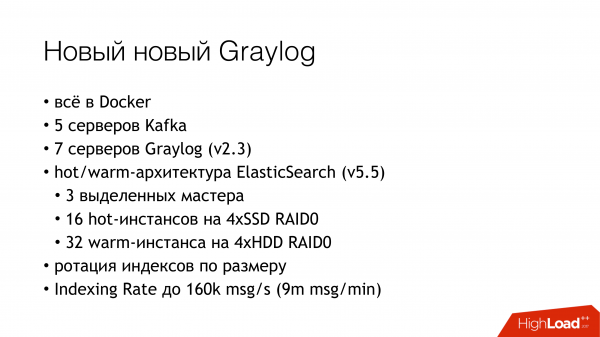
Sådan overlevede vi. Vi tilføjede et par ekstra servere og SSD'er. På nuværende tidspunkt lever vi på denne måde. Nu behandler vi allerede 160.000 beskeder i sekundet. Vi er endnu ikke nået op til grænsen, så det er ikke klart, hvor meget vi reelt kan trække ud af dette.
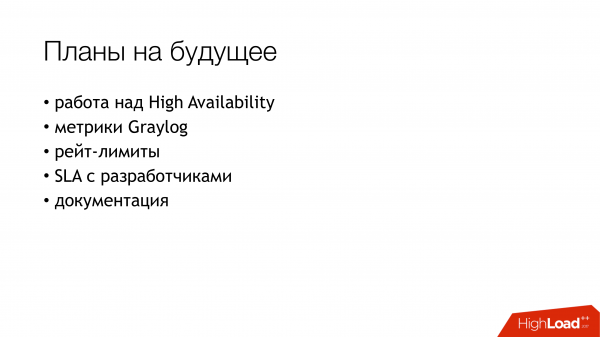
Sådan ser vores fremtidsplaner ud. Af dem er det sandsynligvis det vigtigste høj tilgængelighed. Vi har det ikke endnu. Flere maskiner er konfigureret ens, men alt går stadig gennem én maskine. Vi skal bruge tid på at konfigurere failover mellem dem.
Indsamle metrikker fra Graylog.
Implementere rate limiting, så vores én, der er blevet sindssyg API, ikke dræber vores båndbredde og alt andet.
Og endelig skrive en SLA med udviklerne om, at vi kan håndtere så meget. Hvis I skriver mere, så beklager vi.
Og skrive dokumentation.
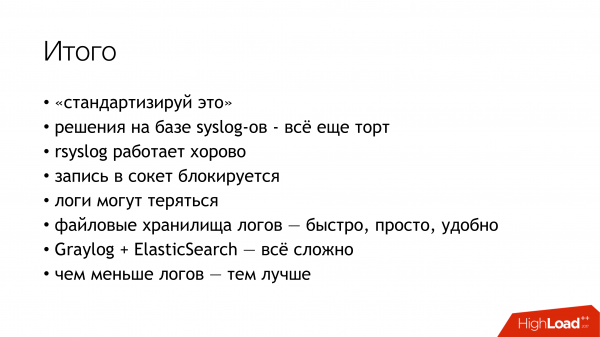
Kort opsummering af alt, hvad vi har gennemgået. For det første standarder. For det andet, syslog — kagen. For det tredje fungerer rsyslog præcis sådan, som det står på sliden. Lad os gå videre til spørgsmål.
Spørgsmål.
Spørgsmål: Hvorfor besluttede I så ikke at bruge… (filebeat?)
Svar: Man skal skrive til fil. Det var vi meget skeptiske overfor. Når din API skriver tusindvis af beskeder i sekundet, er det stadig ikke en løsning, selv hvis du roterer en gang i timen. Man kan skrive til en pipe. Til det spurgte udviklerne: "Hvad sker der, hvis processen, som vi skriver til, crasher?" Jeg fandt faktisk ikke et svar til dem og sagde: "Nå, okay, lad os lade være med at gøre det."
Spørgsmål: Hvorfor skriver du ikke logs direkte til HDFS?
Svar: Det er det næste skridt. Vi tænkte på det i starten, men da vi ikke har ressourcer til at arbejde på det i øjeblikket, hænger det som en langsigtet løsning.
Spørgsmål: Kolonneformatet ville være mere passende.
Svar: Jeg forstår det hele. Vi er 'for' med begge hænder.
Spørgsmål: Du skriver til rsyslog. Der kan man bruge både TCP og UDP. Men hvis man bruger UDP, hvordan garanterer du så leveringen?
Svar: Der er to aspekter. For det første informerer jeg straks alle om, at vi ikke garanterer leveringen af logs. Fordi når udviklerne kommer og siger: 'Lad os begynde at skrive finansielle data der, og så kan I gemme dem til senere, hvis noget går galt', svarer vi 'Fantastisk! Lad os sige, at I begynder at blokere for skrivningen til socket og laver det i transaktioner, så I garanterer, at I sender det til os, og at I er sikre på, at vi har modtaget det fra den anden side.' Og i det øjeblik bliver alle straks tilbageholdende. Og da de ikke ønsker det, hvad spørgsmål har vi så? Hvis I ikke ønsker at garantere skrivning til socket, hvorfor skal vi så garantere leveringen? Vi gør vores bedste. Vi forsøger virkelig at levere så meget som muligt og så godt som muligt, men vi giver ikke 100% garanti. Derfor skal der ikke skrives finansielle data der. Der er databaser med transaktioner til det.
Spørgsmål: Når API'en genererer en logbesked og videregiver kontrollen til mikrotjenesterne, har I så ikke oplevet problemer med, at beskeder fra forskellige mikrotjenester ankommer i forkert rækkefølge? Det kan skabe forvirring.
Svar: Det er normalt, at de ankommer i forskellig rækkefølge. Man skal være forberedt på det. For enhver netværkslevering garanterer ikke rækkefølgen, eller man skal bruge specielle ressourcer til det. Hvis vi tager filsystemer, gemmer hver API logs i sin egen fil. Eller rettere sagt, rsyslog opdeler dem i mapper. Hver API har sine egne logs, som du kan gå ind og se, og derefter kan du matche dem ved hjælp af timestamp i loggen. Hvis de går ind og ser i Graylog, så bliver de sorteret efter timestamp. Der vil alt være i orden.
Spørgsmål: Timestamp kan variere med millisekunder.
Svar: Timestamp genereres af selve API'en. Det er i grunden hele pointen. Vi har NTP. API'en genererer timestamp allerede i selve beskeden. Det tilføjes ikke af rsyslog.
Spørgsmål: Det er ikke helt klart, hvordan interaktionen mellem datacenterne fungerer. Inden for datacentret er det klart, hvordan loggene blev indsamlet og behandlet. Hvordan foregår interaktionen mellem datacenterne? Eller lever hvert datacenter sit eget liv?
Svar: Næsten. Hvert land er placeret i et bestemt datacenter. Vi har i øjeblikket ikke spredning, hvor et land er placeret i flere datacentre. Derfor behøver vi ikke at samle dem. Inden for hvert center er der en Log Relay. Det er en Rsyslog-server. Faktisk er der to administrationsmaskiner. De er indstillet ens. Men indtil videre går trafikken kun gennem den ene. Den aggregerer alle loggene. Den har en diskqueue i tilfælde af noget. Den komprimerer logs og sender dem til det centrale datacenter (i Singapore), hvor de derefter sendes til Graylog. Og hvert datacenter har sin egen filopbevaring. I tilfælde af, at vi mister forbindelsen, har vi alle loggene der. De vil forblive der. De vil blive gemt.
Spørgsmål: Får I logs derfra i nødsituationer?
Svar: Man kan gå derhen (til filopbevaringen) og se.
Spørgsmål: Hvordan overvåger I, at I ikke mister logs?
Svar: Vi mister dem faktisk, og vi overvåger det. Overvågningen blev startet for en måned siden. I biblioteket, der bruges af Go API, er der målinger. Den kan tælle, hvor mange gange den ikke kunne skrive til socket. Der er i øjeblikket en smart heuristik. Der er en buffer. Den forsøger at skrive beskeder fra den til socket. Hvis bufferen fyldes op, begynder den at droppe dem. Og tæller hvor mange den har droppet. Hvis tællerne begynder at fylde op, får vi besked om det. De går også til Prometheus, og i Grafana kan man se grafer. Man kan indstille advarsler. Men det er stadig uklart, hvem de skal sendes til.
Spørgsmål: I Elasticsearch opbevarer I logs med backup. Hvor mange replikaer har I?
Svar: Én replika.
Spørgsmål: Er det kun én replika?
Svar: Det er master og replika. Dataene opbevares i to eksemplarer.
Spørgsmål: Har I justeret størrelsen på rsyslog-bufferen på nogen måde?
Svar: Vi skriver datagrammer til en tilpasset unix socket. Dette pålægger os straks en begrænsning på 128 kilobyte. Vi kan ikke skrive mere til det. Vi har angivet dette i standarden. De, der ønsker at komme ind i lagrene, skriver 128 kilobyte. Bibliotekerne skærer faktisk ned og sætter et flag, der signalerer, at meddelelsen er blevet forkortet. I vores standard for selve meddelelsen er der et særligt felt, der viser, om det blev forkortet ved skrivning eller ej. Så vi har mulighed for at spore dette aspekt.
Spørgsmål: Skriver du korrupt JSON?
Svar: Korrupt JSON vil blive afvist enten under relay, fordi pakken er for stor. Eller det vil blive afvist af Graylog, fordi det ikke kan parse JSON. Men her er der nuancer, som skal rettes, og de er for det meste knyttet til rsyslog. Jeg har allerede indsendt et par issues der, som der stadig skal arbejdes på.
Spørgsmål: Hvorfor Kafka? Har du prøvet RabbitMQ? Kan Graylog ikke klare sådanne belastninger?
Svar: Vi kan ikke få det til at fungere med Graylog. Men Graylog fungerer for os. Det er en besværlig størrelse. Og faktisk er det ikke nødvendigt. Jeg ville foretrække at skrive direkte fra rsyslog til Elasticsearch og derefter se i Kibana. Men vi skal afklare spørgsmålene med sikkerhedsfolkene. Dette er en mulig udviklingsvej for os, når vi fjerner Graylog og bruger Kibana. Det vil ikke give mening at bruge Logstash. Fordi jeg kan gøre alt dette med rsyslog. Og det har en modul til at skrive til Elasticsearch. Vi forsøger at leve med Graylog. Vi har endda tweaket det lidt. Men der er stadig plads til forbedringer.
Om Kafka. Det er, som historien har udviklet sig. Da jeg kom, var det allerede der, og logfiler blev allerede skrevet til det. Vi rejste bare vores klynge op og flyttede loggene til den. Vi styrer det, vi ved, hvordan det har det. Om RabbitMQ... vi får det ikke til at fungere med RabbitMQ. Men vi får det til at fungere med RabbitMQ. Det er i produktionen, og der har været problemer med det. Lige nu, før udsalget, fik vi det til at fungere, og det begyndte at fungere normalt. Men før det var jeg ikke parat til at udgive det i produktion. Der er også et andet punkt. Graylog kan læse AMQP 0.9-versionen, mens rsyslog kan skrive AMQP 1.0-versionen. Der er ikke nogen løsning, der kan gøre begge dele. Det er enten det ene eller det andet. Derfor er der kun Kafka lige nu. Men der er også sine nuancer der. Fordi omkafka af den version af rsyslog, vi bruger, kan miste hele bufferet af beskeder, som den har hentet fra rsyslog. Indtil videre må vi leve med det.
Spørgsmål: Bruger du Kafka, fordi det allerede var der? Til ingen andre formål?
Svar: Den Kafka, der var, bruges af Data Science-teamet. Det er et helt separat projekt, som jeg desværre ikke kan sige noget om. Jeg er ikke opdateret. Det var under ledelse af Data Science-teamet. Da loggene blev oprettet, besluttede de at bruge det, så de ikke skulle installere deres egen. Nu har vi opdateret Graylog, og vi har mistet kompatibiliteten, fordi der var en gammel version af Kafka. Vi var nødt til at oprette vores egen. Samtidig blev vi fri for de fire emner for hver API. Vi lavede et bredt emne til alt live, et bredt emne til alt staging, og så sender vi bare alt derind. Graylog henter alt dette parallelt.
Spørgsmål: Hvad er det der behov for det her magi med sockets? Har I prøvet at bruge log-driver syslog til containerne.
Svar: På det tidspunkt, hvor vi stillede os selv dette spørgsmål, var vores forhold til Docker spændt. Det var Docker 1.0 eller 0.9. Docker i sig selv var mærkelig. For det andet, hvis man også skal stoppe logs i det… Jeg har en ubevist mistanke om, at den lader alle logs passere igennem sig, gennem Docker-dæmonen. Hvis vores API bliver skørt, så stopper de andre API’er op, fordi de ikke kan sende stdout og stderr. Jeg ved ikke, hvad det vil føre til. Jeg har en fornemmelse af, at man ikke burde bruge Docker's syslog-driver her. Vores afdeling for funktionel test har sin egen lille Graylog-klynge med logs. De bruger Docker-logdrivere, og det ser ud til at fungere fint. Men de skriver direkte GELF til Graylog. På det tidspunkt, da vi startede det hele, havde vi bare brug for, at det fungerede. Måske senere, når nogen siger, at det har fungeret fint i lang tid, vil vi prøve det.
Spørgsmål: I gør leveringen mellem datacentrer med rsyslog. Hvorfor ikke med Kafka?
Svar: Vi gør faktisk begge dele. Af to grunde. Hvis kanalen er helt nede, så kan vores logs, selv i komprimeret format, ikke komme igennem. Og Kafka tillader os simpelthen at miste dem undervejs. På den måde slipper vi for, at logs sidder fast. I dette tilfælde bruger vi Kafka direkte. Hvis vores kanal er god, og vi ønsker at frigøre den, så bruger vi rsyslog. Men man kan faktisk indstille rsyslog til at droppe det, der ikke kan komme igennem. I øjeblikket bruger vi så nogle steder rsyslog direkte, og andre steder Kafka.
Kilde: habr.com
