

Introduktion til operativsystemer
Hej, Habr! Jeg vil gerne præsentere for dig en serie af artikeloversættelser af en interessant litteratur — OSTEP. Dette materiale undersøger grundigt, hvordan unix-lignende operativsystemer fungerer, nemlig hvordan man arbejder med processer, forskellige scheduler, hukommelse og andre lignende komponenter, der udgør et moderne OS. Originalen af alt materiale kan du se her . Vær opmærksom på, at oversættelsen er lavet uprofessionelt (temmelig frit), men jeg håber, at jeg har bevaret den overordnede mening.
Laboratoriearbejder om dette emne kan findes her:
Andre dele:
Og du kan også tjekke min kanal på =)
Planlægningsmetode: Multi-Level Feedback Queue
I denne lektion vil vi diskutere problemerne med at udvikle en af de mest kendte metoder til
planlægning, som kaldes Multi-Level Feedback Queue (MLFQ). MLFQ-scheduler blev første gang beskrevet i 1962 af Fernando J. Corbató i et system kaldet
Compatible Time-Sharing System (CTSS). Disse arbejder (herunder senere arbejder på
Multics) blev efterfølgende præsenteret til Turing Award. Scheduler blev
senere forbedret og fik et udseende, som man allerede kan finde i
nogle moderne systemer.
MLFQ-algoritmen forsøger at løse 2 grundlæggende overlappende problemer.
For det første, den forsøger at optimere omsætningshastigheden, som vi har gennemgået i den tidligere lektion, og som optimeres ved at køre de
korteste opgaver i starten af køen. Desværre ved OS ikke, hvor længe en given proces vil køre, hvilket er
nødvendig viden for drift af SJF- og STCF-algoritmer. For det andet, MLFQ forsøger
at gøre systemet responsivt for brugerne (for eksempel dem, der sidder og
stirrer på skærmen i forventning om at opgaven afsluttes) og dermed minimere
respons tiden. Desværre reducerer algoritmer som RR respons tiden, men har en meget
negativ indvirkning på omsætningshastighedsmetrikken. Her er vores problem: Hvordan designer man
en scheduler, der opfylder vores krav, uden at vide noget om
processens karakter generelt? Hvordan kan en scheduler lære opgavens egenskaber,
som den kører, og dermed træffe bedre beslutninger om planlægning?
Essensen af problemet: Hvordan planlægger man opgaveplacering uden en perfekt viden?
Hvordan udvikler man en scheduler, der samtidig minimerer respons tiden
for interaktive opgaver og samtidig minimerer omsætningstiden uden forudgående
viden om opgavens udførelsestid?
Bemærk: Lærer af tidligere hændelser
MLFQ-kø er et glimrende eksempel på et system, der lærer af
tidligere hændelser for at forudsige fremtiden. Sådanne metoder ses ofte
i OS (og mange andre områder inden for datalogi, herunder forudsigelser i hardware og caching algoritmer). Sådanne tilgange
fungerer, når opgaver har adfærdsmæssige faser og dermed er forudsigelige.
aktiveres, når opgaver har adfærdsmæssige faser og dermed er forudsigelige.
Men med sådan teknologi skal man være forsigtig, fordi forudsigelser meget let
kan vise sig at være forkerte og føre systemet til at træffe dårligere beslutninger end
hvis der slet ikke var nogen viden.
MLFQ: Grundlæggende regler
Lad os overveje de grundlæggende regler for MLFQ-algoritmen. Og selvom der findes flere
implementeringer af denne algoritme, er de grundlæggende tilgange ens.
I den implementering, vi vil se på, vil MLFQ have flere
separat køer, hver med en anden prioritet. På ethvert tidspunkt
befinder en opgave, der er klar til udførelse, sig i en af køerne. MLFQ anvender prioriteter
for at afgøre, hvilken opgave der skal køres, dvs. opgaven med højere
prioritet (opgaven fra køen med højeste prioritet) vil blive startet først.
Der kan uden tvivl være mere end én opgave i en given kø, således at de
vil have samme prioritet. I dette tilfælde vil RR-mekanismen blive anvendt
til planlægning af kørsel blandt disse opgaver.
Dermed når vi frem til to grundlæggende regler for MLFQ:
Regel 1: Hvis Prioritet(A) > Prioritet(B), vil opgave A blive startet (B vil ikke)
- Regel 2: Hvis Prioritet(A) = Prioritet(B), vil A og B blive startet ved hjælp af RR
- I henhold til ovenstående er de vigtigste elementer i MLFQ-planlægning
prioriteter. I stedet for at tildele en fast prioritet til hver
opgave, ændrer MLFQ dens prioritet baseret på observeret adfærd.
For eksempel, hvis en opgave konstant holder CPU'en besk忙et i ventetid for input fra tastaturet,
vil MLFQ holde prioriteten for processen på et højt niveau, fordi det er sådan,
en interaktiv proces skal fungere. Men hvis opgaven derimod konstant og
intensivt bruger CPU'en i længere tid, vil MLFQ sænke dens
prioritet. Dermed vil MLFQ lære processernes adfærd i løbet af deres kørsel
og anvende adfærden.
Lad os skitsere et eksempel på, hvordan køerne kunne se ud på et givent
tidspunkt, og så ville det se nogenlunde sådan ud:
I dette diagram er der 2 processer A og B i køen med den højeste prioritet. Processen
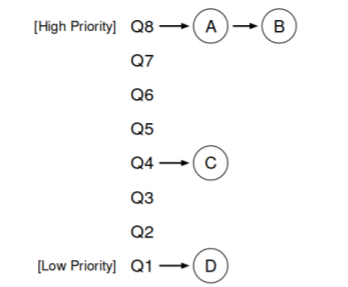
C er et sted midt imellem, mens processen D er i bunden af køen. I henhold til de ovenstående
beskrivelser vil MLFQ-planlæggeren kun udføre opgaver med den højeste prioritet.
beskrivelserne af MLFQ-algoritmen vil planlæggeren kun udføre opgaver med den højeste prioritet.
prioritet i henhold til RR, mens opgaverne C og D vil ikke blive forfulgt.
Selvfølgelig giver et statisk snapshot ikke det fulde billede af, hvordan MLFQ fungerer.
Det er vigtigt at forstå, hvordan billedet ændrer sig over tid.
Forsøg 1: Hvordan ændrer man prioritet
På dette tidspunkt er det nødvendigt at beslutte, hvordan MLFQ vil ændre prioriteringsniveauet
for opgaver (og dermed opgavens placering i køen) i løbet af dens livscyklus. For
dette er det nødvendigt at have arbejdsprocessen in mente: et bestemt antal
interaktive opgaver med kort arbejdstid (og dermed hyppig frigivelse af
CPU) og flere lange opgaver, der bruger CPU i hele deres arbejdstid, mens
respons tiden for disse opgaver ikke er vigtig. Og således kan man gøre det første forsøg
på at implementere MLFQ-algoritmen med følgende regler:
- Regel 3: Når en opgave tilføjes systemet, placeres den i køen med den højeste
- prioritet til Ingester.
- Regel 4a: Hvis en opgave bruger hele den tildelte tidsvindue, sænkes dens
- prioritet.
- Regel 4b: Hvis en opgave frigiver CPU før udløbet af sit tidsvindue, forbliver den
- med den samme prioritet.
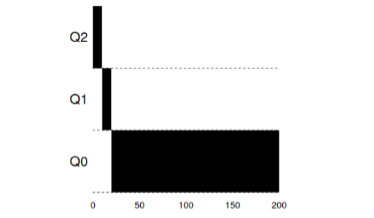
Eksempel 1: En enkelt langvarig opgave
Som det fremgår af dette eksempel, starter opgaven ved at få den højeste
prioritet. Efter et tidsvindue på 10 ms sænkes prioriteten af planlæggeren.
Efter det næste tidsvindue sænkes opgaven endelig til
den laveste prioritet i systemet, hvor den forbliver.
Eksempel 2: En kort opgave introduceres
Lad os nu se et eksempel på, hvordan MLFQ forsøger at nærme sig SJF. I dette
eksempel er der to opgaver: A, som er en langvarig opgave, der konstant
beskæftiger CPU, og B, som er en kort interaktiv opgave. Antag,
at A allerede har kørt et stykke tid, da opgave B ankommer.
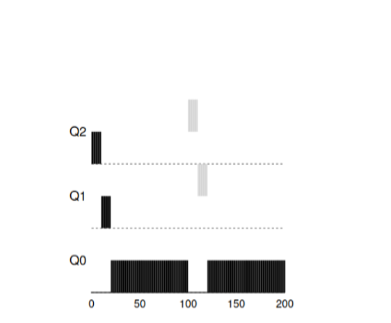
På dette diagram kan resultaterne af scenariet ses. Opgave A, ligesom enhver opgave,
der bruger CPU, befinder sig i bunden. Opgave B vil ankomme på tid T=100 og vil
blive placeret i køen med den højeste prioritet. Da dens arbejdstid ikke er lang,
vil den blive afsluttet, før den når den sidste kø.
Fra dette eksempel skal man forstå hovedmålet med algoritmen: da algoritmen ikke
ved, om en opgave er lang eller kort, antager den først, at opgaven
kort og tildeler den højeste prioritet. Hvis det virkelig er en kort opgave, så
vil den blive udført hurtigt, ellers hvis det er en lang opgave, så vil den bevæge sig langsomt
nedad i prioriteten og snart bevise, at det virkelig er en langvarig opgave, der ikke
kræver respons.
Eksempel 3: Hvad med ind- og uddata?
Lad os nu se på et eksempel med ind- og uddata. Som nævnt i regel 4b,
hvis en proces frigiver CPU'en uden at have brugt hele sin CPU-tid,
forbliver den på det samme prioriteringsniveau. Hensigten med denne regel er ret enkel
— hvis en interaktiv opgave udfører mange ind- og uddataoperationer, for eksempel venter
på brugerens tastetryk eller mus, vil en sådan opgave frigive CPU'en
før det tildelte vindue. Vi ønsker ikke at sænke prioriteten for en sådan opgave,
og således vil den forblive på det samme niveau.
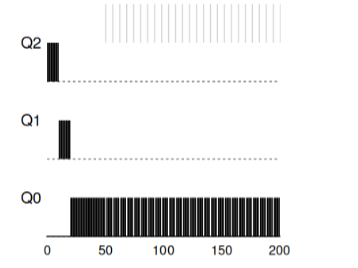
Dette eksempel viser, hvordan algoritmen vil arbejde med sådanne processer — interaktiv opgave B, der kun har brug for CPU i 1 ms før udførelsen
af input-output-processen og den langvarige opgave A, der bruger CPU hele sin tid.
MLFQ holder proces B med højeste prioritet, fordi den fortsætter med
at frigive CPU'en. Hvis B er en interaktiv opgave, har algoritmen i dette tilfælde opnået
sit mål med hurtigt at køre interaktive opgaver.
Problemer med den nuværende MLFQ-algoritme
I de tidligere eksempler byggede vi en grundlæggende version af MLFQ. Og det ser ud til, at den
gør sit arbejde godt og retfærdigt, ved rimeligt at fordele CPU-tid mellem
lange opgaver og lader korte opgaver eller opgaver, der intensivt bruger
ind- og uddataarbejde hurtigt. Desværre har denne tilgang flere
alvorlige problemer.
For det første, sultproblemet: hvis der er mange interaktive
opgaver i systemet, vil de bruge al CPU-tid, og således får ingen lang
opgave mulighed for at blive udført (de sulter).
For det andet, smarte brugere kunne skrive deres programmer på en måde, der
snyder planlæggeren. Snydet består i at gøre noget, så planlæggeren
giver processen mere CPU-tid. Algoritmen, der
beskrevet ovenfor er ganske sårbar over for sådanne angreb: før tidsvinduet næsten
er udløbet, skal der udføres en input-output-operation (til en hvilken som helst, uanset hvilken fil)
og derved frigive CPU'en. En sådan adfærd vil gøre det muligt at forblive i den samme
kø og igen få en større procentdel af processortiden. Hvis dette gøres
korrekt (for eksempel køre 99% af tiden i vinduet før frigivelse af CPU'en),
kan en sådan opgave simpelthen monopolisere processoren.
Endelig kan programmet ændre sin adfærd over tid. De opgaver,
der brugte CPU'en, kan blive interaktive. I vores eksempel vil sådanne
opgaver ikke få den rette behandling fra planlæggeren, da de ville have fået andre
(oprindelige) interaktive opgaver.
Spørgsmål til salen: hvilke angreb på planlæggeren kunne der udføres i den moderne verden?
Forsøg 2: Prioritetsforøgelse
Lad os prøve at ændre reglerne og se, om vi kan undgå problemer med
sult. Hvad kunne vi gøre for at sikre, at de CPU-relaterede
opgaver får deres tid (selvom det ikke er længe).
Som en simpel løsning på problemet kan man foreslå at
periodisk øge prioriteten af alle sådanne opgaver i systemet. Der er mange måder
at opnå dette, lad os prøve at implementere noget simpelt som eksempel: at ændre
alle opgaver til den højeste prioritet, nedenfor er den nye regel:
- Regel5: Efter en vis periode S, ændre alle opgaver i systemet til den højeste kø.
Vores nye regel løser to problemer på én gang. For det første
er processerne garanteret ikke sultne: opgaver, der befinder sig i den højeste kø, vil dele
processortid ifølge RR-algoritmen, og dermed får alle processer
processortid. For det andet, hvis en proces, der tidligere kun brugte
processoren, bliver interaktiv, vil den forblive i køen med højere
prioritet, efter at den engang har fået en prioriteringsforøgelse til den højeste.
Lad os tage et eksempel. I dette scenarie overvejer vi én proces, der bruger
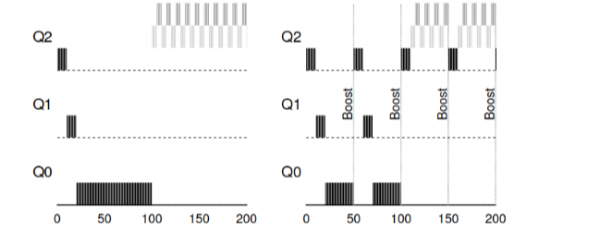
CPU og to interaktive, korte processer. Til venstre viser billedet adfærden uden prioriteringsforøgelse, hvilket betyder, at de lange opgaver begynder at sulte, efter at der ankommer to interaktive opgaver til systemet. Til højre udføres der en prioriteringsforøgelse hvert 50 ms, hvilket sikrer, at alle processer får processor tid og periodisk udføres. 50 ms er her et eksempel; i virkeligheden er dette tal en smule højere.
Det er tydeligt, at tilføjelsen af tid til den periodiske forøgelse S fører til
det naturlige spørgsmål: hvilken værdi skal fastsættes? En anerkendt
systemingeniør, John Ousterhout, kaldte sådanne størrelser i systemer for voo-doo
konstant, da de på en måde krævede lidt magi for at blive korrekt
fastsat. Og desværre har S sådan en aroma. Hvis værdien sættes for højt,
begynder de lange opgaver at sulte. Og hvis værdien sættes for lavt,
vil de interaktive opgaver ikke få tilstrækkelig processor tid.
Forsøg 3: Bedre regnskab
Nu har vi endnu et problem, vi skal løse: hvordan undgår vi
at vores planlægger bliver snydt? Skyld er reglerne 4a, 4b, som tillader opgaven at bevare prioriteten ved at frigive processoren
indtil den tildelte tid udløber. Hvordan håndterer vi det?
Løsningen i dette tilfælde kan betragtes som en forbedret regnskabsføring af CPU-tid på hvert
niveau af MLFQ. I stedet for at glemme den tid, som programmet har brugt
processoren i det tildelte interval, bør vi tage højde for og bevare den. Efter at
processen har brugt den tildelte tid, bør vi sænke dens prioritet til den næste
prioritetsniveau. Nu er det ligegyldigt, hvordan processen bruger sin tid — om
den kører konstant på processoren eller gennem mange opkald. Således,
bør vi omskrive regel 4 til følgende:
Regel 4
- : Når en opgave har brugt sin tildelte tid i den aktuelle kø (uanset hvor mange gange den har frigivet CPU'en) sænkes prioriteten for denne opgave (den bevæger sig ned ad køen).Lad os se på et eksempel:
Billedet viser, hvad der sker, hvis man forsøger at snyde planlæggeren, ligesom
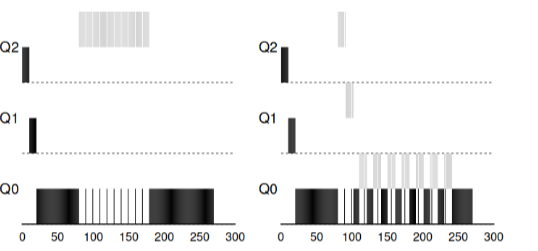 »
Billedet viser, hvad der sker, hvis man forsøger at narre planlæggeren, som
hvis det var med de tidligere regler 4a, 4b ville resultatet til venstre komme ud. Med den nye
regel - resultatet til højre. Før beskyttelse kunne enhver proces forårsage I/O indtil afslutningen og
dermed dominere CPU'en, efter aktivering af beskyttelse, uanset adfærden af
I/O, vil det stadig falde ned i køerne og således ikke være i stand til uretfærdigt
at overtage CPU-ressourcer.
Forbedrer MLFQ og andre problemer
Med de ovennævnte forbedringer opstår nye problemer: et af de vigtigste
spørgsmål er - hvordan skal en sådan scheduler parametriseres? Dvs. Hvor mange skal der være
køer? Hvad skal størrelsen på arbejdsvinduet være inden for køen? Hvor
ofte skal programmets prioritet hæves for at undgå sult og
tage hensyn til ændringer i programmets adfærd? Der er ikke noget simpel
svar på disse spørgsmål, og kun eksperimenter med belastninger og efterfølgende konfiguration
af scheduler kan føre til en eller anden tilfredsstillende balance.
For eksempel tillader de fleste implementeringer af MLFQ tildeling af forskellige
tidsintervaller til forskellige køer. Højt prioriterede køer tildeles normalt korte intervaller.
Disse køer består af interaktive opgaver,
hvor skift mellem dem er ret følsomt og bør tage 10 millisekunder eller mindre.
Modsat består lavprioriterede køer af lange opgaver, der bruger
CPU'en. Og i dette tilfælde er lange tidsintervaller meget velegnede (100 ms).
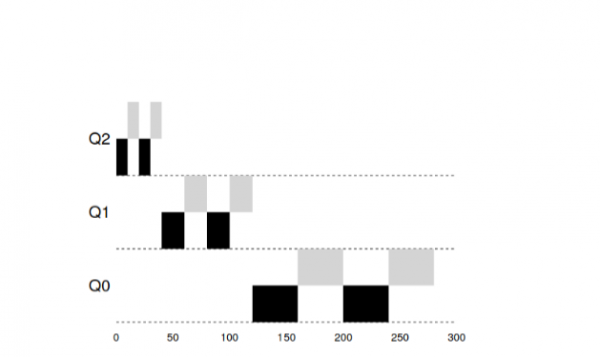
I dette eksempel er der 2 opgaver, der har arbejdet i den højt prioriterede kø i 20
ms, opdelt i vinduer på 10 ms. 40 ms i den mellemste kø (vindue på 20 ms) og i den lavprioriterede
kø blev det tidsvindue 40 ms, hvor opgaverne afsluttede deres arbejde.
Implementeringen af MLFQ i Solaris OS er en klassisk scheduler, der deler tid.
Scheduler'en giver et sæt tabeller, der præcist angiver, hvordan
prioriteten for processen skal ændres over tid, hvad størrelse
det tildelte vindue skal have, og hvor ofte prioriteringer af opgaven skal hæves. Systemadministratoren
kan interagere med denne tabel og få scheduler'en til at opføre sig
anderledes. Som standard har denne tabel 60 køer med gradvist stigende
vinduesstørrelser fra 20 ms (høj prioritet) op til flere hundrede ms (lav prioritet), og
og med en boost af alle opgaver hver sekund.
Andre MLFQ-planlæggere bruger ikke tabeller eller specifikke
regler, som beskrevet i dette foredrag; i stedet beregner de prioriteter ved hjælp af
matematiske formler. For eksempel bruger planlæggeren i FreeBSD en formel til
at beregne den aktuelle prioritet for en opgave, baseret på hvor meget processoren
har brugt CPU. Derudover falder CPU-brug over tid, og dermed sker der en
ændring i prioriteten lidt anderledes end beskrevet ovenfor. Dette kaldes
decay-algoritmer. Fra version 7.1 har FreeBSD ULE-planlæggeren.
Endelig har mange planlæggere andre funktioner. For eksempel reserverer nogle
planlæggere de højeste niveauer til operationelle systemopgaver, og derfor kan
ingen brugerprocesser opnå den højeste prioritet i
systemet. Nogle systemer tillader at give råd for at hjælpe
planlæggeren med at fastsætte prioriteter korrekt. For eksempel kan man med en kommando nice
øge eller reducere prioriteten for en opgave, og dermed øge eller
nedsætte programmets chancer for CPU-tid.
MLFQ: Konklusioner
Vi har beskrevet en tilgang til planlægning kaldet MLFQ. Navnet
stammer fra princippet om, at den har flere køer og bruger feedback
til at bestemme opgaveprioriteten.
De endelige regler vil være som følger:
- Regel 1: Hvis prioritet(A) > Prioritet(B), vil opgave A blive startet (B ikke)
- Regel 2: Hvis prioritet(A) = Prioritet(B), startes A og B ved hjælp af RR
- Regel 3: Når en opgave ankommer til systemet, placeres den i den kø med den højeste prioritet.
- : Når en opgave har brugt sin tildelte tid i den aktuelle kø (uanset hvor mange gange den har frigivet CPU'en) sænkes prioriteten for denne opgave (den bevæger sig ned ad køen).Lad os se på et eksempel:
- Regel5: Efter en vis periode S, ændre alle opgaver i systemet til den højeste kø.
MLFQ er interessant af følgende grund - i stedet for at kræve kendskab til
opgavens karakter på forhånd, lærer algoritmen opgavens tidligere adfærd og fastsætter
prioriteterne derefter. Dermed forsøger den at sidde på to stole - at opnå ydeevne for små opgaver (SJF, STCF) og retfærdigt køre lange,
CPU-intensive opgaver. Derfor bruger mange systemer, herunder BSD og deres afledte versioner,
Solaris, Windows, Mac som planlægger en eller anden form for algoritme
MLFQ som basis.
Additional materials:
- (computing)
Kilde: habr.com
