

Hej, Habr! I dag skal vi bygge et system, der ved hjælp af Spark Streaming vil behandle beskedstrømme fra Apache Kafka og gemme resultaterne i en cloud-database, AWS RDS.
Lad os forestille os, at en kreditinstitution stiller os opgaven at behandle indkommende transaktioner "on the fly" i alle deres filialer. Dette kan gøres med det formål at beregne den åbne valuta-position for kassen, grænser eller det økonomiske resultat af handler osv.
Hvordan man realiserer denne brugssag uden at anvende magi og trylleformularer - læs videre! Lad os komme i gang!
Introduktion
Uden tvivl giver behandlingen af et stort datamængde i realtid omfattende muligheder for brug i moderne systemer. En af de mest populære kombinationer til dette er tandem Apache Kafka og Spark Streaming, hvor Kafka skaber en strøm af indkommende beskeder, mens Spark Streaming behandler disse pakker indenfor et bestemt tidsinterval.
For at øge applikationens fejltolerance vil vi bruge kontrolpunkter - checkpoints. Ved hjælp af denne mekanisme, når Spark Streaming-modulet skal genoprette tabte data, vil det kun være nødvendigt at vende tilbage til det seneste kontrolpunkt og genoptage beregningerne derfra.
Arkitekturen for det udviklede system
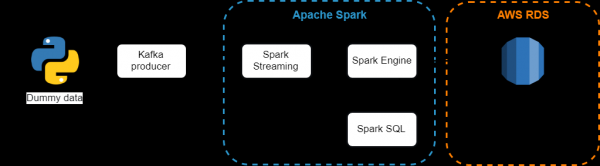
Brugte komponenter:
- — det er et distribueret beskedudvekslingssystem med publicering og abonnement. Det er egnet både til autonom og online forbrug af beskeder. For at forhindre datatab gemmes beskeder fra Kafka på disk og replikeres indenfor klyngen. Kafka-systemet er bygget oven på synkroniseringstjenesten ZooKeeper;
- — komponenten Spark til behandling af streamede data. Spark Streaming-modulet er bygget med en "micro-batch" arkitektur, hvor streamen af data fortolkes som en kontinuerlig sekvens af små datapakker. Spark Streaming modtager data fra forskellige kilder og samler dem i små pakker. Nye pakker oprettes med regelmæssige tidsintervaller. I begyndelsen af hvert tidsinterval oprettes en ny pakke, og alle data, der er modtaget i løbet af dette interval, inkluderes i pakken. Ved slutningen af intervallet stopper stigningen af pakke. Størrelsen af intervallet bestemmes af en parameter kaldet batch interval;
- — kombinerer relationel behandling med funktionel programmering i Spark. Med strukturerede data menes der data, der har et skema, det vil sige et ensartet sæt felter for alle poster. Spark SQL understøtter input fra mange kilder til strukturerede data og takket være tilgængeligheden af skema-information kan det effektivt udtrække kun de nødvendige felter fra posterne samt levere DataFrame API'er;
- — det er en relativt billig cloud-relational database, en webservice der forenkler opsætningen, driften og skaleringen, administreres direkte af Amazon.
Installation og opstart af Kafka-server
Før brug af Kafka skal man sikre, at Java er tilgængelig, da JVM anvendes:
sudo apt-get update
sudo apt-get install default-jre
java -version
Lad os oprette en ny bruger til at arbejde med Kafka:
sudo useradd kafka -m
sudo passwd kafka
sudo adduser kafka sudo
Derefter downloader vi distributionen fra Apache Kafka's officielle hjemmeside:
wget -P /YOUR_PATH "http://apache-mirror.rbc.ru/pub/apache/kafka/2.2.0/kafka_2.12-2.2.0.tgz"Udpak den downloadede arkiv:
tar -xvzf /YOUR_PATH/kafka_2.12-2.2.0.tgz
ln -s /YOUR_PATH/kafka_2.12-2.2.0 kafka
Det næste skridt er valgfrit. Faktisk tillader standardindstillingerne ikke fuld anvendelse af alle muligheder i Apache Kafka. For eksempel at slette emner, kategorier, grupper, som meddelelser kan offentliggøres til. For at ændre dette redigerer vi konfigurationsfilen:
vim ~/kafka/config/server.propertiesTilføj følgende til slutningen af filen:
delete.topic.enable = trueInden du starter Kafka-serveren, skal ZooKeeper-serveren startes. Vi bruger et hjælpeprogram, der leveres med Kafka-distributionen:
Cd ~/kafka
bin/zookeeper-server-start.sh config/zookeeper.properties
Når ZooKeeper er startet korrekt, starter vi Kafka-serveren i et separat terminalvindue:
bin/kafka-server-start.sh config/server.propertiesLad os oprette et nyt emne kaldet Transaction:
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic transactionLad os sikre os, at emnet er oprettet med det rette antal partitioner og replikering:
bin/kafka-topics.sh --describe --zookeeper localhost:2181 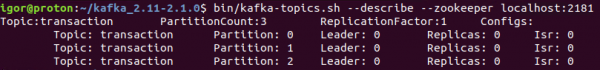
Vi udelader testøjeblikke for producenten og forbrugeren til det nyligt oprettede emne. Mere detaljeret om, hvordan man kan teste sending og modtagelse af beskeder, står i den officielle dokumentation — . Men vi går videre til at skrive producenten i Python ved hjælp af KafkaProducer API.
Skrive en producent
Producenten vil generere tilfældige data — 100 beskeder hvert sekund. Med tilfældige data mener vi et ordforråd bestående af tre felter:
- Filial — navnet på salgsstedet for kreditinstitutionen;
- Currency — valutaen for transaktionen;
- Amount — beløbet for transaktionen. Beløbet vil være et positivt tal, hvis det er et køb af valuta fra banken, og negativt hvis det er et salg.
Koden til producenten ser således ud:
from numpy.random import choice, randint

def get_random_value():
    new_dict = {}

    branch_list = ['Kazan', 'SPB', 'Novosibirsk', 'Surgut']
    currency_list = ['RUB', 'USD', 'EUR', 'GBP']

    new_dict['branch'] = choice(branch_list)
    new_dict['currency'] = choice(currency_list)
    new_dict['amount'] = randint(-100, 100)

    return new_dict
Derefter, ved hjælp af metoden send, sender vi en besked til serveren i det ønskede emne, i JSON-format:
from kafka import KafkaProducer

producer = KafkaProducer(bootstrap_servers=['localhost:9092'],
                             value_serializer=lambda x:dumps(x).encode('utf-8'),
                             compression_type='gzip')
my_topic = 'transaction'
data = get_random_value()

try:
    future = producer.send(topic = my_topic, value = data)
    record_metadata = future.get(timeout=10)

    print('--> Beskeden er sendt til et emne:
            {}, partition: {}, offset: {}'
            .format(record_metadata.topic,
                record_metadata.partition,
                record_metadata.offset ))

except Exception as e:
    print('--> Det ser ud til, at der er opstået en fejl: {}'.format(e))

finally:
    producer.flush()
Når scriptet køres, får vi følgende beskeder i terminalen:
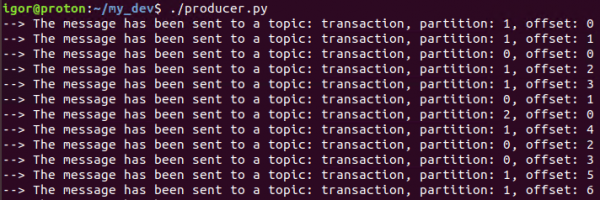
Det betyder, at alt fungerer, som vi ønskede — producenten genererer og sender beskeder til det ønskede emne.
Næste skridt bliver at installere Spark og behandle denne strøm af beskeder.
Installation af Apache Spark
Apache Spark — er en alsidig og højtydende cluster computing platform.
I forhold til ydeevne overgår Spark populære implementeringer af MapReduce-modellen, samtidig med at der tilbydes support til et bredere udvalg af beregningstyper, herunder interaktive forespørgsler og streamingbehandling. Hastigheden spiller en vigtig rolle i behandlingen af store datamængder, da det netop er hastigheden, der muliggør interaktiv drift uden at bruge minutter eller timer på at vente. En af Spark's vigtigste fordele, der muliggør så høj hastighed, er evnen til at udføre beregninger i hukommelsen.
Denne ramme er skrevet i Scala, så det er nødvendigt først at installere det:
sudo apt-get install scalaDownload distributionen af Spark fra det officielle websted:
wget "http://mirror.linux-ia64.org/apache/spark/spark-2.4.2/spark-2.4.2-bin-hadoop2.7.tgz"Udpak arkivet:
sudo tar xvf spark-2.4.2/spark-2.4.2-bin-hadoop2.7.tgz -C /usr/local/sparkTilføj stien til Spark i bash-filen:
vim ~/ .bashrcTilføj følgende linjer gennem editoren:
SPARK_HOME=/usr/local/spark
export PATH=$SPARK_HOME/bin:$PATH
Kør kommandoen nedenfor efter at have foretaget ændringerne i bashrc:
source ~/ .bashrcUdrulning af AWS PostgreSQL
Det er tilbage at udrulle databasen, hvor vi vil indlæse de behandlede oplysninger fra strømme. For dette vil vi bruge tjenesten AWS RDS.
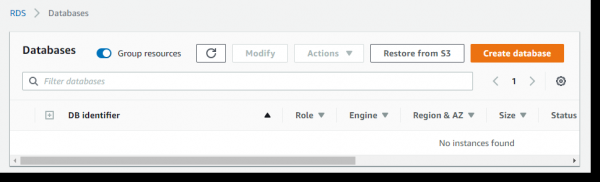
Gå til AWS konsollen —> AWS RDS —> Databases —> Opret database:
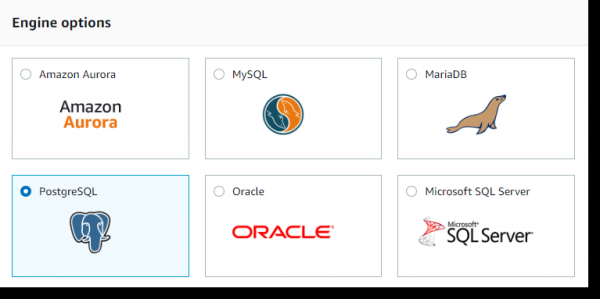
Vælg PostgreSQL og klik på knappen Næste:
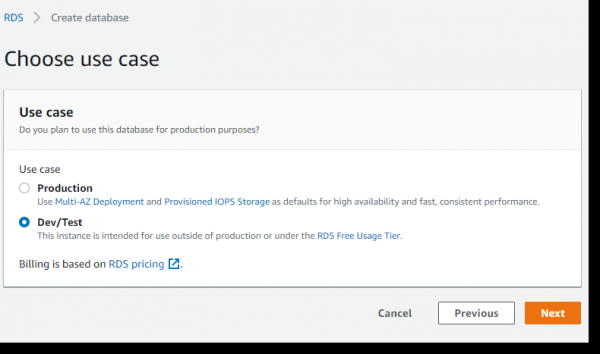
Da dette eksempel kun behandles til uddannelsesmæssige formål, vil vi bruge en gratis server "på minimumsniveau" (Free Tier):
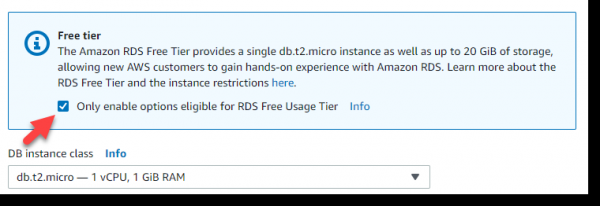
Derefter markerer vi afkrydsningsfeltet i blokken Free Tier, og efter dette vil vi automatisk få tilbudt en instans af typen t2.micro — selvom den er lidt svag, så er den gratis og helt passende til vores opgave:
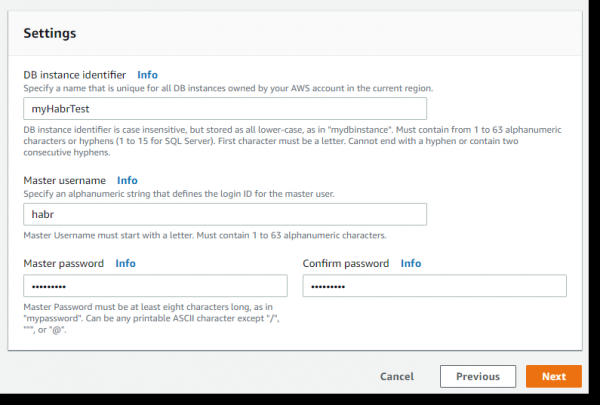
Dernæst er der meget vigtige oplysninger: navnet på DB-instansen, navnet på master-brugeren og dens adgangskode. Vi kalder instansen: myHabrTest, master-bruger: habr, adgangskoden: habr12345 og klikker på knappen Næste:
På den næste side findes indstillingerne, der bestemmer tilgængeligheden af vores DB-server udefra (Public accessibility) og tilgængeligheden af porte:
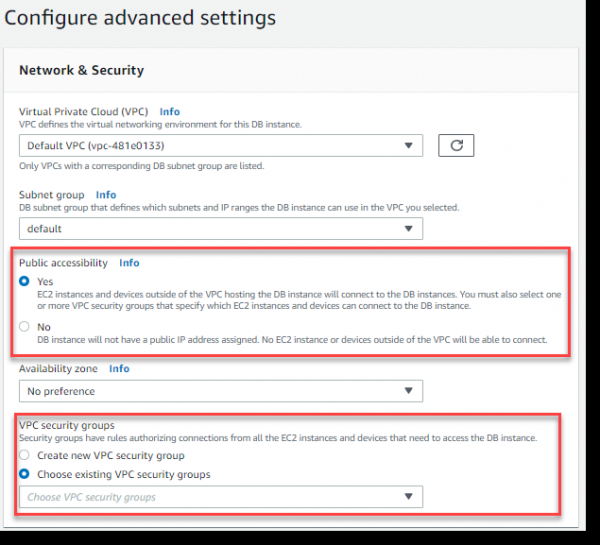
Lad os oprette en ny indstilling for VPC security group, der tillader udefra adgang til vores DB-server via port 5432 (PostgreSQL).
Lad os åbne et nyt browservindue til AWS-konsollen i afsnittet VPC Dashboard —> Security Groups —> Opret security group:
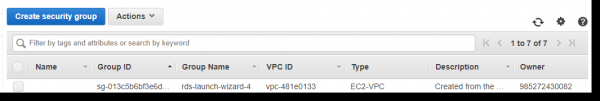
Vi angiver et navn til sikkerhedsgruppen — PostgreSQL, en beskrivelse, angiver hvilken VPC denne gruppe skal være knyttet til, og klikker på knappen Opret:

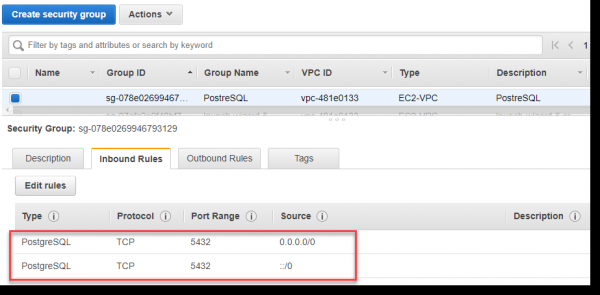
Vi udfylder for den nyoprettede gruppe Indgående regler for port 5432, som vist på billedet nedenfor. Man behøver ikke at indtaste porten manuelt, men kan vælge PostgreSQL fra rullelisten Type.
Strengt taget betyder værdien ::/0 tilgængeligheden af indgående trafik til serveren fra hele verden, hvilket kan anses for at være lidt misvisende, men for eksemplets skyld vil vi tillade os at bruge denne tilgang:
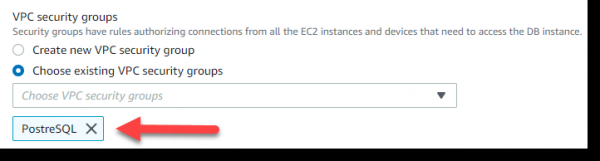
Vi vender tilbage til browserens side, hvor vi har åbnet «Konfigurer avancerede indstillinger» og vælger i afsnittet VPC-sikkerhedsgrupper —> Vælg eksisterende VPC-sikkerhedsgrupper —> PostgreSQL:
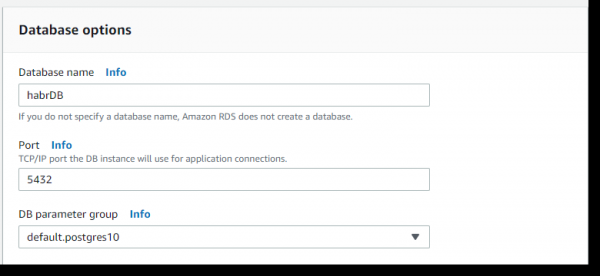
Dernæst i afsnittet Databaseindstillinger —> Database navn —> angiver vi navnet — habrDB.
De øvrige parametre, bortset fra måske deaktivering af sikkerhedskopiering (backup retention period — 0 dage), overvågning og Performance Insights, kan vi lade stå som standard. Vi klikker på knappen Opret database:
Stream behandler
Det afsluttende trin vil være udviklingen af en Spark-job, der hver anden sekund behandler nye data, der kommer fra Kafka, og indsætter resultatet i databasen.
Som nævnt tidligere er kontrolpunkter (checkpoints) den primære mekanisme i Spark Streaming, som skal konfigureres for at sikre fejltolerance. Vi vil bruge kontrolpunkter, og i tilfælde af, at proceduren fejler, vil Spark Streaming-modulet til genopretning af tabte data kun skulle vende tilbage til det seneste kontrolpunkt og genoptage beregningerne derfra.
Kontrolpunktet kan aktiveres ved at angive en mappe i et fejltolerant, pålideligt filsystem (f.eks. HDFS, S3 osv.), hvor kontrolpunktsoplysningerne vil blive gemt. Dette gøres f.eks. ved:
streamingContext.checkpoint(checkpointDirectory)I vores eksempel vil vi bruge følgende tilgang, nemlig hvis checkpointDirectory eksisterer, vil konteksten blive genskabt fra kontrolpunktsdataene. Hvis mappen ikke eksisterer (dvs. det udføres for første gang), kaldes funktionen functionToCreateContext for at oprette en ny kontekst og konfigurere DStreams:
from pyspark.streaming import StreamingContext

context = StreamingContext.getOrCreate(checkpointDirectory, functionToCreateContext)
Vi opretter et DirectStream-objekt med henblik på at oprette forbindelse til emnet «transaction» ved hjælp af metoden createDirectStream fra KafkaUtils-biblioteket:
fra pyspark.streaming.kafka import KafkaUtils

sc = SparkContext(conf=conf)
ssc = StreamingContext(sc, 2)

broker_list = 'localhost:9092'
topic = 'transaktion'

directKafkaStream = KafkaUtils.createDirectStream(ssc,
                                [topic],
                                {"metadata.broker.list": broker_list})
Vi parser indkommende data i JSON-format:
rowRdd = rdd.map(lambda w: Row(branch=w['branch'],
                                       currency=w['currency'],
                                       amount=w['amount']))

testDataFrame = spark.createDataFrame(rowRdd)
testDataFrame.createOrReplaceTempView("treasury_stream")
Ved hjælp af Spark SQL udfører vi en enkel gruppering og viser resultatet i konsollen:
select
    from_unixtime(unix_timestamp()) as curr_time,
    t.branch                        as branch_name,
    t.currency                      as currency_code,
    sum(amount)                     as batch_value
from treasury_stream t
group by
    t.branch,
    t.currency
Hent teksten fra forespørgslen og kør den via Spark SQL:
sql_query = get_sql_query()
testResultDataFrame = spark.sql(sql_query)
testResultDataFrame.show(n=5)
Og så gemmer vi de aggregerede data i en tabel i AWS RDS. For at gemme aggregationsresultaterne i databasen vil vi bruge write-metoden på DataFrame-objektet:
testResultDataFrame.write
    .format("jdbc")
    .mode("append")
    .option("driver", 'org.postgresql.Driver')
    .option("url","jdbc:postgresql://myhabrtest.ciny8bykwxeg.us-east-1.rds.amazonaws.com:5432/habrDB")
    .option("dbtable", "transaction_flow")
    .option("user", "habr")
    .option("password", "habr12345")
    .save()
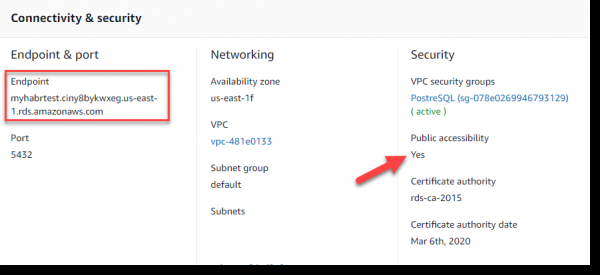
Nogle ord om opsætning af forbindelsen til AWS RDS. Brugernavn og adgangskode til den blev oprettet i trin "Udrulning af AWS PostgreSQL". Som URL til databasen skal vi bruge den Endpoint, der vises under Connectivity & security:
For korrekt integration af Spark og Kafka skal opgaven køres via spark-submit med brug af artefakten spark-streaming-kafka-0-8_2.11. Derudover anvender vi også artefakten til interaktion med PostgreSQL-database, som vi vil overføre via —packages.
For at gøre scriptet mere fleksibelt, vil vi også tage navnet på beskedserveren og det emne, vi ønsker at modtage data fra, som indtastningsparametre.
Så er det tid til at starte og teste systemets funktionalitet:
spark-submit
--packages org.apache.spark:spark-streaming-kafka-0-8_2.11:2.0.2,
org.postgresql:postgresql:9.4.1207
spark_job.py localhost:9092 transaktion
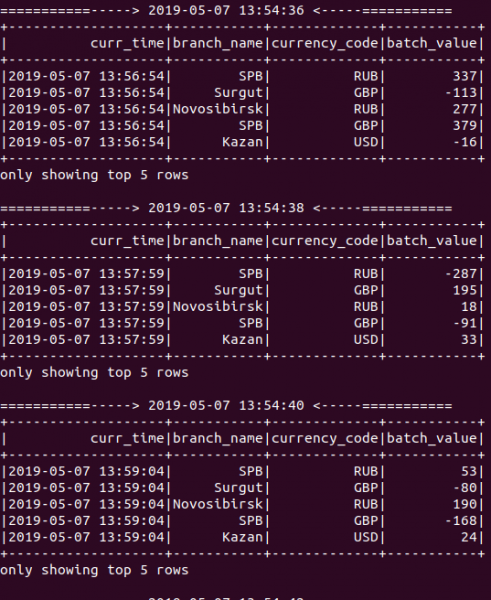
Det lykkedes! Som vist på billedet nedenfor — under anvendelse af applikationen vises de nye aggregationsresultater hvert 2. sekund, fordi vi har sat pakkeintervallet til 2 sekunder, da vi oprettede StreamingContext-objektet:
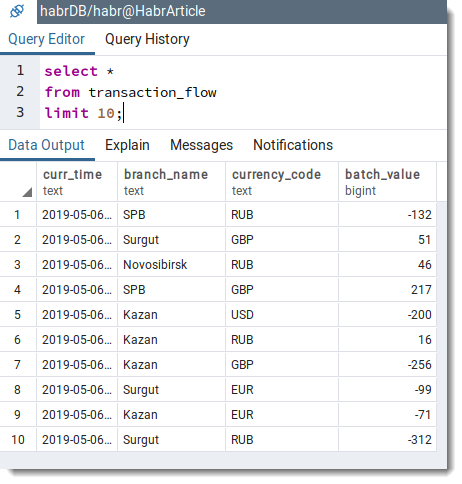
Derudover laver vi en simpel forespørgsel til databasen for at kontrollere, om der er poster i tabellen transaction_flow:
Konklusion
I denne artikel blev der præsenteret et eksempel på strømningsbehandling af information ved hjælp af Spark Streaming i samarbejde med Apache Kafka og PostgreSQL. Med den stigende mængde data fra forskellige kilder er det svært at overvurdere den praktiske værdi af Spark Streaming til at skabe streamingapplikationer og applikationer, der fungerer i realtid.
Den fulde kildekode kan findes i mit repository på .
Jeg ser frem til at diskutere denne artikel, og jeg ser frem til jeres kommentarer samt håber på konstruktiv kritik fra alle interesserede læsere.
Jeg ønsker dig held og lykke!
Ps. Oprindeligt var det planlagt at bruge en lokal database PostgreSQL, men i betragtning af min kærlighed til AWS besluttede jeg at flytte databasen til skyen. I den næste artikel om dette emne vil jeg vise, hvordan man implementerer hele det ovenfor beskrevne system i AWS ved hjælp af AWS Kinesis og AWS EMR. Hold øje med nyhederne!
Kilde: habr.com
