

Først og fremmest, når man arbejder med et nyt datasæt, er det vigtigt at forstå det. For at gøre dette skal man for eksempel finde ud af værdiernes intervaller, deres typer samt få information om antallet af manglende værdier.
Biblioteket pandas tilbyder os mange nyttige værktøjer til udførelse af eksplorativ dataanalyse (Exploratory Data Analysis, EDA). Men før man bruger dem, er det normalt nødvendigt at starte med mere generelle funktioner som df.describe(). Det skal dog bemærkes, at funktionernes muligheder er begrænsede, og de indledende faser af arbejdet med enhver datasæt under EDA ligner ofte hinanden meget.
Forfatteren til det materiale, vi offentliggør i dag, siger, at han ikke er fan af at gentage handlinger. Som følge heraf fandt han, i sin søgen efter midler til hurtigt og effektivt at udføre eksplorativ dataanalyse, biblioteket . Resultaterne af dets arbejde præsenteres ikke som separate målinger, men som en ret detaljeret HTML-rapport, der indeholder størstedelen af de oplysninger om de analyserede data, som man kan have brug for at vide, inden man går videre med mere grundigt arbejde med dem.
Her vil vi gennemgå de specifikke funktioner ved at bruge biblioteket pandas-profiling ved at tage udgangspunkt i datasættet Titanic.
Eksplorativ dataanalyse ved hjælp af pandas
Jeg besluttede at eksperimentere med pandas-profiling på datasættet Titanic på grund af, at det indeholder data af forskellige typer og på grund af tilstedeværelsen af manglende værdier. Jeg mener, at biblioteket pandas-profiling især er interessant i de situationer, hvor dataene endnu ikke er renset og kræver yderligere behandling afhængigt af deres karakteristika. For at kunne udføre denne type behandling effektivt er det nødvendigt at vide, hvor man skal starte, og hvad man skal være opmærksom på. Her kommer mulighederne i pandas-profiling til nytte.
For at starte med importerer vi dataene og bruger pandas til at hente indikatorer for beskrivende statistik:
# импорт необходимых пакетов
import pandas as pd
import pandas_profiling
import numpy as np

# импорт данных
df = pd.read_csv('/Users/lukas/Downloads/titanic/train.csv')

# вычисление показателей описательной статистики
df.describe()
Efter at have kørt denne kodeblok vil man få det, der vises på det følgende billede.
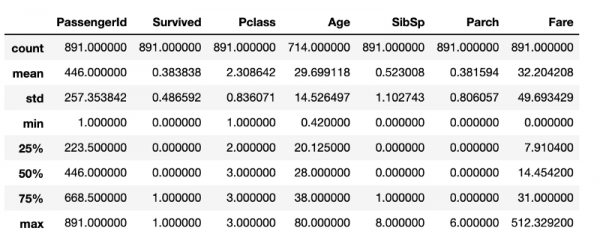
Indikatorerne for beskrivende statistik, der er opnået ved hjælp af standardfunktioner i pandas
Selvom der er mange nyttige oplysninger her, mangler der stadig information, som ville være interessant at vide om de undersøgte data. For eksempel kan man antage, at der i dataframen, strukturen DataFrame, er 891 rækker. Hvis dette skal verificeres, vil der være behov for endnu en række kode, der bestemmer størrelsen af framen. Selvom disse beregninger ikke er meget ressourcekrævende, vil konstant gentagelse uundgåeligt føre til tab af tid, som sandsynligvis ville være bedre brugt på datarensning.
Eksplorativ dataanalyse ved hjælp af pandas-profiling
Lad os nu gøre det samme ved hjælp af pandas-profiling:
pandas_profiling.ProfileReport(df)Udførelse af den ovenfor viste kodeline vil muliggøre at generere en rapport med oplysninger om den eksplorative dataanalyse. Koden, der er vist ovenfor, vil føre til udskrivning af de fundne oplysninger om dataene, men man kan også lave det, så resultatet bliver en HTML-fil, der for eksempel kan vises for nogen.
Den første del af rapporten vil indeholde afsnittet Oversigt, som giver grundlæggende oplysninger om dataene (antal observationer, antal variable og så videre). Derudover vil det indeholde en liste over advarsler, der informerer analytikeren om, hvad der er værd at være særlig opmærksom på. Disse advarsler kan tjene som en ledetråd til, hvor man bør fokusere sine bestræbelser på datarensning.
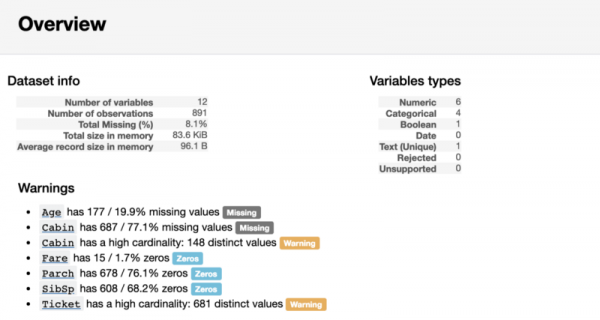
Oversigt afsnittet
Eksplorativ analyse af variable
Efter afsnittet Oversigt i rapporten kan man finde nyttige oplysninger om hver variabel. Disse inkluderer blandt andet små diagrammer, der beskriver fordelingen af hver variabel.
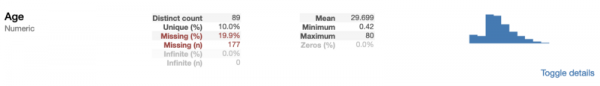
Oplysninger om den numeriske variabel Alder
Som man kan se fra det foregående eksempel, giver pandas-profiling os flere nyttige indikatorer såsom procent og antal manglende værdier samt de descriptive statistikker, som vi allerede har set. Da Alder er en numerisk variabel, gør visualiseringen af dens fordeling i histogramform det muligt for os at konkludere, at vi har at gøre med en højrevendt fordeling.
Når vi ser på den kategoriske variabel, adskiller de viste indikatorer sig lidt fra dem, der blev fundet for den numeriske variabel.
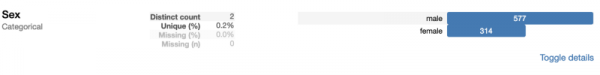
Oplysninger om den kategoriske variabel Køn
Nemlig, i stedet for at finde gennemsnittet, minimum eller maksimum fandt pandas-profiling biblioteket antallet af klasser. Da Køn — en binær variabel, hvis værdier repræsenteres af to klasser.
Hvis du, ligesom jeg, elsker at udforske kode, kan du finde det interessant at se, hvordan pandas-profiling biblioteket beregner disse målinger. At finde ud af det er ikke så svært, da bibliotekets kode er åben og tilgængelig på GitHub. Da jeg ikke er meget for at bruge "black boxes" i mine projekter, kiggede jeg på kildekoden til biblioteket. For eksempel, sådan her ser mekanismen til behandling af numeriske variable, repræsenteret ved funktionen :
def describe_numeric_1d(series, **kwargs):
    """Beregn sammendrag statistik for en numerisk (`TYPE_NUM`) variabel (en Series).
    Også oprette histogrammer (mini og fuld) af dens fordelinger.
    Parametre
    ----------
    series : Series
        Variablen der skal beskrives.
    Returns
    -------
    Series
        Beskrivelsen af variablen som en Series med indekset som statistiknøgler.
    """
    # Formater et tal som en procent. For eksempel vil 0.25 blive til 25%.
    _percentile_format = "{:.0%}"
    stats = dict()
    stats['type'] = base.TYPE_NUM
    stats['mean'] = series.mean()
    stats['std'] = series.std()
    stats['variance'] = series.var()
    stats['min'] = series.min()
    stats['max'] = series.max()
    stats['range'] = stats['max'] - stats['min']
    # For at undgå at beregne det flere gange
    _series_no_na = series.dropna()
    for percentile in np.array([0.05, 0.25, 0.5, 0.75, 0.95]):
        # dropna() er en workaround for https://github.com/pydata/pandas/issues/13098
        stats[_percentile_format.format(percentile)] = _series_no_na.quantile(percentile)
    stats['iqr'] = stats['75%'] - stats['25%']
    stats['kurtosis'] = series.kurt()
    stats['skewness'] = series.skew()
    stats['sum'] = series.sum()
    stats['mad'] = series.mad()
    stats['cv'] = stats['std'] / stats['mean'] if stats['mean'] else np.NaN
    stats['n_zeros'] = (len(series) - np.count_nonzero(series))
    stats['p_zeros'] = stats['n_zeros'] * 1.0 / len(series)
    # Histogrammer
    stats['histogram'] = histogram(series, **kwargs)
    stats['mini_histogram'] = mini_histogram(series, **kwargs)
    return pd.Series(stats, name=series.name)
Selvom dette kodefragment kan virke ret stort og komplekst, er det faktisk meget enkelt at forstå. Det handler om, at der i bibliotekets kildekode er en funktion, der bestemmer variabletyper. Hvis det viser sig, at biblioteket har mødt en numerisk variabel, så vil den ovennævnte funktion finde de målinger, som vi har diskuteret. Denne funktion bruger standardoperationer fra pandas til at arbejde med objekter af typen Series, ligesom series.mean(). Beregningsresultaterne gemmes i en ordbog stats. Histogrammer dannes ved hjælp af en tilpasset version af funktionen matplotlib.pyplot.hist. Tilpasningen er designet til at sikre, at funktionen kan arbejde med forskellige typer datasæt.
Korrelationsindikatorer og et udvalg af de undersøgte data
Efter resultaterne af pandas-profiling analysen, vil sektionen 'Korruptioner' vise Pearson- og Spearman-korrelationsmatricer.
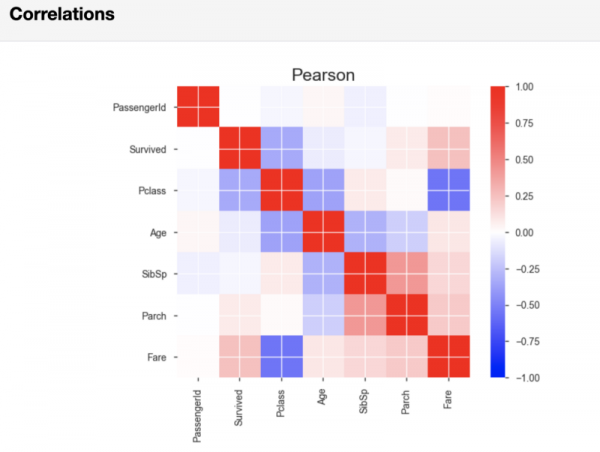
Pearson-korrelationsmatrice
Hvis det er nødvendigt, kan der i den linje af koden, der starter genereringen af rapporten, angives tærskelværdier, der anvendes ved beregning af korrelation. Ved at gøre dette kan du angive, hvilken styrke af korrelation der betragtes som vigtig for din analyse.
Endelig vil rapporten fra pandas-profiling, i sektionen 'Sample', vise et uddrag af data taget fra begyndelsen af datasættet som et eksempel. Denne tilgang kan føre til ubehagelige overraskelser, da de første par observationer muligvis ikke repræsenterer egenskaberne ved hele datasættet.
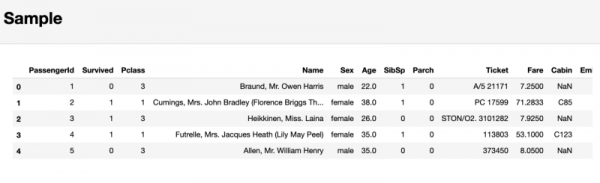
Sektionen, der indeholder et udvalg af de undersøgte data
Som resultat anbefaler jeg ikke at fokusere på denne sidste sektion. I stedet er det bedre at bruge kommandoen df.sample(5), som tilfældigt vælger 5 observationer fra datasættet.
Resumé
Sammenfattende kan det konstateres, at pandas-profiling biblioteket giver analytikere nogle nyttige funktioner, der er praktiske, når der hurtigt skal opnås et overordnet indtryk af dataene eller videregives en rapport om dataenes udforskende analyse. Den reelle behandling af data, som tager højde for deres egenskaber, udføres, som uden brug af pandas-profiling, manuelt.
Hvis du vil se, hvordan hele den udforskende dataanalyse ser ud i en enkelt Jupyter-notesbog - tag et kig på mit projekt, der er oprettet ved hjælp af nbviewer. Og i GitHub-repositoriet kan du finde den relevante kode.
Kære læsere! Hvor starter du med at analysere nye datasæt?
Kilde: habr.com
