

Markedet for distribueret computing og big data vokser, hvis man skal tro , med 18-19% om året. Det betyder, at spørgsmålet om valg af software til disse formål stadig er relevant. I dette indlæg vil vi starte med, hvorfor distribueret computing er nødvendigt, se nærmere på valget af software, fortælle om anvendelsen af Hadoop ved hjælp af Cloudera, og til sidst diskutere valg af hardware og hvordan det påvirker ydeevnen på forskellige måder.
Hvorfor er distribueret computing nødvendigt i almindelig forretning? Her er svaret både enkelt og kompliceret. Enkelt — fordi vi i de fleste tilfælde udfører relativt enkle beregninger pr. enhed information. Kompliceret — fordi der er så meget information. Rigtig meget. Som følge heraf skal vi Dermed er anvendelsesscenarierne ret universelle: beregninger kan anvendes overalt, hvor der er behov for at tage højde for et stort antal metric på et endnu større datasæt.
Et af de seneste eksempler er Dodo Pizza-kæden der har tilpasset indkøb baseret på analysen af kundernes ordredata, som viser, at brugerne normalt kun arbejder med seks grundlæggende sæt ingredienser plus nogle tilfældige, når de vælger en pizza med vilkårlig topping. Desuden har det gjort det lettere for dem at anbefale ekstra varer til brugerne under bestillingsprocessen, hvilket har øget indtjeningen.
Et andet eksempel: produktpositioner har gjort det muligt for H&M at reducere sortimentet i enkelte butikker med 40%, mens salget er forblevet på samme niveau. Dette blev opnået ved at udelukke produkter, der sælger dårligt, hvor der også blev taget hensyn til sæsonbestemthed.
Valg af værktøj
Den industrielle standard for denne slags beregning er Hadoop. Hvorfor? Fordi Hadoop er et fremragende, veldokumenteret framework (selv Habr udgiver mange detaljerede artikler om emnet), som kommer med et sæt værktøjer og biblioteker. Du kan indtaste enorme mængder både strukturerede og ustrukturerede data, og systemet vil selv fordele dem mellem de beregningsmæssige ressourcer. Disse ressourcer kan desuden tilføjes eller fjernes når som helst — den horisontale skalerbarhed i aktion.
I 2017 indgik det indflydelsesrige konsulentfirma Gartner , at Hadoop snart vil uddø. Årsagen er temmelig banal: analytikere mener, at virksomheder vil migrere massivt til skyen, da de dér kan betale for faktisk brug af beregningskapacitet. Den anden vigtige faktor, der angiveligt kan "begrave" Hadoop, er hastigheden. Fordi løsninger som Apache Spark eller Google Cloud DataFlow arbejder hurtigere end MapReduce, som er grundlaget for Hadoop.
Hadoop hviler på flere søjler, hvoraf de mest markante er teknologierne MapReduce (et distribueret datasystem til beregninger mellem servere) og filsystemet HDFS. Det sidste er specielt designet til at lagre information fordelt mellem klyngens noder: hver blok af fast størrelse kan lagres på flere noder, og takket være replikation opretholdes systemets robusthed over for fejl på enkelte noder. I stedet for en filtabel bruges en specialiseret server, kaldet NameNode.
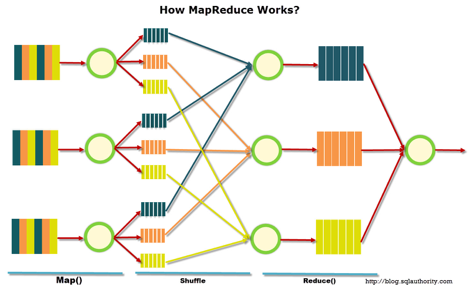
På illustrationen nedenfor vises skemaet for arbejdet med MapReduce. I det første trin opdeles dataene efter et bestemt kriterium, i det andet distribueres de efter beregningskapaciteter, og i det tredje sker beregningen.
MapReduce blev oprindeligt skabt af Google til deres søgesystem. Senere blev MapReduce åbnet som open source, og Apache tog over projektet. Google migrerede gradvis til andre løsninger. En interessant detalje: i øjeblikket har Google et projekt ved navn Google Cloud Dataflow, der markedsføres som det næste skridt efter Hadoop, som en hurtig erstatning.
Ved nærmere eftersyn ses det, at Google Cloud Dataflow er baseret på en variant af Apache Beam, hvor Apache Beam indeholder et vel-dokumenteret framework, Apache Spark, hvilket gør, at man kan tale om praktisk talt samme hastighed ved udførelse af løsninger. Og Apache Spark fungerer fremragende på HDFS-filsystemet, hvilket muliggør deployment på Hadoop-servere.
Lad os tilføje mængden af dokumentation og færdige løsninger for Hadoop og Spark mod Google Cloud Dataflow, og valget af værktøjet bliver åbenbart. Ydermere kan ingeniører selv beslutte, hvilken kode — til Hadoop eller Spark — de vil udføre, baseret på opgaven, erfaring og kvalifikation.
Skyen eller lokal server
Tendensen mod den generelle overgang til skyen har skabt et interessant begreb som Hadoop-as-a-service. I dette scenarie er administrationen af de tilsluttede servere blevet meget vigtig. For desværre, på trods af sin popularitet, er ren Hadoop et ret komplekst værktøj at opsætte, da der er mange ting, der skal gøres manuelt. For eksempel skal serverne konfigureres individuelt, overvåges, og mange parametre skal indstilles omhyggeligt. Generelt er det noget for entusiaster, og der er en stor risiko for at lave fejl eller overse noget.
Derfor har forskellige distributioner fået stor popularitet, som oprindeligt leveres med brugervenlige deployments- og administrationsværktøjer. En af de mest populære distributioner, som understøtter Spark og forenkler det hele, er Cloudera. Den har både betalte og gratis versioner - og i den gratis version er al den grundlæggende funktionalitet tilgængelig, uden begrænsninger på antallet af noder.
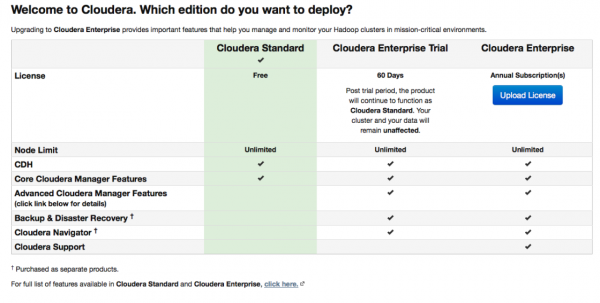
Under opsætningen vil Cloudera Manager oprette SSH-forbindelser til dine servere. Et interessant punkt er, at det under installationen er bedst at angive, at den skal udføres med såkaldte parceller: specielle pakker, der hver indeholder alle de nødvendige komponenter, konfigureret til at arbejde sammen. I bund og grund er det en forbedret version af en pakkemanager.
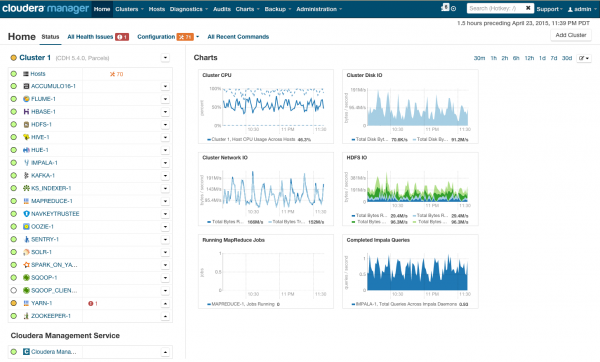
Efter installationen får vi et clusters kontrolpanel, hvor man kan se telemetri for klyngerne, installerede tjenester, plus at du kan tilføje/fjerne ressourcer og redigere klyngens konfiguration.
Resultatet er, at du står over for skæringen af den raket, der vil føre dig til BigData's lysere fremtid. Men før vi siger «lad os gå», lad os kigge under motorhjelmen.
Krav til hardware
På deres hjemmeside nævner Cloudera forskellige mulige konfigurationer. De generelle principper, som de bygger på, er vist i illustrationen:
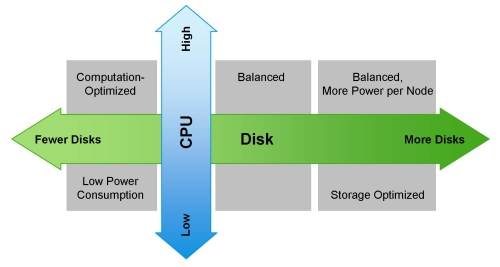
Et optimistisk scenarie kan blive skadet af MapReduce. Hvis man ser nærmere på diagrammet fra det foregående afsnit, bliver det tydeligt, at næsten alle gange kan en MapReduce-opgave støde på et 'flaskehals' problem, når data læses fra disken eller nettet. Dette er også nævnt i Clouderas blog. Derfor er ind- og udgangshastighed meget vigtig for hurtige beregninger, herunder via Spark, som ofte anvendes til realtidsberegninger. Derfor er det vigtigt, når man bruger Hadoop, at der findes balancerede og hurtige maskiner i klyngen, hvilket ikke altid kan garanteres i cloud-infrastrukturen.
Balancen i belastningsfordelingen opnås ved at bruge Openstack-virtualisering på servere med kraftige multikern CPU'er. Data-noderne tildeles deres egne processorressourcer og specifikke diske. I vores løsning Atos Codex Data Lake Engine opnås omfattende virtualisering, hvilket giver os fordele både i forhold til ydeevne (netværksinfrastrukturen har minimal indflydelse) og TCO (unødvendige fysiske servere elimineres).
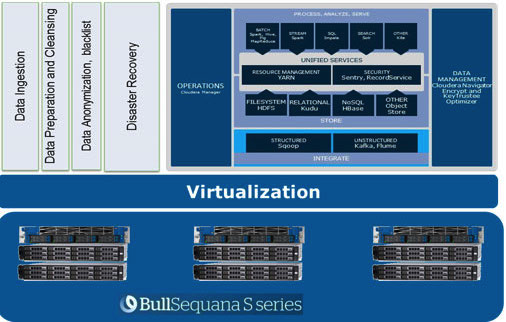
Ved brug af BullSequana S200-servere opnår vi en jævnere belastning, som mangler visse flaskehalse. Den minimale konfiguration inkluderer 3 BullSequana S200-servere, hver med to JBOD, plus yderligere S200-servere kan tilsluttes som option, som indeholder fire data-noder hver. Her er et eksempel på belastning i TeraGen-testen:
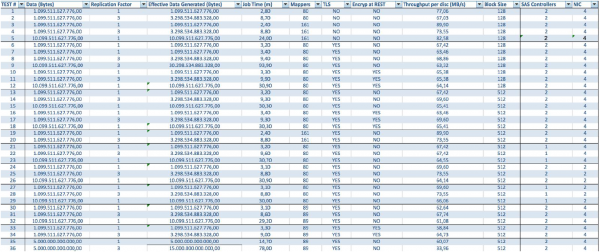
Test med forskellige datamængder og replikationsværdier viser ens resultater med hensyn til belastningsfordeling mellem klyngens noder. Nedenfor er et diagram, der viser diskadgangsfordeling under performance-tests.
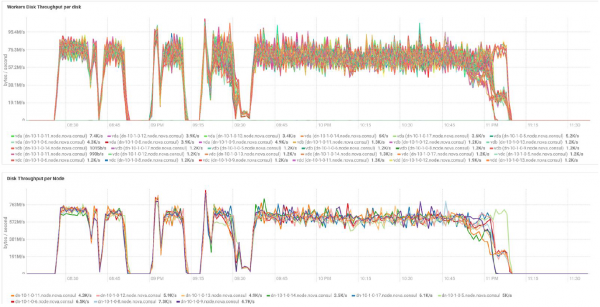
Beregnede resultater er baseret på den minimale konfiguration bestående af 3 BullSequana S200-servere. Den inkluderer 9 datanoder og 3 primære noder samt reserverede virtuelle maskiner til potentiel implementering af beskyttelse baseret på OpenStack Virtualization. TeraSort-testresultatet: blokstørrelse 512 MB med en replikationsfaktor på tre og kryptering tager 23,1 minutter.
Hvordan kan systemet udvides? Der er forskellige former for udvidelser til Data Lake Engine:
- Dataoverførselsnoder: for hver 40 TB nyttig plads
- Analytiske noder med mulighed for installation af grafikkort
- Andre muligheder afhængigt af virksomhedens behov (for eksempel hvis Kafka er nødvendigt og lignende)
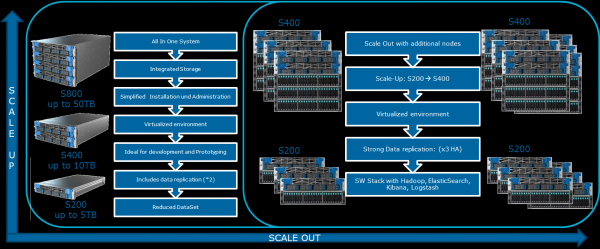
Atos Codex Data Lake Engine omfatter både serverne selv og det forudinstallerede software, der inkluderer Cloudera-pakken med licens; selve Hadoop, OpenStack med virtuelle maskiner baseret på RedHat Enterprise Linux-kernen, systemer til datagendannelse og backup (herunder ved hjælp af en backup-node og Cloudera BDR — Backup and Disaster Recovery). Atos Codex Data Lake Engine blev den første løsning med virtualisering, der blev certificeret. .
Hvis du er interesseret i flere detaljer, vil vi være glade for at besvare dine spørgsmål i kommentarerne.
Kilde: habr.com
