

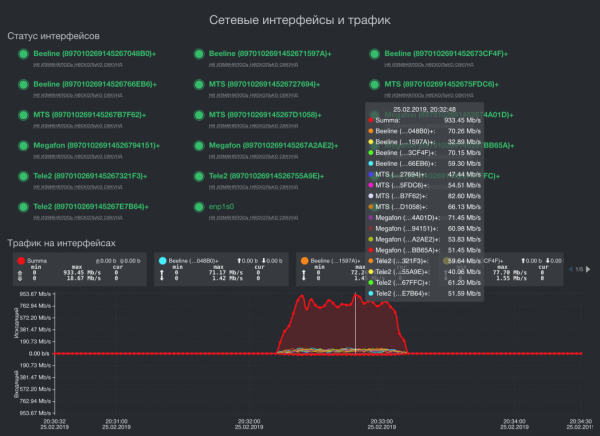
16 modemer, 4 mobiloperatører = Udgående hastighed 933,45 Mbit/s
Introduktion
Hej! Dette er en artikel om, hvordan vi har skrevet et nyt overvågningssystem til os selv. I forhold til de eksisterende adskiller det sig ved muligheden for højfrekvent synkron indsamling af målinger og et meget lavt ressourceforbrug. Spørgselsfrekvensen kan nå op på 0,1 millisekunder med en synkroniseringsnøjagtighed mellem målingerne på 10 nanosekunder. Alle binære filer fylder 6 megabyte.
Om projektet
Vi har et ret specifikt produkt. Vi producerer en omfattende løsning til opsummering af båndbredde og redundans i datatransmission. Det er, når der er flere kanaler, for eksempel Operatør1 (40 Mbit/s) + Operatør2 (30 Mbit/s) + Noget andet (5 Mbit/s), hvilket resulterer i én stabil og hurtig kanal, hvis hastighed vil være cirka: (40+30+5)x0,92=75×0,92=69 Mbit/s.
Sådanne løsninger er eftertragtede der, hvor kapaciteten af en enkelt kanal ikke er tilstrækkelig. For eksempel transport, videosystemer og realtids streaming af video, transmission af direkte tv- og radioudsendelser, samt i sommerhuse, hvor udbyderne kun inkluderer de store fire, og hastigheden på én modem/kanal ikke er nok.
Til hver af disse retninger udgiver vi en særskilt serie af enheder, men den softwaremæssige del er næsten ensartet, og et kvalitets overvågningssystem er en af dets vigtigste moduler uden hvilken produktet ville være umuligt.
I løbet af flere år har vi formået at skabe et multilevelt, hurtigt, tværplatforms og letvægts overvågningssystem. Dette vil vi gerne dele med det respektable fællesskab.
Problemformulering
Overvågningssystemet sikrer indsamling af målinger fra to fundamentalt forskellige klasser: realtidsmålinger og alle andre. Systemet til overvågning havde kun følgende krav:
- Højfrekvent synkron indsamling af realtidsmålinger og transmission af dem til kommunikationsstyringssystemet uden forsinkelser.
Høj frekvens og synkronisering af forskellige metrikker er ikke bare vigtige, men livsvigtige for analysen af entropien i datatransmissionskanaler. Hvis den gennemsnitlige forsinkelse i en datatransmissionskanal er 30 millisekunder, vil en synkroniseringsfejl mellem de øvrige metrikker på kun én millisekund føre til en hastighedsnedgang i den resulterende kanal på cirka 5%. Hvis vi fejler i synkroniseringen med 1 millisekund i fire kanaler, kan hastigheden nemt falde til 30%. Desuden ændrer entropien i kanalerne sig meget hurtigt, så hvis vi måler den mindre end én gang hver 0,5 millisekund, vil vi på hurtige kanaler med lav forsinkelse opleve høj hastighedsnedgang. Naturligvis er sådan præcision ikke nødvendig for alle metrikker og under alle forhold. Når forsinkelsen i kanalen er 500 millisekunder, og vi arbejder med sådanne, vil en fejl på 1 millisekund næsten ikke være mærkbar. For metrikker relateret til livsunderstøttelse er en spørgerate og synkronisering på 2 sekunder tilstrækkelig, men selve overvågningssystemet skal kunne arbejde med ekstremt høj spørgerate og ekstremt præcis synkronisering af metrikker. - Minimal ressourceforbrug og en ensartet stak.
Det endelige device kan være både et kraftfuldt ombordssystem, der kan analysere situationen på vejen eller udføre biometrisk registrering af mennesker, samt en enhedsstyring i størrelsen af en håndflade, der bæres under en kuglesikker vest af en specialstyrkessoldat for at transmittere video i realtid under dårlige forbindelser. På trods af denne variation i arkitektur og beregningskapacitet ønsker vi en ensartet softwarestak. - Parasoll-arkitektur
Metrikker skal indsamles og aggregeres på det endelige device, have et lokalt lagersystem og visualisering i realtid og retrospektivt. Hvis der er forbindelse, skal data sendes til det centraliserede overvågningssystem. Når forbindelsen er fraværende, skal køen for sending akkumuleres og ikke forbruge RAM. - API til integration i kundens overvågningssystem, fordi ingen har brug for mange overvågningssystemer. Kunden skal indsamle data fra alle enheder og netværk i en samlet overvågning.
What we achieved
For the sake of not overloading this already substantial longread, I won't provide examples and measurements of all monitoring systems. This would require another article. I will simply say that we were unable to find a monitoring system capable of capturing two metrics simultaneously with an error of less than 1 millisecond and that operates equally effectively on both ARM architecture with 64MB RAM and x86_64 architecture with 32GB RAM. Therefore, we decided to develop our own system that can handle all of this. Here’s what we came up with:
Summation of the bandwidth of three channels for different network topologies
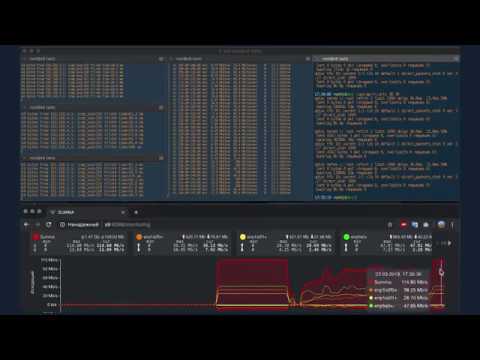
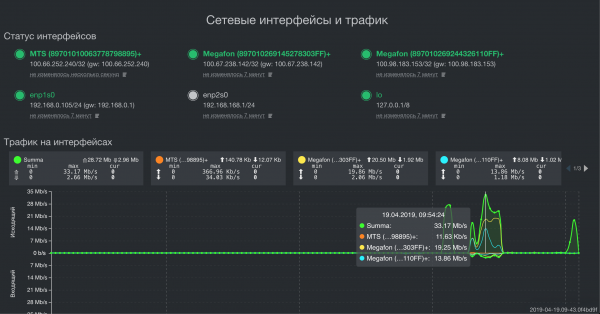
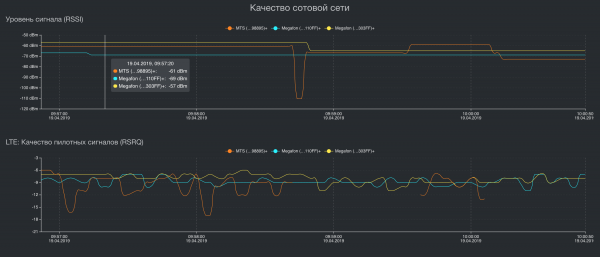
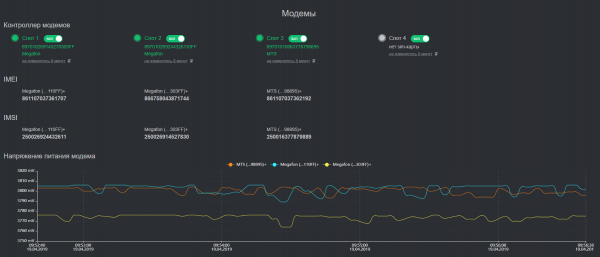
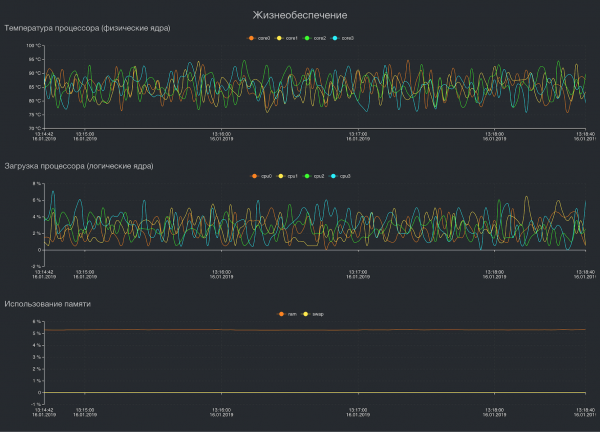
Visualization of some key metrics
Arkitektur
As the primary programming language, both on the device and in the data center, we use Golang. It has significantly simplified our lives with its implementation of concurrency and the ability to obtain one statically linked executable binary file for each service. As a result, we save significantly on resources, methods, and traffic for deploying services to end devices, as well as on development and debugging time.
The system is implemented according to the classic modular principle and contains several subsystems:
- Registration of metrics.
Each metric is served by its own thread and synchronized through channels. We achieved synchronization accuracy of up to 10 nanoseconds. - Storage of metrics
Vi overvejede mellem at skrive vores eget lager til tidsdata eller bruge noget eksisterende. Databasen er nødvendig til retrospektive data, der skal visualiseres senere. Dvs. der er ingen data om forsinkelser i kanalen hver 0,5 millisekund eller fejlmeddelelser i transportnetværket, men der er hastighed på hver grænseflade hver 500 millisekund. Udover høje krav til tværplatforme og lavt ressourcetræk er det ekstremt vigtigt for os at kunne behandle dataene der, hvor de opbevares. Dette sparer enormt meget beregningsressourcer. Siden 2016 har vi brugt databasen Tarantool i dette projekt, og vi ser ikke nogen erstatning for den i horisonten. Fleksibel, med optimal ressourceforbrug og en mere end passende teknisk support. Derudover er GIS-modulet implementeret i Tarantool. Det er selvfølgelig ikke så kraftfuldt som PostGIS, men det er tilstrækkeligt til vores opgaver med opbevaring af nogle metrikker knyttet til steder (aktuelle for transport). - Visualisering af metrikker
Det er relativt simpelt. Vi tager data fra lageret og viser dem enten i realtid eller retrospektivt. - Datasynkronisering med det centrale overvågningssystem.
Det centrale overvågningssystem modtager data fra alle enheder, gemmer dem med en given retrospektiv, og via API giver dem til kundens overvågningssystem. I modsætning til klassiske overvågningssystemer, hvor "hoved" går rundt og indsamler data — er vores ordning omvendt. Enhederne sender selv data, når der er forbindelse. Dette er en meget vigtig detalje, da den gør det muligt at få data fra enheden i de tidsperioder, hvor den ikke var tilgængelig, og ikke belaste kanaler og ressourcer, når enheden ikke er tilgængelig. Som det centrale overvågningssystem bruger vi Influx overvågningsserver. I modsætning til lignende systemer kan den importere retrospektive data (dvs. med tidsstempel forskelligt fra det tidspunkt, hvor metrikken blev modtaget) De indsamlede metrikker visualiseres af den forfinede Grafana. Denne standardstack blev også valgt, fordi den har klar API-integration til stort set ethvert kundes overvågningssystem. - Datasynkronisering med det centrale enhedshåndteringssystem.
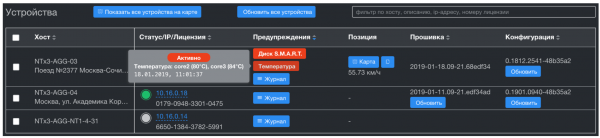
Enhedsstyringssystemet implementerer Zero Touch Provisioning (firmwareopdatering, konfiguration osv.) og adskiller sig fra overvågningssystemet ved kun at modtage problemer med enheder. Dette er triggere for drift af de indbyggede hardwareovervågningssystemer og alle målinger af livscyklussystemer: CPU- og SSD-temperatur, CPU-belastning, ledig plads og S.M.A.R.T-sundhed på diske. Lagringen af subsystemet er også bygget på Tarantool. Dette giver os en betydelig hastighed i aggregering af tidsserier på tusindvis af enheder, og det løser fuldstændigt problemet med datasynkronisering med disse enheder. Tarantool har et fantastisk indbygget køsystem og garanteret levering. Denne vigtige funktion fik vi out-of-the-box, fantastisk!
Netværksstyringssystem
vil være udsolgt
Indtil videre er det svageste led vores centrale overvågningssystem. Det er implementeret på 99,9% med den standardiserede tech stack, og det har en række ulemper:
- InfluxDB mister data ved strømafbrydelse. Normalt henter kunden hurtigt alt, hvad der kommer fra enhederne, og i selve databasen er der ingen data ældre end 5 minutter, men i fremtiden kan det blive et problem.
- Grafana har en række problemer med aggregering af data og synkronisering af deres visning. Det mest almindelige problem er, når der i databasen ligger en tidsserie med et interval på 2 sekunder, lad os sige fra 00:00:00, mens Grafana begynder at vise data i aggregation fra +1 sekund. Som resultat ser brugeren en ustabil graf.
- Overdreven mængde kode til API-integration med tredjepartsovervågningssystemer. Det kan gøres betydeligt mere kompakt, og selvfølgelig genskrives i Go)
Jeg har bevidst valgt ikke at beskrive de tekniske detaljer, men kun at skitsere designet af dette system. For det første vil det kræve en hel artikel at beskrive systemet teknisk fuldt ud. For det andet vil det ikke være interessant for alle. Skriv i kommentarfeltet, hvilke tekniske detaljer du gerne vil vide.
Konklusion
Hvis nogen har spørgsmål ud over denne artikel, kan I kontakte mig på a.rodin @ qedr.com
16 modemmer, 4 mobiloperatører= Udgående hastighed 933,45.
Kilde: habr.com
