

Hej alle sammen! Mit navn er Pavel Agaletskiy. Jeg arbejder som teamleder i det hold, der udvikler Lamoda leveringssystem. I 2018 talte jeg på konferencen HighLoad++, og i dag vil jeg præsentere en gennemgang af mit oplæg.
Mit emne handler om vores virksomheds erfaring med at deployere systemer og tjenester i forskellige miljøer. Fra vores præhistoriske tid, hvor vi deployerede alle systemer på almindelige virtuelle servere, til den gradvise overgang fra Nomad til deployment i Kubernetes. Jeg vil fortælle om, hvorfor vi gjorde det, og hvilke problemer vi stødte på i processen.

Udrift af applikationer på VM
Lad os starte med, at for 3 år siden blev alle virksomhedens systemer og tjenester deployeret på almindelige virtuelle servere. Teknisk set var det organiseret sådan, at al kode fra vores systemer blev gemt og samlet ved hjælp af automatiske buildprocesser via Jenkins. Med Ansible blev det derefter rullet ud fra vores versionskontrolsystem til de virtuelle servere. Hver system, der var i vores virksomhed, blev deployeret på mindst 2 servere: en på head og den anden på tail. Disse to systemer var fuldstændig identiske i alle deres indstillinger, kapaciteter, konfigurationer osv. Forskellen mellem dem var kun, at head modtog brugertrafik, mens tail aldrig modtog brugertrafik.
Hvorfor blev dette gjort?
Når vi deployerede nye versioner af vores applikation, ønskede vi at sikre en sømløs udrulning, det vil sige uden mærkbare konsekvenser for brugerne. Dette blev opnået ved, at den nyeste byggede version blev rullet ud til tail med Ansible. Her kunne folk, der arbejdede med deployment, kontrollere og sikre, at alt var i orden: alle metrics, sektioner og applikationer fungerede; de nødvendige scripts blev startet. Først efter at de havde sikret sig, at alt var okay, blev trafikken skiftet. Den begyndte at gå til den server, der tidligere var tail. Den, der tidligere var head, forblev uden brugertrafik, men med den tidligere version af vores applikation.
Dermed var det sømløst for brugerne. Fordi skiftet er øjeblikkeligt, da det blot kræver en omskiftning af balanceringssystemet. Det er meget nemt at rulle tilbage til den tidligere version ved blot at skifte balanceringssystemet tilbage. Vi kunne også bekræfte applikationens evne i produktion, inden brugertrafikken begyndte, hvilket var ganske praktisk.
Hvilke fordele så vi i alt dette?
- Først og fremmest fungerer det ganske godt. Det er tydeligt for alle, hvordan en sådan deployeringsmodel fungerer, fordi de fleste mennesker har deployeret på almindelige virtuelle servere. Det er ganske
- pålideligt , da deployeringsteknologien er enkel og er blevet testet af tusinder af virksomheder. Millioner af servere bliver deployeret på denne måde. Det er svært at ødelægge noget.Og endelig kunne vi få
- atomiske deployment . Deployeringer, der for brugerne finder sted øjeblikkeligt, uden mærkbare skift mellem den gamle version og den nye.Men vi så også nogle ulemper i alt dette:
Udover produktionsmiljøet og udviklingsmiljøet er der også andre miljøer. For eksempel QA og pre-produktion. På det tidspunkt havde vi mange servere og omkring 60 tjenester. Af denne grund måtte vi
- opretholde den relevante version af den virtuelle maskine for hver tjeneste. Hvis du vil opdatere biblioteker eller installere nye afhængigheder, skal du gøre det i alle miljøer. Det var også nødvendigt at synkronisere tidspunktet, når du planlægger at deployere den næste nye version af din applikation, med tidspunktet, hvor DevOps udfører de nødvendige indstillinger af miljøet. Dette kan nemt føre til situationer, hvor vores miljøer adskiller sig merkbart fra hinanden i alle de efterfølgende miljøer. For eksempel kan QA-miljøet have en version af bibliotekerne, mens produktionen har en anden, hvilket kan føre til problemer. Sværhedsgraden ved at opdatere afhængighederne
- af din applikation. Det afhænger ikke af dig, men af et andet team. Nemlig DevOps-teamet, som understøtter serverne. Du skal give dem den passende opgave og give en beskrivelse af, hvad du ønsker at gøre. af din applikation. Dette afhænger ikke af dig, men af et andet team. Mere præcist af devops-teamet, som understøtter serverne. Du skal give dem den opgave, der er relevant, og give en beskrivelse af, hvad du ønsker at gøre.
- På det tidspunkt ønskede vi også at opdele vores store monolitter i separate, mindre services, da vi kunne se, at antallet ville stige. På det tidspunkt havde vi allerede mere end 100 af dem. Det var nødvendigt at oprette en ny virtuel maskine for hver ny service, som også skulle vedligeholdes og deployeres. Derudover krævede det ikke bare én maskine, men mindst to. Dertil kom også QA-miljøet. Dette skaber problemer og gør opbygningen og lanceringen af nye systemer mere kompliceret, kostbart og tidskrævende.
Derfor besluttede vi, at det ville være mere praktisk at gå fra at deployere almindelige virtuelle maskiner til at deployere vores applikationer i Docker-containere. Når man har Docker, er der behov for et system, der kan køre applikationen i et cluster, fordi man ikke bare kan starte en container. Man vil normalt gerne overvåge, hvor mange containere der er kørende, så de kan starte automatisk. Derfor var vi nødt til at vælge et administrationssystem.
Vi overvejede længe, hvilken en vi kunne vælge. Problemet var, at på det tidspunkt var vores deploy-stack på almindelige virtuelle servere lidt forældet, da der var nogle ikke så opdaterede versioner af operativsystemerne. På et tidspunkt kørte vi endda FreeBSD, som var lidt besværligt at vedligeholde. Vi indså, at vi hurtigst muligt skulle migrere til Docker. Vores DevOps-team kiggede på deres eksisterende erfaring med forskellige løsninger og valgte et system som Nomad.
Overgangen til Nomad
Nomad er et produkt fra virksomheden “HashiCorp”. De er også kendt for deres andre løsninger:
«Consul» — et værktøj til service discovery.
«Terraform» — et system til serveradministration, der giver dig mulighed for at konfigurere dem via en konfiguration, såkaldt infrastructure-as-code.
«Vagrant» giver dig mulighed for at deployere virtuelle maskiner lokalt eller i skyen ved hjælp af specifikke konfigurationsfiler.
Nomad virkede på det tidspunkt som en forholdsvis enkel løsning, som man hurtigt kunne skifte til uden at ændre hele infrastrukturen. Desuden er det let at lære. Derfor valgte vi det som vores system til styring af containere.
Hvad skal der til for overhovedet at deployere dit system i Nomad?
- Først og fremmest har du brug for en docker image din applikation. Du skal samle den og placere den i et Docker-billedlager. I vores tilfælde er det Artifactory – et system, der giver mulighed for at pushe forskellige typer artefakter ind i det. Den kan gemme arkiver, Docker-billeder, PHP Composer-pakker, NPM-pakker og så videre.
- Det er også nødvendigt konfigurationsfilen, som vil fortælle Nomad hvad, hvor hen, og i hvilken mængde du ønsker at deployere.
Når vi taler om Nomad, bruger den HCL-sprog (HashiCorp Configuration Language) som formatet for konfigurationsfilen, hvilket står for HashiCorp Configuration Language. Det er et superset af YAML, som gør det muligt at beskrive din service i Nomads termer.
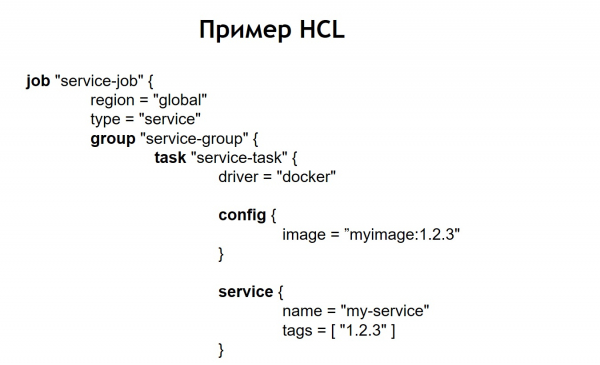
Det lader dig angive, hvor mange containere du vil deployere, fra hvilke billeder der skal sendes forskellige parametre ved deployering. På den måde fodrer du denne Nomad-fil ind, og den starter containerne i produktionen i overensstemmelse med den.
I vores tilfælde indså vi, at det ville være upraktisk at skrive fuldstændig ens HCL-filer til hver service, fordi der er mange services, og nogle gange ønsker man at opdatere dem. Der er tilfælde, hvor en service ikke er deployeret i ét eksemplar, men i forskellige. For eksempel har et af systemerne, vi har i produktion, mere end 100 instanser i produktionen. De bliver startet fra de samme billeder, men adskiller sig med hensyn til konfigurationsindstillinger og konfigurationsfiler.
Derfor besluttede vi, at det ville være praktisk at opbevare alle vores konfigurationsfiler til deployment i et fælles repository. På den måde blev de gennemskuelige: det var nemt at vedligeholde dem, og man kunne se, hvilke systemer vi har. I tilfælde af behov var det heller ikke svært at opdatere eller ændre noget. At tilføje et nyt system ville heller ikke være svært – det var nok bare at oprette en konfigurationsfil inden for en ny mappe. Inde i den ligger filerne: service.hcl, som indeholder beskrivelsen af vores service, og nogle env-filer, som giver mulighed for at konfigurere denne service, når den er deployeret i produktionen.
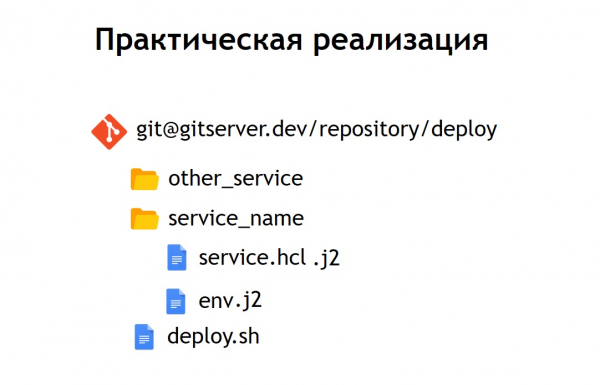
Men nogle af vores systemer er ikke deployeret i produktionen i ét eksemplar, men i flere på én gang. Derfor besluttede vi, at det ville være praktisk for os at opbevare ikke konfigurationerne i ren form, men i deres skabelonform. Og som skabelonsprog valgte vi jinja 2. I dette format gemmer vi både konfigurationsfilerne til selve tjenesten samt de nødvendige env-filer.
Derudover har vi lagt et fælles deploy-script i repository'et for alle projekter, som gør det muligt at starte og deployere din tjeneste i produktion, i den ønskede miljø og til det ønskede mål. Når vi har gjort vores HCL-konfig til en skabelon, ser den HCL-fil, der tidligere var en almindelig Nomad-konfiguration, anderledes ud.
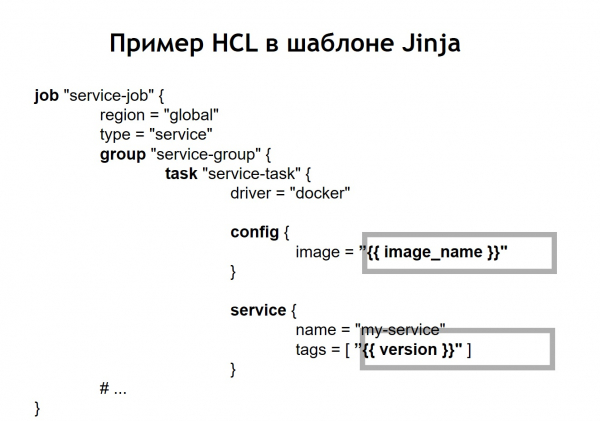
Det vil sige, at vi har erstattet nogle variabelpladser i konfigurationen med indsætninger af variabler, der hentes fra env-filer eller andre kilder. Derudover har vi fået mulighed for at samle HCL-filer dynamisk, hvilket betyder, at vi ikke kun kan anvende almindelige variabelindsætninger. Da jinja understøtter løkker og betingelser, kan der også laves konfigurationsfiler, der ændrer sig afhængigt af, hvor du deployerer dine applikationer.
For eksempel vil du deployere din tjeneste i pre-production og i produktion. Antag, at du ikke ønsker at køre cron-scripts i pre-production, men blot ønsker at se tjenesten på et separat domæne for at sikre dig, at den fungerer. For alle, der deployerer en tjeneste, er processen meget simpel og gennemsigtig. Du skal blot udføre filen deploy.sh, angive hvilken tjeneste du vil deployere, og til hvilket mål. For eksempel, hvis du vil deploye et system til Rusland, Hviderusland eller Kasakhstan. Det er tilstrækkeligt at ændre en af parametrene, og du får den korrekte konfigurationsfil samlet.
Når Nomad-tjenesten allerede er deployeret til dit cluster, ser den sådan ud.
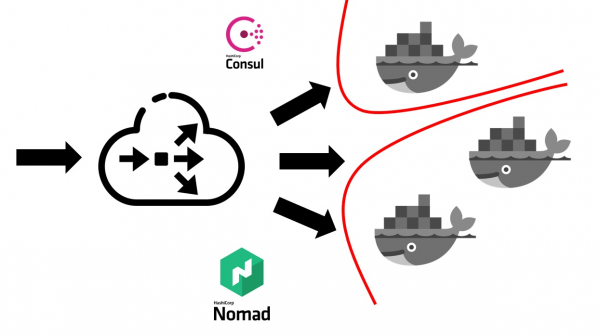
For det første har du brug for en eller anden extern balancer, som vil modtage al brugertrafik. Den vil arbejde sammen med Consul og finde ud af, hvor, på hvilken node, der ligger en specifik tjeneste, som svarer til et bestemt domænenavn. Tjenester i Consul dukker op fra selve Nomad. Da disse produkter kommer fra samme virksomhed, er de godt integreret med hinanden. Man kan sige, at Nomad fra starten er i stand til at registrere alle tjenester, der køres i det, i Consul. IP-adressen for som nævnt tidligere.
Når din eksterne load balancer har fundet ud af, hvilken service den skal sende trafikken til, omdirigerer den den til den relevante container eller flere containere, der svarer til din applikation. Det er selvfølgelig nødvendigt også at tænke på sikkerheden. Selvom alle services kører på de samme virtuelle maskiner i containere, er det typisk nødvendigt at forhindre fri adgang fra en service til en anden. Vi har opnået dette gennem segmentering. Hver service blev kørt i sit eget virtuelle netværk, hvor der var fastlagt routingregler samt regler for tilladelse/afvisning af adgang til andre systemer og services. De kunne være både inden for denne klynge og uden for den. For eksempel, hvis du ønsker at forbyde en service at oprette forbindelse til en bestemt database, kan dette gøres ved at segmentere på netværksniveau. Således kan du ikke ved en fejltagelse forbinde fra testmiljøet til din produktionsdatabase.
Hvad kostede overgangen i form af menneskelige ressourcer?
Overgangen af hele virksomheden til Nomad tog cirka 5-6 måneder. Vi overgik service for service, men i et ret hurtigt tempo. Hver team skulle oprette sine egne containere til services.
Vi har en tilgang, hvor hvert team selv er ansvarlig for docker images af deres systemer. DevOps leverer den fælles infrastruktur, der er nødvendig for deployment, dvs. support til selve klyngen, support til CI-systemet osv. På det tidspunkt var mere end 60 systemer flyttet til Nomad, og vi havde omkring 2000 containere.
DevOps er ansvarlige for den fælles infrastruktur vedrørende deployment og servere. Hver udviklingsteam er derimod ansvarlig for implementeringen af containere til deres specifikke system, da det er teamet, der ved, hvad de rent faktisk har brug for i den eller den container.
Årsager til at sige nej til Nomad
Hvilken fordel har vi opnået ved at skifte til deployment gennem Nomad og Docker?
- Vi ensartede betingelser til alle miljøer. I udvikling, QA-miljøet, pre-production og produktion anvendes de samme containerbilleder med de samme afhængigheder. Derfor har du praktisk talt ingen chance for, at det, der kommer i produktion, ikke er det, du tidligere har testet lokalt eller i et testmiljø.
- Vi har også fundet ud af, at det er tilstrækkeligt let at tilføje en ny service. Enhver ny system kan deployeres meget enkelt. Det er nok at gå til det repository, der opbevarer konfigurationer, tilføje en ny konfig til dit system, og så er du klar. Du kan deploye dit system i produktion uden yderligere anstrengelser fra devops.
- Alle konfigurationsfiler i et fælles repository blev gennemgået. På det tidspunkt, hvor vi deployede vores systemer med virtuele servere, brugte vi Ansible, hvor konfigurationerne lå i det samme repository. Men for de fleste udviklere var det lidt sværere at arbejde med. Mængden af konfigurationer og kode, du skal tilføje for at deploye en service, blev meget mindre. Derudover var det meget nemt for devops at rette eller ændre den. I tilfælde af overgange, for eksempel til en ny version af Nomad, kunne de massivt opdatere alle operationsfiler, der lå på det samme sted.
Men vi stødte også på nogle ulemper:
Det viste sig, at vi ikke kunne opnå glidende deployment i tilfælde af Nomad. Ved udrulningen af containere fra forskellige miljøer kunne det ske, at den blev startet, og Nomad opfattede den som klar til at modtage trafik. Dette skete, før applikationen indeni nåede at starte op. Af denne grund begyndte systemet i en kort periode at give 500-fejl, fordi trafikken begyndte at gå til en container, der endnu ikke var klar til at modtage den.
Vi stødte på nogle fejl. Den mest væsentlige bug er, at Nomad ikke håndterer store klynger særligt godt, hvis du har mange systemer og containere. Når du ønsker at sætte én af serverne i vedligeholdelse, som er inkluderet i Nomad-klyngen, er der en betydelig risiko for, at klyngen ikke fungerer optimalt og falder fra hinanden. En del containere kan for eksempel falde ned og ikke komme op igen — dette vil koste dig meget, hvis alle dine systemer i produktion præcist er i klyngen, der styres af Nomad.
Derfor besluttede vi at overveje, hvilken retning vi skulle gå i fremover. På det tidspunkt blev vi meget bedre til at forstå, hvad vi ønskede at opnå. Nemlig: vi ønsker pålidelighed, lidt flere funktioner end hvad Nomad tilbyder, og et mere modent, mere stabilt system.
I denne henseende valgte vi Kubernetes som den mest populære platform til at køre klynger. Især givet at størrelsen og antallet af vores containere var ret store. Til sådanne formål syntes Kubernetes at være det mest passende system blandt dem, vi kunne se på.
Overgangen til Kubernetes
Lad mig kort fortælle om de grundlæggende begreber i Kubernetes og hvordan de adskiller sig fra Nomad.
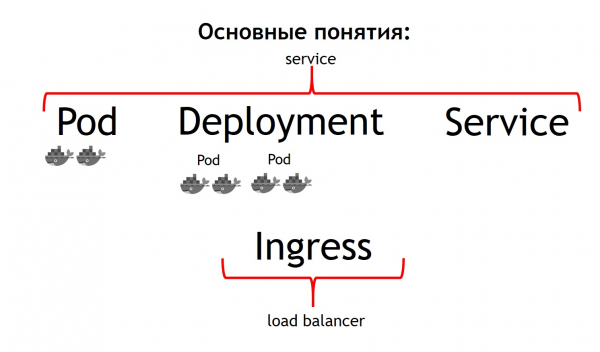
Først og fremmest er det mest basale begreb i Kubernetes begrebet pod. Pod — det er en gruppe af en eller flere containere, der altid kører sammen. Og de fungerer som om, de altid strengt kører på én virtuel maskine. De kan tilgå hinanden via IP-adressen 127.0.0.1 på forskellige porte.
Lad os antage, at du har en PHP-applikation, der består af nginx og php-fpm – en klassisk opsætning. Du vil sandsynligvis have, at både nginx og php-fpm containere altid skal være sammen. Kubernetes gør det muligt at opnå dette ved at beskrive dem som en fælles pod. Det var netop dette, vi ikke kunne opnå med Nomad.
Det næste begreb er deployment. Faktisk er pod'en i sig selv en efemær ting, den starter og forsvinder. Vil du først dræbe alle dine tidligere containere og derefter starte nye versioner med det samme, eller vil du udrulle dem gradvist – dette er præcist det, som begrebet deployment ansvarer for. Det beskriver, hvordan du implementerer dine pods, i hvilken mængde, og hvordan de opdateres.
Det tredje begreb er service. Din service er faktisk dit system, som modtager en vis trafik og derefter sender det til en eller flere pods, der svarer til din service. Det betyder, at det tillader at angive, at al indgående trafik til en given service med et bestemt navn skal sendes til netop disse pods. Og samtidig sikrer det, at du får trafikbalance. Det vil sige, at du kan køre to pods af din applikation, og al indgående trafik vil blive jævnt fordelt mellem de relevante pods til denne service.
Og det fjerde grundlæggende begreb — Ingress. Det er en service, der kører i Kubernetes-klusteret. Den fungerer som en ekstern belastningsfordeler, der modtager alle forespørgsler. Gennem Kubernetes API kan Ingress bestemme, hvor disse forespørgsler skal sendes. Desuden gør den dette meget fleksibelt. Du kan sige, at alle forespørgsler til denne vært og den pågældende URL skal sendes til denne service. Og disse forespørgsler, der kommer til denne vært og en anden URL, skal sendes til en anden service.
Det mest fantastiske for den, der udvikler applikationen, er, at du har mulighed for at styre det hele selv. Ved at angive Ingress-konfigurationen kan du sende al trafik, der kommer til en bestemt API, til separate containere, der f.eks. er skrevet i Go. Og denne trafik, der kommer til den samme domæne, men til en anden URL, kan sendes til containere, der er skrevet i PHP, hvor der er meget logik, men de er ikke så hurtige.
Hvis man sammenligner alle disse begreber med Nomad, kan man sige, at de første tre begreber er samlet i en Service. Det sidste begreb findes ikke i Nomad. Vi brugte en ekstern belastningsfordeler til dette formål: det kan være haproxy, nginx, nginx+ osv. I tilfældet med Kubernetes behøver du ikke at introducere dette begreb separat. Men hvis du ser på Ingress indeni, så er det enten nginx, haproxy eller traefik, men som ombygget inden for Kubernetes.
Alle de begreber, jeg har beskrevet, er i realiteten ressourcer, der eksisterer inden for Kubernetes-klusteret. For at beskrive dem i Kubernetes bruges yaml-formatet, som er mere læsbart og velkendt end HCL-filer i tilfælde af Nomad. Men strukturelt beskriver de f.eks. pods det samme. De siger – jeg ønsker at implementere sådanne pods derhen, med sådanne billeder, i sådanne mængder.
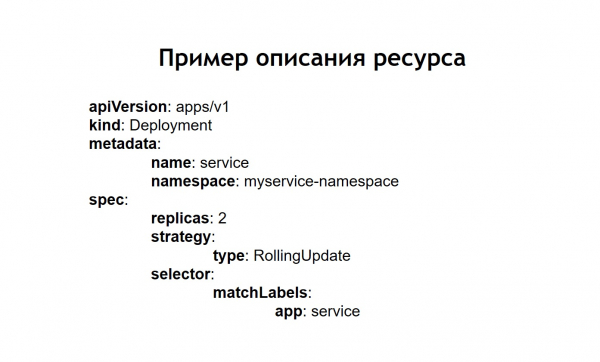
Derudover indså vi, at vi ikke ønskede at oprette hver enkelt ressource manuelt: deployment, tjenester, Ingress og mere. I stedet ønskede vi at beskrive hvert system, vi har, i form af Kubernetes, så vi ikke skulle oprette alle nødvendige ressourceafhængigheder manuelt i den rigtige rækkefølge. Som et sådant system, der gjorde dette muligt, blev Helm valgt.
Grundlæggende begreber i Helm
Helm er pakkehåndtering til Kubernetes. Det ligner, hvordan package managers fungerer i programmeringssprog. De giver dig mulighed for at gemme en service, der består f.eks. af deployment nginx, deployment php-fpm, konfiguration for Ingress, configmaps (dette er en enhed, der gør det muligt at definere env og andre parametre for dit system) i form af såkaldte charts. Samtidig fungerer Helm ovenfor Kubernetes. Så det er ikke et system, der står uafhængigt, men blot en anden service, der kører inden for klynge. Du interagerer med det gennem dets API ved hjælp af kommandolinje. Dets bekvemmelighed og skønhed ligger i, at selvom Helm skulle gå ned, eller du sletter det fra klyngen, så forsvinder dine tjenester ikke, da Helm i bund og grund kun fungerer som en opstart af systemet. Det er Kubernetes, der herefter står for driften og tilstanden af tjenesterne.
Vi indså også, at skabelonbehandling, som vi tidligere var nødt til at implementere manuelt ved at integrere jinja i vores konfigurationer, er en af Helm's grundlæggende funktioner. Alle konfigurationer, du laver til dine systemer, gemmes i Helm som skabeloner, der ligner en smule på jinja, men som i virkeligheden bruger skabelonbehandling af sproget Go, som Helm er skrevet i, ligesom Kubernetes.
Helm tilføjer os endnu et par yderligere begreber.
Chart — er beskrivelsen af din service. I andre package managers ville det blive kaldt et package, bundle eller noget lignende. Her kaldes det chart.
Values – er de variabler, som du ønsker at bruge til at samle dine konfigurationer fra skabeloner.
ReleaseHver gang en service, der deployeres med helm, modtager en inkrementel version af udgivelsen. Helm husker, hvordan konfigurationen af servicen var ved den tidligere, forrige udgivelse og så videre. Derfor er det nok at udføre kommandoen helm rollback med den tidligere version af udgivelsen. Selv hvis den tilsvarende konfiguration ikke er tilgængelig i dit repository på tidspunktet for rollback, husker helm stadig, hvordan den var, og vil gendanne dit system til den tilstand, det var i ved den tidligere udgivelse.
Når vi bruger helm, bliver de almindelige konfigurationer for Kubernetes også til skabeloner, hvor der er mulighed for at anvende variabler, funktioner og betingede operatorer. På den måde kan du samle konfigurationen af din service afhængigt af miljøet.
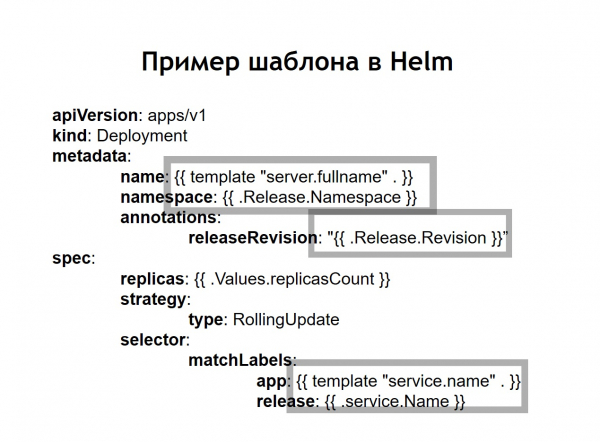
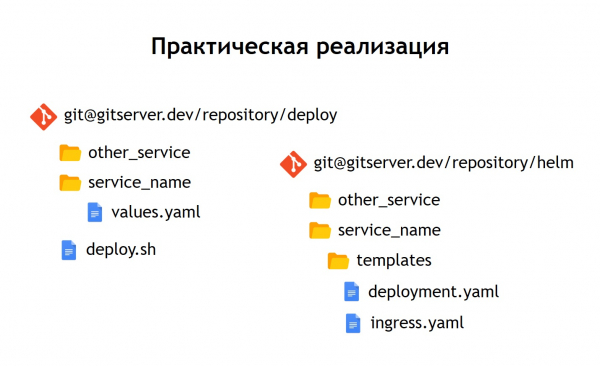
I praksis besluttede vi at håndtere det lidt anderledes, end vi gjorde med Nomad. Mens Nomad opbevarede både konfigurationer til deployment og n-variabler i et enkelt repository, valgte vi her at opdele dem i to separate repositories. I "deploy"-repositoryet opbevares kun n-variablerne, der er nødvendige for deployment, mens konfigurationer eller charts opbevares i "helm"-repositoryet.
Hvad har dette givet os?
Selvom vi ikke opbevarer nogen virkelig følsomme data i selve konfigurationsfilerne, såsom adgangskoder til databaser, da de opbevares som secrets i Kubernetes, er der stadig enkelte ting, som vi ikke ønsker at give adgang til for alle. Derfor er adgangen til "deploy"-repositoryet mere begrænset, mens "helm"-repositoryet indeholder blot beskrivelsen af servicen. Af denne grund kan adgangen til det gives på en sikker måde til et bredere publikum.
Da vi har ikke kun produktion, men også andre miljøer, kan vi med denne opdeling genbruge vores helm-charts til at deployere tjenester ikke bare i produktionen, men også for eksempel i QA-miljøet. Selv for at kunne udvikle dem lokalt ved at bruge Minikube — det er en ting til lokal kørsel af Kubernetes.
Inden for hver repository har vi opdelt i separate mapper for hver tjeneste. Det vil sige, at der inden for hver mappe findes skabeloner, der relaterer sig til den pågældende chart og beskriver de ressourcer, der skal implementeres for at starte vores system. I repository'et 'deploy' har vi kun efterladt miljøvariabler. I dette tilfælde valgte vi ikke at bruge skabelonisering med jinja, fordi helm selv tilbyder skabelonisering som standard – det er en af dens primære funktioner.
Vi har efterladt et script til implementering – deploy.sh, som forenkler og standardiserer opstarten til implementering med helm. Dermed ser deploy-grænsefladen for alle, der ønsker at implementere, nøjagtig ud som den gjorde i tilfælde af implementering via Nomad. Den samme deploy.sh, navnet på din tjeneste, og hvor du ønsker at implementere den. Dette medfører, at helm kører indeni. Det indsamler konfigurationer fra skabeloner, erstatter dem med de nødvendige værdifiler, og derefter implementerer det ved at kaste dem ind i Kubernetes.
Konklusioner
Kubernetes-tjenesten ser mere kompleks ud end Nomad.
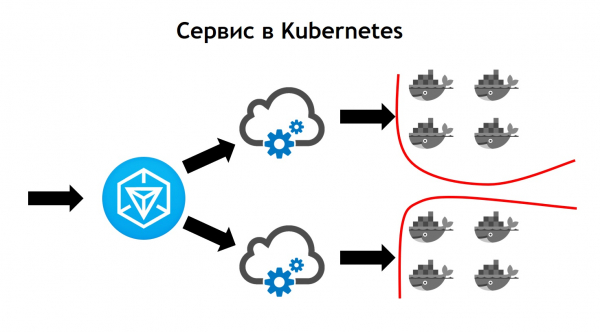
Her kommer den udgående trafik til Ingress. Det er netop frontcontrolleren, der modtager alle forespørgsler og derefter sender dem til de relevante tjenester i henhold til forespørgslen. Den bestemmer dem baseret på konfigurationer, som er en del af beskrivelsen af din applikation i helm, og som udviklerne selv angiver. Tjenesten sender forespørgsler til sine pods, det vil sige specifikke containere, og balancerer den indgående trafik mellem alle de containere, der hører til den pågældende tjeneste. Og selvfølgelig skal vi ikke glemme, at vi ikke bør gå på kompromis med sikkerheden på netværksniveau. Derfor fungerer segmenteringen i Kubernetes-klyngen, som er baseret på tagging. Alle tjenester har bestemte tags, som er knyttet til adgangen til bestemte eksterne/intern ressourcer inden for eller uden for klyngen.
Ved overgangen opdagede vi, at Kubernetes har alle funktioner, som Nomad, som vi tidligere brugte, og tilføjer mange nye muligheder. Det kan udvides gennem plugins, og faktisk gennem brugerdefinerede ressourcearter. Det vil sige, at du ikke kun kan bruge de standardressourcer, der følger med Kubernetes, men også skabe dine egne ressourcer og tjenester, der kan læse dem. Dette giver ekstra muligheder for at udvide dit system uden behov for at geninstallere Kubernetes og uden nødvendigheden af ændringer.
Et eksempel på en sådan anvendelse er Prometheus, som kører inde i vores Kubernetes-kluster. For at det kan begynde at samle metrics fra en given tjeneste, skal vi tilføje en ekstra ressourcetype i tjenestens beskrivelse, såkaldt service-monitor. Takket være Prometheus' evne til at læse brugerdefinerede ressourcearter, når det kører i Kubernetes, begynder det automatisk at indsamle metrics fra det nye system. Det er bastante praktisk.
Den første deployment, vi lavede i Kubernetes, var i marts 2018. Og i denne periode har vi aldrig haft problemer med det. Det fungerer stabilt uden betydelige fejl. Derudover kan vi udvide det yderligere. I dag er de tilgængelige funktioner tilstrækkelige til vores behov, og vi er meget tilfredse med udviklingshastigheden i Kubernetes. I øjeblikket er der mere end 3000 containere i Kubernetes. Klustret strækker sig over flere noder. Det er servicevenligt, stabilt og let at kontrollere.
Kilde: habr.com
