

Som i , opstod der et problem med den distribuerede service, lad os kalde denne service Elvin. Denne gang var det ikke mig selv, der opdagede problemet, men drengene fra klientdelen, der informerede mig.
En dag vågnede jeg op til en utilfreds besked angående store forsinkelser hos Elvin, som vi planlagde at lancere snart. Specifikt oplevede kunden en forsinkelse på 99. percentilen på omkring 50 ms, langt over vores grænse for forsinkelse. Det var overraskende, da jeg havde testet tjenesten omhyggeligt, især hvad angår forsinkelser, da dette ofte er et klagepunkt.
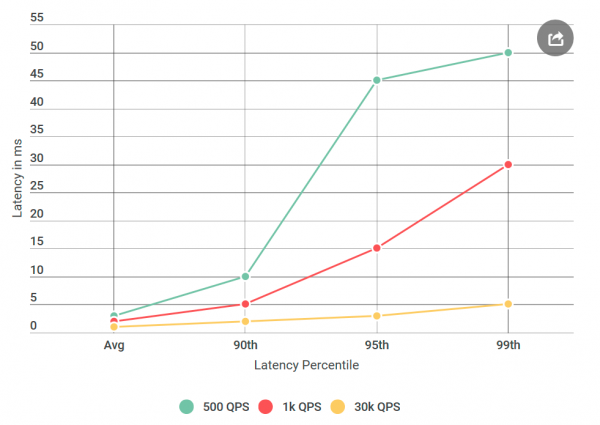
Før jeg sendte Elvin til test, udførte jeg mange eksperimenter med 40.000 forespørgsler pr. sekund (QPS), og alle viste en forsinkelse på mindre end 10 ms. Jeg var klar til at påstå, at jeg ikke var enig i deres resultater. Men da jeg så på brevet igen, lagde jeg mærke til noget nyt: jeg havde helt sikkert ikke testet under de forhold, de nævnte, deres QPS var meget lavere end min. Jeg testede ved 40k QPS, og de kun ved 1k. Jeg udførte endnu et eksperiment, denne gang med lavere QPS, bare for at tilfredsstille dem.
Da jeg skriver om dette på bloggen — har du nok allerede indset det: deres tal viste sig at være korrekte. Jeg kontrollerede min virtuelle klient igen og igen, alt med det samme resultat: lavt antal forespørgsler øger ikke kun forsinkelsen, men øger også antallet af forespørgsler med forsinkelse over 10 ms. Med andre ord, hvis der ved 40k QPS var omkring 50 forespørgsler pr. sekund, der oversteg 50 ms, så var der ved 1k QPS 100 forespørgsler hver sekund over 50 ms. Paradoxalt!
Indskrænk søgningen
Når man står over for forsinkelsesproblemer i et distribueret system med mange komponenter, er det første skridt at lave en kort liste over mistænkte. Lad os dykke lidt dybere ned i Elvins arkitektur:
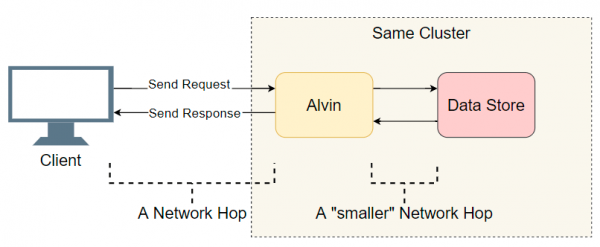
En god start ville være listen over udførte input-output overgange (netværk kald/ diskopslag osv.). Lad os forsøge at finde ud af, hvor forsinkelsen opstår. Udover de åbenlyse input-output med klienten foretager Elvin et ekstra skridt: han henvender sig til datalageret. Men dette lager fungerer i et cluster med Elvin, så forsinkelsen der bør være mindre end med klienten. Så her er listen over mistænkte:
- Netværksopkald fra klienten til Elvin.
- Netværksopkald fra Elvin til datalageret.
- Søgning på disket i datalageret.
- Netværksanrop fra datalageret til Elvin.
- Netværksanrop fra Elvin til klienten.
Lad os prøve at udelukke nogle punkter.
Datalageret er ikke involveret
Først og fremmest transformerede jeg Elvin til en ping-ping server, der ikke behandler anmodninger. Når jeg modtager en anmodning, returnerer den et tomt svar. Hvis forsinkelsen falder, så er fejlen i implementeringen af Elvin eller datalageret - intet usædvanligt. I det første eksperiment får vi følgende graf:
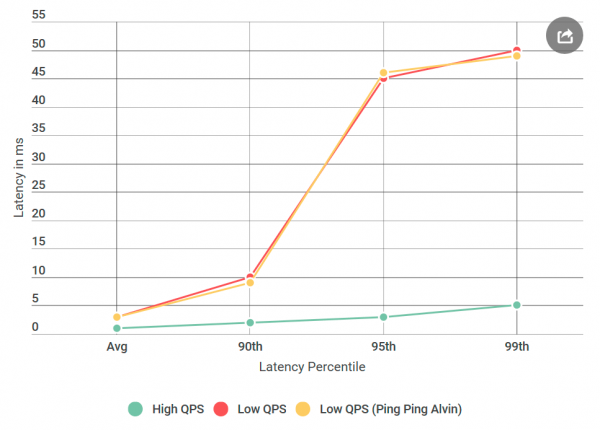
Som vi kan se, er der ingen forbedringer ved brug af ping-ping serveren. Det betyder, at datalageret ikke øger forsinkelsen, og listen over mistænkte formindskes med halvdelen:
- Netværksopkald fra klienten til Elvin.
- Netværksanrop fra Elvin til klienten.
Fantastisk! Listen formindskes hurtigt. Jeg troede, jeg næsten havde fundet årsagen.
gRPC
Nu er det tid til at introducere jer for en ny spiller: . Det er et open source-bibliotek fra Google til inter-process kommunikation . Selvom gRPC det er godt optimeret og bredt anvendt, er det første gang, jeg bruger det i et system af denne størrelse, og jeg forventede, at min implementering ville være suboptimal - mildt sagt.
Tilstedeværelsen af gRPC i stakken rejste et nyt spørgsmål: kunne det være min implementering eller selve gRPC forårsager forsinkelsesproblemet? Vi tilføjer en ny mistænkt til listen:
- Klienten kalder biblioteket
gRPC - Bibliotek
gRPCpå klienten udfører et netværksopkald til biblioteketgRPCpå serveren - Bibliotek
gRPChenvender sig til Elvin (ingen operation i tilfælde af ping-pong serveren)
For at I skal forstå, hvordan koden ser ud, adskiller min implementering af klienten/Elvin sig ikke meget fra klient-server .
Bemærk: den ovenfor nævnte liste er lidt forenklet, da
gRPCden giver mulighed for brug af en egen (skabelon?) trådmodel, hvor udførelsesstakkengRPCog brugerimplementeringen flettes sammen. For enkelhedens skyld holder vi os til denne model.
Profilering vil løse alt
Ved at udelukke datalagerne troede jeg, jeg næsten var færdig: "Nu bliver det nemt! Lad os anvende profilen og finde ud af, hvor forsinkelsen opstår." Jeg , fordi CPU'en er meget hurtig og oftest ikke er flaskehalsen. De fleste forsinkelser opstår, når processoren skal stoppe behandlingen for at gøre noget andet. Præcis CPU-profilering er lavet til netop dette: den registrerer præcist alle og giver indsigt i, hvor forsinkelserne opstår.
Jeg tog fire profiler: én til høj QPS (lav forsinkelse) og med en ping-pong server på lav QPS (høj forsinkelse), både på klientsiden og serversiden. Og for en sikkerheds skyld tog jeg også en prøveprofil af CPU'en. Når jeg sammenligner profiler, leder jeg typisk efter en abnorm funktionstak. For eksempel, på den dårlige side med høj forsinkelse er der betydeligt flere kontekstskift (10 gange eller mere). Men i mit tilfælde var antallet af kontekstskift næsten det samme. Til min skræk var der ikke noget væsentligt at finde.
Yderligere fejlfinding
Jeg var fortvivlet. Jeg vidste ikke, hvilke flere værktøjer jeg kunne bruge, og min næste plan var i bund og grund at gentage eksperimenterne med forskellige variationer i stedet for at diagnosticere problemet klart.
Hvad nu hvis
Fra starten var jeg bekymret over den specifikke forsinkelse på 50 ms. Det er en meget lang tid. Jeg besluttede, at jeg ville klippe stykker af koden, indtil jeg kunne finde ud af, hvilken del der forårsagede denne fejl. Derefter fulgte et eksperiment, som lykkedes.
Som sædvanligt, med bagklogskab virker alt indlysende. Jeg placerede klienten på én maskine med Elvin - og sendte en anmodning til localhost. Og forsinkelsen forsvandt!
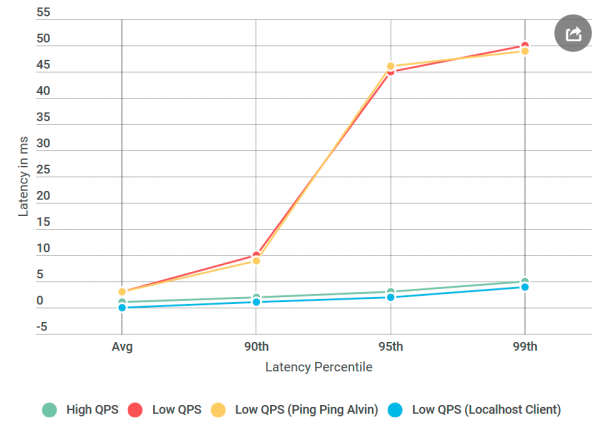
Noget var galt med netværket.
Lærer færdighederne fra netværksingeniøren
Jeg må indrømme: mine netværksteknologiske færdigheder er forfærdelige, især i betragtning af at jeg arbejder med dem dagligt. Men netværket var den primære mistænkte, og jeg havde brug for at lære at fejlfinde det.
Heldigvis elsker internettet dem, der ønsker at lære. Kombinationen af ping og tracert virkede som et godt udgangspunkt for at fejlfinde netværkstransportproblemer.
For det første kørte jeg på TCP-porten til Elvin. Jeg brugte standardindstillingerne - ikke noget særligt. Af mere end tusinde pings oversteg ingen 10 ms, undtagen den første for opvarmning. Dette står i kontrast til den observerede forsinkelse på 50 ms i 99. percentil: der burde vi have set omkring én anmodning med 50 ms forsinkelse for hver 100 anmodninger.
Derefter prøvede jeg : måske er problemet ved en af noderne på ruten mellem Elvin og klienten. Men traceren kom også tilbage uden resultater.
Derfor var årsagen til forsinkelsen ikke min kode, ikke implementeringen af gRPC og ikke netværket. Jeg begyndte allerede at frygte, at jeg aldrig ville forstå dette.
Nu, hvilket OS er vi på
gRPC er bredt anvendt i Linux, men for Windows er det eksotisk. Jeg besluttede at udføre et eksperiment, som lykkedes: jeg oprettede en virtuel Linux-maskine, kompilerede Alvin til Linux og deployerede den.
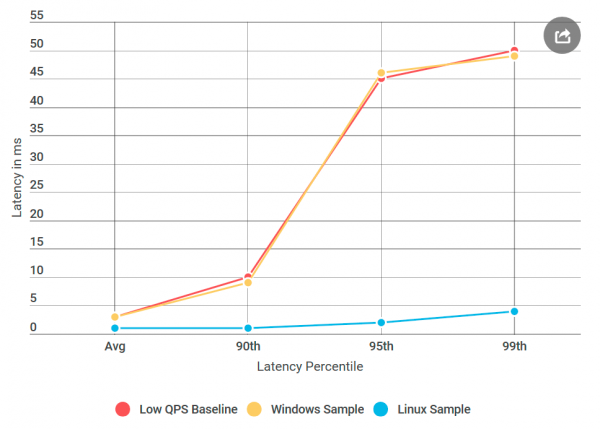
Og her er hvad der kom ud af det: i ping-pong serveren på Linux var der ikke de samme forsinkelser som på den tilsvarende Windows-node, selvom datakilden ikke var forskellig. Problemet viste sig at være implementeringen af gRPC for Windows.
Nagle-algoritmen
I hele denne tid har jeg troet, at jeg manglede en flag gRPC. Nu forstår jeg, at det faktisk er en gRPC flag for Windows, der mangler. Jeg fandt et internt RPC-bibliotek, som jeg var sikker på fungerede godt for alle installerede flag . Jeg tilføjede så alle disse flag til gRPC og deployerede Alvin på Windows, i den reviderede ping-pong server under Windows!
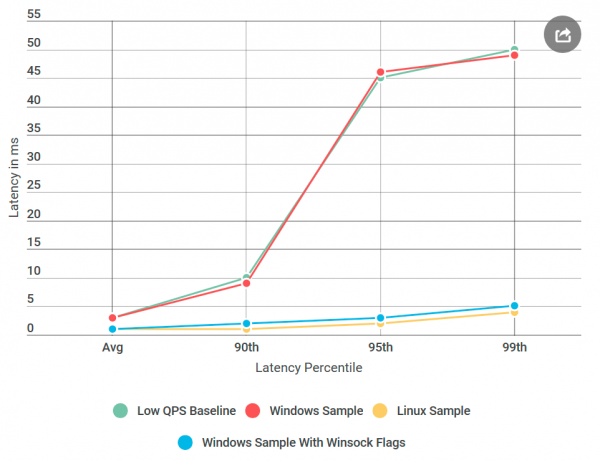
Næsten klar: jeg begyndte at fjerne de tilføjede flag ét ad gangen, indtil regressionen kom tilbage, så jeg kunne bestemme årsagen præcist. Det var den berygtede , Nagle-algoritmen switch.
forsøger at reducere antallet af pakker sendt over netværket ved at forsinke overførslen af meddelelser, indtil pakkestørrelsen overstiger et bestemt antal bytes. Selvom dette kan være godt for den gennemsnitlige bruger, er det ødelæggende for realtidsservere, da OS vil forsinke nogle meddelelser, hvilket medfører forsinkelser ved lav QPS. Der gRPC var dette flag sat i Linux-implementeringen for TCP-sockets, men ikke for Windows. Jeg fandt det .
Konklusion
Den store forsinkelse ved lav QPS skyldtes OS' optimering. Når jeg ser tilbage, kunne profileringen ikke opdage forsinkelsen, fordi den blev foretaget i kernel-tilstand, ikke i . Jeg ved ikke, om man kan observere Nagle-algoritmen gennem ETW-optagelser, men det ville være interessant.
Hvad angår localhost-eksperimentet, berørte det sandsynligvis ikke den faktiske netværkskode, og Nagle-algoritmen blev ikke aktiveret, så forsinkelsesproblemerne forsvandt, da klienten tilsluttede Alvin via localhost.
Næste gang du ser en stigning i forsinkelse med faldende anmodninger per sekund, skal Nagle-algoritmen være på din mistænkte liste!
Kilde: habr.com
