

Indledning
Jeg præsenterede dette foredrag på engelsk ved GopherCon Rusland 2019 i Moskva og på russisk ved mødet i Nizhny Novgorod. Det handler om bitmap-indekset — mindre almindeligt end B-tree, men ikke mindre interessant. Jeg deler af præsentationen på konferencen på engelsk og den skriftlige transkription på russisk.
Vi vil se på, hvordan bitmap-indekset fungerer, hvornår det er bedre, hvornår det er værre end andre indekser, og i hvilke tilfælde det er betydeligt hurtigere end dem; vi vil se, hvilke populære DBMS'er der allerede har bitmap-indekser; vi vil forsøge at skrive vores eget i Go. Og som dessert vil vi bruge eksisterende biblioteker til at lave vores egen superhurtige specialiserede database.
Jeg håber meget, at mit arbejde vil være nyttigt og interessant for jer. Lad os komme i gang!
Introduktion

Hej alle! Klokken er seks om aftenen, og vi er alle super trætte. Det er et fantastisk tidspunkt at tale om den kedelige teori om databaseindekser, ikke? Bare rolig, jeg har et par linjer kode her og der. 🙂
Hvis vi skal være seriøse, er foredraget fyldt med information, og vi har ikke så meget tid. Så lad os starte.
I dag vil jeg tale om følgende:
- hvad indekser er;
- hvad bitmap-indekset er;
- hvor det bruges, og hvor det IKKE bruges, og hvorfor;
- en simpel implementering i Go og lidt kamp med compileren;
- en lidt mindre simpel, men meget mere performant implementering i Go-assembler;
- de 'problemer', bitmap-indekser har;
- eksisterende implementeringer.
Så hvad er indekser?
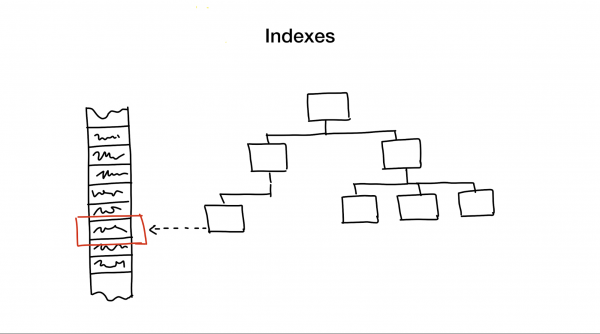
Et indeks er en separat datastruktur, som vi holder og opdaterer udover de primære data. Det bruges til at fremskynde søgning. Uden indekser ville søgning kræve en fuld gennemgang af dataene (en proces kaldet full scan), og denne proces har en lineær algoritmisk kompleksitet. Men databaser indeholder typisk enorme mængder data, og lineær kompleksitet er for langsomt. Ideelt set ønsker vi at få logaritmisk eller konstant.
Det er et kæmpe komplekst emne, fyldt med nuancer og kompromiser, men efter at have set på årtiers udvikling og forskning inden for forskellige databaser, er jeg klar til at påstå, at der kun er et par bredt anvendte tilgange til at oprette databaser indekser.
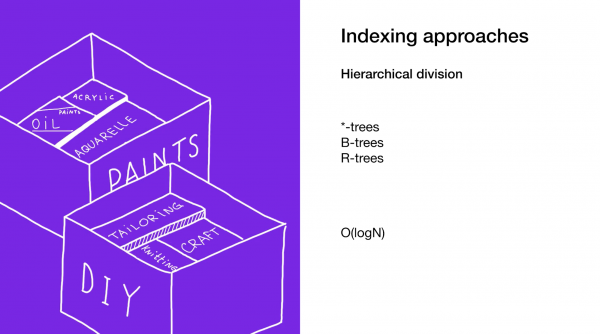
Den første tilgang er baseret på hierarkisk reduktion af søgeområdet, hvor vi opdeler søgeområdet i mindre dele.
Vi gør normalt dette ved hjælp af forskellige typer træer. Et eksempel kunne være en stor kasse med materialer i dit skab, der indeholder mindre kasser med materialer delt op efter forskellige emner. Hvis du har brug for materialer, vil du helt sikkert søge i kassen mærket 'Materialer' og ikke i den, der hedder 'Småkager', ikke sandt?
Den anden tilgang er at fremhæve det nødvendige element eller gruppe af elementer med det samme. Vi gør dette i hash maps eller omvendte indekser. Brugen af hash maps ligner meget det tidligere eksempel, men i stedet for en kasse med kasser har du i dit skab en bunke små kasser med de endelige genstande.
Den tredje tilgang er at fjerne behovet for søgning. Dette gør vi ved hjælp af Bloom-filtre eller cuckoo-filtre. De første giver et svar øjeblikkeligt og fjerner behovet for at foretage en søgning.
Den sidste tilgang er at udnytte al kapacitet, som moderne hardware tilbyder. Det er netop det, vi gør med bitmap-indekser. Ja, når vi bruger dem, skal vi nogle gange gennemgå hele indekset, men vi gør det super effektivt.
Som jeg allerede har nævnt, er emnet for DB-indekser omfattende og fuld af kompromiser. Det betyder, at vi nogle gange kan bruge flere tilgange samtidigt: hvis vi skal fremskynde søgningen yderligere, eller hvis vi skal dække alle mulige søgetyper.
I dag vil jeg tale om den mindst kendte tilgang af de nævnte - bitmap-indekser.
Hvem er jeg til at tale om dette emne?
Jeg arbejder som teamleder hos Badoo (måske kender du bedre et af vores andre produkter - Bumble). Vi har over 400 millioner brugere verden over og mange funktioner, der hjælper med at finde den bedste partner til dem. Det gør vi ved hjælp af skræddersyede services, der også benytter bitmap-indekser.
Hvad er så et bitmap-indeks?
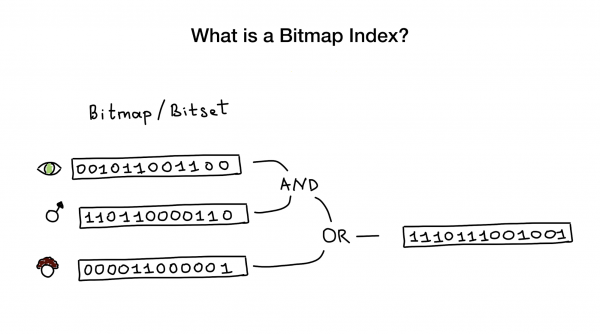
Bitmap-indekser, som navnet antyder, bruger bitmapper eller bitmængder til at implementere en søgeindeks. Set fra oven består denne indeks af et eller flere sådanne bitmapper, der repræsenterer forskellige enheder (som mennesker) og deres egenskaber eller parametre (alder, øjenfarve osv.), samt en algoritme, der bruger bitoperationer (AND, OR, NOT) for at besvare en søgeforespørgsel.
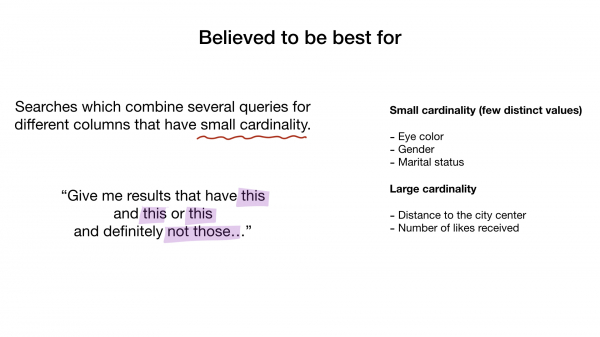
Det siges, at bitmap-indekser er bedst egnet og meget effektive, når der er søgninger, der kombinerer forespørgsler på mange kolonner med lav kardinalitet (forestil dig 'øjenfarve' eller 'familieforhold' mod noget som 'afstand fra byens centrum'). Men senere vil jeg vise, at de også fungerer fremragende med kolonner med høj kardinalitet.
Lad os overveje et simpelt eksempel på en bitmap-indeks.
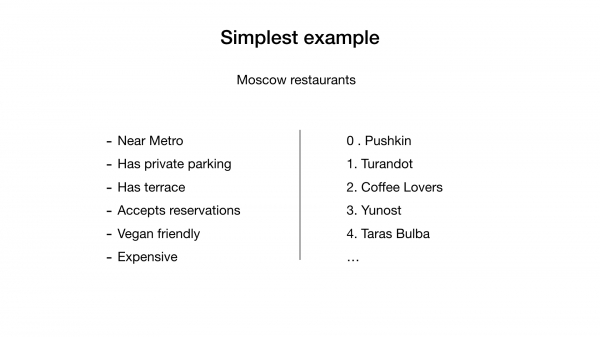
Forestil dig, at vi har en liste over restauranter i Moskva med binære egenskaber som disse:
- nær metro (near metro);
- har privat parkering (has private parking);
- har terrasse (has terrace);
- accepterer reservationer (accepts reservations);
- veganervenlig (vegan friendly);
- dyr (expensive).
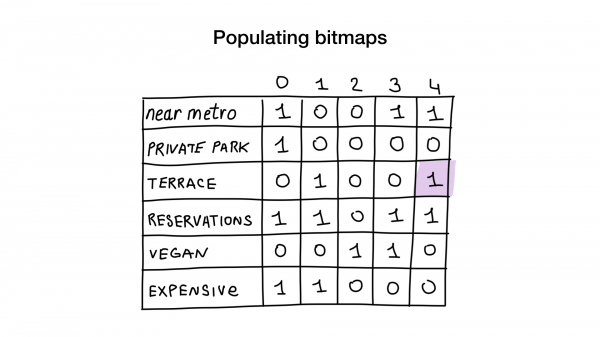
Lad os give hver restaurant et rækkenummer, der begynder fra 0, og allokere hukommelse til 6 bitmapper (én for hver egenskab). Derefter fylder vi disse bitmapper afhængigt af, om restauranten har denne egenskab eller ej. Hvis restaurant 4 har en terrasse, vil bit nr. 4 i bitmappen 'har terrasse' blive sat til 1 (hvis terrassen ikke er der, så til 0).
Nu har vi den enkleste bitmap-indeks, man kan få, og vi kan bruge den til at besvare forespørgsler som:
- «Vis mig restauranter, der er velegnede til veganere»;
- «Vis mig billige restauranter med terrasse, hvor der kan reserveres bord».
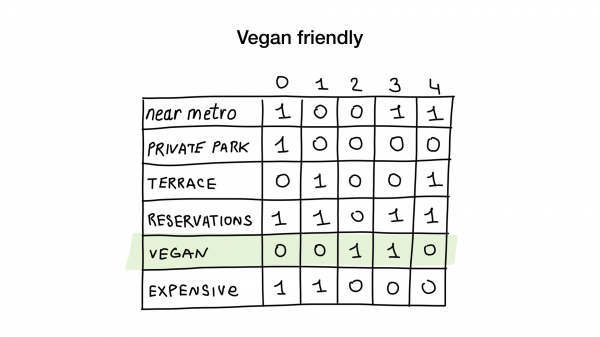
Hvordan? Lad os se. Den første forespørgsel er meget enkel. Alt, hvad vi behøver, er at tage bitmappen 'veganervenlig' og konvertere den til en liste over restauranter, hvis bits er sat.
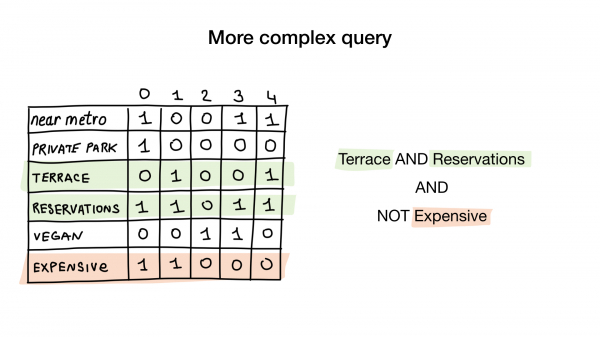
Den anden forespørgsel er lidt mere kompliceret. Vi skal bruge bitoperationen NOT på bitmap'en "dyr", for at få en liste over billige restauranter, derefter AND'e den med bitmap'en "kan reserveres" og AND'e resultatet med bitmap'en "har terrasse". Den resulterende bitmap vil indeholde en liste over steder, der opfylder alle vores kriterier. I dette eksempel er det kun restauranten "Ungdom".
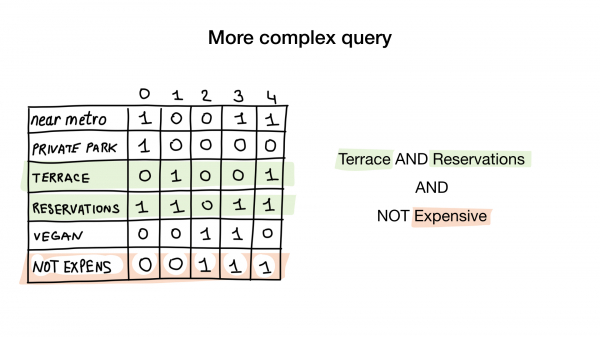
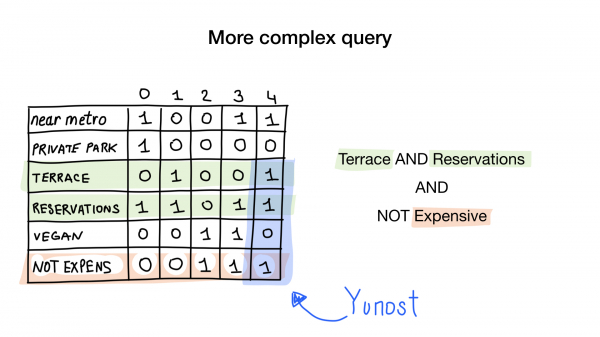
Der er meget teori her, men bare rolig, vi vil snart se koden.
Hvor bruges bitmap-indekser?
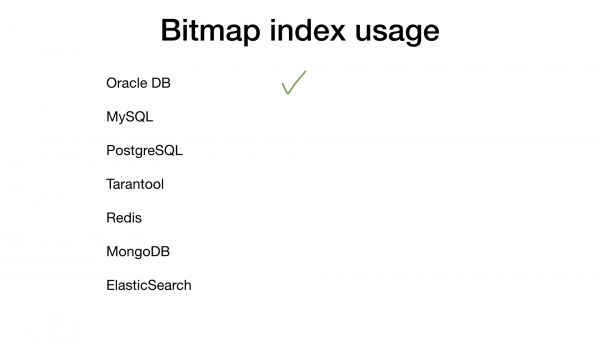
Hvis du "googler" bitmap-indekser, vil 90% af svarene være på en eller anden måde relateret til Oracle DB. Men andre DBMS må også støtte sådan en cool ting, ikke sandt? Ikke helt.
Lad os tage et kig på listen over hovedmistænkte.
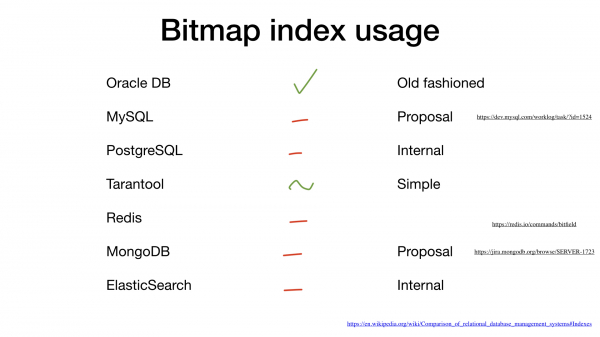
MySQL understøtter stadig ikke bitmap-indekser, men der er et forslag om at tilføje denne mulighed ().
PostgreSQL understøtter ikke bitmap-indekser, men bruger enkle bitmaps og bitoperationer til at kombinere søgeresultater fra flere andre indekser.
Tarantool har bitset-indekser; det understøtter simpel søgning på dem.
Redis har enkle bitfelter) uden mulighed for at søge i dem.
MongoDB understøtter stadig ikke bitmap-indekser, men der er også et forslag om at tilføje denne mulighed.
Elasticsearch bruger bitmaps internt).
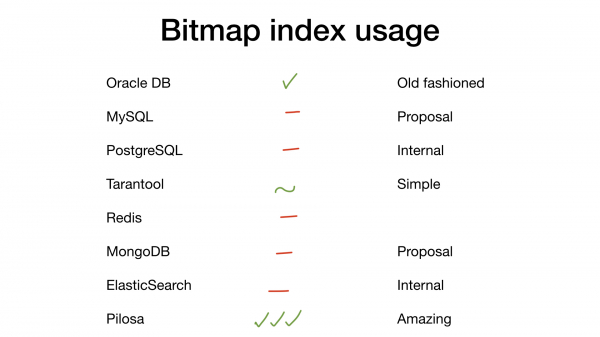
- Men i vores hus er der en ny nabo: Pilosa. Det er en ny ikke-relational database skrevet i Go. Den indeholder kun bitmap-indekser og baserer alt på dem. Vi vil tale om den lidt senere.
Implementering i Go
Men hvorfor bruges bitmap-indekser så sjældent? Før jeg svarer på dette spørgsmål, vil jeg gerne demonstrere en meget simpel implementering af et bitmap-index i Go.
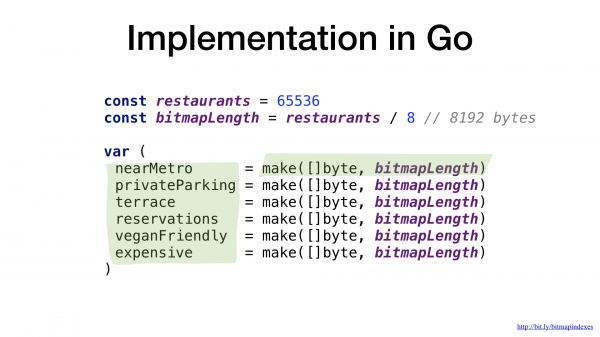
Bitmaps er i bund og grund blot repræsenteret som datablokke. I Go lad os bruge byte-slices til dette.
Vi har en bitmap for en restaurantkarakteristik, og hver bit i bitmap'en angiver, om den pågældende restaurant har denne egenskab eller ej.
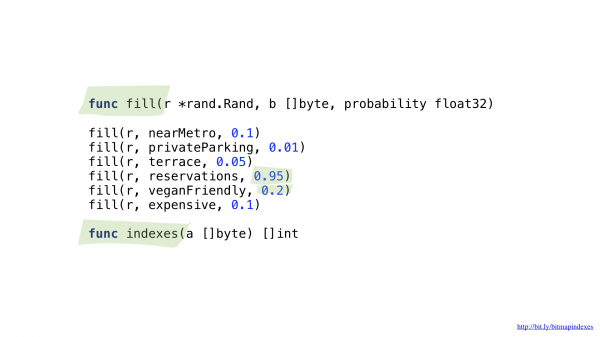
Vi har brug for to hjælpefunktioner. Den ene vil blive brugt til at udfylde vores bitmaps med tilfældige data. Tilfældige, men med en bestemt sandsynlighed for, at restauranten har hver egenskab. For eksempel mener jeg, at der er meget få restauranter i Moskva, hvor det ikke er muligt at reservere et bord, og jeg tror, at cirka 20% af stederne er velegnede til vegetarer.
Den anden funktion vil konvertere bitmapen til en liste over restauranter.
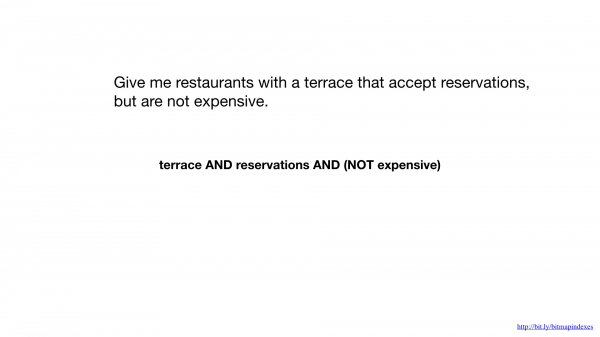
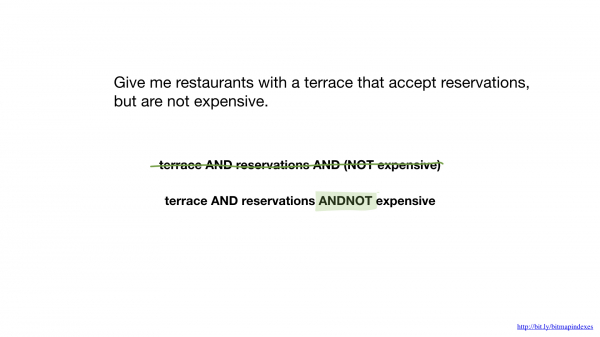
For at svare på forespørgslen "Vis mig billige restauranter med terrasse, hvor det er muligt at reservere et bord", har vi brug for to bitoperationer: NOT og AND.
Vi kan forenkle vores kode lidt ved at bruge en mere kompleks operation AND NOT.
Vi har funktioner til hver af disse operationer. Begge gennemgår skiver, tager de tilsvarende elementer fra hver, kombinerer dem med en bitoperation og lægger resultatet i en resultatarray.
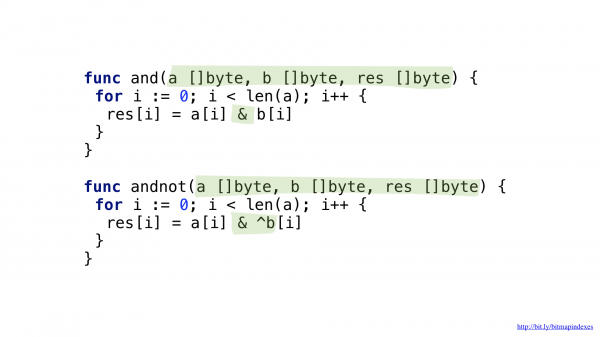
Og nu kan vi bruge vores bitmaps og funktioner til at besvare søgeforespørgslen.
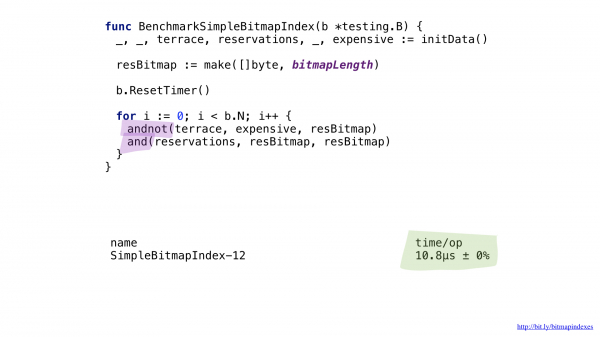
Ydelsen er ikke så høj, selvom funktionerne er meget simple, og vi har sparet en del ved ikke at returnere en ny resultatarray ved hver funktionsopkald.
Efter lidt profilering med pprof bemærkede jeg, at Go-kompilatoren overså en meget simpel, men vigtig optimering: funktionsinlining.
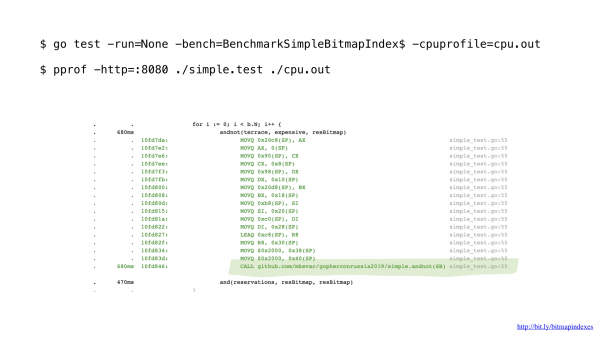
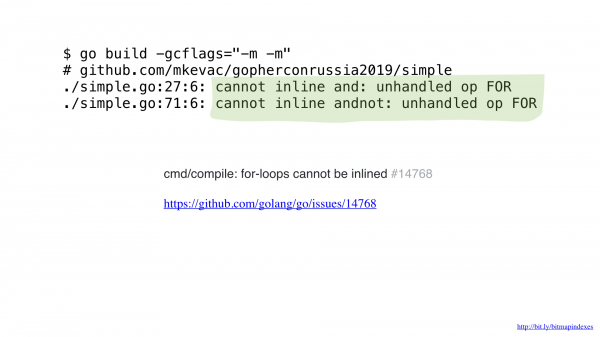
Sagen er, at Go-kompilatoren er ekstremt bange for løkker, der går gennem skiver, og nægter kategorisk at inline funktioner, der indeholder sådanne løkker.
Men jeg er ikke bange og kan narre kompilatoren ved at bruge goto i stedet for en løkke, som i de gode gamle dage.
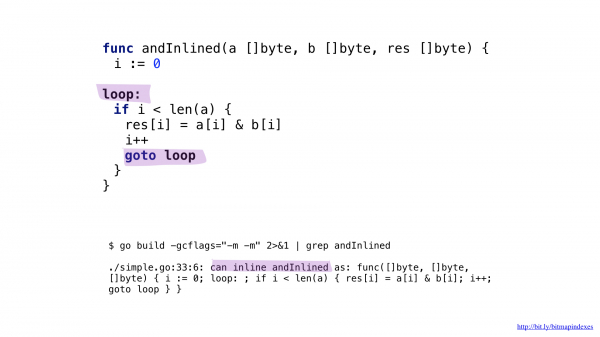
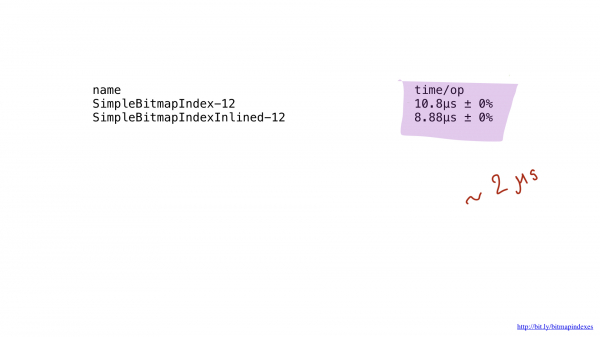
Og som du kan se, så inline'er kompilatoren nu gladeligt vores funktion! I sidste ende formår vi at spare omkring 2 mikrosekunder. Ikke dårligt!
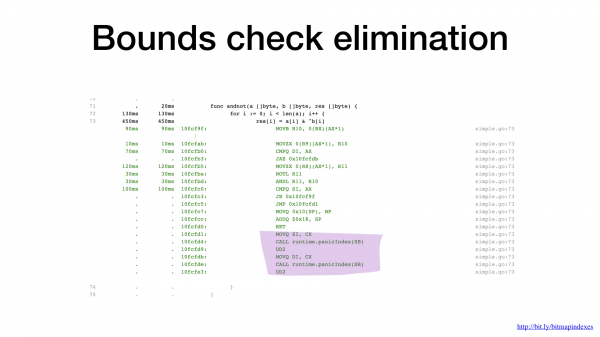
Det andet flaskehals er ikke svært at se, hvis man ser nøje på assemblerudgangen. Kompilatoren tilføjede en grænsekontrol direkte inde i vores mest brugte løkke. Sagen er, at Go er et sikkert sprog, og kompilatoren er bange for, at mine tre argumenter (de tre skiver) har forskellig størrelse. For så ville der være en teoretisk mulighed for, at der opstår såkaldt buffer overflow.
Lad os berolige compileren ved at vise, at alle skiver har samme størrelse. Vi kan gøre dette ved at tilføje en simpel kontrol i starten af vores funktion.
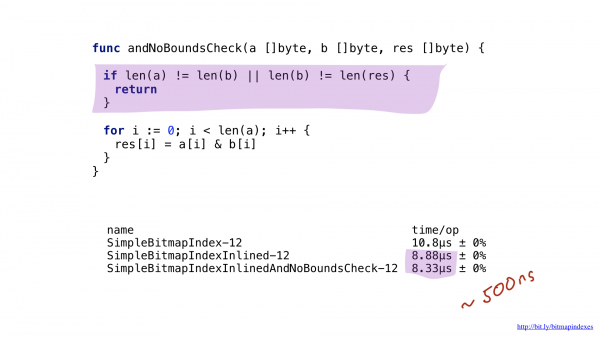
Når den ser dette, springer compileren glad over kontrollen, og vi sparer faktisk 500 nanosekunder.
Store batches
Okay, vi har formået at få noget ydeevne ud af vores enkle implementering, men dette resultat er faktisk meget dårligere end hvad der er muligt med det nuværende hardware.
Alt hvad vi gør, er grundlæggende bitoperationer, og vores processorer udfører dem meget effektivt. Men desværre "fodrer" vi vores processor med meget små stykker arbejde. Vores funktioner udfører operationer byte for byte. Vi kan let optimere vores kode til at arbejde med 8-byte stykker ved at bruge skiver af UInt64.
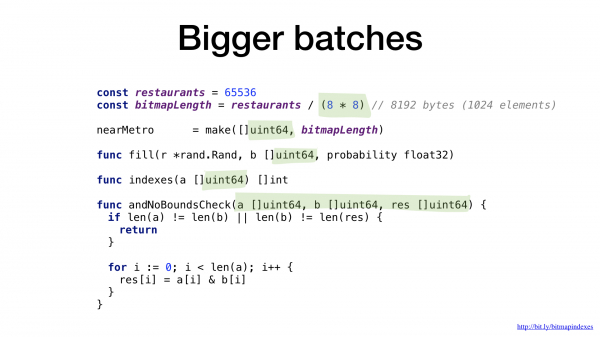
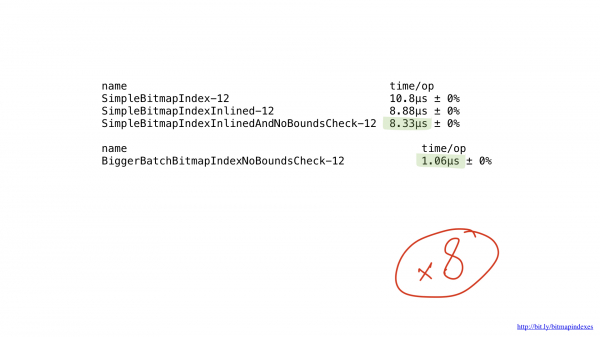
Som du kan se, har denne lille ændring accelereret vores program otte gange ved at øge batch-størrelsen otte gange. Gevinsten er i bund og grund lineær.
Implementation i assembler
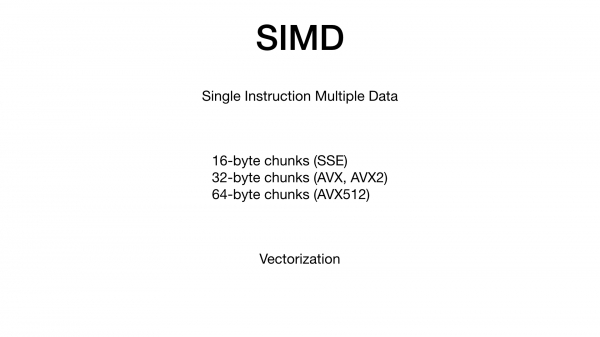
Men det er ikke slutningen. Vores processorer kan arbejde med stykker på 16, 32 og endda 64 byte. Sådanne "bredde" operationer kaldes single instruction multiple data (SIMD; én instruktion, mange data), og processen med at ændre koden, så den bruger sådanne operationer, kaldes vektorisering.
Desværre er Go-compiler ikke særlig god til vektorisering. På nuværende tidspunkt er den eneste måde at vektorisere kode i Go, at tage og lægge dataoperationer manuelt ved hjælp af Go-assembler.
Go-assembler er et mærkeligt væsen. Du ved sikkert, at assembler er noget, der er meget bundet til den computerarkitektur, du skriver til, men sådan er det ikke i Go. Go-assembler minder mere om IRL (intermediate representation language) eller mellemtrinssprog: det er praktisk taget platformuafhængigt. Rob Pike præsenterede et fantastisk om dette for et par år siden på GopherCon i Denver.
Derudover bruger Go et usædvanligt format, Plan 9, som adskiller sig fra de anerkendte AT&T- og Intel-formater.
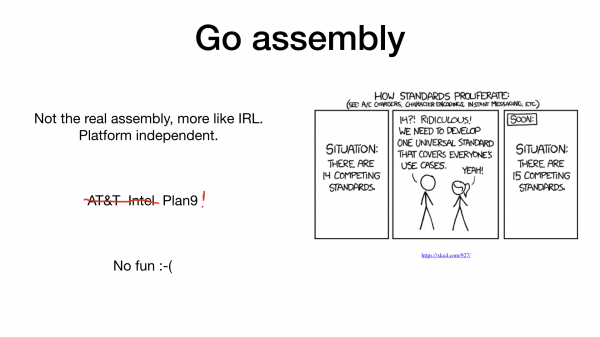
Man kan trygt sige, at det ikke er den sjoveste opgave at skrive Go-assembler manuelt.
Men heldigvis er der allerede to højniveau værktøjer, der hjælper os med at skrive Go-assembler: PeachPy og avo. Begge værktøjer genererer Go-assembler fra mere høj-niveau kode skrevet i henholdsvis Python og Go.
Disse værktøjer forenkler ting som registerallokering, skrivning af loops, og generelt gør det lettere at træde ind i verden af assemblerprogrammering i Go.
Vi vil bruge avo, så vores programmer næsten vil være almindelige Go-programmer.
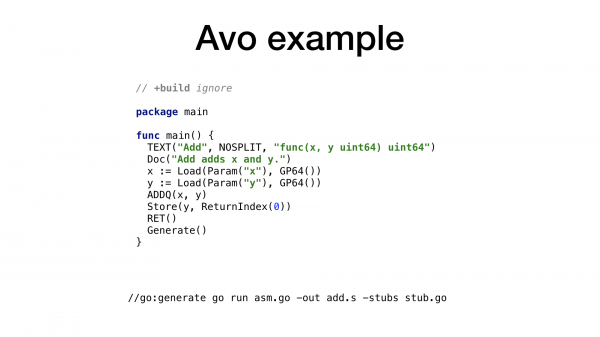
Her er det enkleste eksempel på et avo-program. Vi har en main()-funktion, der definerer en funktion Add() indeni, hvis formål er at lægge to tal sammen. Der er hjælpefunktioner til at hente parametre efter navn og til at få et ledigt og passende processorregister. Hver processoroperation har en tilsvarende funktion i avo, som man kan se med ADDQ. Og endelig ser vi en hjælpefunktion til at gemme det resulterende værd.
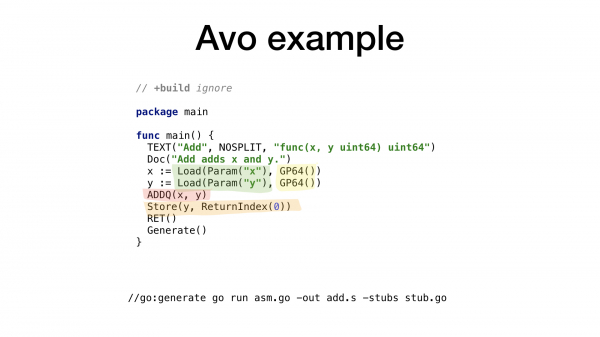
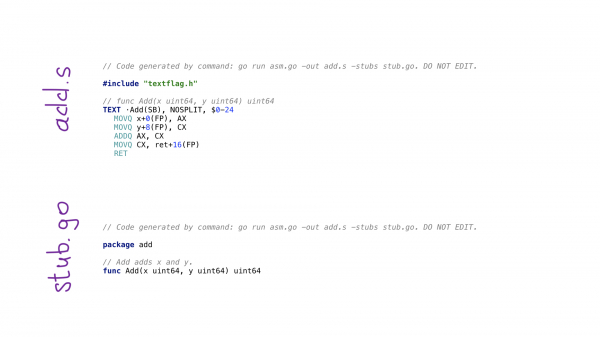
Når vi kalder go generate, vil vi køre programmet i avo, og der vil blive genereret to filer:
- add.s med den resulterende kode i Go-assembler;
- stub.go med funktionsoverskrifter for at forbinde de to verdener: Go og assembler.
Nu hvor vi har set, hvad og hvordan avo fungerer, lad os se på vores funktioner. Jeg har implementeret både de skalar og vektor (SIMD) versioner af funktionerne.
Lad os først se på de skalar versioner.
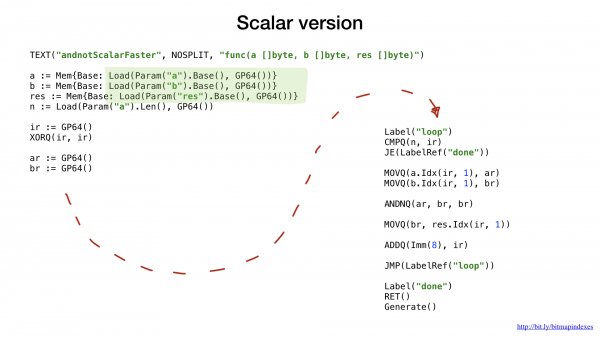
Som i det tidligere eksempel beder vi om at få et ledigt og korrekt register af almindelig brug, vi har ikke brug for at beregne forskydninger og størrelser for argumenterne. Alt dette klarer avo for os.
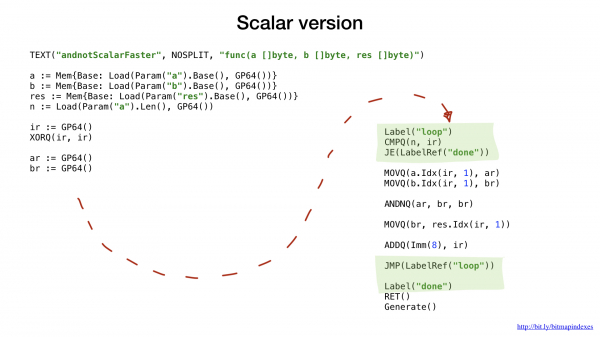
Tidligere brugte vi labels og goto (eller spring) for at forbedre ydeevnen og for at narre Go-kompilereren, men nu gør vi det fra starten. Forskellen er, at loops er et mere højere begreb. I assembler har vi kun labels og spring.
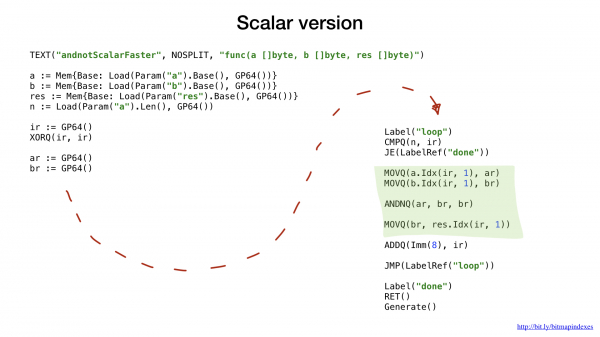
Den resterende kode skal allerede være bekendt og forståelig. Vi emulerer en loop med labels og spring, tager en lille del af data fra vores to slices, kombinerer dem med en bitoperation (AND NOT i dette tilfælde) og derefter placerer resultatet i den resulterende slice. Det er alt.
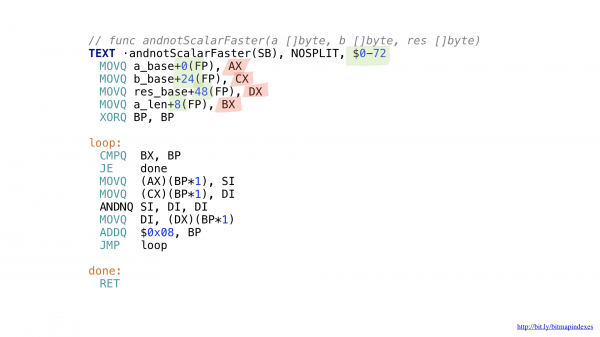
Her er den endelige kode i assembler. Vi behøvede ikke at beregne forskydninger og størrelser (markeret med grønt) eller holde øje med de anvendte registre (markeret med rødt).
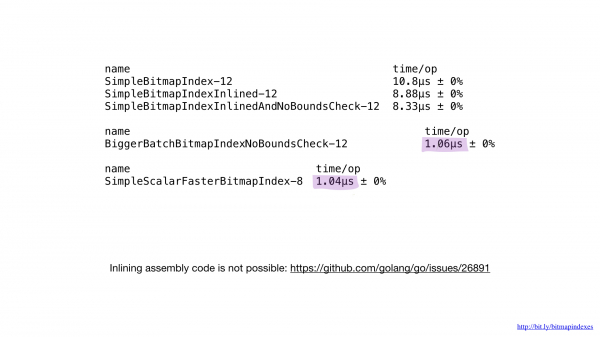
Hvis vi sammenligner ydeevnen af implementeringen i assembler med ydeevnen af den bedste implementering i Go, vil vi se, at de er ens. Og det er forventeligt. For vi har ikke gjort noget særligt — vi har blot genskabt det, som Go-kompilatoren ville have gjort.
Desværre kan vi ikke få kompilatoren til at inline vores funktioner, der er skrevet i assembler. Go-kompilatoren mangler i øjeblikket denne funktion, selv om der har været en anmodning om at tilføje den i lang tid.
Netop derfor er det umuligt at få nogen som helst fordele ved små funktioner i assembler. Vi må enten skrive store funktioner, eller også bruge det nye math/bits bibliotek, eller undgå assembler helt.
Lad os nu se på de vektoriserede versioner af vores funktioner.
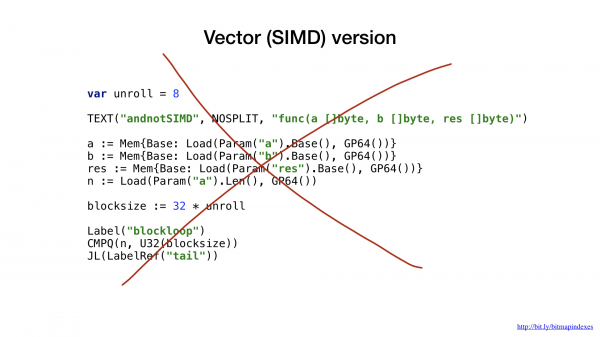
Til dette eksempel har jeg valgt at anvende AVX2, så vi vil bruge operationer, der arbejder med 32-byte blokke. Kodestrukturen ligner meget den skalar version: indlæsning af parametre, anmodning om en ledig fælles registreringsenhed osv.
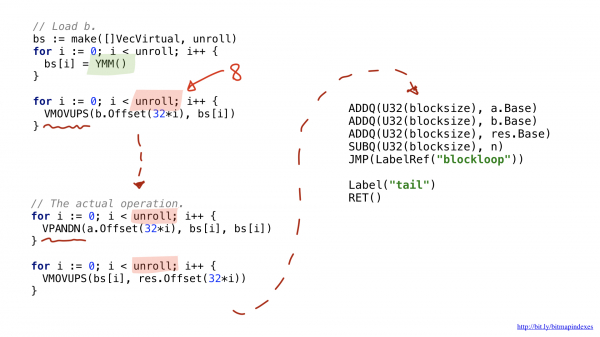
En af nyhederne er, at de bredere vektoroperationer bruger særlige brede registre. I tilfælde af 32-byte blokke er det registre med præfikset Y. Derfor ser du funktionen YMM() i koden. Hvis jeg havde brugt AVX-512 med 64-bit blokke, ville præfikset have været Z.
En anden nyhed er, at jeg har valgt at bruge en optimering kaldet loop unrolling, hvilket vil sige at udføre otte loop-operationer manuelt, inden vi hopper tilbage til starten af loopet. Denne optimering reducerer antallet af brancher i koden og er begrænset af antallet af ledige registre til rådighed.
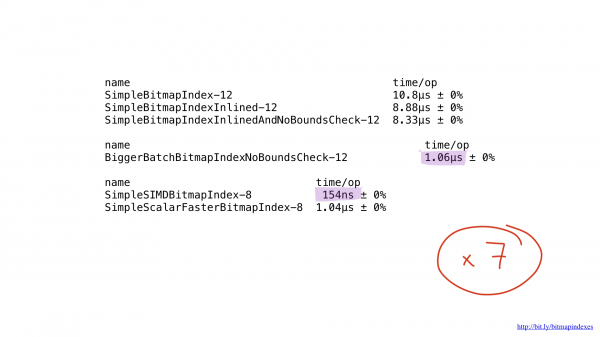
Hvad med ydeevnen? Den er fremragende! Vi har opnået en acceleration på cirka syv gange sammenlignet med den bedste løsning i Go. Imponerende, ikke?
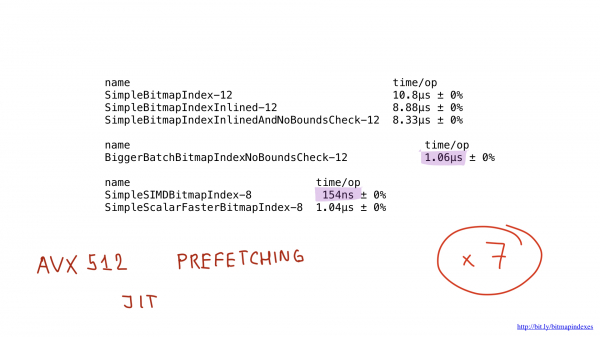
Men selv denne implementering kunne potentielt være blevet accelereret ved hjælp af AVX-512, prefetching eller JIT (just-in-time compiler) til forespørgselsplanlæggeren. Men det er helt klart et emne for et separat foredrag.
Problemer med bitmap-indekser
Nu hvor vi har gennemgået en simpel implementering af bitmap-indeksen i Go og en langt mere effektiv i assembler, lad os endelig tale om, hvorfor bitmap-indekser så sjældent anvendes.
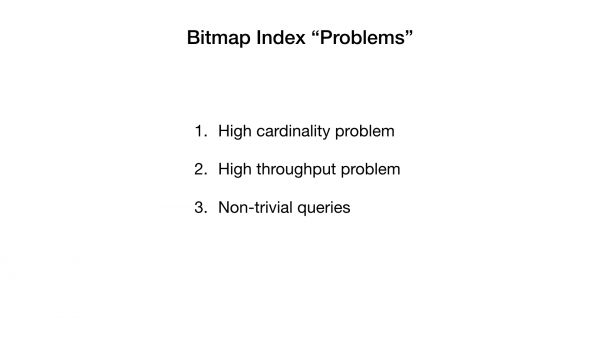
I de gamle videnskabelige arbejder nævnes der tre problemer med bitmap-indekser, men nyere forskning og jeg selv hævder, at de ikke længere er relevante. Lad os ikke dykke dybt ind i hvert af disse problemer, men overfladisk se på dem.
Problemet med høj kardinalitet
Så vi får at vide, at bitmap-indekser kun er egnede til felter med lav kardinalitet, dvs. dem med få værdier (f.eks. køn eller øjenfarve), og grunden til dette er, at den almindelige repræsentation for sådanne felter (én bit pr. værdi) ved høj kardinalitet ville optage for meget plads, og desuden ville disse bitmap-indekser være svagt (sjældent) udfyldt.
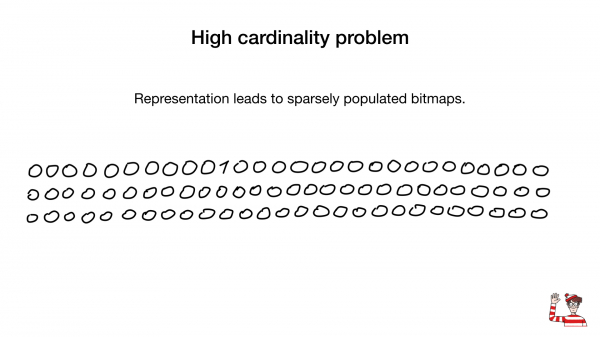
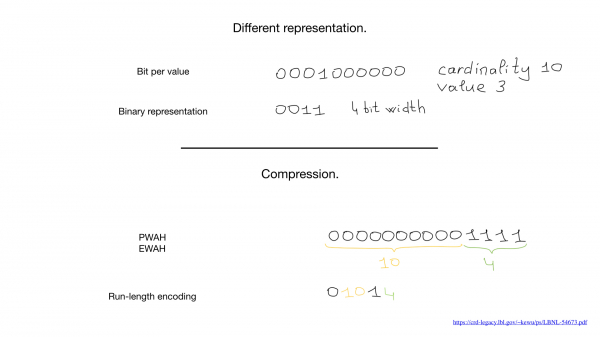
Nogle gange kan vi bruge en anden repræsentation, f.eks. den standard, vi bruger til at repræsentere tal. Men det var introduktionen af komprimeringsalgoritmer, der ændrede alt. I løbet af de sidste årtier har forskere og akademikere udviklet et stort antal komprimeringsalgoritmer til bitmapper. Deres primære fordel er, at der ikke er behov for at dekomprimere bitmapper for at udføre bit-operationer — vi kan udføre bit-operationer direkte på de komprimerede bitmapper.
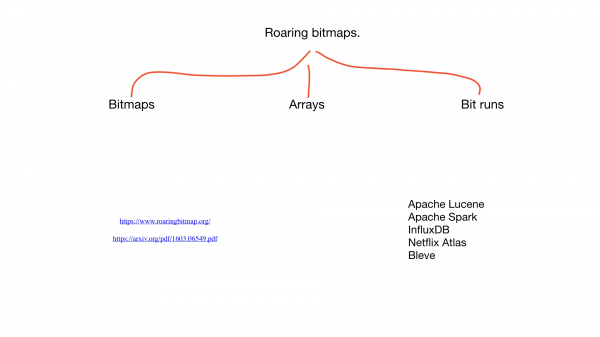
For nylig er der også begyndt at dukke hybridmetoder op, såsom roaring bitmapper. De bruger samtidig tre forskellige repræsentationer til bitmapper — selve bitmapperne, arrays og såkaldte bit runs — og balancerer mellem dem for at maksimere ydeevne og minimere hukommelsesforbruget.
Du kan finde roaring bitmapper i de mest populære applikationer. Der findes allerede et stort antal implementationer til mange forskellige programmeringssprog, inklusive mere end tre implementationer til Go.
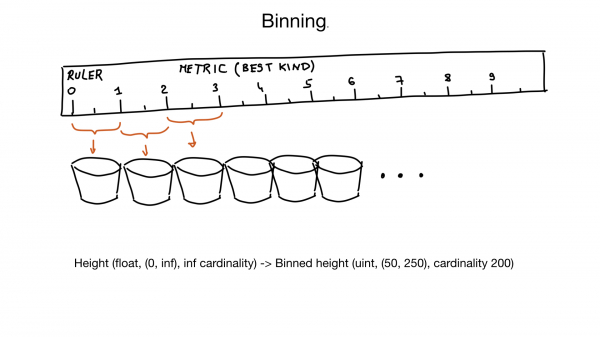
En anden tilgang, der kan hjælpe os med at håndtere høj kardinalitet, kaldes gruppering (binning). Forestil dig, at du har et felt, der repræsenterer en persons højde. Højde er et flydende tal, men vi mennesker tænker ikke på det på den måde. For os er der ingen forskel mellem en højde på 185,2 cm og 185,3 cm.
Så vi kan gruppere lignende værdier i grupper inden for 1 cm.
Og hvis vi også ved, at der meget sjældent er mennesker, der er mindre end 50 cm høje eller højere end 250 cm, kan vi i princippet omdanne et felt med uendelig kardinalitet til et felt med en kardinalitet på omtrent 200 værdier.
Selvfølgelig kan vi, hvis det er nødvendigt, foretage yderligere filtrering efterfølgende.
Problemet med høj båndbredde
Det næste problem med bitmap-indekser er, at opdatering af dem kan være meget kostbart.
Databaser skal give mulighed for at opdatere data i det øjeblik, hvor hundreder af andre forespørgsler potentielt søger på disse data. Vi har brug for låse for at undgå problemer med samtidig adgang til data eller andre problemer med delt adgang. Og hvor der er én stor lås, er der et problem — lock contention, når denne lås bliver en flaskehals.
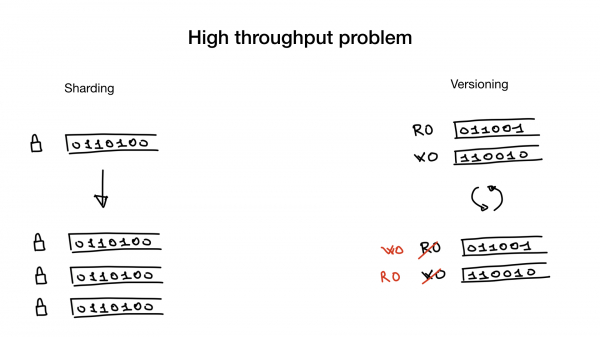
Dette problem kan løses eller omgås ved hjælp af sharding eller ved at bruge versionsindekser.
Sharding er enkelt og almengyldigt. Du kan shard bitmap-indekset, ligesom du ville shard andre data. I stedet for én stor lås får du mange små låse, og derved undgår du lock contention.
Den anden måde at løse problemet på er ved at bruge versionsindekser. Du kan have én kopi af indekset, som du bruger til at søge eller læse, og én til skrivning eller opdatering. Og en gang imellem (f.eks. hvert 100 ms eller 500 ms) duplikerer du dem og bytter dem om. Selvfølgelig er denne tilgang kun anvendelig i de tilfælde, hvor din applikation kan arbejde med et let forsinket søgeindeks.
Disse to tilgange kan bruges samtidigt: du kan have et sharded versionsindeks.
Mere komplekse forespørgsler
Det sidste problem med bitmap-indekser er, at de, som vi har fået at vide, ikke passer godt til mere komplekse typer forespørgsler, såsom forespørgsler 'over intervallet'.
Det er sandt, hvis man tænker over det, at bitoperationer som AND, OR osv. ikke egner sig særlig godt til forespørgsler af typen 'Vis mig hoteller med en pris pr. nat mellem 200 og 300 dollars'.
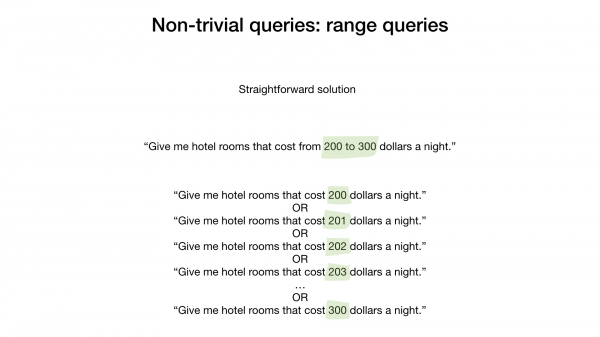
En naiv og meget ufornuftig løsning ville være at tage resultaterne for hver enkelt dollarværdi og kombinere dem med bitoperationen OR.
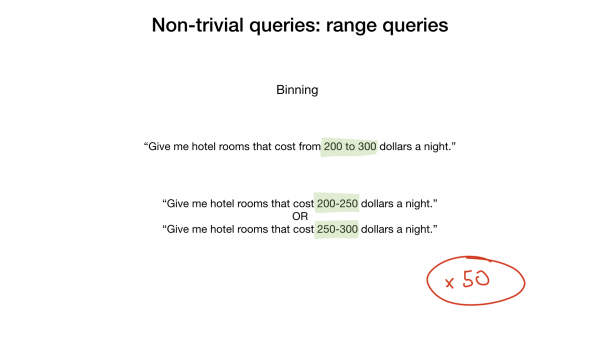
En lidt mere korrekt løsning ville være at bruge gruppering. For eksempel i grupper af 50 dollars. Det ville accelerere vores proces med 50 gange.
Men problemet kan også nemt løses ved at bruge en repræsentation, der er specielt designet til denne type forespørgsler. I videnskabelige arbejder kaldes det range-encoded bitmaps.
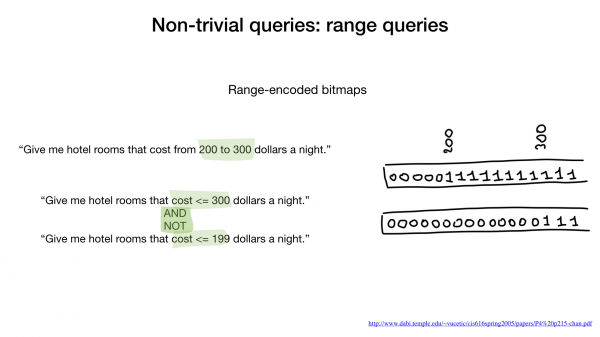
I denne repræsentation sætter vi ikke bare et enkelt bit for en værdi (for eksempel 200), men vi sætter denne værdi og alt, hvad der er højere. 200 og derover. Det samme gælder for 300: 300 og derover. Og så videre.
Ved at bruge denne repræsentation kan vi svare på denne type søgeforespørgsel ved at gå igennem indekset kun to gange. Først får vi en liste over hoteller, hvor værelset koster mindre end 300 dollars, og derefter fjerner vi dem, hvor prisen på værelset er mindre end 199 dollars. Færdig.
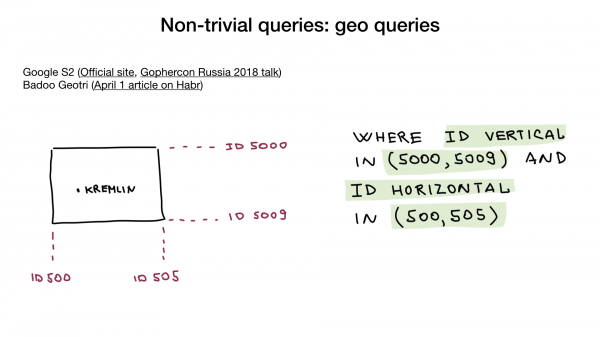
Du vil blive overrasket, men selv geoforespørgsler er mulige ved hjælp af bitmap-indekser. Tricket er at bruge en georepræsentation, der omkranser din koordinat med en geometrisk figur. For eksempel S2 fra Google. Figuren skal kunne repræsenteres med tre eller flere overlappende linjer, som kan nummereres. På den måde kan vi omsætte vores geoforespørgsel til flere "interval" forespørgsler (ved hjælp af disse nummererede linjer).
Færdige løsninger
Jeg håber, jeg har fanget lidt af din interesse, og at du nu har et nyttigt værktøj til din samling. Hvis du nogensinde skal lave noget lignende, vil du vide, hvilken retning du skal se i.
Men ikke alle har tid, tålmodighed og ressourcer til at oprette bitmap-indekser fra bunden. Især mere avancerede, ved hjælp af SIMD, for eksempel.
Heldigvis er der flere færdige løsninger, der kan hjælpe dig.
Roaring bitmaps
For det første er der den nævnte roaring bitmaps-bibliotek, som jeg allerede har talt om. Det indeholder alle de nødvendige containere og bitoperationer, du har brug for for at lave et fuldt bitmap-indeks.
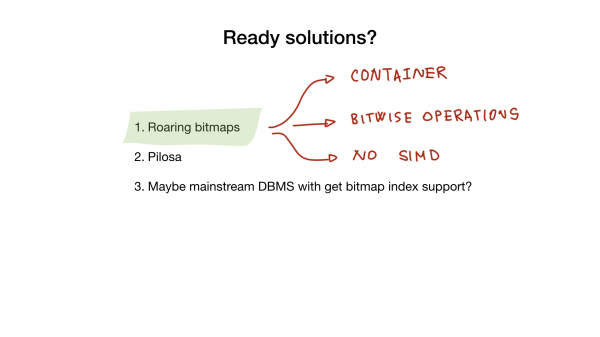
Desværre bruger ingen af Go-implementeringerne i øjeblikket SIMD, hvilket betyder, at Go-implementeringerne er mindre effektive end implementeringer i C, for eksempel.
Pilosa
Et andet produkt, der kan hjælpe dig, er databasen Pilosa, som i bund og grund kun har bitmap-indekser. Det er en relativt ny løsning, men den vinder hurtigt popularitet.
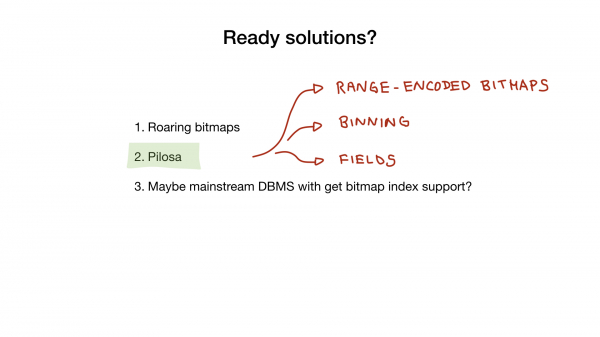
Pilosa bruger roaring bitmaps internt og giver dig mulighed for at anvende dem, hvilket forenkler og forklarer alle de ting, jeg har nævnt før: gruppering, range-encoded bitmaps, begrebet felt osv.
Lad os hurtigt tage et kig på et eksempel på brugen af Pilosa til at besvare et spørgsmål, som du allerede kender.
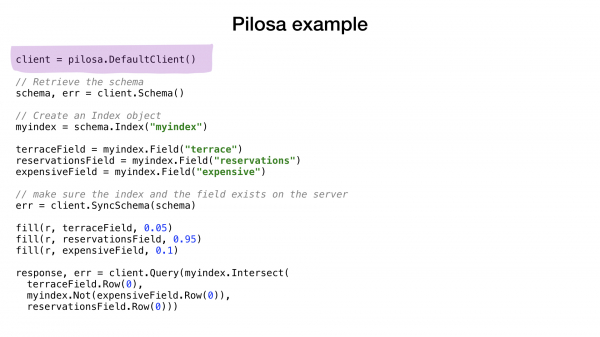
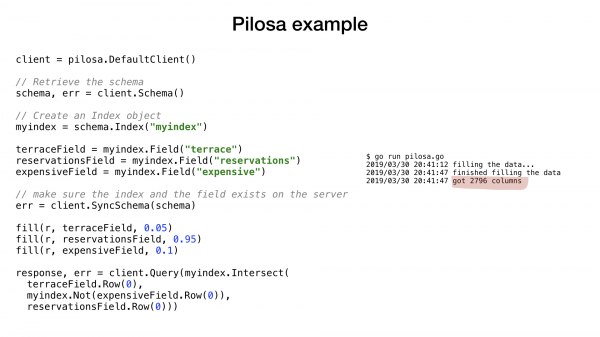
Eksemplet ligner meget det, du har set før. Vi opretter en klient til Pilosa-serveren, opretter et indeks og de nødvendige felter, fylder derefter vores felter med tilfældige data med sandsynligheder, og til sidst udfører vi det kendte request.
Derefter bruger vi NOT på feltet «expensive», krydser resultatet (eller AND-er) med feltet «terrace» og med feltet «reservations». Og til sidst får vi det endelige resultat.
Jeg håber virkelig, at der i den nærmeste fremtid vil komme denne nye type indekser - bitmap-indekser - i databaser som MySQL og PostgreSQL.
Konklusion
Hvis du ikke er faldet i søvn endnu, tak. Jeg var nødt til at berøre mange emner kort på grund af tidsbegrænsninger, men jeg håber, at præsentationen var nyttig og måske endda motiverende.
Det er godt at vide om bitmap-indekser, selvom de ikke er nødvendige lige nu. Lad dem være et ekstra værktøj i din værktøjskasse.
Vi har set på forskellige tricks til at øge ydeevnen for Go og de ting, som Go-kompilatoren ikke helt håndterer godt endnu. Dette er bestemt nyttigt at vide for enhver Go-udvikler.
Det var alt, hvad jeg ville sige. Tak!
Kilde: habr.com
