

Serverless betyder ikke fysisk fravær af servere. Det er ikke en "dræber" til containere eller en kortvarig trend. Det er en ny tilgang til opbygning af systemer i skyen. I dagens artikel vil vi se på arkitekturen af Serverless-applikationer, overveje hvilken rolle Serverless-tjenesteudbyderen spiller, samt open-source projekter. I slutningen vil vi tale om anvendelsen af Serverless.
Jeg ønsker at skrive backend-delen af en applikation (selv en online-butiks). Det kan være en chat, en service til publicering af indhold eller en belastningsbalancer. Uanset hvad vil der være en del hovedpine: jeg skal forberede infrastrukturen, definere afhængighederne af applikationen, tænke over operativsystemet på værten. Derefter skal jeg opdatere små komponenter, som ikke påvirker resten af monolitten. Og vi skal ikke glemme skalerbarheden under belastning.
Hvad hvis jeg tager efemere containere, hvor de nødvendige afhængigheder allerede er forudinstalleret, og hvor containerne er isolerede fra hinanden og fra værts-OS? Vi kan opdele monolitten i mikrotjenester, hver af dem kan opdateres og skaleres uafhængigt af de andre. Ved at placere koden i en sådan container kan jeg køre den på enhver infrastruktur. Det er allerede bedre.
Og hvis man ikke ønsker at konfigurere containere? Ikke ønsker at tænke på skalerbarhed af applikationen. Ikke ønsker at betale for inaktive startede containere, når belastningen på tjenesten er minimal. Man ønsker at skrive kode. Fokusere på forretningslogik og bringe produkter til markedet med lysens hastighed.
Disse tanker førte mig til serverløse beregninger. Serverless betyder i dette tilfælde ikke fysisk fravær af servere, men fravær af hovedpine ved at administrere infrastrukturen.
Ideen er, at applikationens logik opdeles i uafhængige funktioner. De har en begivenhedsbaseret struktur. Hver funktion udfører en "mikroopgave". Alt hvad der kræves af udvikleren er at uploade funktionerne i den cloud-udbyderens console og koble dem til begivenhedskilder. Koden vil blive kørt ved anmodning i en automatisk forberedt container, og jeg betaler kun for kørselstiden.
Lad os finde ud af, hvordan udviklingsprocessen for applikationen nu vil se ud.
Fra udviklerens side
Tidligere begyndte vi at tale om applikationen til onlinebutikken. I den traditionelle tilgang udfører en monolitisk applikation hovedlogikken i systemet. Serveren med applikationen kører konstant, selv når der ikke er nogen belastning.
For at overgå til serverless opdeler vi applikationen i mikroupgaver. For hver enkelt skriver vi en funktion. Funktionerne er uafhængige af hinanden og gemmer ikke tilstand (stateless). De kan endda være skrevet i forskellige sprog. Hvis en af dem "går ned", stopper applikationen ikke helt. Applikationens arkitektur vil se sådan ud:
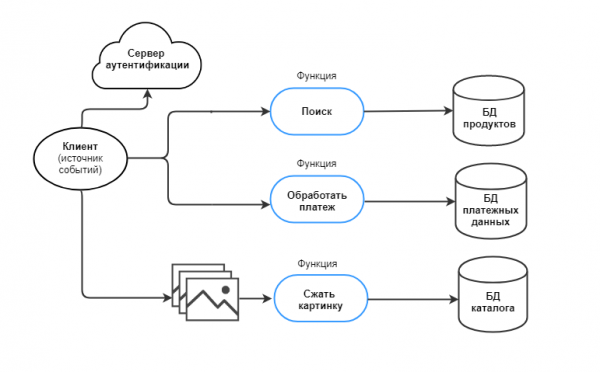
Opdeling i funktioner i Serverless ligner arbejdet med mikrotjenester. Men en mikrotjeneste kan udføre flere opgaver, mens en funktion ideelt set skal udføre én. Lad os forestille os, at opgaven er at indsamle statistik og præsentere den på anmodning fra brugeren. I den mikrotjeneste-baserede tilgang udfører én tjeneste opgaven med to indgangspunkter: til skrivning og til læsning. I serverless beregninger vil dette være to forskellige funktioner, der ikke er forbundet med hinanden. Udvikleren sparer beregningsressourcer, hvis for eksempel statistikken opdateres oftere, end den eksporteres.
Serverless-funktioner skal udføres inden for en kort tidsramme (timeout), som defineres af tjenesteudbyderen. For eksempel er timeout for AWS 15 minutter. Det betyder, at langvarige funktioner (long-lived) skal ændres i henhold til kravene - dette adskiller Serverless fra andre populære teknologier i dag (containere og Platform as a Service).
Vi tildeler et hændelse til hver funktion. En hændelse er en trigger for handling:
Begivenhed
Handlingen, som funktionen udfører
Et billede af produktet er blevet uploadet til lageret
Kompresser billedet og upload det til kataloget
Adressen til den fysiske butik er blevet opdateret i databasen
Indlæs den nye placering på kortene
Klienten betaler for varen
Start behandling af betalingen
Hændelser kan være HTTP-anmodninger, streamingdata, meddelelseskøer osv. Hændelseskilder er ændringer eller tilføjelser af data. Derudover kan funktioner startes på en timer.
Arkitekturen er arbejdet igennem, og applikationen er næsten blevet serverless. Vi går videre til tjenesteudbyderen.
Fra tjenesteudgiverens side
Normalt tilbydes serverless beregninger af cloud-tjenesteudbydere. De kaldes forskellige: Azure Functions, AWS Lambda, Google Cloud Functions, IBM Cloud Functions.
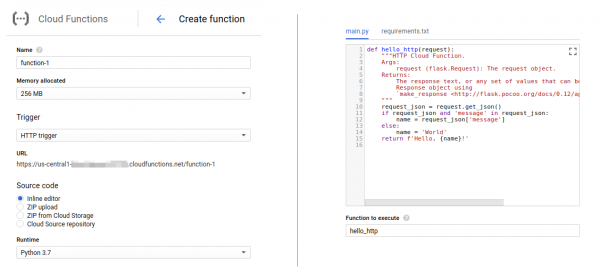
Vi vil bruge tjenesten gennem konsollen eller udbyderens brugerpanel. Funktionskoden kan uploades på en af følgende måder:
- skrive koden i de indbyggede redaktører via webkonsollen,
- uploade en arkivfil med koden,
- arbejde med offentlige eller private git-repositories.
Her indstiller vi også de hændelser, der udløser funktionen. Udsætningerne for hændelser kan variere mellem forskellige udbydere.
Udbyderen har bygget og automatiseret et System Function as a Service (FaaS) på deres infrastruktur:
- Funktionskoden sendes til opbevaring hos udbyderen.
- Når der opstår en hændelse, startes containere automatisk på serveren med et forberedt miljø. Hver instans af funktionen har sin egen isolerede container.
- Fra opbevaringen sendes funktionen til containere, beregnes og returnerer resultatet.
- Antallet af parallelle hændelser stiger—antallet af containere øges. Systemet skalerer automatisk. Hvis brugerne ikke tilgår funktionen, vil den være inaktiv.
- Udbyderen angiver tiden for inaktivitet af containerne—hvis funktionerne ikke dukker op i containeren inden for denne tid, vil den blive destrueret.
Dermed får vi Serverless «ud af boksen». Vi betaler for tjenesten efter pay-as-you-go modellen og kun for de funktioner, der anvendes, og kun for den tid, de blev brugt.
For at introducere udviklerne til tjenesten tilbyder udbyderne op til 12 måneder gratis test, men begrænser den samlede beregningstid, antallet af forespørgsler pr. måned, midler eller ressourceforbrug.
Den største fordel ved at arbejde med en udbyder er muligheden for ikke at bekymre sig om infrastrukturen (servere, virtuelle maskiner, containere). Udbyderen kan implementere FaaS både med egne udviklinger og ved hjælp af open-source værktøjer. Det er, hvad vi vil komme ind på næste gang.
Fra open source siden
I de seneste par år har open-source samfundet arbejdet aktivt med Serverless værktøjer. Derudover bidrager de største aktører på markedet til udviklingen af de serverless platforme:
- Google tilbyder udviklerne deres open-source værktøj— . IBM, RedHat, Pivotal og SAP har deltaget i udviklingen;
- IBM har arbejdet på Serverless-platformen , som senere blev et projekt hos Apache Foundation;
- Microsoft har delvist åbnet koden til platformen .
Udviklinger finder også sted inden for serverless-rammer. og udrulles inden for forberedte Kubernetes-klynger, fungerer både med Kubernetes og Docker Swarm. Rammeverket fungerer som en slags controller, der forbereder en udførelsesmiljø inden for klyngen på anmodning og derefter kører funktionen der.
Rammerne giver mulighed for at konfigurere værktøjet efter egne behov. I Kubeless kan udvikleren indstille timeout for funktionen (standardværdi er 180 sekunder). Fission tilbyder i et forsøg på at løse problemet med kold opstart at holde nogle containere kørende hele tiden (selvom det medfører omkostninger til ressourcer). OpenFaaS tilbyder en række udløsere i forskellige former: HTTP, Kafka, Redis, MQTT, Cron, AWS SQS, NATs osv.
Instruktioner til at komme i gang kan findes i de officielle dokumentationer for rammerne. Arbejde med dem kræver lidt flere færdigheder end ved arbejde med en udbyder – det kræver mindst evnen til at starte en Kubernetes-klynge via CLI. Det maksimale vil være at inkludere andre open-source værktøjer (f.eks. køadministratoren Kafka) i arbejdet.
Uanset hvilken metode vi arbejder med Serverless – gennem en udbyder eller ved hjælp af open-source – vil vi opleve en række fordele og ulemper ved Serverless-tilgangen.
Fra perspektivet af fordele og ulemper
Serverless udvikler idéerne om containerinfrastruktur og mikroservices-tilgangen, hvor teams kan arbejde i et flersproget miljø uden at være bundet til én platform. Opbygningen af systemet forenkles, og det bliver lettere at rette fejl. Mikroservice-arkitekturen tillader hurtigere tilføjelse af ny funktionalitet til systemet end ved en monolitisk applikation.
Serverless reducerer udviklingstiden yderligere, hvilket giver udvikleren mulighed for at fokusere udelukkende på applikationens forretningslogik og kodeudvikling. Som følge heraf forkortes tiden for udviklingen til markedet.
Som en bonus får vi automatisk skalering efter belastning, og vi betaler kun for de anvendte ressourcer og kun den tid, hvor de anvendes.
Som enhver teknologi har Serverless ulemper.
For eksempel kan en sådan ulempe være kold opstartstid (gennemsnitligt op til 1 sekund for sprog som JavaScript, Python, Go, Java, Ruby).
På den ene side afhænger tiden for kold start i praksis af mange variable: sproget, som funktionen er skrevet i, antallet af biblioteker, mængden af kode, kommunikation med ekstra ressourcer (som databaser eller autentifikationsservere). Da udvikleren styrer disse variable, kan han forkorte starttiden. Men på den anden side kan udvikleren ikke styre containerens opstartstid — her afhænger alt af udbyderen.
En kold start kan blive til en varm, når funktionen genbruger den container, der blev startet af den forrige event. En sådan situation opstår i tre tilfælde:
- hvis kunderne ofte bruger tjenesten, og antallet af opkald til funktionen stiger;
- hvis udbyderen, platformen eller rammeværket tillader, at nogle containere holdes kørende hele tiden;
- hvis udvikleren starter funktioner efter et tids interval (lad os sige, hver 3. minut).
For mange applikationer er kold start ikke et problem. Her skal man tage udgangspunkt i typen og opgaverne for tjenesten. En forsinkelse på et sekund er ikke altid kritisk for en forretningsapplikation, men kan blive kritisk for medicinske tjenesteydelser. Sandsynligvis er serverless-tilgangen ikke længere tilstrækkelig i dette tilfælde.
Den næste ulempe ved Serverless er den korte livscyklus for funktionen (timeout, inden funktionen skal udføres).
Men hvis man skal arbejde med langvarige opgaver, kan man bruge en hybridarkitektur — kombinere Serverless med en anden teknologi.
Ikke alle systemer vil kunne arbejde efter Serverless-modellen.
Nogle applikationer vil stadig gemme data og tilstand under udførelsen. Nogle arkitekturer vil forblive monolitiske, og nogle funktioner vil være langvarige. Men (ligesom cloud-teknologi engang og senere containere), er Serverless en teknologi med en stor fremtid.
I denne sammenhæng vil jeg gerne glidende overgå til spørgsmålet om anvendelsen af Serverless-tilgangen.
Fra et anvendelsesperspektiv
I 2018 steg procentdelen af brugen af Serverless . Blandt de virksomheder, der allerede har implementeret teknologien i deres tjenester, er store markedsaktører som Twitter, PayPal, Netflix, T-Mobile, Coca-Cola. Det er samtidig vigtigt at forstå, at Serverless ikke er en panacea, men et værktøj til løsning af bestemte opgaver:
- At reducere inaktivitet af ressourcer. Det er ikke nødvendigt konstant at have en virtuel maskine kørende for tjenester, som der kun er få henvendelser til.
- Behandle data "on the fly". Komprimere billeder, fjerne baggrund, ændre videoformater, arbejde med IoT-sensorer, udføre matematiske operationer.
- "Sammensætte" andre tjenester sammen. Git-repositorium med interne programmer, chatbot i Slack med Jira og kalender.
- Balancerer belastningen. Her stopper vi op og ser nærmere på det.
Lad os sige, at der er en tjeneste, der får 50 besøgende. Der kører en virtuel maskine med svag hardware til den. Af og til stiger belastningen på tjenesten med flere gange. Så kan svag hardware ikke klare det.
Vi kan tilføje en balanceringsenhed til systemet, som vil fordele belastningen, lad os sige, på tre virtuelle maskiner. På dette tidspunkt kan vi ikke præcist forudsige belastningen, så vi holder en vis mængde ressourcer kørende "i reserve". Og vi betaler for spild.
I en sådan situation kan vi optimere systemet gennem en hybrid tilgang: Vi lader en virtuel maskine stå bag balanceringsenheden og sætter et link til Serverless Endpoint med funktioner. Hvis belastningen overstiger tærsklen, starter balanceringsenheden funktionseksemplarer, der tager sig af en del af behandlingen af anmodninger.
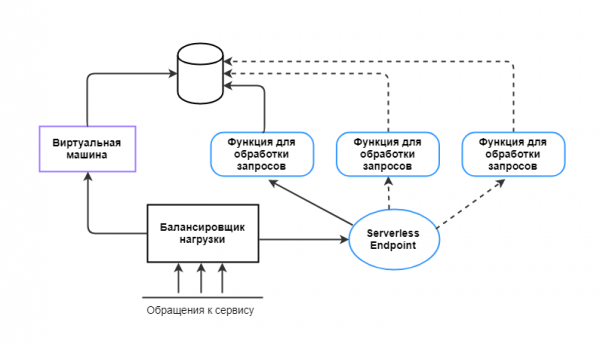
På denne måde kan Serverless bruges der, hvor man ikke nødvendigvis ofte, men intensivt skal håndtere et stort antal anmodninger. I dette tilfælde er det mere økonomisk at starte flere funktioner i 15 minutter end konstant at have en virtuel maskine eller server kørende.
På trods af alle fordelene ved serverløse beregninger, bør man først vurdere applikationens logik og forstå, hvilke opgaver Serverless kan løse i den specifikke situation, før man implementerer det.
Serverless og Selectel
Hos Selectel har vi allerede gennem vores kontrolpanel. Nu bygger vi vores egen FaaS-platform. Vi ønsker, at udviklere kan løse deres opgaver med Serverless gennem et nemt og fleksibelt interface.
Hvis du har idéer til, hvordan den ideelle FaaS-platform skal se ud, og hvordan du vil bruge Serverless i dine projekter, så del dem i kommentarerne. Vi vil tage dine ønsker med i udviklingen af platformen.
Materialer anvendt i artiklen:
Kilde: habr.com
