

Hej igen! Artiklens overskrift taler for sig selv. I takt med at kurset nærmer sig foreslår vi at finde ud af, hvem dataingeniører egentlig er. Artiklen indeholder mange nyttige links. God læsning.
En enkel guide til, hvordan man fanger bølgen af Data Engineering og ikke lader den trække en ned i dybet.
Det virker som om, at alle i dag ønsker at blive data scientist. Men hvad med Data Engineering? Det er i princippet en slags hybrid mellem dataanalytikere og data scientists; dataingeniører har typisk ansvar for at administrere arbejdsprocesser, behandlingslinjer og ETL-processer.På grund af vigtigheden af disse funktioner er det i øjeblikket en populær professionel jargon, der aktivt vinder frem.
En høj løn og en enorm efterspørgsel er blot en lille del af, hvad der gør dette arbejde ekstremt attraktivt! Hvis du ønsker at blive en af heltene, er det aldrig for sent at begynde at lære. I dette indlæg har jeg samlet al den nødvendige information for at hjælpe dig med at tage de første skridt.
Lad os komme i gang!
Hvad er Data Engineering?
Ærligt talt, der findes ikke en bedre forklaring end denne:
"En videnskabsmand kan opdage en ny stjerne, men kan ikke skabe en. Han må bede ingeniøren om at gøre det for ham."
– Gordon Lindsay Glegg
Derfor er dataingeniørens rolle ret betydningsfuld.
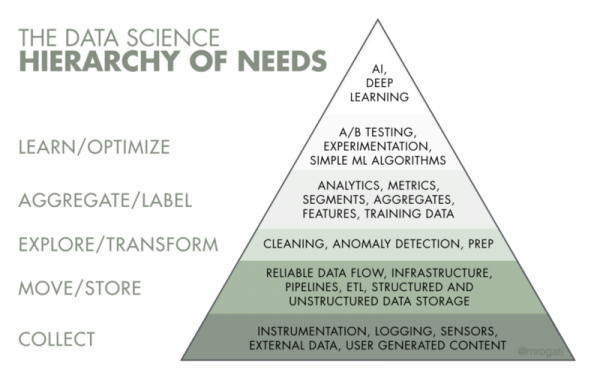
Af navnet fremgår det, at dataengineering handler om data, nemlig deres levering, opbevaring og behandling. Derfor er dataingeniørers hovedopgave at sikre en pålidelig infrastruktur for data. Hvis vi ser på AI-hierarkiet af behov, besætter dataengineering de første 2-3 trin: indsamling, flytning og opbevaring, databehandling..
Hvad laver en dataingeniør?
Med fremkomsten af big data har ansvarsområderne ændret sig drastisk. Førhen skrev disse eksperter store SQL-forespørgsler og flyttede data ved hjælp af værktøjer som Informatica ETL, Pentaho ETL, Talend, men nu er kravene til dataingeniører steget.
De fleste virksomheder med ledige stillinger som dataingeniør stiller følgende krav:
- Fremragende kendskab til SQL og Python.
- Erfaring med cloud-platforme, især Amazon Web Services.
- Kendskab til Java/Scala foretrækkes.
- God forståelse for SQL- og NoSQL-databaser (datamodellering, datalagring).
Vær opmærksom på, at dette kun er det mest nødvendige. Ud fra denne liste kan det antages, at dataingeniører er specialister inden for softwareudvikling og backend.
For eksempel, hvis en virksomhed begynder at generere store mængder data fra forskellige kilder, er det dit ansvar som dataingeniør at organisere indsamlingen, behandlingen og opbevaringen af informationen.
Listen over værktøjer, der anvendes i dette tilfælde, kan variere, alt afhængigt af mængden af disse data, hastigheden af deres ankomst og heterogenitet. De fleste virksomheder kommer slet ikke i kontakt med store data, derfor kan der anvendes en SQL-database (PostgreSQL, MySQL osv.) som et centralt lager med et lille antal scripts til at lede data ind i lageret.
IT-giganter som Google, Amazon, Facebook eller Dropbox har højere krav: kendskab til Python, Java eller Scala.
- Erfaring med store data: Hadoop, Spark, Kafka.
- Kendskab til algoritmer og datatyper.
- Forståelse af grundlæggende principper for distribuerede systemer.
- Erfaring med datavisualiseringsværktøjer som Tableau eller ElasticSearch vil være en stor fordel.
Der er en tydelig bevægelse mod store data, især i deres behandling under høj belastning. Disse virksomheder har højere krav til systemets fejltolerance.
Dataingeniører vs. dataforskere
Okay, det var en enkel og sjov sammenligning (intet personligt), men det er faktisk meget mere komplekst.
For det første skal du vide, at der er en del uklarhed i adskillelsen af roller og færdigheder mellem dataforskeren og dataingeniøren. Du kan nemt blive forvirret over, hvilke færdigheder der er nødvendige for at blive en succesfuld dataingeniør. Selvfølgelig er der nogle færdigheder, der overlapper mellem begge roller, men der er også en række diametralt modsatte færdigheder.
Data science er en alvorlig sag, men vi bevæger os mod en verden med funktionel data science, hvor praktikere kan udføre deres egen analyse. For at aktivere data pipelines og integrerede datastrukturer har du brug for dataingeniører, ikke forskere.
Er dataingeniøren mere eftertragtet end dataforskeren?
— Ja, fordi før du kan bage en gulerodskage, skal du først samle, skrælle og forberede gulerødderne!
En dataingeniør forstår programmering bedre end nogen dataforsker, men når det kommer til statistik, er alt præcist omvendt.
Men her er fordelene ved en dataingeniør:
uden ham/hende vil værdien af prototypemodellen, som ofte består af et fragment af dårligt kvalitet kode i en Python-fil, leveret af en dataforsker og på en eller anden måde giver et resultat, gå mod nul.
Uden dataingeniøren vil denne kode aldrig blive et projekt, og ingen forretningsproblem vil blive løst effektivt. Dataingeniøren forsøger at omdanne alt dette til et produkt.
Grundlæggende information, som en dataingeniør skal vide
Så hvis dette job vækker lys i dig, og du er fuld af entusiasme — du er i stand til at lære dette, du kan tilegne dig alle de nødvendige færdigheder og blive en ægte rockstjerne inden for dataproduktion. Og ja, du kan opnå dette selv uden programmeringsfærdigheder eller anden teknisk viden. Det er svært, men muligt!
Hvad er de første skridt?
Du skal have en overordnet forståelse af, hvad der er hvad.
For det første vedrører Data Engineering datalogi. Specifikt – du skal forstå effektive algoritmer og datastrukturer. For det andet, eftersom dataingeniører arbejder med data, er det nødvendigt at have forståelse for, hvordan databaser fungerer, samt de underliggende strukturer.
For eksempel er almindelige B-tree SQL databaser baseret på B-Tree datastrukturen, samt i moderne distribuerede lagre, LSM-Tree og andre modifikationer af hash-tabeller.
* Disse trin er baseret på en fremragende artikel . Så hvis du kan russisk, så støt denne forfatter og læs .
1. Algoritmer og datastrukturer
Brugen af den rigtige datastruktur kan betydeligt forbedre algoritmens ydeevne. Ideelt set bør vi alle lære datastrukturer og algoritmer i skolen, men det bliver sjældent dækket. Under alle omstændigheder er det aldrig for sent at få indsigt.
Så her er mine yndlings gratis kurser til at lære datastrukturer og algoritmer:
Plus glem ikke det klassiske arbejde med algoritmerne af Thomas Cormen — . Det er den perfekte håndbog, når du skal friske din hukommelse op.
- For at forbedre dine færdigheder, brug .
Du kan også dykke ind i databaseverdenen med de fantastiske videoer fra Carnegie Mellon University på Youtube:
- .
- .
2. Læring af SQL
Hele vores liv er data. For at hente disse data fra en database, skal du "tale" med dem på et fælles sprog.
SQL (Structured Query Language — struktureret forespørgselssprog) er kommunikationsspråket inden for dataområdet. Uanset hvad nogen siger, har SQL levet, lever, og vil fortsætte med at leve i lang tid.
Hvis du har været i udvikling i lang tid, har du sikkert bemærket, at rygterne om SQL's snarlige død dukker op fra tid til anden. Sproget blev udviklet i begyndelsen af 70'erne og er stadig meget populært blandt analytikere, udviklere og bare entusiaster.
Uden kendskab til SQL er der intet at gøre inden for datateknik, da du uundgåeligt vil skulle lave forespørgsler for at hente data. Alle moderne datalagringssystemer understøtter SQL:
- Amazon Redshift
- HP Vertica
- Oracle
- SQL Server
… og mange andre.
For at analysere store datamængder, der er gemt i distribuerede systemer som HDFS, er der blevet opfundet SQL-mekanismer: Apache Hive, Impala osv. Ser du, det er ikke på vej væk.
Hvordan lærer man SQL? Gør det bare i praksis.
Til dette vil jeg anbefale at se på en fremragende tutorial, som for øvrigt er gratis, fra .
En fremtrædende funktion ved disse kurser er den interaktive platform, hvor du kan skrive og udføre SQL-forespørgsler direkte i browseren. Ressourcen vil være nyttig. Og du kan anvende denne viden i i sektionen for databaser.
3. Programmering i Python og Java/Scala
Jeg har allerede beskrevet, hvorfor det er værd at lære programmeringssproget Python i artiklen . Hvad angår Java og Scala, er de fleste værktøjer til lagring og behandling af enorme datamængder skrevet på disse sprog. For eksempel:
- Apache Kafka (Scala)
- Hadoop, HDFS (Java)
- Apache Spark (Scala)
- Apache Cassandra (Java)
- HBase (Java)
- Apache Hive (Java)
For at forstå, hvordan disse værktøjer fungerer, skal du kende de sprog, som de er skrevet i. Den funktionelle tilgang i Scala gør det muligt effektivt at løse opgaver inden for parallel databehandling. Python kan desværre ikke prale af hastighed og parallel behandling. Generelt set har kendskab til flere sprog og programmeringsparadigmer en positiv indvirkning på bredden af tilgange til problemløsning.
For at dykke ned i Scala-sproget kan du læse af sprogforfatteren. Derudover har Twitter udgivet en god introduktionsguide — .
Når det kommer til Python, mener jeg, at er den bedste bog på mellemniveau.
4. Værktøjer til arbejde med store data
Her er en liste over de mest populære værktøjer inden for big data:
- Apache Spark
- Apache Kafka
- Apache Hadoop (HDFS, HBase, Hive)
- Apache Cassandra
Mere information om opbygning af store datablokke kan du finde i dette fantastiske . De mest populære værktøjer er Spark og Kafka. De er bestemt værd at studere, helst forstå, hvordan de arbejder inden i. Jay Kreps (medskaber af Kafka) offentliggjorde i 2013 et monumentalt værk , forresten, de grundlæggende ideer fra denne talmud blev brugt til at skabe Apache Kafka.
- En introduktion til Hadoop kan være .
- Den mest omfattende guide til Apache Spark for mig er — .
5. Cloud-platforme
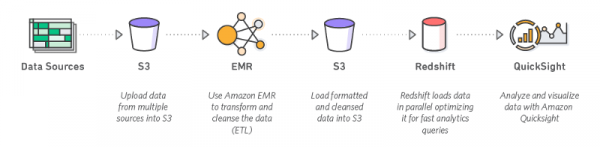
At have kendskab til mindst én cloud-platform er et basis krav for ansøgere til stillingen som dataingeniør. Arbejdsgivere foretrækker Amazon Web Services, på andenpladsen er Google Cloud Platform, og på tredjepladsen Microsoft Azure.
Du skal have godt kendskab til Amazon EC2, AWS Lambda, Amazon S3, DynamoDB.
6. Fordelte systemer
Arbejdet med store data indebærer eksistensen af klynger af uafhængigt fungerende computere, der kommunikerer med hinanden over et netværk. Jo større klyngen er, jo større er sandsynligheden for, at dens noder fejler. For at blive en dygtig ekspert inden for data skal du dykke ind i problemstillingerne og eksisterende løsninger for distribuerede systemer. Dette felt er gammelt og komplekst.
Andrew Tanenbaum betragtes som en pioner inden for dette område. For dem der ikke er bange for teori, anbefaler jeg hans bog , for begyndere kan den virke kompleks, men det vil virkelig hjælpe dig med at finpudse dine færdigheder.
Jeg mener den bedste introduktionsbog. Forresten har Martin en fantastisk . Hans arbejde vil hjælpe med at systematisere viden om opbygning af moderne infrastruktur til lagring og behandling af store data.
For dem der kan lide at se videoer, findes der et kursus på Youtube .
7. Datakanaler
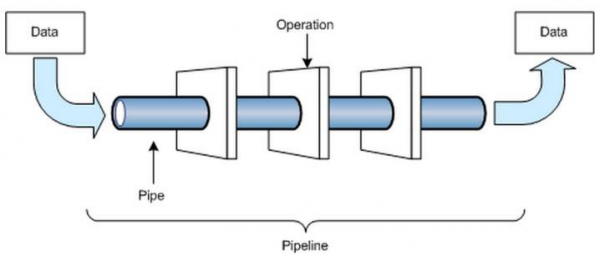
Datakanaler er noget, du ikke kan leve uden som dataingeniør.
Det meste af tiden bygger en dataingeniør det såkaldte datakanal, hvilket betyder at skabe en proces til levering af data fra et sted til et andet. Dette kan være brugerflows, der går til en API fra en ekstern tjeneste eller laver SQL-forespørgsler, beriger data og placerer dem i et centraliseret lager (datavarehus) eller et lager for ustrukturerede data (datadamme).
Sammenfattende: den primære tjekliste for en dataingeniør
Lad os opsummere – der er behov for en god forståelse af følgende:
- Informationssystemer;
- Softwareudvikling (Agil, DevOps, Designteknikker, SOA);
- Fordelte systemer og parallel programmering;
- Grundlæggende databasebegreber – planlægning, design, drift og fejlfinding;
- Eksperimentdesign – A/B-tests til bevis for koncepter, vurdering af systemers pålidelighed og ydeevne samt til udvikling af pålidelige metoder til hurtig leverance af gode løsninger.
Dette er blot nogle af kravene for at blive dataingeniør, så undersøg og sæt dig ind i datasystemer, informationssystemer, kontinuerlig levering/implementering/integration, programmeringssprog og andre emner inden for datalogi (ikke i alle fagområder).
Og til sidst, men ikke mindre vigtigt, vil jeg gerne sige.
Vejen til at blive Data Engineer er ikke så enkel, som den måske ser ud. Den tilgiver ikke, frustrerer, og du skal være klar til det. Nogle øjeblikke i denne rejse kan få dig til at overveje at give op. Men det er en ægte arbejds- og læringsproces.
Bare pynt ikke på det fra starten. Hele pointen med rejsen er at lære så meget som muligt og være klar til nye udfordringer.
Her er et fantastisk billede, som jeg stødte på, der illustrerer dette punkt godt:
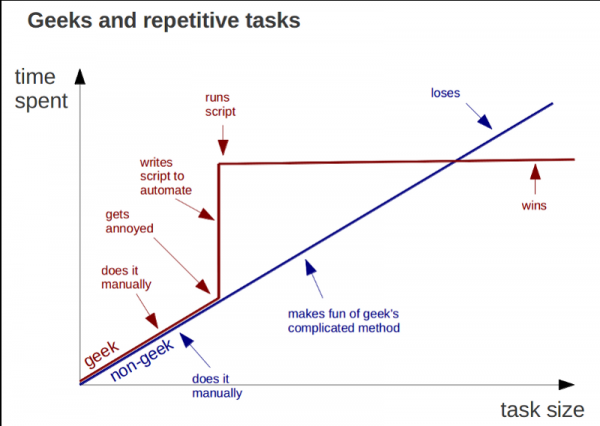
Og ja, glem ikke at undgå udbrændthed og tage pauser. Det er også meget vigtigt. Held og lykke!
Hvad synes I om artiklen, venner? Vi inviterer til , der finder sted i dag kl. 20.00. Under webinaret vil vi diskutere, hvordan man bygger et effektivt og skalerbart databehandlingssystem for en lille virksomhed eller startup med minimale omkostninger. Som en del af praksis vil vi introducere Google Clouds databehandlingsværktøjer. Vi ses!
Kilde: habr.com
