

Temaet DevOps er i øjeblikket meget populært. CI/CD-pipeline for kontinuerlig integration og levering bliver implementeret af alle, der har en interesse i det. Men de fleste giver ikke altid den nødvendige opmærksomhed på sikring af pålideligheden af informationssystemer på de forskellige trin i CI/CD Pipeline. I denne artikel vil jeg gerne tale om mine erfaringer med automatisering af kvalitetskontrol af software og implementering af mulige scenarier for dens "selvgenopretning".
Jeg arbejder som ingeniør i IT-service management i virksomheden . Mit specialområde er implementering af forskellige systemer til overvågning af applikationers ydeevne og tilgængelighed. Jeg kommunikerer ofte med IT-kunder fra forskellige markedssegmenter omkring aktuelle spørgsmål vedrørende overvågning af kvaliteten af deres IT-tjenester. Hovedopgaven er at minimere releasecyklusens tid og øge hyppigheden af deres udgivelser. Det er selvfølgelig alt sammen godt: flere udgivelser – flere nye funktioner – flere tilfredse brugere – mere profit. Men i praksis fungerer det ikke altid så godt. Ved meget høje implementeringshastigheder opstår spørgsmålet om kvaliteten af vores udgivelser straks. Selv med en fuldt automatiseret pipeline er et af de største problemer overgangen af tjenester fra test til produktion uden at påvirke oppetid og brugeres interaktion med applikationen.
Baseret på adskillige samtaler med kunder kan jeg sige, at kontrol af releasekvalitet, applikationens pålidelighed og muligheden for dens "selvgenopretning" (for eksempel tilbagevenden til en stabil version) på de forskellige trin i CI/CD-pipelinen – er blandt de mest bekymrende og relevante emner.
For nylig arbejdede jeg selv på kundens side – i supportafdelingen for applikationssoftware i en onlinebank. I arkitekturen af vores applikation blev der anvendt mange egenudviklede mikrotjenester. Det mest bekymrende var, at ikke alle udviklere kunne følge med de høje udviklingshastigheder, og kvaliteten af nogle mikrotjenester led under det, hvilket gav anledning til komiske kælenavne for dem og deres skabere. Der opstod historier om, hvilke materialer disse produkter blev lavet af.
«Formulering af opgaven»
Den høje frekvens af releases og det store antal mikrotjenester gør det svært at forstå, hvordan applikationen fungerer som helhed, både under testfasen og i driftsfasen. Ændringer finder konstant sted, og det er meget svært at kontrollere dem uden gode overvågningsværktøjer. Ofte sidder udviklerne om morgenen efter en natrelease som på en krudttønde og venter på, at ingenting går galt, selvom alle tests var vellykkede under testningen.
Der er endnu en ting. Under testfasen kontrolleres softwarets funktionalitet: udførelsen af applikationens grundlæggende funktioner og fraværet af fejl. Kvalitetsvurderinger af ydeevnen er enten fraværende eller tager ikke alle aspekter af applikationens arbejde og integrationslaget i betragtning. Nogle metrikker bliver slet ikke kontrolleret. I sidste ende, når der opstår en fejl i produktionsmiljøet, hører teknisk support først om det, når de faktiske brugere begynder at klage. Man ønsker at minimere indflydelsen af software af lav kvalitet på slutbrugerne.
En måde at løse dette på er at implementere kvalitetskontrolprocesser på forskellige stadier af CI/CD-pipelinen, tilføje forskellige scenarier for systemgendannelse ved fejl. Vi skal også huske, at vi har DevOps. Virksomheden forventer hurtigst muligt at få den nye produkt. Derfor skal alle vores tests og scenarier automatiseres.
Opgaven opdeles i to komponenter:
- kontrol af kvaliteten af builds under testningen (automatisere processen med at fange dårlige builds);
- kontrol af kvaliteten af software i produktionsmiljøet (mekanismer til automatisk at opdage problemer og mulige scenarier for selvgenopretning).
Værktøj til overvågning og indsamling af metrikker
For at realisere de opstillede mål kræves der et overvågningssystem, der kan opdage problemer og sende dem til automatiseringssystemer på forskellige stadier af CI/CD-konceptet. Det vil også være en fordel, hvis dette system kan give nyttige metrikker til forskellige teams: udvikling, test og drift. Og det ville være helt fantastisk, hvis det også kunne gavne forretningen.
For collecting metrics, you can use a combination of various systems (Prometheus, ELK Stack, Zabbix, etc.), but in my opinion, solutions from the APM class are best suited for these tasks (), which can greatly simplify your life.
As part of my work in support services, I started working on a similar project using the APM solution from Dynatrace. Now, working as an integrator, I have a good understanding of the monitoring systems market. My subjective opinion: Dynatrace is the best fit for addressing such tasks.
The Dynatrace solution provides a horizontal view of each user operation with a deep level of detail down to the code execution level. You can track the entire interaction chain between various information services: from frontend web and mobile applications to backend application servers, integration bus, and specific database calls.
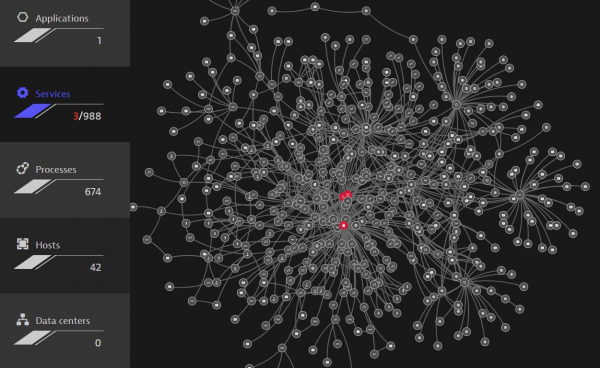 . Automatic construction of all dependencies between the system components
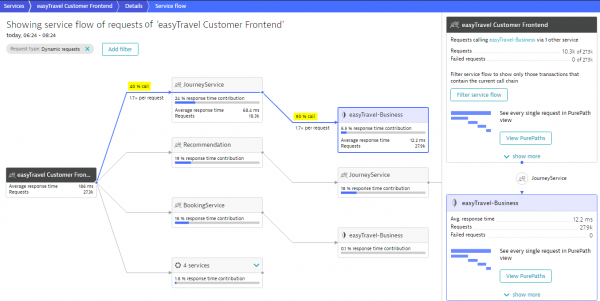 . Automatic identification and construction of the service operation flow
We also remember that we need to integrate with various automation tools. Here, the solution has a convenient API that allows you to send and receive various metrics and events.
Next, we will take a more detailed look at how to solve the set tasks using the Dynatrace system.
Task 1. Automating quality control of builds at the testing stage
The first task is to identify problems as early as possible in the application delivery pipeline. Only "good" code builds should reach the production environment. To achieve this, additional quality monitoring tools should be included in your pipeline at the testing stage.
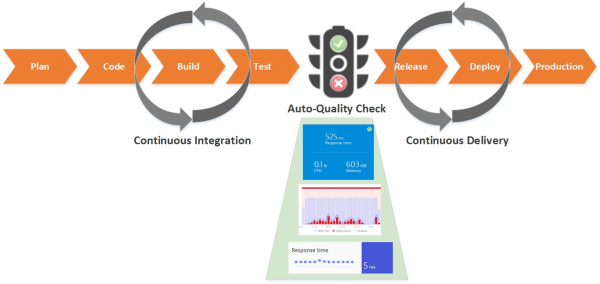
Let's consider step-by-step how to implement and automate this process:
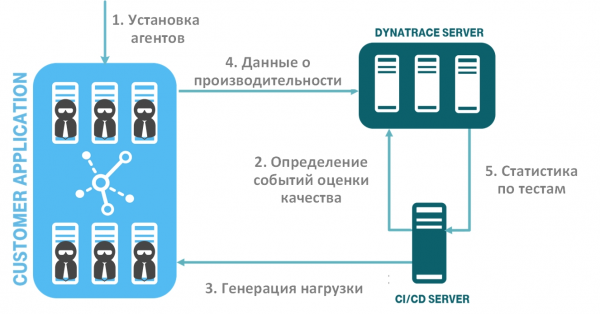
The diagram shows the flow of automated software quality checking steps:
- deployment of the monitoring system (agent installation);
- defining quality assessment events for your software (metrics and threshold values) and transmitting them to the monitoring system;
- load generation and performance testing;
- collecting performance and availability data in the monitoring system;
- overførsel af data om test baseret på begivenheder for kvalitetsvurdering af software fra overvågningssystemet til CI/CD-systemet. Automatisk analyse af builds.
Trin 1. Udrulning af overvågningssystemet
Først skal du installere agenterne i dit testmiljø. Dynatrace-løsningen har den fordel, at den bruger den universelle agent OneAgent, som installeres på OS-forekomsten (Windows, Linux, AIX), automatisk opdager dine tjenester og begynder at indsamle overvågningsdata om dem. Du behøver ikke at konfigurere en agent separat for hver proces. Den samme situation gælder for cloud- og containerplatforme. Installationsprocessen for agenterne kan også automatiseres. Dynatrace passer perfekt ind i konceptet "infrastruktur som kode" (): der findes allerede klare scripts og instruktioner til alle populære platforme. Du integrerer agenten i din tjenestekonfiguration, og ved udrulning får du straks en ny tjeneste med en fungerende agent.
Trin 2. Bestemmelse af begivenheder for kvalitetsvurdering af dit software
Nu skal du beslutte, hvilke tjenester og forretningsoperationer der skal medtages. Det er vigtigt at tage hensyn til netop de brugeroperationer, der er forretningskritiske for din tjeneste. Her anbefaler jeg at konsultere med forretnings- og systemanalytikere.
Dernæst skal du definere, hvilke målinger du ønsker at inkludere i kontrollen for hver af niveauerne. Det kan f.eks. være svartid (opdelt i gennemsnit, median, percentiler osv.), fejl (logiske, tjeneste- og infrastrukturelle osv.) og forskellige infrastrukturelle målinger (hukommelseshoved, affaldsindsamler, trådtælling osv.).
For at automatisere og gøre det nemmere for DevOps-teamet opstår konceptet "Overvågning som kode". Hvad jeg mener med dette er, at en udvikler/tester kan skrive en simpel JSON-fil, der definerer indikatorerne for kvalitetsvurdering af software.
Lad os se på et eksempel på en sådan JSON-fil. Som et par nøgle/værdi bruges objekter fra Dynatrace API (beskrivelsen af API'en kan ses her ).
{
    "timeseries": [
    {
      "timeseriesId": "service.ResponseTime",
      "aggregation": "avg",
      "tags": "Frontend",
      "severe": 250000,
      "warning": 1000000
    },
    {
      "timeseriesId": "service.ResponseTime ",
      "aggregation": "avg",
      "tags": "Backend",
      "severe": 4000000,
      "warning": 8000000
    },
    {
      "timeseriesId": "docker.Container.Cpu",
      "aggregation": "avg",
      "severe": 50,
      "warning": 70
    }
  ]
}
Filen er et array af definitioner af tidsserier (timeseries):
- timeseriesId – den metric, der undersøges, for eksempel Response Time, Error count, Memory used osv.;
- aggregation — aggregationsniveauet for metrics, i vores tilfælde avg, men du kan bruge hvad som helst, der er nødvendigt for dig (avg, min, max, sum, count, percentile);
- tags – objektets tag i overvågningssystemet, eller du kan angive en specifik objektidentifikator;
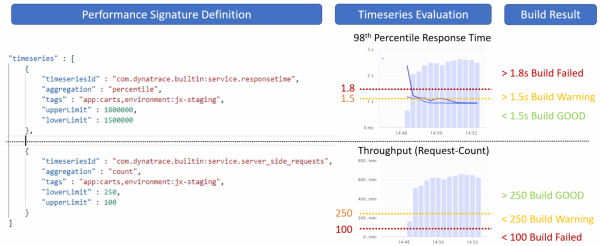
- severe og warning – disse indikatorer regulerer tærskelværdierne for vores metrics; hvis testværdierne overstiger den severe tærskel, markeres vores samling som mislykket.
På følgende billede ses et eksempel på brug af sådanne tærskler.
Trin 3. Generering af belastning
Efter at vi har fastlagt kvalitetsniveauerne for vores service, er det nødvendigt at generere en testbelastning. Du kan bruge et hvilket som helst af de værktøjer, du foretrækker til testning, for eksempel Jmeter, Selenium, Neotys, Gatling osv.
Overvågningssystemet Dynatrace gør det muligt at indsamle forskellige metadata fra dine tests og genkende, hvilken test der hører til hvilken releasecyklus og hvilken service. Det anbefales at tilføje yderligere headers i HTTP-anmodningerne fra testen.
På følgende billede ses et eksempel, hvor vi ved hjælp af den ekstra header X-Dynatrace-Test markerer, at denne test vedrører test af operationen ved at tilføje en vare til indkøbskurven.
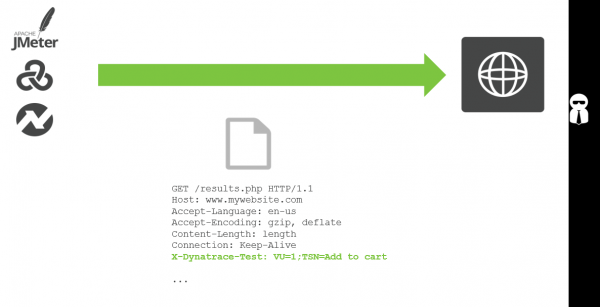
Ved hver kørsel af en belastningstest sender du ekstra kontekstinformation til Dynatrace ved hjælp af CI/CD-serverens event-API. På den måde kan systemet adskille forskellige tests fra hinanden.
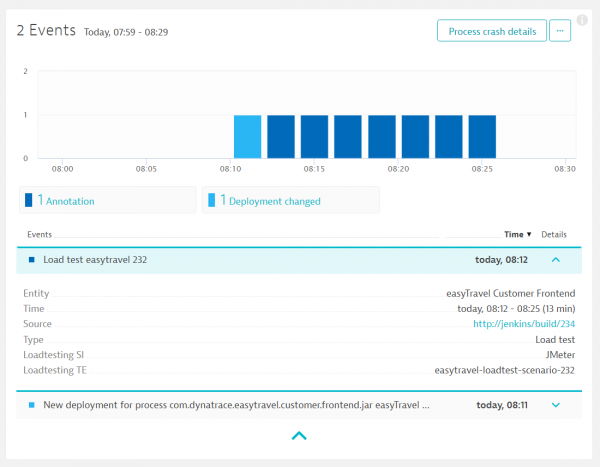 . Eventet i overvågningssystemet om starten af belastningstestningen
Trin 4-5. Indsamling af ydeevnedata og overførsel af data til CI/CD-systemet
Sammen med den genererede test sendes et event til overvågningssystemet om behovet for at indsamle data om kvalitetsmålinger. Vores JSON-fil, der definerer nøglemetrics, angives også.
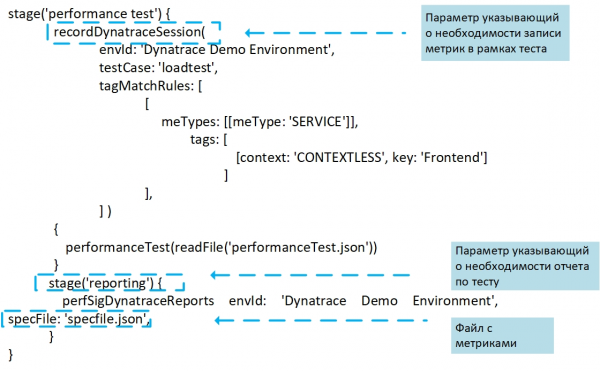 Et event om behovet for kvalitetstestning af software, der genereres på CI/CD-serveren til sending til overvågningssystemet
I vores eksempel kaldes kvalitetstestningsbegivenheden perfSigDynatraceReport (Performance_Signature) – det er en klar til integration med Jenkins, som er udviklet af folkene fra T-Systems Multimedia Solutions. Hver begivenhed, der starter testningen, indeholder oplysninger om tjenesten, build-nummeret og tidspunktet for testen. Plugin'en indsamler præstationsværdier under build-processen, vurderer dem og sammenligner resultatet med tidligere builds og ikke-funktionelle krav.
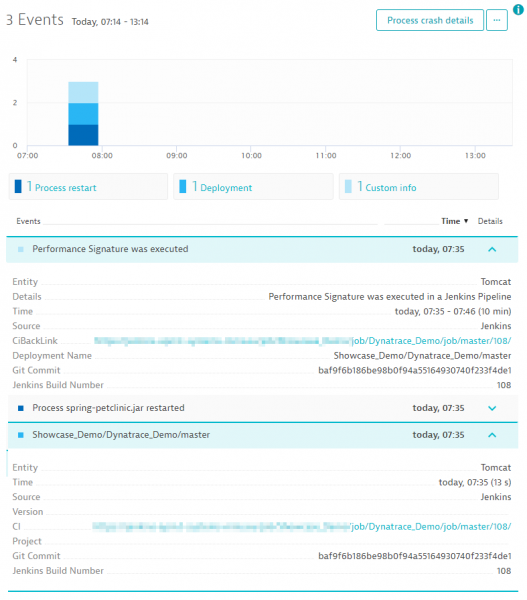 Begivenheden i overvågningssystemet for starten af kvalitetstestningen af builden.
Når testen er afsluttet, sendes alle målinger til vurdering af softwarekvaliteten tilbage til systemet for kontinuerlig integration, f.eks. Jenkins, som genererer en rapport med resultaterne.
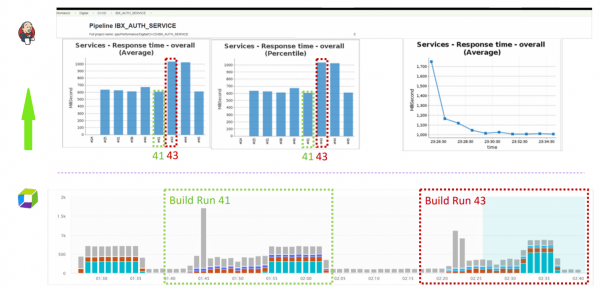 Statistikresultatet for builds på CI/CD-serveren.
For hver enkelt build ser vi statistikken for hver defineret måling i hele testens varighed. Vi kan også se, hvis der har været overtrædelser af bestemte tærskelværdier (advarsel og alvorlige tærskelværdier). Baseret på de samlede indikatorer bliver hele builden markeret som stabil, ustabil eller fejlet. For nemheds skyld kan du også tilføje sammenligningsmålinger for den aktuelle build i rapporten.
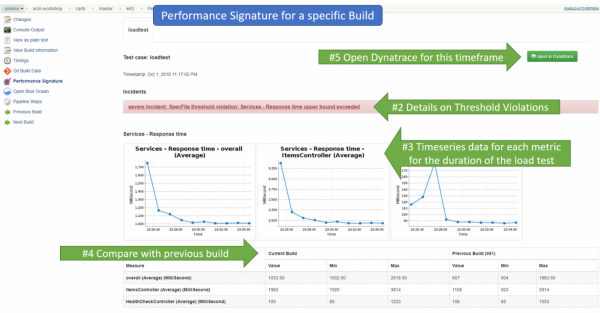 Visning af detaljeret statistik over builds på CI/CD-serveren.
Detaljeret sammenligning af to builds
Om nødvendigt kan du gå ind i Dynatrace-grænsefladen og der se statistikken for hver af dine builds mere detaljeret og sammenligne dem med hinanden.
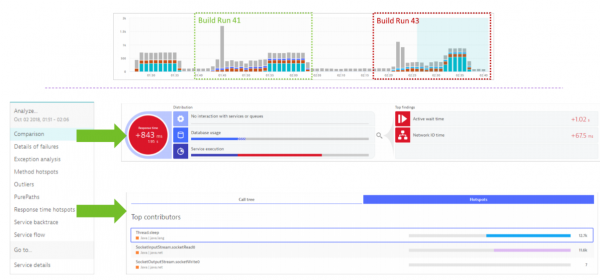 Sammenligning af statistik over builds i Dynatrace.
Konklusioner
Som resultat får vi en tjeneste "monitorering som en service", automatiseret i den kontinuerlige integrationspipeline. Udvikleren eller testeren skal blot definere listen over målinger i en JSON-fil, og alt andet sker automatisk. Vi får gennemsigtig kontrol af kvaliteten af udgivelser: alle meddelelser om præstation, ressourceforbrug eller arkitektoniske regressioner.
Opgave 2. Automatisering af softwarekvalitetskontrol i produktionsmiljøet
Så vi har løst opgaven med, hvordan man automatiserer overvågningsprocessen i testningen i Pipeline. På denne måde minimerer vi procentdelen af dårlig kvalitet builds, der når produktionsmiljøet.
Men hvad skal man gøre, hvis dårligt software alligevel når produktionen, eller hvis noget bare går i stykker? For utopia ønskede vi, at der skulle være mekanismer til automatisk opdagelse af problemer, og så vidt muligt skulle systemet selv genoprette sin funktionalitet, i det mindste om natten.
Til dette skal vi, ligesom i det foregående afsnit, forudse automatiske kvalitetskontroller af software i produktionsmiljøet og indlægge scripts til systemets selvgenoprettelse.
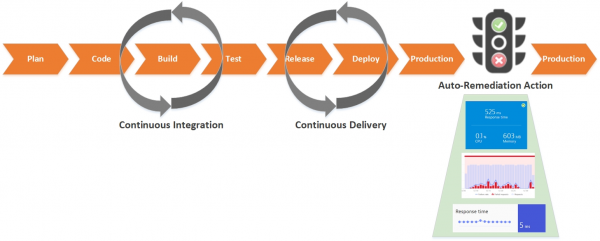
Auto-reparering som kode
I de fleste virksomheder eksisterer der allerede en opbygget vidensbase om forskellige typer almindelige problemer og en liste over handlinger til deres løsning, f.eks. genstart af processer, oprydning af ressourcer, rollback af versioner, genoprettelse af forkerte konfigurationsændringer, ændring af antallet af komponenter i klyngen, skift af blå eller grøn kontur osv.
Selvom disse anvendelsesscenarier har været kendt i mange år af de mange teams, jeg kommunikerer med, har kun få tænkt over det og investeret i deres automatisering.
Hvis man tænker over det, er der ikke noget overnaturligt kompliceret i at implementere processerne til selvgenoprettelse af applikationens funktionalitet. Det er nødvendigt at præsentere de allerede kendte arbejdsscenarier fra dine administratorer som scripts (konceptet "auto-reparering som kode"), som du på forhånd har skrevet for hver enkelt situation. Automatiske reparationsscenarier skal sigte mod at eliminere grundårsagen til problemet. Du bestemmer selv de rette reaktionshandlinger på hændelsen.
Enhver metrisk fra dit overvågningssystem kan fungere som trigger til at starte scenariet. Det vigtigste er, at disse målinger præcist kan fastslå, at alt er galt, da man ikke ønsker at få falske positiver i produktionsmiljøet.
Du kan bruge ethvert system eller en kombination af systemer: Prometheus, ELK Stack, Zabbix osv. Men jeg vil give nogle eksempler baseret på APM-løsningen (som eksempel vil jeg igen bruge Dynatrace), som også vil gøre dit liv lettere.
For det første er der alt vedrørende ydeevne set fra applikationens synspunkt. Løsningen giver hundreder af målinger på forskellige niveauer, som du kan bruge som triggere:
- bruger niveauer (browser, mobile apps, IoT-enheder, brugeradfærd, konvertering osv.);
- serviceniveau og operationer (ydelse, tilgængelighed, fejl osv.);
- applikationsinfrastruktur niveau (OS-metrikker for vært, JMX, MQ, webserver osv.);
- platform niveauer (virtualisering, cloud, container osv.).
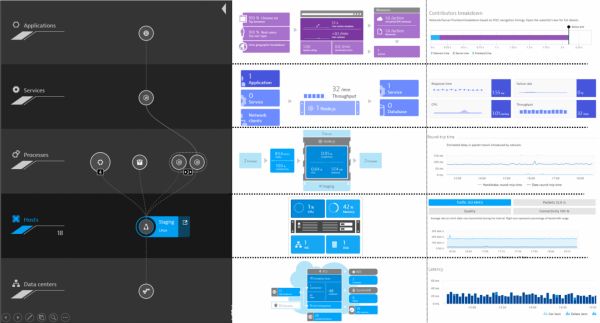 Overvågningsniveauer i Dynatrace.
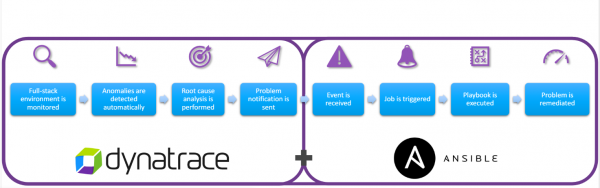
For det andet, som jeg nævnte tidligere, har Dynatrace et åbent API, der gør det meget nemt at integrere det med forskellige tredjepartssystemer. For eksempel at sende en meddelelse til automatiseringssystemet ved overskridelse af kontrolparametre.
Nedenfor er et eksempel på interaktion med Ansible.
Jeg vil derefter give nogle eksempler på, hvilke automatiseringer der kan gøres. Dette er kun en del af sagerne, deres liste i dit miljø kan kun begrænses af din fantasi og dine overvågningsværktøjs muligheder.
1. Dårlig deploy – rollback af version
Selv hvis vi kontrollerer alt meget grundigt i testmiljøet, er der stadig en chance for, at en ny version kan dræbe din applikation i produktionsmiljøet. Den menneskelige faktor er ikke blevet afskaffet.
I den næste illustration ser vi, at der sker et pludseligt spring i operationernes udførelsestid i tjenesten. Begyndelsen af dette spring falder sammen med tidspunktet for deployment til applikationen. Alle disse oplysninger sendes som begivenheder til automatiseringssystemet. Hvis tjenestens funktionalitet ikke normaliseres efter den tid, vi har angivet, udløses automatisk et script, der ruller versionen tilbage til den gamle.
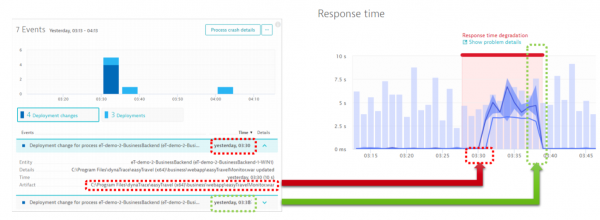 Deteriorering af operationernes ydeevne efter deployment.
2. Ressourcebelastning på 100% – tilføje node til routing
I det næste eksempel bestemmer overvågningssystemet, at en af komponenterne viser en CPU-belastning på 100%.
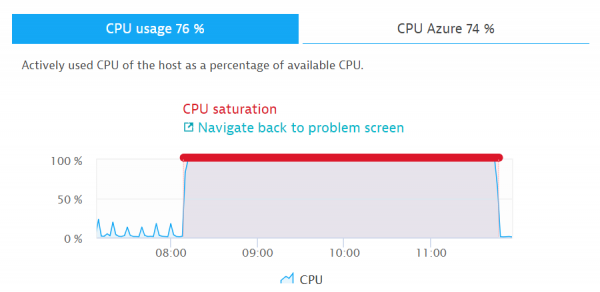 CPU-belastning 100%
For denne hændelse er der flere forskellige scenarier. For eksempel tjekker overvågningssystemet yderligere, om ressourceknapheden er relateret til et øget belastning på tjenesten. Hvis ja, udføres et script, der automatisk tilføjer en node til routing, hvilket genopretter systemets funktionalitet som helhed.
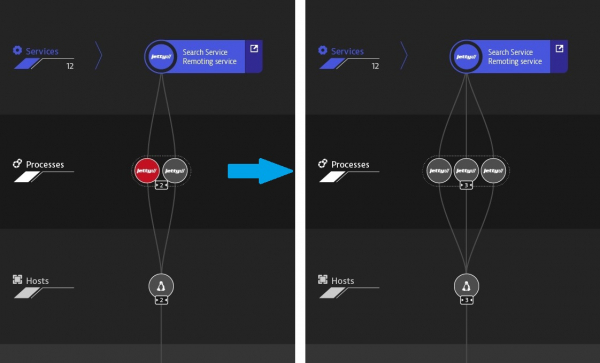 Skalering under og efter hændelsen
3. Mangel på plads på harddisken – rengøring af disken
Jeg tror, at mange af disse processer allerede er automatiserede. Med APM kan man også holde øje med den ledige plads på disksystemet. Hvis der ikke er plads eller hvis disken arbejder langsomt, kan vi kalde et script for at rydde eller tilføje plads.
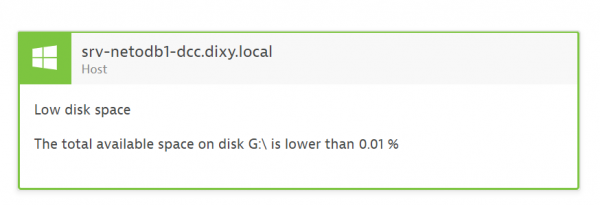
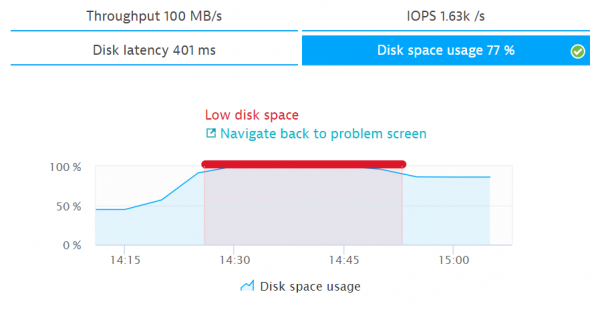 Diskbelastning 100%
4. Lav brugeraktivitet eller lav konvertering – skift mellem den blå og grønne gren
Jeg møder ofte kunder, der bruger to konturer (blue-green deploy) til applikationer i produktionsmiljøet. Dette gør det muligt hurtigt at skifte mellem grenene ved levering af nye udgivelser. Ofte kan der efter deployment ske væsentlige ændringer, som man ikke straks bemærker. Samtidig kan der ikke observeres nogen degradering i ydeevne og tilgængelighed. For at reagere hurtigt på sådanne ændringer er det bedre at bruge forskellige metrikker, der afspejler brugernes adfærd (antal sessioner og brugerhandlinger, konvertering, bounce rate). På den næste grafik ses et eksempel, hvor skiftet mellem softwaregrenene sker ved fald i konverteringen.
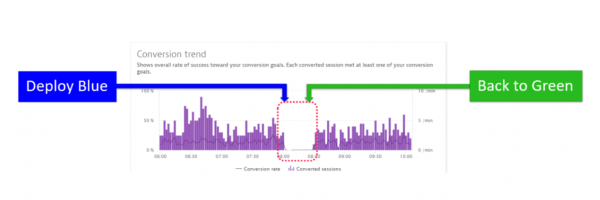 Fald i konverteringen efter skift mellem softwaregrenene.
Automatiske problemerfindingsmekanismer
Til sidst vil jeg give et eksempel på, hvad jeg bedst kan lide ved Dynatrace.
I en del af min beretning om automatisering af kvalitetstjek af builds i testmiljøet fastsatte vi alle tærskelværdier manuelt. For testmiljøet er det normalt, at testeren selv bestemmer målingerne før hver kontrol afhængigt af belastningen. I produktionsmiljøet er det ønskeligt, at problemer opdages automatisk under hensyntagen til forskellige baseline-mekanismer.
Dynatrace har interessante indbyggede kunstig intelligens-værktøjer, som baseret på mekanismer til at identificere anomale metrikker (baselining) og kortlægning af interaktionen mellem alle komponenter, der sammenligner og korrelerer begivenheder, identificerer anomalier i driften af din tjeneste og giver detaljerede oplysninger om hver enkelt problem og årsagen til det.
Ved automatisk analyse af afhængighederne mellem komponenterne bestemmer Dynatrace ikke kun, om den problematiske tjeneste er den primære årsag, men også dens afhængighed af andre tjenester. I det følgende eksempel sporer og vurderer Dynatrace automatisk ydeevnen af hver tjeneste i forbindelse med transaktioner og identificerer Golang-tjenesten som den primære årsag.
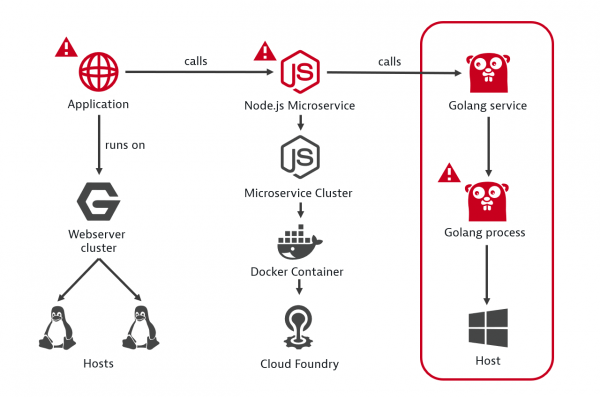 Eksempel på definition af rodårsagen til en fejl.
På den næste illustration vises processen med overvågning af problemer med din applikation fra starten af hændelsen.
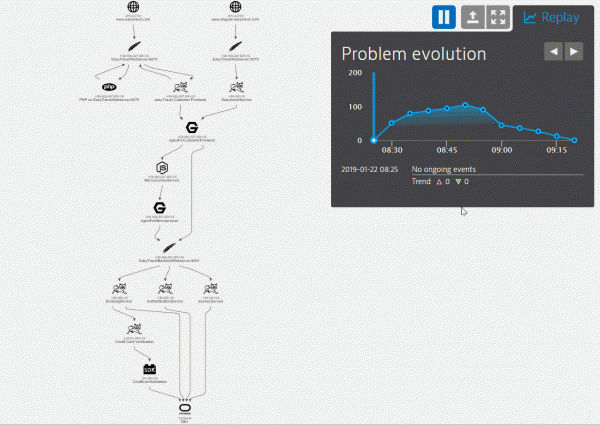 Visualisering af det opståede problem med visning af alle komponenter og begivenheder på dem.
Overvågningssystemet har samlet en fuld kronologi over begivenheder relateret til det opståede problem. I vinduet under den tidsmæssige graf kan vi se alle nøglebegivenheder på hver af komponenterne. Baseret på disse begivenheder kan du definere procedurer til automatisk reparation i form af kode-scripts.
Jeg anbefaler desuden at integrere overvågningssystemet med Service Desk eller et bug-tracker. Når der opstår et problem, får udviklerne hurtigt fuld information til analyse på kode-niveau i produktionsmiljøet.
Konklusion
Resultatet er en CI/CD-pipeline med indbyggede automatiserede kvalitetskontroller i pipeline. Vi minimerer antallet af usikre builds, øger systemets pålidelighed generelt, og hvis der stadig opstår driftsforstyrrelser, aktiverer vi mekanismerne for at genoprette driften.
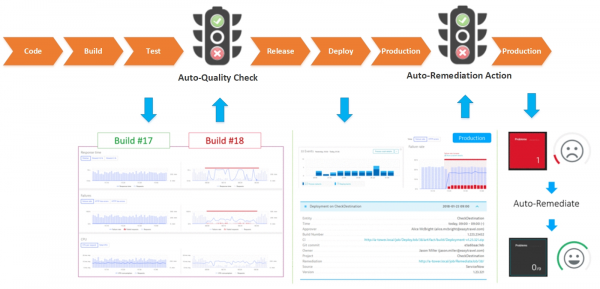
Automation af overvågning af softwarekvalitet er bestemt værd at investere i; det er ikke altid en hurtig proces, men over tid vil det give resultater. Jeg anbefaler efter løsning af en ny hændelse i produktionsmiljøet straks at overveje, hvilke overvågninger der skal tilføjes til testmiljøet for at undgå, at en dårlig build når produktion, samt at udarbejde et script til automatisk reparation af disse problemer.
Jeg håber, mine eksempler vil hjælpe dig i dine forsøg. Jeg ville også være interesseret i at se dine eksempler på anvendte metrics til implementering af selvgenopretning af systemers drift.
Kilde: habr.com
