

Den første API fra MitLager blev lanceret for 10 år siden. I hele denne tid har vi arbejdet på de eksisterende versioner af API'et og udviklet nye. Og flere versioner af API'et er allerede blevet begravet.
I denne artikel vil der være meget: hvordan API'et blev skabt, hvorfor det er nødvendigt for cloudtjenesten, hvad det giver brugerne, hvilke udfordringer vi har mødt, og hvad vi ønsker at gøre fremadrettet.
Mit navn er Oleg Alekseev , jeg er teknisk direktør og medstifter af MitLager.
Hvorfor lave API til servicen
Vores kunder, som er titusindvis af iværksættere, bruger aktivt cloudløsninger: banktjenester, webshops, varehåndtering, CRM. Når man først er tilsluttet én, er det allerede svært at stoppe. Og så er der den femte, ottende, tiende tjeneste, der gør iværksætterens arbejde lettere, men brugerne overfører stadig data mellem disse cloudtjenester manuelt. Det bliver til et mareridt.
Den åbenlyse løsning er at give brugerne mulighed for at overføre data mellem cloudtjenester. For eksempel at importere og eksportere data som filer, der derefter kan uploades til den ønskede tjeneste. Filene tilpasses normalt formatet for hver tjeneste. Det er mere eller mindre et simpelt manuelt arbejde, men med stigende antal af disse tjenester bliver det blot sværere at udføre.
Derfor er det næste skridt — API. Med det vinder cloudtjenesten ved at forbinde flere tjenester på ét sted. Fremkomsten af et sådant økosystem tiltrækker nye kunder på grund af de ekstra muligheder. Et produkt med nye funktioner bliver mere attraktivt og nyttigt.
Hvis man laver egne programmeringsgrænseflader, tiltrækker det eksterne sælgere i form af programmører, der kender dit produkt gennem API'et. De begynder at bygge løsninger baseret på det foreslåede API og tjener penge på at automatisere deres kunders opgaver.
Mit MyStocks regnskabssystem bygger på enkle processer. Det vigtigste er arbejdet med primære dokumenter, muligheden for at modtage og afsende varer, samt at få rapporter til virksomheden baseret på disse dokumenter. Derudover er der dataoverførsel, f.eks. til cloud-bogholderi, og modtagelse af data fra banksystemer eller detailpunkter. Vi arbejder også med internetbutikker: vi modtager oplysninger om varer og sender data om lagerbeholdninger.
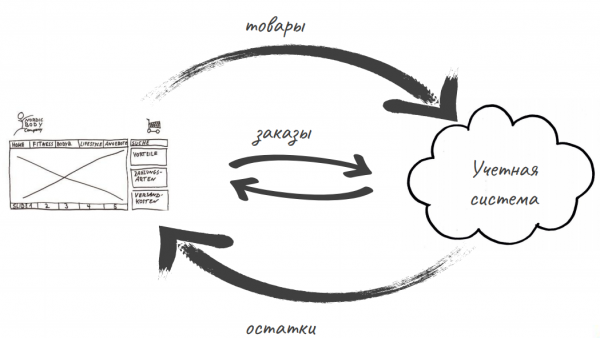
Den første API fra MyStocks
I løbet af de 10 år, hvor MyStocks har arbejdet med API, har vi opbygget mange integrationer, der muliggør dataudveksling, bankbehandling, betalinger og brugen af ekstern telefoni.
I det første år gjorde vi det muligt at eksportere enhver data i XML-format. På det tidspunkt var det meget nemmere og mere sikkert for brugerne at holde data offline end i en eller anden sky, og vi gav dem denne mulighed. Eksporten blev startet manuelt fra grænsefladen. Så API kunne man ikke kalde det endnu.
Dengang begyndte vi også samarbejde med Rusagro — de brugte allerede en 'moden' ERP til planlægning af produktion og salg, men automatiserede lastningen af vognene på fabrikkerne med MyStocks. Således fik vi de første spæde skridt hen imod et rigtigt API: udvekslingen mellem vores service og ERP-en fandt sted ved at sende en stor fil med data om alle dokumenttyper.
Dette er en god løsning til batchdataudveksling, men sammen med dokumenterne måtte afhængigheder overføres: oplysninger om varer, kunder og lagre. Sådan en sammenblanding er ikke svær at generere ved eksport, men ret svær at afkode ved import, da alle oplysninger kommer i en pakke: både om nye dokumenter og om eksisterende.
Den første XML API levede ikke længe — efter to år begyndte vi at ombygge den. Allerede fra starten af dens drift gjorde vi flere fejl i opbygningen af det programmerbare interface.
Sådan blev XML API bygget: illustration fra en af vores arkitekter. For øvrigt, hold øje med hans artikler.
Her er vores hovedfejl:
- JAXB-annoteringen blev lavet direkte på entitetsbønner. For at kommunikere med databasen bruger vi Hibernate, og de samme bønner blev annoteret med JAXB. Denne fejl dukker næsten med det samme op: enhver opdatering af datagrundlaget førte til behovet for straks at informere alle, der bruger API'et, eller konstruktion af hurtige løsninger, der kunne sikre kompatibilitet med den tidligere datastruktur.
- API'et opstod som en slags supplement, og oprindeligt definerede vi ikke, hvilken del af produktet det udgør. Vi overvejede heller ikke, om API'et var noget vigtigt, og om det var nødvendigt at opretholde bagudkompatibilitet for de første kunder. På et tidspunkt udgjorde antallet af API-brugere omkring 5% af det samlede lille antal, og vi gav dem ikke meget opmærksomhed. Den universelle filtrering, vi tidligere havde lavet, førte til, at vi blev brugt som backend. Denne filtrering var slet ikke GraphQL, men noget i den stil — den fungerede gennem en masse parametre i forespørgselsstrengen. Med et så kraftigt værktøj var det svært for brugerne at holde sig væk, og forespørgslerne blev sendt direkte fra deres e-handelsplatforms brugergrænseflade. Situationen blev en ubehagelig overraskelse, fordi levering af en sådan tjeneste burde kræve en anden prissætning og generelt en anden forståelse af selve API'et som produkt.
- Fordi API'et ikke udviklede sig som et hovedprodukt, blev dokumentationen til API'et udarbejdet og offentliggjort som en restløsning — gennem reverse engineering. Denne metode synes at være temmelig enkel og praktisk, men strider imod arbejde efter kontrakt. Det er, når der er en bestemt komponent med en foruddefineret arbejdsgang. Udvikleren implementerer den i overensstemmelse med denne skitse og opgaven, komponenten gennemgår testning, kunden får et produkt, der svarer til analytikerens intentioner. Reverse engineering kaster derimod et produkt ud på markedet, som bare findes: med hurtige løsninger, mærkelige beslutninger og unødvendige funktionaliteter i stedet for den ønskede funktionalitet.
- Hele strømmen af forespørgsler, der kom gennem API'en, kunne kun analyseres som en Nginx-log eller fra applikationens server. Dette gjorde det umuligt at identificere emneområder, bortset fra at opdele efter brugere og abonnenter. Hvis der ikke er mulighed for at regulere registreringen af applikationen eller kunderne, bliver det umuligt at analysere situationen. Dette problem havde mindst indflydelse på udviklingen af API'en; det handlede mere om at forstå dens efterspørgsel og funktionsindhold.
Forsøg nummer to: REST API
I 2010 forsøgte vi at opbygge et udvekslingssystem med online regnskabsprogrammet – BuchSoft. Det lykkedes ikke. Men i integrationsprocessen blev der skabt et komplet API: en REST-udvekslingstjeneste, hvor der ikke var friheder som kald til operationer i form af RPC-opkald. Al kommunikation med API'en blev standardiseret til REST-formatet: forespørgselslinjen indeholder navnet på entiteten, og den operation, der udføres, bestemmes ved hjælp af HTTP-metoden. Vi tilføjede filtrering efter opdateringstidspunktet for entiteterne, hvilket gav brugerne mulighed for at bygge replikation med deres egne systemer.
I samme år blev der introduceret et API til eksport af lager- og varelagerdata. Gennem API'en blev de mest værdifulde dele af systemet tilgængelige for brugerne – udveksling af primære dokumenter og beregningsdata vedrørende lagrene og omkostningerne af varer.
I december 2015 offentliggjorde RetailCRM det første tredjepartsbibliotek til adgang til vores API. Det blev brugt aktivt, samtidig voksede tjenestens popularitet generelt, og belastningen på API'en voksede hurtigere end belastningen på webgrænsefladen. En dag blev væksten til en belastningsspid.
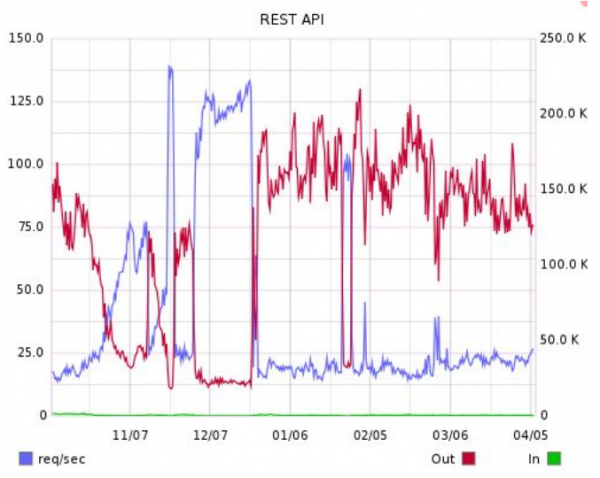
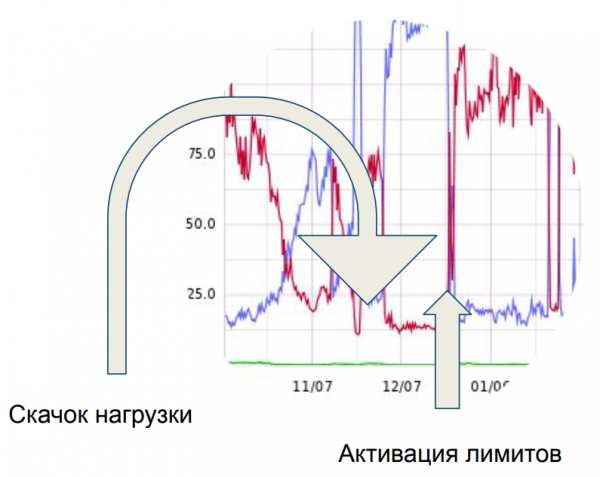
Og denne spid, som pilen til venstre viser, forårsagede total forbløffelse hos serveren, der betjente vores API. I en uge prøvede vi at finde ud af, hvad præcist denne belastning genererede. Det viste sig, at det var de samme forespørgsler, der blev transmitteret til vores API fra frontend'en hos kunderne. Omkring 50 kunder stod for det hele. Her indså vi en af vores fejl – fuldstændig mangel på grænser.
Som følge heraf har vi indført en grænse for antallet af samtidige forespørgsler. Fra én konto kan man nu åbne højst to forespørgsler ad gangen. Det er tilstrækkeligt til at arbejde i reproduktionsmode for dataudveksling i batchmode. De, der ønskede at bruge os som backend, måtte øge deres overensstemmelse med priserne, da de indførte brugen af flere konti i deres software.
Bringer orden
Siden 2014 er efterspørgslen efter den eksisterende API blevet en vigtig del af forretningen, og selve API'en har genereret den største mængde data i udvekslingen med kunderne. I 2015 lancerede vi projektet for at bringe API'en i orden. Vi valgte JSON som format i stedet for XML og begyndte at bygge det ud fra de funktioner, vi havde identificeret ved implementeringen af den tidligere version:
- Mulighed for versionering. Versionering gør det muligt at udvikle en ny version uden at påvirke den eksisterende applikation og uden at forstyrre brugerens arbejde.
- Mulighed for brugeren at se metadata i svaret, som de modtager.
- Mulighed for at udveksle store dokumenter. Hvis vi behandler et dokument med mere end 4-5 tusinde poster, bliver det et problem for serveren: lange transaktioner, lange http-forespørgsler. Vi har bygget en særlig mekanisme, der muliggør at opdatere dokumentet i dele og håndtere individuelle poster i dokumentet ved at sende dem til serveren.
- Værktøjer til replikation - der var også i den tidligere version.
- Belastningsgrænser - som et resultat af tidligere problemer, som vi stødte på i den tidligere version. Vi har indført grænser for antal forespørgsler i en given tidsramme, antal parallelle forespørgsler og forespørgsler fra én ip-adresse.
Siden da har vi udgivet to mindre versioner af API'en og lanceret flere specialiserede API'er, men den overordnede tilgang er forblevet uændret. Den opdaterede udvekslingsformat og den nye arkitektur har gjort det muligt at rette mangler i API'en hurtigere.
API'en fra MojeLager i dag
I dag løser API'en fra MojeLager mange opgaver:
- dataudveksling med webshops, regnskabssystemer, banker;
- få beregningsdata, rapporter;
- bruge som backend til klientapplikationer - vores mobile applikationer og desktopkassen arbejder gennem API'en.
- afsendelse af notifikationer om ændringer i data i MinLager - webhooks;
- telefoni;
- loyalitetssystemer.
Baseret på API har vores direktør Askar Rakhimberdiev på fire timer skrev en telegram-bot, der henter lagerbeholdninger via API:
Nu er det blot tørre tal.
Her er vores statistik for det gamle REST API:
- 400 virksomheder;
- 600 brugere;
- 2 millioner forespørgsler om dagen;
- 200 GB/dag udgående trafik.
Og her er, hvad vi er nået frem til med alle API'er fra MinLager:
- mere end 70 integrationer (nogle af dem kan ses her );
- 8500 virksomheder;
- 12.000 brugere;
- 46 millioner forespørgsler om dagen;
- 2 TB/dag udgående trafik.
vil være udsolgt
Planerne for udvikling af API'et er aktivt under diskussion. Vi forsøger at tage hensyn til brugeroplevelsen, som vores brugere giver os. Det er ikke altid muligt at gøre alt med det samme, men en ny version af API'et med mere brugervenlige metadata og en mindre kompliceret struktur, OAuth til autentifikation og API til indlejrede applikationsinterfacer er nært forestående.
Du kan følge nyhederne på den specielle hjemmeside for udviklere af integrationer med MinLager: .
Kilde: habr.com
