

Når vi taler om steganografi, forestiller folk sig terrorister, pædofile, spioner, ja, i bedste fald kryptoanarkister og andre forskere. Og faktisk, hvem ellers kan have brug for at skjule noget fra ydre blikke? Hvilken nytte kan det overhovedet være for den almindelige borger?
Det viser sig, at der faktisk er en. Det er derfor, vi i dag vil komprimere data ved hjælp af steganografimetoder. Og til sidst vil læseren endda kunne bruge sine dyrebare JPEG-fotoarkiver til at øge mængden af ledige gigabyte på filsystemet.
Hvad?
Hvis læseren kan huske, så er steganografi sådanne mærkelige algoritmer, der tillader at skjule tilstedeværelsen af én information inden i en anden. Med andre ord: billede + fil == omtrent det samme billede, men ikke helt (i stedet for billeder kan der være hvad som helst, men det er normalt lettere at forstå med billeder). Der bør ikke være nogen enkel måde at fastslå, om der er noget indeni eller ej.
Men hvis man ikke kan skelne det ene fra det andet, er der så overhovedet nogen forskel? Set fra forbrugerens synspunkt, bekymrer brugeren sig ikke om matematisk præcision (reflekteret i et bestemt sæt bits), kun hvad der opfattes.
Lad os for eksempel se på tre billeder af en sød hund:
Pas på, JPEG!
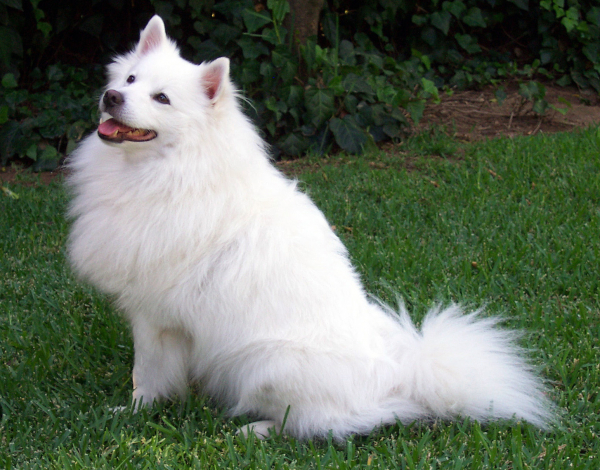
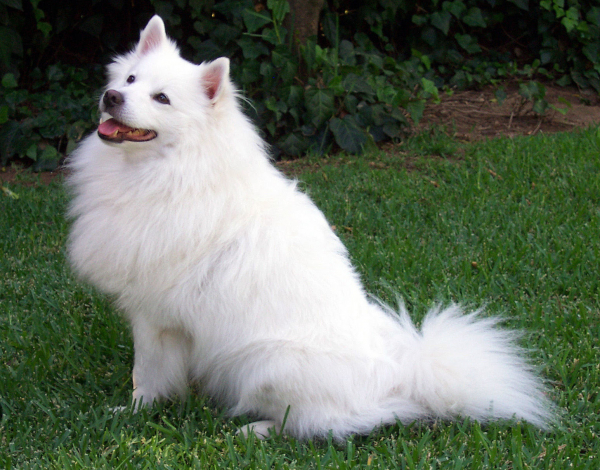
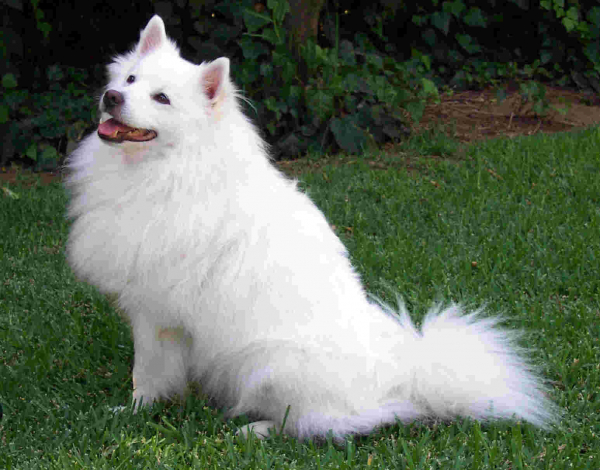
På trods af den enorme forskel i størrelse, er der få, der ville vælge den tredje version. På den anden side er forskellen mellem de to første billeder ikke så mærkbar, og informationsmængden i dem (efter min mening) kan anses for at være lig med.
Selve denne principle er allerede gammel og har i mange år været aktivt udnyttet af metoder til information kompression med tab. Men at bryde ned— ikke bygge op, vi er interesserede i den mere avancerede side af spørgsmålet. Er det muligt at indbygge ekstra information af størrelse N i en fil, så størrelsen øges med M < N, og ændringerne ikke er mærkbare for brugeren?
Selvfølgelig er det muligt. Men det er vigtigt at lave et par forbehold med det samme:
- For det første skal metoden være universel og give positive resultater for de fleste inputdata. Det vil sige, i gennemsnit, for vilkårlig input, skal der ske en faktisk reduktion i den gemte informationsmængde. "I gennemsnit" betyder, at der kan forekomme modsatte tilfælde, men de må ikke dominerer.
- For det andet skal størrelsen af den komprimerede beholder, før information integreres, være større end den komprimerede version af dens modifikation. At simpelthen integrere en masse bits i BMP-billeder ved hjælp af LSB-metoden er ikke en steganografisk komprimering, da det originale billede, når det køres gennem en eller anden DEFLATE, sandsynligvis vil blive betydeligt mindre.
- For det tredje skal resultaterne udføres og sammenlignes i forhold til data, der allerede er komprimeret med klassiske metoder. Dette vil fjerne den sandsynlighedseffekt, der er forskellen i deres overflødighed og tillade en mere effektiv komprimering i almindelighed.
Hvor?
Brugen af steganografi indebærer, at vi ud over den komprimerede information også får brug for beholdere, hvori den skal integreres. Den maksimale mængde integrerbar information afhænger i høj grad af de individuelle egenskaber, men bliver lettere skalerbar med deres antal. Derfor skal beholderformatet være udbredt, så brugeren har et tilstrækkeligt antal til at få nogen form for udbytte af "komprimerings"-processen.
I denne sammenhæng bliver grafiske, audio- og videofiler gode kandidater. Men på grund af mangfoldigheden af forskellige formater, codecs osv. har vi i praksis kun et begrænset antal muligheder.
Under hensyntagen til alt dette, faldt mit valg på JPEG. Det er praktisk talt tilgængeligt for alle, anvendes bredt både til personlige og erhvervsmæssige formål og er næsten de facto-formatet for de fleste billeder.
Hvornår? Hvordan?
Derefter følger omtrentlige og tekniske diagrammer og beskrivelser uden særlige forklaringer, så interesserede kan springe dem over ved at rulle ned til afsnittet "Høj teknologi".
Fælles træk
For at integrere data et sted, skal man først bestemme, hvor. Der kan være ubegribelig mange forskellige billeder på filsystemet, blandt hvilke brugeren kun måtte ønske at bruge nogle få. Dette ønskede sæt af beholdere kalder vi et bibliotek.
Den dannes i to tilfælde: før komprimering og før dekomprimering. I det første tilfælde kan man blot bruge et sæt filnavne (eller bedre, et regulært udtryk til dem), men i det andet kræves noget mere pålideligt: brugeren kan kopiere og flytte dem inden for filsystemet, hvilket gør det vanskeligt at identificere dem korrekt. Derfor er det nødvendigt at gemme deres hasher (md5 er tilstrækkeligt) efter at have foretaget alle ændringer.
Der er ikke meget mening i at udføre den indledende søgning med et regulært udtryk på hele filsystemet; det er tilstrækkeligt at angive en bestemt rodmappe. I denne mappe vil der også blive gemt en speciel arkivfil, der indeholder de hasher sammen med anden metainformation, der er nødvendig for senere at genskabe den komprimerede information.
Alt dette gælder ligeligt for enhver implementering af enhver algoritme til steganografisk datakomprimering. Selve processerne for komprimering og genskabelse af data kan kaldes pakning og udpakning.
F5
Nu hvor det er klart, hvad vi laver og hvorfor vi gør det, er det tid til at beskrive selve algoritmen til at nå målet. Lad os huske processen med at kode en JPEG-fil (tak til den nationale biblioteks wiki ved Bauman):
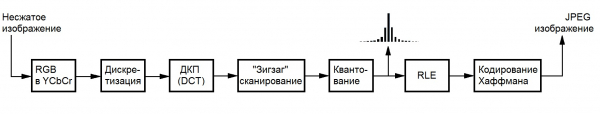
Når vi ser på det, er det bedst at gøre et par bemærkninger med det samme:
- Størrelsen på JPEG-filen kan betragtes som optimal, selv uden at prøve at komprimere den med WinRAR;
- Man må kun ændre den gemte information (den, der er resultatet af den diskrete cosinus-transformation, DCT) for at sikre en acceptabel ydelse.
- For ikke at miste data i betydelig grad, der er synlige for brugeren, er det nødvendigt at foretage mindst mulige ændringer i hver enkelt billede;
Under disse betingelser passer en hel familie af algoritmer, som man kan blive bekendt med . Den mest avancerede af dem er algoritmen af Andreas Westfeld, der arbejder med DCT-koefficienterne for lysstyrke (det menneskelige øje er mindst følsomt over for ændringer i denne). Hans overordnede skema, når man arbejder med en eksisterende JPEG-fil, vises i følgende diagram:
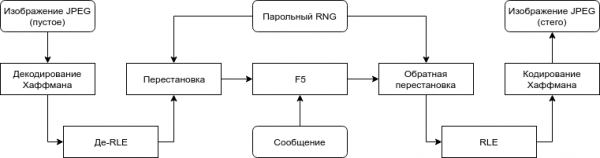
F5-blokken anvender en avanceret indlejringsmetode baseret på matrixkodning. Læseren kan nærmere sætte sig ind i denne metode og selve algoritmen via linket ovenfor, men vi er først og fremmest interesserede i den kendsgerning, at jo større størrelsen på den anvendte beholder er, jo færre ændringer kan der foretages ved indlejring af den samme mængde information. Til selve algoritmen kræves det kun at udføre enkle (de)kodningsoperationer af Huffman og RLE.
Ændringerne foretages på heltalskoefficienterne og reduceres til én enheds absolutte værdi, hvilket i princippet muliggør brugen af F5 til datakomprimering. Det skyldes, at en reduceret koefficient i absolut værdi sandsynligvis vil tage færre bits efter Huffman-kodning på grund af den statistiske fordeling af værdier i JPEG.
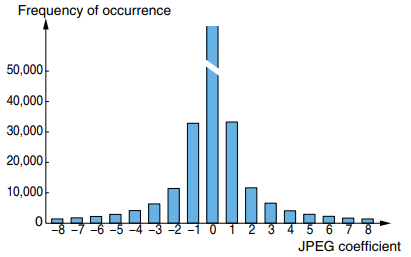
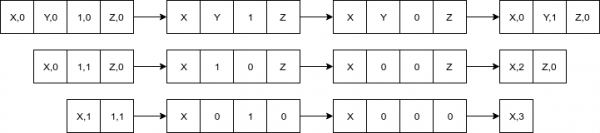
I tilfælde af dannelse af nul (den såkaldte forkortelse) vil mængden af gemt information reduceres med dens størrelse, da den tidligere selvstændige koefficient bliver en del af den kodede RLE-sekvens af nuller:
Modifikationer
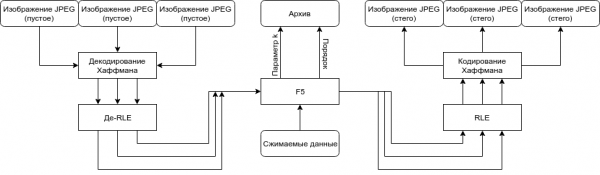
Databeskyttelse og datakomprimering er ortogonale opgaver, så den hemmelige adgangskode-permutationsmetode fra den oprindelige algoritme kan ignoreres. Desuden skal vi vide præcist, hvordan dataene skal udtrækkes, så al nødvendig information til dette formål (hvilke containere der blev brugt, i hvilken rækkefølge osv.) skal gemmes i en separat fil og være åben for fri læsning af arkiveringsprogrammet.
Den oprindelige algoritme er designet til overførsel af hemmelige meddelelser, så den arbejder kun med én beholder ad gangen, idet den forudsætter, at brugeren selv vil dele den op i dele ved behov, hvis det overhovedet måtte blive nødvendigt. Desuden vil det ved uafhængig indlejring i hver container være nødvendigt at vide på forhånd, hvor mange bits data der skal placeres i hver. Derfor er det værd at samle koefficienterne for hvert element fra biblioteket i én abstrakt stor og arbejde med den efter den oprindelige algoritme.
Da den originale F5 tillader at bruge op til 12% af containerens størrelse, vil en sådan ændring også øge den maksimale kapacitet: «op til 12%» af størrelsen på hele biblioteket skal være større end eller lig med summen af «op til 12%» af hver af dens elementer.
Den kodificerede overordnede skema ser således ud:
Selve algoritmen
Nu er det tid til at beskrive selve algoritmen fra start til slut, så læseren ikke holdes i uvidenhed:
- Brugeren definerer de binære komprimerbare data M og biblioteket L ved hjælp af et regulært udtryk og den rodmappe, der skal søges i;
- I rækkefølge på FS former bibliotekselementerne MC:
- En række koefficienter C dekodes fra datafilen;
- MC <- MC | C;
- Parameteret k bestemmes ud fra den skræmmende ulighed:
|M| * 8 / (count_full(MC) + count_ones(MC) * k_rate(k)) < k / ((1 << k) - 1); - Der tages successivt
n = (1 << k) - 1de nederste bits af ikke-nul elementer fra MC og skrives ind ien:- Den magiske hash-funktion beregnes
f, som kortlægger et n-bit ordenhvis s == 0s; - Hvis
, skal der ikke ændres noget, og algoritmen går videre til de næste koefficienter;Reducer det absolutte værd af den koefficient, der svarer til - -te bit i ordet
sHvis der som følge af reduktionen skete en forkortelse (koefficienten blev 0), skal man gentage trin fra starten;en; - Alle koefficienter kodificeres med RLE og Huffman, skrives i de oprindelige filer;
- Den magiske hash-funktion beregnes
- Parameteret k skrives i arkivfilen;
- For hver fil L i rækkefølge af deres oprindelige placering beregnes MD5-hashen og skrives i arkivfilen.
- Den naive form af algoritmen og implementeringer på andre højere niveauer (især dem med affaldssamling) ville give forfærdelig ydeevne, derfor realiserede jeg alle disse komplekse processer i rent C og lavede en række optimeringer både i forhold til hastighed og hukommelse (du kan ikke forestille dig, hvor meget disse billeder vejer, uden komprimering selv til DCT). Men på den måde, i begyndelsen, lod udførelseshastigheden meget tilbage at ønske, så jeg vil ikke beskrive hele processen og de anvendte metoder.
Høj teknologi
Tværplatformskompatibilitet er opnået ved at bruge en kombination af bibliotekerne libjpeg, pcre og tinydir, for hvilket de skal have tak. Som standard kompileres alt gennem den almindelige
, så Windows-brugere skal installere en form for Cygwin eller finde ud af Visual Studio og biblioteker på egen hånd. make, så Windows-brugere ønsker at installere Cygwin eller selv håndtere Visual Studio og biblioteker.
Implementeringen er tilgængelig som et kommandolinjeværktøj og en biblioteksfil. De, der ønsker at lære mere om brugen af sidstnævnte, kan finde oplysninger i readme-filen i vores GitHub-repository, som jeg vil vedhæfte i slutningen af indlægget. Lad os nu gå videre til beskrivelsen og demonstration af funktionen.
Hvordan bruger man det?
Med forsigtighed. De anvendte billeder kan flyttes, omdøbes og kopieres efter ønske. Dog skal man være yderst omhyggelig med ikke at ændre deres indhold. Ændring af et enkelt bit vil føre til et brud på hash-værdien og gøre det umuligt at gendanne oplysningerne.
Lad os sige, at vi efter kompileringen har fået en eksekverbar fil f5ar. Man kan analysere størrelsen på biblioteket for at beregne mulighederne for dets anvendelse ved hjælp af flaget -a: .\/f5ar -a [søgemappe] [Perl-kompatibelt regulært udtryk]. Pakning udføres med kommandoen .\/f5ar -p [søgemappe] [Perl-kompatibelt regulært udtryk] [pakket fil] [arkivnavn], mens udpakkning sker ved hjælp af .\/f5ar -u [arkivfil] [navn på gendannet fil].
Demonstration af funktionaliteten
For at vise effektiviteten af metoden har jeg uploadet en samling af 225 helt gratis hundefotografier fra tjenesten . Hver af dem har en lidt højere kvalitet end almindelige brugerfotos, men dog hver enkelt er blevet omkodet med libjpeg for at neutralisere indflydelsen fra bibliotekets kodningsspecifikationer på den samlede størrelse. For at fremhæve det dårligste eksempel på komprimerede data blev der genereret en tilfældig 36MB fil (lidt mere end 5% af den samlede størrelse) med jævnt fordelt indhold ved hjælp af dd.
Testprocessen er ganske simpel:
$ ls
binary_data dogs f5ar
$ du -sh dogs/
633M dogs/
$ du -h binary_data
36M binary_data

$ .\/f5ar -p dogs/ .*jpg binary_data dogs.f5ar
Læser komprimeringsfil... ok
Initierer arkivet... ok
Analyserer bibliotekskapacitet... færdig i 16,8 sek
Registreret noget garanteret kapacitet på 48439359 bytes
Registreret mulig kapacitet på op til 102618787 bytes
Komprimering... færdig i 32,6 sek
Gemmer arkivet... ok

$ .\/f5ar -u dogs/dogs.f5ar unpacked
Initierer arkivet... ok
Læser arkivfilen... ok
Fylder arkivet med filer... færdig i 1,2 sek
Udpakning... færdig i 17,5 sek
Skriver udtrukne data... ok

$ sha1sum binary_data unpacked
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 binary_data
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 unpacked
$ du -sh dogs/
563M dogs/
Eller et screenshot for entusiasten
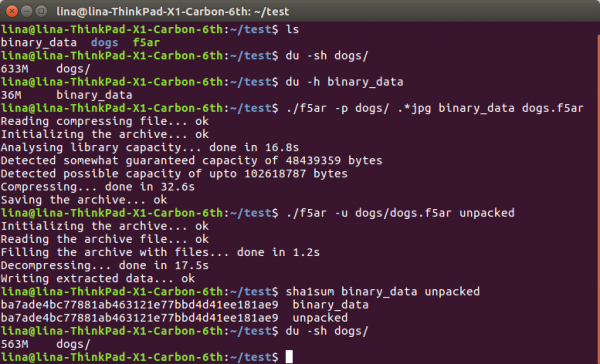
Som det fremgår, er vi fra de oprindelige 633 + 36 == 669 megabyte data på harddisken endt med mere behagelige 563, hvilket giver os et komprimeringsforhold på ~1,188. Denne radikale forskel skyldes de ekstremt små tab, der svarer til dem der opnås ved JPEG-filoptimering med klassiske metoder (som tinyjpg). Naturligvis, når man bruger steganografisk komprimering, tabes information ikke bare, men bruges til at kode andre data. Desuden er antallet af "optimerede" koefficienter ved brug af F5 langt mindre end ved traditionel optimering.
Uanset hvilke modifikationer der er lavet, er de helt usynlige for øjet. Under spoilerafsnittet nedenfor kan læseren vurdere forskellen både visuelt og ved at trække ændrede komponentværdier fra de originale (jo mere dæmpet farven er, desto mindre er forskellen):
Links til billeder, der ikke kunne placeres på habrastorage
Originalen —
Modificeret —
Forskellen —
Afslutning
Jeg håber, at jeg har været i stand til at overbevise læseren om, at sådanne metoder er mulige og har ret til at eksistere. Alligevel kan det virke langt simplere at købe en harddisk eller en ekstra kanal (til netværksoverførsel) end at forsøge at spare på denne måde. På den ene side er det faktisk rigtigt; ekstensiv udvikling er ofte mere simpel og pålidelig. Men på den anden side bør man ikke glemme den intensive udvikling. For der er ingen garantier for, at det i morgen vil være muligt at gå til butikken og købe sig en ny harddisk på tusind terabyte, men man kan altid bruge dem, der allerede ligger derhjemme.
->
Kilde: habr.com
