

God fredag til alle! Venner, i dag fortsætter vi serien af publikationer dedikeret til kurset , da undervisningen i den nye gruppe for kurset starter allerede i slutningen af næste uge. Lad os komme i gang!
Overvågning er bare. Det er en velkendt kendsgerning. Start Nagios, kør NRPE på det eksterne system, konfigurer Nagios til NRPE TCP-port 5666, og så har du overvågning.
Det er så let, at det er kedeligt. Nu har du de grundlæggende målinger for CPU-tid, diskunderstøttelse, RAM, som kommer som standard i Nagios og NRPE. Men i virkeligheden er det ikke „overvågning“ som sådan. Det er kun begyndelsen.
(Normalt installerer man PNP4Nagios, RRDtool og Thruk, opsætter notifikationer i Slack og går direkte til nagiosexchange, men lad os undlade det for nu).
God overvågning er faktisk ret kompliceret, du skal virkelig kende indersiden af den applikation, du overvåger.
Er overvågning svært?
Enhver server, hvad enten det er Linux eller Windows, vil efter definition tjene et bestemt formål. Apache, Samba, Tomcat, filopbevaring, LDAP – alle disse tjenester er mere eller mindre unikke på en eller flere måder. Hver har sin funktion, sine særpræg. Der er forskellige måder at indsamle de målinger, KPI'er (nøglepræstationsindikatorer), der er interessante for dig, når serveren er under belastning.
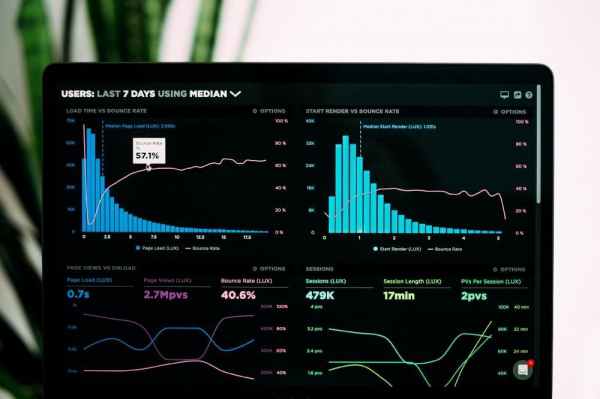
Foto af og få en fungerende kommando.
(Jeg ville ønske, at mine dashboards var malet i neonblå farver – drømmende suk –… hmm…)
Enhver software, der leverer tjenester, skal have en mekanisme til at indsamle målinger. Apache har modulet mod-status, som viser serverens status-side. Nginx har stub_status. Tomcat har JMX eller specielle webapplikationer, der viser vigtige målinger. MySQL har kommandoen „show global status“ osv.
Så hvorfor integrerer udviklere ikke sådanne mekanismer i de applikationer, de skaber?
Er det kun udviklerne, der gør dette?
Et vist niveau af ligegyldighed over for integrationen af målinger er ikke begrænset til udviklerne. Jeg har arbejdet i virksomheder, hvor der blev udviklet applikationer ved hjælp af Tomcat, og hvor der ikke blev givet nogen målinger, ingen serviceaktivitetlogs, ud over de generelle fejl logs fra Tomcat. Nogle udviklere genererer en overflod af logs, som intet siger for systemadministratoren, der er uheldig nok til at læse dem kl. 3:15 om morgenen.
Foto af og få en fungerende kommando.
Systemingeniører, der tillader sådanne produkter at blive udgivet, skal også påtage sig et vist ansvar for situationen. Få systemingeniører har tid og omtanke til at forsøge at få meningsfulde målinger ud af logs, uden konteksten af disse målinger og evnen til at fortolke dem i lyset af applikationens aktivitet. Nogle forstår ikke, hvilken fordel de kan få ved det, udover indikatorer som 'noget er i øjeblikket (eller snart vil være) galt'.
Ændringen af tankegangen omkring nødvendigheden af målinger skal finde sted ikke kun blandt udviklerne, men også blandt systemingeniørerne.
For enhver systemingeniør, der ikke kun skal reagere på kritiske hændelser, men også sikre, at de ikke opstår, er fraværet af målinger normalt en hindring for dette.
Systemingeniører dykker dog normalt ikke ned i koden, da de tjener penge for deres virksomhed. De har brug for ledende udviklere, der forstår vigtigheden af systemingeniørens ansvar i at identificere problemer, øge bevidstheden om ydeevneproblemer og lignende.
Denne devops ting
Devops-mentaliteten beskriver synergi mellem udviklernes (dev) og drifts (ops) tankegang. Enhver virksomhed, der hævder, at de 'gør devops', skal:
- sige det, de sandsynligvis ikke gør (et hint til meme fra filmen 'Prinsessebruden' — 'Jeg tror ikke, det betyder det, du tror, det betyder!')
- opmuntre til en position for konstant forbedring af produktet.
Du kan ikke forbedre et produkt og vide, at det er blevet forbedret, hvis du ikke ved, hvordan det fungerer i øjeblikket. Du vil ikke være i stand til at finde ud af, hvordan produktet fungerer, hvis du ikke forstår, hvordan dets komponenter fungerer, de tjenester, det er afhængigt af, dets primære problemområder og flaskehalse.
Hvis du ikke overvåger potentielle flaskehalse, vil du ikke kunne følge teknikken 'De fem hvorfor' ved skrivning af et postmortem. Du vil ikke være i stand til at samle alt på én skærm for at se, hvordan produktet fungerer, eller finde ud af, hvordan det ser ud 'normalt og lykkeligt'.
Skift til venstre, TIL VENSTRE, JEG SAGDE, VEEEENSTRE—
For mig er et af nøgleprincipperne i DevOps 'Skift til venstre' (shift left). At skifte til venstre i denne kontekst betyder at flytte muligheden (ikke ansvarligheden, men kun muligheden) for at gøre det, som systemingeniører normalt bekymrer sig om, for eksempel at skabe ydeevnemetrikker, udnytte logs mere effektivt osv., til venstre i softwareleveringslivscyklussen (Software Delivery Life Cycle).
Foto af og få en fungerende kommando.
Softwareudviklere skal være i stand til at bruge og kende de overvågningsværktøjer, som virksomheden bruger, for at kunne overvåge i alle sine former, metrikker, logføring, overvågningsinterfaces, og vigtigst af alt, at observere hvordan deres produkt fungerer i produktion. Du kan ikke tvinge udviklerne til at investere tid og kræfter i overvågning, så længe de ikke kan se metrikkerne og påvirke, hvordan de ser ud, hvordan ejeren af produktet vil præsentere dem for CTO'en ved næste briefing osv.
Kort sagt
- Bring hesten til vandet. Vis udviklerne, hvor mange problemer de kan undgå for sig selv, hjælp dem med at identificere de rigtige KPI'er og metrikker for deres applikationer, så der bliver mindre råb fra produktlederen, som bliver råbt ad af den tekniske direktør (CTO). Bring dem frem i lyset, blidt og roligt. Hvis det ikke lykkes, så bestik, tru og overtale enten dem eller produktlederen for hurtigst muligt at implementere indsamlingen af disse metrikker fra applikationerne, og tegne derefter diagrammer. Det vil være vanskeligt, da dette ikke vil blive betragtet som en prioritet, og der vil være mange projekter på produktets køreplan, der venter på implementering og genererer indtægter. Derfor vil du have brug for en økonomisk begrundelse for at retfærdiggøre den tid og de ressourcer, der bruges på at implementere overvågning i produktet.
- Hjælp systemingeniørerne med at få en god nats søvn. Vis dem, at brugen af tjeklisten "udgivelsesudgave" for ethvert udgivet produkt er en god idé. At sikre, at alle applikationer i produktion er dækket af metrics, vil hjælpe med at sikre en sund søvn om natten, hvilket gør det muligt for udviklerne at se, hvad der ikke fungerer som det skal. Ikke desto mindre er den rigtige måde at irritere og frustrere enhver udvikler, produktleder eller teknisk direktør på, at insistere på at sætte hindringer i vejen og modarbejde. Sådan en adfærd vil påvirke datoen for udgivelsen af ethvert produkt, hvis man igen venter til sidste øjeblik, så tag fat på problemerne så hurtigt som muligt og inkluder dem i projektplanen. Hvis nødvendigt, snig dig ind til møderne om produktet. Bær falske overskæg og fedt eller noget i den stil, det vil aldrig svigte. Del dine problemer, vis de åbenlyse fordele og evangeliser.
- Sørg for, at både udviklerne (dev) og driften (ops) forstår betydningen og konsekvenserne af, at produktmetrics går ind i "den røde zone". Lad ikke driften være den eneste vagthund for produktets funktionalitet, sørg for, at udviklerne også er involveret i dette (#productsquads).
- Logs er en glimrende ting, men metrics er også vigtige. Kombiner dem og lad ikke dine logs blive til affald i en kæmpe brændende klump af nytteløshed. Forklar og vis udviklerne, hvorfor ingen andre end dem kan forstå deres logs, og vis dem, hvordan det er at se på unyttige logs kl. 03:15.
Foto af og få en fungerende kommando.
Det var alt for nu. Nyt materiale vil blive udgivet i næste uge. Hvis du ønsker at vide mere om kurset, inviterer vi til , som finder sted allerede på mandag. Og nu venter vi traditionelt på jeres kommentarer.
Kilde: habr.com
