

Introduktion
Goddag. Vi har haft et script (eller rettere sagt et sæt scripts) kørende i et halvt år, der genererer rapporter om status for virtuelle maskiner (og andet). Jeg har besluttet at dele erfaringerne med oprettelsen og selve koden. Jeg ser frem til kritik og håber, at dette materiale kan være nyttigt for nogen.
Identificering af behov
Vi har mange virtuelle maskiner (omkring 1500 VM'er fordelt på 3 vCenter). Nye oprettes, og gamle slettes ret ofte. For at bevare orden blev der tilføjet flere brugerdefinerede felter i vCenter for at adskille VM'er i subsystemer, angive om de er testmaskiner, samt hvem der har oprettet dem og hvornår. Den menneskelige faktor har medført, at mere end halvdelen af maskinerne er tilbage med uopfyldte felter, hvilket har gjort arbejdet mere kompliceret. Hver sjette måned blev der altid nogen, der blev frustreret og satte gang i en opdateringsproces for disse data, men resultatet er ofte blevet irrelevant efter omkring halvanden uge.
Lad mig straks præcisere, at alle forstår, at der skal være anmodninger om oprettelse af maskiner, processer til deres oprettelse osv. Og samtidig følger alle strengt denne proces, og alt er i orden. Desværre er vi ikke i den situation, men det er ikke emnet for artiklen 🙂
Generelt blev der taget beslutning om at automatisere kontrollen af korrekt udfyldelse af felterne.
Vi besluttede, at en daglig e-mail med en liste over forkert udfyldte maskiner til alle ansvarlige ingeniører og deres chefer ville være en god begyndelse.
På dette tidspunkt havde en af kollegerne allerede implementeret et PowerShell-script, der dagligt samlede information om alle maskiner på alle vCenter'er og genererede 3 CSV-dokumenter (hver til sit eget vCenter), som blev gemt på den fælles disk. Der blev taget beslutning om at tage dette script som grundlag og supplere det med kontroller ved hjælp af R, som der var en smule erfaring med.
I processen voksede løsningen til at inkludere e-mail-udsendelser, en database med en hoved- og historisk tabel (om dette senere), samt analyse af vSphere-logs for at finde de faktiske skabere af VM'erne og tidspunkterne for deres oprettelse.
Der blev anvendt IDE'er RStudio Desktop og PowerShell ISE til udviklingen.
Scriptet kører fra en almindelig Windows virtuel maskine.
Beskrivelse af den overordnede logik.
Den overordnede logik for scripts viste sig at være som følger.
- Vi indsamler data om virtuelle maskiner ved hjælp af et PowerShell-script, som vi kalder fra R, og vi kombinerer resultaterne i en enkelt csv. Den omvendte interaktion mellem sprog er lavet på samme måde. (Det kunne have været muligt at sende data direkte fra R til PowerShell som variable, men det er kompliceret, og med mellemliggende csv er det lettere at debugge og dele mellemresultater med andre).
- Ved hjælp af R danner vi gyldige parametre for felterne, hvis værdier vi kontrollerer. — Vi danner et Word-dokument, der vil indeholde værdierne for disse felter til indsættelse i informationsbrevet, som vil være svaret på kollegaers spørgsmål "Men hvordan skal jeg udfylde dette?".
- Vi indlæser data om alle VM'er fra csv ved hjælp af R, danner et dataframe, fjerner unødvendige felter og danner et informations-xlsx-dokument, der vil indeholde en opsummering af alle VM'er, som vi lægger ud på en fælles ressource.
- Vi anvender alle verificeringer for korrekt udfyldning af felter på dataframe for alle VM'er og danner en tabel, der kun indeholder VM'er med forkert udfyldte felter (og kun disse felter).
- Den resulterende liste over VM'er sendes til et andet PowerShell-script, der vil kigge i vCenter-logfilerne for hændelser vedrørende oprettelse af VM'er, hvilket gør det muligt at angive det formodede oprettelsestidspunkt og den formodede opretter. Dette er i tilfælde af, at ingen vil indrømme, hvis maskine det er. Dette script kører ikke hurtigt, især hvis der er mange logs, derfor ser vi kun de sidste 2 uger, og vi bruger også et workflow, der tillader at søge information om flere VM'er samtidigt. I eksemplet på scriptet er der detaljerede kommentarer om denne mekanisme. Resultatet gemmes i csv, som vi igen indlæser i R.
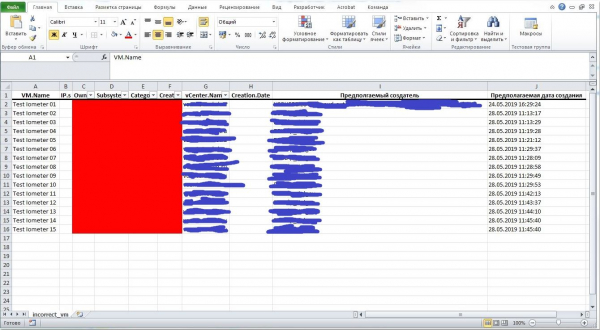
- Vi danner et flot formatteret xlsx-dokument, hvor forkert udfyldte felter er fremhævet med rød farve, der er anvendt filtre til nogle kolonner, samt yderligere kolonner, der indeholder formodede oprettere og oprettelsestidspunkt for VM'er.
- Vi opretter en e-mail, hvor vi vedhæfter et dokument, der beskriver de acceptable værdier for felterne samt en tabel med forkert udfyldte VM'er. I teksten angiver vi det samlede antal forkert oprettede VM'er, et link til den samlede ressource og et motiverende billede. Hvis der ikke er nogen forkert udfyldte VM'er, sender vi en anden e-mail med et mere glædeligt motiverende billede.
- Vi registrerer data for alle VM'er i SQL Server DB med hensyn til den implementerede mekanisme for historiske tabeller (en meget interessant mekanisme - som vi vil uddybe senere).
Selve scripts.
Hovedfilen med R-koden.
# Путь к рабочей директории (нужно для корректной работы через виндовый планировщик заданий)
setwd("C:ScriptsgetVm")
#### Подгружаем необходимые пакеты ####
library(tidyverse)
library(xlsx)
library(mailR)
library(rmarkdown)
##### Определяем пути к исходным файлам и другие переменные #####
source(file = "const.R", local = T, encoding = "utf-8")
# Проверяем существование файла со всеми ВМ и удаляем, если есть.
if (file.exists(filenameVmCreationRules)) {file.remove(filenameVmCreationRules)}
#### Создаём вордовский документ с допустимыми полями
render("VM_name_rules.Rmd",
output_format = word_document(),
output_file = filenameVmCreationRules)
# Проверяем существование файла со всеми ВМ и удаляем, если есть
if (file.exists(allVmXlsxPath)) {file.remove(allVmXlsxPath)}
#### Забираем данные по всем машинам через PowerShell скрипт. На выходе получим csv.
system(paste0("powershell -File ", getVmPsPath))
# Полный df
fullXslx_df <- allVmXlsxPath %>%
read.csv2(stringsAsFactors = FALSE)
# Tjekker for korrekt udfyldte felter
full_df <- fullXslx_df %>%
mutate(
# Først fjerner vi alle unødvendige mellemrum og tabulatorer, derefter tager vi hensyn til komma som separator, og tjekker for tilladte værdier,
isSubsystemCorrect = Subsystem %>%
gsub("[[:space:]]", "", .) %>%
str_split(., ",") %>%
map(function(x) (all(x %in% AllowedValues$Subsystem))) %>%
as.logical(),
isOwnerCorrect = Owner %in% AllowedValues$Owner,
isCategoryCorrect = Category %in% AllowedValues$Category,
isCreatorCorrect = (!is.na(Creator) & Creator != ''),
isCreation.DateCorrect = map(Creation.Date, IsDate)
)
# Tjekker for eksistensen af en fil med alle VM'er og sletter den, hvis den findes.
if (file.exists(filenameAll)) {file.remove(filenameAll)}
#### Opretter xslx fil med rapport ####
# Generelle data på et separat ark
full_df %>% write.xlsx(file=filenameAll,
sheetName=names[1],
col.names=TRUE,
row.names=FALSE,
append=FALSE)
#### Opretter xslx fil med forkert udfyldte felter ####
# Opretter df
incorrect_df <- full_df %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Creator,
Category,
Creation.Date,
isOwnerCorrect,
isSubsystemCorrect,
isCategoryCorrect,
isCreatorCorrect,
vCenter.Name) %>%
filter(isSubsystemCorrect == F |
isOwnerCorrect == F |
isCategoryCorrect == F |
isCreatorCorrect == F)
# Tjekker for eksistensen af en fil med alle VM'er og sletter den, hvis den findes.
if (file.exists(filenameIncVM)) {file.remove(filenameIncVM)}
# Gemmer listen over VM'er med udefinerede felter i csv
incorrect_df %>%
select(VM.Name) %>%
write_csv2(path = filenameIncVM, append = FALSE)
# Filtrerer til indsættelse i mail
incorrect_df_filtered <- incorrect_df %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Category,
Creator,
vCenter.Name,
Creation.Date
)
# Tæller antallet af rækker
numberOfRows <- nrow(incorrect_df)
#### Начало условия ####
# Дальше либо у нас есть неправильно заполненные поля, либо нет.
# Если есть - запускаем ещё один скрипт
if (numberOfRows > 0) {
# Tjekker for eksistensen af en fil med skabere og sletter den, hvis den findes.
if (file.exists(creatorsFilePath)) {file.remove(creatorsFilePath)}
# Kører PowerShell script, der finder skaberne af de fundne VM'er. På output får vi csv.
system(paste0("powershell -File ", getCreatorsPath))
# Læser filen med skaberne
creators_df <- creatorsFilePath %>%
read.csv2(stringsAsFactors = FALSE)
# Filtrerer til indsættelse i mail, tilføjer data fra tabellen med skaberne
incorrect_df_filtered <- incorrect_df_filtered %>%
select(VM.Name,
IP.s,
Owner,
Subsystem,
Category,
Creator,
vCenter.Name,
Creation.Date
) %>%
left_join(creators_df, by = "VM.Name") %>%
rename(`Antaget skaber` = CreatedBy,
`Antaget dato for oprettelse` = CreatedOn)
# Opretter mailens indhold
emailBody <- paste0(
'<html>
<h3>Goddag, kære kolleger.</h3>
<p>Den fulde opdaterede information om de virtuelle maskiner kan findes på disk H: her:<p>
<p>\server.ruVM', sourceFileFormat, '</p>
<p>Vedhæftet er en liste over VM med <strong>forkert udfyldte</strong> felter. I alt er der <strong>', numberOfRows,'</strong>.</p>
<p>Der er tilføjet 2 ekstra kolonner til tabellen. <strong>Formodet skaber</strong> og <strong>Formodet oprettelsesdato</strong>, som hentes fra vCenter-logfilerne de sidste 2 uger</p>
<p>Vi beder skaberne af maskinerne om at præcisere oplysningerne og udfylde felterne korrekt. Reglerne for udfyldning af felterne er også vedhæftet.</p>
<p><img src="data/meme.jpg"></p>
</html>'
)
# Tjekker om filen findes
if (file.exists(filenameIncorrect)) {file.remove(filenameIncorrect)}
# Danner en pæn tabel med formater osv.
source(file = "email.R", local = T, encoding = "utf-8")
#### Danner en mail med dårligt underskrevne maskiner ####
send.mail(from = emailParams$from,
to = emailParams$to,
subject = "VM med forkert udfyldte felter",
body = emailBody,
encoding = "utf-8",
html = TRUE,
inline = TRUE,
smtp = emailParams$smtpParams,
authenticate = TRUE,
send = TRUE,
attach.files = c(filenameIncorrect, filenameVmCreationRules),
debug = FALSE)
#### Dernæst følger blokken, hvis der ikke er problemer med VM ####
} else {
# Danner mailens indhold
emailBody <- paste0(
'<html>
<h3>Goddag, kære kolleger</h3>
<p>Den fulde opdaterede information om de virtuelle maskiner kan findes på disk H: her:<p>
<p>\server.ruVM', sourceFileFormat, '</p>
<p>Desuden er alle felter for VM korrekt udfyldt på nuværende tidspunkt</p>
<p><img src="data/meme_correct.jpg"></p>
</html>'
)
#### Danner en mail uden dårligt udfyldte VM ####
send.mail(from = emailParams$from,
to = emailParams$to,
subject = "Sammenfattende oplysninger",
body = emailBody,
encoding = "utf-8",
html = TRUE,
inline = TRUE,
smtp = emailParams$smtpParams,
authenticate = TRUE,
send = TRUE,
debug = FALSE)
}
####### Gemmer data i DB #####
source(file = "DB.R", local = T, encoding = "utf-8")
Scriptet til at hente listen over VM'er i PowerShell.
# Данные для подключения и другие переменные
$vCenterNames = @(
                    "vcenter01",
                    "vcenter02",
                    "vcenter03"
                    )
$vCenterUsername = "myusername"
$vCenterPassword = "mypassword"

$filename = "C:ScriptsgetVmdataallvmall-vm-$(get-date -f yyyy-MM-dd).csv"

$destinationSMB = "server.rumyfolder$vm"
$IP0=""
$IP1=""
$IP2=""
$IP3=""
$IP4=""
$IP5=""

# Подключение ко всем vCenter, что содержатся в переменной. Будет работать, если логин и пароль одинаковые (например, доменные)
Connect-VIServer -Server $vCenterNames -User $vCenterUsername -Password $vCenterPassword

write-host ""

# Создаём функцию с циклом по всем vCenter-ам
function Get-VMinventory {

# В этой переменной будет списко всех ВМ, как объектов
$AllVM = Get-VM | Sort Name
$cnt = $AllVM.Count
$count = 1

# Начинаем цикл по всем ВМ и собираем необходимые параметры каждого объекта
   foreach ($vm in $AllVM) {
   $StartTime = $(get-date)

     $IP0 = $vm.Guest.IPAddress[0]
     $IP1 = $vm.Guest.IPAddress[1]
     $IP2 = $vm.Guest.IPAddress[2]
     $IP3 = $vm.Guest.IPAddress[3]
     $IP4 = $vm.Guest.IPAddress[4]
     $IP5 = $vm.Guest.IPAddress[5]

     If ($IP0 -ne $null) {If ($IP0.Contains(":") -ne 0) {$IP0=""}}
     If ($IP1 -ne $null) {If ($IP1.Contains(":") -ne 0) {$IP1=""}}
     If ($IP2 -ne $null) {If ($IP2.Contains(":") -ne 0) {$IP2=""}}
     If ($IP3 -ne $null) {If ($IP3.Contains(":") -ne 0) {$IP3=""}}
     If ($IP4 -ne $null) {If ($IP4.Contains(":") -ne 0) {$IP4=""}}
     If ($IP5 -ne $null) {If ($IP5.Contains(":") -ne 0) {$IP5=""}}

     $cluster = $vm | Get-Cluster | Select-Object -ExpandProperty name
     $Bootime = $vm.ExtensionData.Runtime.BootTime
     $TotalHDDs = $vm.ProvisionedSpaceGB -as [int]
     $CreationDate = $vm.CustomFields.Item("CreationDate") -as [string]
     $Creator = $vm.CustomFields.Item("Creator") -as [string]
     $Category = $vm.CustomFields.Item("Category") -as [string]
     $Owner = $vm.CustomFields.Item("Owner") -as [string]
     $Subsystem = $vm.CustomFields.Item("Subsystem") -as [string]

     $IPS = $vm.CustomFields.Item("IP") -as [string]

     $vCPU = $vm.NumCpu
     $CorePerSocket = $vm.ExtensionData.config.hardware.NumCoresPerSocket
     $Sockets = $vCPU/$CorePerSocket

     $Id = $vm.Id.Split('-')[2] -as [int]

     # Собираем все параметры в один объект
     $Vmresult = New-Object PSObject
     $Vmresult | add-member -MemberType NoteProperty -Name "Id" -Value $Id
     $Vmresult | add-member -MemberType NoteProperty -Name "VM Name" -Value $vm.Name
     $Vmresult | add-member -MemberType NoteProperty -Name "Cluster" -Value $cluster
     $Vmresult | add-member -MemberType NoteProperty -Name "Esxi Host" -Value $VM.VMHost
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 1" -Value $IP0
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 2" -Value $IP1
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 3" -Value $IP2
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 4" -Value $IP3
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 5" -Value $IP4
     $Vmresult | add-member -MemberType NoteProperty -Name "IP Address 6" -Value $IP5
     $Vmresult | add-member -MemberType NoteProperty -Name "vCPU" -Value $vCPU
     $Vmresult | Add-Member -MemberType NoteProperty -Name "CPU Sockets" -Value $Sockets
     $Vmresult | Add-Member -MemberType NoteProperty -Name "Core per Socket" -Value $CorePerSocket
     $Vmresult | add-member -MemberType NoteProperty -Name "RAM (GB)" -Value $vm.MemoryGB
     $Vmresult | add-member -MemberType NoteProperty -Name "Total-HDD (GB)" -Value $TotalHDDs
     $Vmresult | add-member -MemberType NoteProperty -Name "Power State" -Value $vm.PowerState
     $Vmresult | add-member -MemberType NoteProperty -Name "OS" -Value $VM.ExtensionData.summary.config.guestfullname
     $Vmresult | Add-Member -MemberType NoteProperty -Name "Boot Time" -Value $Bootime
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Status" -Value $vm.ExtensionData.Guest.ToolsStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Version" -Value $vm.ExtensionData.Guest.ToolsVersion
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Version Status" -Value $vm.ExtensionData.Guest.ToolsVersionStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "VMTools Running Status" -Value $vm.ExtensionData.Guest.ToolsRunningStatus
     $Vmresult | add-member -MemberType NoteProperty -Name "Creation Date" -Value $CreationDate
     $Vmresult | add-member -MemberType NoteProperty -Name "Creator" -Value $Creator
     $Vmresult | add-member -MemberType NoteProperty -Name "Category" -Value $Category
     $Vmresult | add-member -MemberType NoteProperty -Name "Owner" -Value $Owner
     $Vmresult | add-member -MemberType NoteProperty -Name "Subsystem" -Value $Subsystem
     $Vmresult | add-member -MemberType NoteProperty -Name "IP's" -Value $IPS
     $Vmresult | add-member -MemberType NoteProperty -Name "vCenter Name" -Value $vm.Uid.Split('@')[1].Split(':')[0]

# Считаем общее и оставшееся время выполнения и выводим на экран результаты. Использовалось для тестирования, но по факту оказалось очень удобно.
     $elapsedTime = $(get-date) - $StartTime
     $totalTime = "{0:HH:mm:ss}" -f ([datetime]($elapsedTime.Ticks*($cnt - $count)))

     clear-host
     Write-Host "Processing" $count "from" $cnt
     Write-host "Progress:" ([math]::Round($count/$cnt*100, 2)) "%"
     Write-host "You have about " $totalTime "for cofee"
     Write-host ""

     $count++

# Выводим результат, чтобы цикл "знал" что является результатом выполнения одного прохода
     $Vmresult
   }

}

# Вызываем получившуюся функцию и сразу выгружаем результат в csv
$allVm = Get-VMinventory | Export-CSV -Path $filename -NoTypeInformation -UseCulture -Force

# Пытаемся выложить полученный файл в нужное нам место и, в случае ошибки, пишем лог.
try
    {
        Copy-Item $filename -Destination $destinationSMB -Force -ErrorAction SilentlyContinue
    }
catch
    {
        $error | Export-CSV -Path $filename".error" -NoTypeInformation -UseCulture -Force
    }
PowerShell-script, der udtrækker skaberne af virtuelle maskiner og datoerne for deres oprettelse fra logfilen.
# Путь к файлу, из которого будем доставать список VM
$VMfilePath = "C:ScriptsgetVmcreators_VMcreators_VM_$(get-date -f yyyy-MM-dd).csv"
# Путь к файлу, в который будем записывать результат
$filePath = "C:ScriptsgetVmdatacreatorscreators-$(get-date -f yyyy-MM-dd).csv"

# Создаём вокрфлоу
Workflow GetCreators-Wf
{
    # Параметры, которые можно будет передать при вызове скрипта
    param([string[]]$VMfilePath)

# Параметры, которые доступны только внутри workflow
$vCenterUsername = "myusername"
$vCenterPassword = "mypassword"
$daysToLook = 14
$start = (get-date).AddDays(-$daysToLook)
$finish = get-date
# Значения, которые будут вписаны в csv для машин, по которым не будет ничего найдено
$UnknownUser = "UNKNOWN"
$UnknownCreatedTime = "0000-00-00"

# Определяем параметры подключения и выводной файл, которые будут доступны во всём скрипте.
$vCenterNames = @(
                    "vcenter01",
                    "vcenter02",
                    "vcenter03"
                    )

# Получаем список VM из csv и загружаем соответствующие объекты
$list = Import-Csv $VMfilePath -UseCulture | select -ExpandProperty VM.Name

# Цикл, который будет выполняться параллельно (по 5 машин за раз)
foreach -parallel ($row in $list)
  {
    # Это скрипт, который видит только свои переменные и те, которые ему переданы через $Using
    InlineScript {

    # Время начала выполнения отдельного блока
        $StartTime = $(get-date)

        Write-Host ""
        Write-Host "Processing $Using:row started at $StartTime"
        Write-Host ""

        # Подключение оборачиваем в переменную, чтобы информация о нём не мешалась в консоли
        $con = Connect-VIServer -Server $Using:vCenterNames -User $Using:vCenterUsername -Password $Using:vCenterPassword

        # Получаем объект vm
        $vm = Get-VM -Name $Using:row

      # Ниже 2 одинаковые команды. Одна с фильтром по времени, вторая - без. Можно пользоваться тем,
      $Event = $vm | Get-VIEvent -Start $Using:start -Finish $Using:finish -Types Info | Where { $_.Gettype().Name -eq "VmBeingDeployedEvent" -or $_.Gettype().Name -eq "VmCreatedEvent" -or $_.Gettype().Name -eq "VmRegisteredEvent" -or $_.Gettype().Name -eq "VmClonedEvent"}
      # $Event = $vm | Get-VIEvent -Types Info | Where { $_.Gettype().Name -eq "VmBeingDeployedEvent" -or $_.Gettype().Name -eq "VmCreatedEvent" -or $_.Gettype().Name -eq "VmRegisteredEvent" -or $_.Gettype().Name -eq "VmClonedEvent"}

      # Заполняем параметры в зависимости от того, удалось ли в логах найти что-то
      If (($Event | Measure-Object).Count -eq 0){
         $User = $Using:UnknownUser
         $Created = $Using:UnknownCreatedTime
         $CreatedFormat = $Using:UnknownCreatedTime
      } Else {
         If ($Event.Username -eq "" -or $Event.Username -eq $null) {
            $User = $Using:UnknownUser
         } Else {
         $User = $Event.Username
         } # Else
            $CreatedFormat = $Event.CreatedTime
            # Один из коллег отдельно просил, чтобы время было в таком формате, поэтому дублируем его. А в БД пойдёт нормальный формат.
            $Created = $Event.CreatedTime.ToString('yyyy-MM-dd')
         } # Else

      Write-Host "Creator for $vm is $User. Creating object."

      # Создаём объект. Добавляем параметры.
      $Vmresult = New-Object PSObject
      $Vmresult | add-member -MemberType NoteProperty -Name "VM Name" -Value $vm.Name
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedBy" -Value $User
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedOn" -Value $CreatedFormat
      $Vmresult | add-member -MemberType NoteProperty -Name "CreatedOnFormat" -Value $Created
      # Выводим результаты
      $Vmresult

    } # Inline

} # ForEach

}

$Creators = GetCreators-Wf $VMfilePath
# Записываем результат в файл
$Creators | select 'VM Name', CreatedBy, CreatedOn | Export-Csv -Path $filePath -NoTypeInformation -UseCulture -Force

Write-Host "CSV generetion finisghed at $(get-date). PROFIT"
Biblioteket fortjener særskilt opmærksomhed. , som gjorde det muligt at formatere vedhæftningen til e-mailen, som ledelsen ønsker, i stedet for blot en csv-tabel.
Oprettelse af et flot xlsx-dokument med listen over forkert udfyldte maskiner.
# Создаём новую книгу
# Возможные значения : "xls" и "xlsx"
wb<-createWorkbook(type="xlsx")

# Стили для имён рядов и колонок в таблицах
TABLE_ROWNAMES_STYLE <- CellStyle(wb) + Font(wb, isBold=TRUE)
TABLE_COLNAMES_STYLE <- CellStyle(wb) + Font(wb, isBold=TRUE) +
  Alignment(wrapText=TRUE, horizontal="ALIGN_CENTER") +
  Border(color="black", position=c("TOP", "BOTTOM"),
         pen=c("BORDER_THIN", "BORDER_THICK"))

# Создаём новый лист
sheet <- createSheet(wb, sheetName = names[2])

# Добавляем таблицу
addDataFrame(incorrect_df_filtered,
             sheet, startRow=1, startColumn=1,  row.names=FALSE, byrow=FALSE,
             colnamesStyle = TABLE_COLNAMES_STYLE,
             rownamesStyle = TABLE_ROWNAMES_STYLE)

# Меняем ширину, чтобы форматирование было автоматическим
autoSizeColumn(sheet = sheet, colIndex=c(1:ncol(incorrect_df)))

# Добавляем фильтры
addAutoFilter(sheet, cellRange = "C1:G1")

# Определяем стиль
fo2 <- Fill(foregroundColor="red")
cs2 <- CellStyle(wb,
                 fill = fo2,
                 dataFormat = DataFormat("@"))

# Находим ряды с неверно заполненным полем Владельца и применяем к ним определённый стиль
rowsOwner <- getRows(sheet, rowIndex = (which(!incorrect_df$isOwnerCorrect) + 1))
cellsOwner <- getCells(rowsOwner, colIndex = which( colnames(incorrect_df_filtered) == "Owner" ))
lapply(names(cellsOwner), function(x) setCellStyle(cellsOwner[[x]], cs2))

# Находим ряды с неверно заполненным полем Подсистемы и применяем к ним определённый стиль
rowsSubsystem <- getRows(sheet, rowIndex = (which(!incorrect_df$isSubsystemCorrect) + 1))
cellsSubsystem <- getCells(rowsSubsystem, colIndex = which( colnames(incorrect_df_filtered) == "Subsystem" ))
lapply(names(cellsSubsystem), function(x) setCellStyle(cellsSubsystem[[x]], cs2))

# Аналогично по Категории
rowsCategory <- getRows(sheet, rowIndex = (which(!incorrect_df$isCategoryCorrect) + 1))
cellsCategory <- getCells(rowsCategory, colIndex = which( colnames(incorrect_df_filtered) == "Category" ))
lapply(names(cellsCategory), function(x) setCellStyle(cellsCategory[[x]], cs2))

# Создатель
rowsCreator <- getRows(sheet, rowIndex = (which(!incorrect_df$isCreatorCorrect) + 1))
cellsCreator <- getCells(rowsCreator, colIndex = which( colnames(incorrect_df_filtered) == "Creator" ))
lapply(names(cellsCreator), function(x) setCellStyle(cellsCreator[[x]], cs2))

# Сохраняем файл
saveWorkbook(wb, filenameIncorrect)
Det ser cirka sådan ud i output:
Der var også et interessant aspekt ved indstillingen af Windows-planlæggeren. Det var svært at finde de rigtige parametre for rettigheder og indstillinger, så alt kunne køre, som det skulle. Til sidst blev der fundet et R-bibliotek, der automatisk opretter en opgave til at køre et R-script og glemmer ikke logfilen. Derefter kan man manuelt justere opgaven.
Et stykke R-kode med to eksempler, som opretter en opgave i Windows-planlæggeren.
library(taskscheduleR)
myscript <- file.path(getwd(), "all_vm.R")

## Kør scriptet efter 62 sekunder
taskscheduler_create(taskname = "getAllVm", rscript = myscript,
                     schedule = "ONCE", starttime = format(Sys.time() + 62, "%H:%M"))

## Kør scriptet hver dag kl. 09:10
taskscheduler_create(taskname = "getAllVmDaily", rscript = myscript,
                     schedule = "WEEKLY",
                     days = c("MON", "TUE", "WED", "THU", "FRI"),
                     starttime = "02:00")

## Slet opgaver
taskscheduler_delete(taskname = "getAllVm")
taskscheduler_delete(taskname = "getAllVmDaily")

# Tjek logfilerne (de sidste 4 linjer)
tail(readLines("all_vm.log"), sep = "n", n = 4)
Separat om databasen.
Efter opsætningen af scriptet opstod der andre spørgsmål. For eksempel ønskede vi at finde datoen, hvor VM'en blev slettet, men loggene i vCenter var allerede blevet raderet. Da scriptet gemmer filer i en mappe hver dag og ikke renser (vi renser manuelt, når vi husker det), kan vi gennemgå de gamle filer og finde den første fil, hvor denne VM ikke er til stede. Men det er ikke helt optimalt.
Jeg havde lyst til at skabe en historisk database.
MS SQL SERVERs funktionalitet – systemversionerede tidsbestemte tabeller, kom mig til hjælp. De oversættes normalt til tidsbestemte (ikke tidsbestemte) tabeller.
Man kan læse mere detaljeret i .
Kort sagt – vi opretter en tabel, angiver at den skal være versioneret, og SQL Server opretter to ekstra datetime-kolonner i denne tabel (datoen for oprettelse af posten og datoen for slutningen af postens liv) samt en ekstra tabel, hvor ændringerne vil blive skrevet. Resultatet er, at vi får opdaterede oplysninger, og gennem enkle forespørgsler, hvis eksempler er givet i dokumentationen, kan vi se enten livscyklussen for en specifik virtuel maskine eller tilstanden for alle VM'er på et givent tidspunkt.
Set fra et ydeevnesynspunkt vil transaktionen for at skrive til hovedtabellen ikke være afsluttet, før transaktionen for at skrive til den tidsbestemte tabel er afsluttet. Det vil sige, at på tabeller med mange skriveoperationer skal denne funktionalitet implementeres med forsigtighed, men i vores tilfælde er det faktisk en ret god ting.
For at mekanismen kunne fungere korrekt, måtte jeg til R skrive en lille kodebid, som skulle sammenligne den nye tabel med dataene for alle VM'er med det, der opbevares i databasen og kun skrive de ændrede rækker til den. Koden er ikke særlig kompliceret, den bruger biblioteket compareDF, men den vil jeg også inkludere nedenfor.
R-kode for at skrive data til databasen
# Подцепляем пакеты
library(odbc)
library(compareDF)

# Формируем коннект
con <- dbConnect(odbc(),
                 Driver = "ODBC Driver 13 for SQL Server",
                 Server = DBParams$server,
                 Database = DBParams$database,
                 UID = DBParams$UID,
                 PWD = DBParams$PWD,
                 Port = 1433)

#### Проверяем есть ли таблица. Если нет - создаём. ####

if (!dbExistsTable(con, DBParams$TblName)) {
  #### Создаём таблицу ####
  create <- dbSendStatement(
    con,
    paste0(
      'CREATE TABLE ',
      DBParams$TblName,
      '(
    [Id] [int] NOT NULL PRIMARY KEY CLUSTERED,
    [VM.Name] [varchar](255) NULL,
    [Cluster] [varchar](255) NULL,
    [Esxi.Host] [varchar](255) NULL,
    [IP.Address.1] [varchar](255) NULL,
    [IP.Address.2] [varchar](255) NULL,
    [IP.Address.3] [varchar](255) NULL,
    [IP.Address.4] [varchar](255) NULL,
    [IP.Address.5] [varchar](255) NULL,
    [IP.Address.6] [varchar](255) NULL,
    [vCPU] [int] NULL,
    [CPU.Sockets] [int] NULL,
    [Core.per.Socket] [int] NULL,
    [RAM..GB.] [int] NULL,
    [Total.HDD..GB.] [int] NULL,
    [Power.State] [varchar](255) NULL,
    [OS] [varchar](255) NULL,
    [Boot.Time] [varchar](255) NULL,
    [VMTools.Status] [varchar](255) NULL,
    [VMTools.Version] [int] NULL,
    [VMTools.Version.Status] [varchar](255) NULL,
    [VMTools.Running.Status] [varchar](255) NULL,
    [Creation.Date] [varchar](255) NULL,
    [Creator] [varchar](255) NULL,
    [Category] [varchar](255) NULL,
    [Owner] [varchar](255) NULL,
    [Subsystem] [varchar](255) NULL,
    [IP.s] [varchar](255) NULL,
    [vCenter.Name] [varchar](255) NULL,
    DateFrom datetime2 GENERATED ALWAYS AS ROW START NOT NULL,
    DateTo datetime2 GENERATED ALWAYS AS ROW END NOT NULL,
    PERIOD FOR SYSTEM_TIME (DateFrom, DateTo)
        ) ON [PRIMARY]
        WITH (SYSTEM_VERSIONING = ON (HISTORY_TABLE = ', DBParams$TblHistName,'));'
    )
  )

  # Отправляем подготовленный запрос
  dbClearResult(create)

} # if

#### Начало работы с таблицей ####

# Обозначаем таблицу, с которой будем работать
allVM_db_con <- tbl(con, DBParams$TblName)

#### Сравниваем таблицы ####

# Собираем данные с таблицы (убираем служебные временные поля)
allVM_db <- allVM_db_con %>%
  select(c(-"DateTo", -"DateFrom")) %>%
  collect()

# Создаём таблицу со сравнением объектов. Сравниваем по Id
# Удалённые объекты там будут помечены через -, созданные через +, изменённые через - и +
ctable_VM <- fullXslx_df %>%
  compare_df(allVM_db,
             c("Id"))

#### Удаление строк ####

# Выдираем Id виртуалок, записи о которых надо удалить
remove_Id <- ctable_VM$comparison_df %>%
  filter(chng_type == "-") %>%
  select(Id)

# Проверяем, что есть записи (если записей нет - и удалять ничего не нужно)
if (remove_Id %>% nrow() > 0) {

  # Конструируем шаблон для запроса на удаление данных
  delete <- dbSendStatement(con,
                        paste0('
                               DELETE
                               FROM ',
                               DBParams$TblName,
                               ' WHERE "Id"=?
                               ') # paste
                        ) # send

  # Создаём запрос на удаление данных
  dbBind(delete, remove_Id)

  # Отправляем подготовленный запрос
  dbClearResult(delete)

} # if

#### Добавление строк ####

# Выделяем таблицу, содержащую строки, которые нужно добавить.
allVM_add <- ctable_VM$comparison_df %>%
  filter(chng_type == "+") %>%
  select(-chng_type)

# Проверяем, есть ли строки, которые нужно добавить и добавляем (если нет - не добавляем)
if (allVM_add %>% nrow() > 0) {
  # Пишем таблицу со всеми необходимыми данными
  dbWriteTable(con,
               DBParams$TblName,
               allVM_add,
               overwrite = FALSE,
               append = TRUE)

} # if

#### Не забываем сделать дисконнект ####
dbDisconnect(con)
I alt
Som et resultat af implementeringen af scriptet er ordene blevet opretholdt i flere måneder. Nogle gange dukker der forkert udfyldte VM'er op, men scriptet fungerer som en god påmindelse, og sjældent ender en VM på listen i to dage i træk.
Der blev også lavet en forberedelse til analyse af historiske data.
Det er klart, at meget af dette kan implementeres ikke 'hjemme', men med specialiseret software, men opgaven var interessant og, man kan sige, fakultativ.
R har endnu en gang vist sig at være et fantastisk universelt sprog, som ikke kun er velegnet til at løse statistiske opgaver, men også fungerer som et glimrende 'mellemled' mellem andre datakilder.
Kilde: habr.com
