

Artiklen fra Stitch Fix-teamet foreslår at bruge et klinisk forskningsmetode (non-inferiority trials) i marketing- og produkt A/B-tests. Denne metode er virkelig anvendelig, når vi tester en ny løsning, der har fordele, der ikke kan måles gennem testen.
Det simpleste eksempel er at reducere omkostningerne. For eksempel automatiserer vi processen til at booke den første lektion, men ønsker ikke at falde drastisk i den samlede konvertering. Eller vi tester ændringer, der er rettet mod én brugergruppe, mens vi holder øje med, at konverteringen i de andre grupper ikke falder for meget (når vi tester flere hypoteser, skal vi huske justeringer).
Valget af den rigtige non-inferiority grænse tilføjer ekstra sværhedsgrad på designstadiet af testen. Spørgsmålet om, hvordan man vælger Δ, bliver ikke særlig godt belyst i artiklen. Det virker som om, at dette valg ikke er helt gennemsigtigt i kliniske forsøg. Medicinpublikationer om non-inferiority rapporterer, at kun i halvdelen af publikationerne begrundes valg af grænse, og ofte er disse begrundelser uklare eller ikke detaljerede.
Under alle omstændigheder synes denne tilgang interessant, da den kan øge hastigheden af testningen ved at reducere den nødvendige stikprøvestørrelse, og dermed også hastigheden af beslutningstagningen. Darya Mukhina, produktanalytiker for mobilappen Skyeng.
Stitch Fix-teamet elsker at teste forskellige ting. Hele teknologisamfundet elsker grundlæggende at udføre tests. Hvilken version af hjemmesiden tiltrækker flere brugere – A eller B? Genererer version A af anbefalingsmodellen flere penge end version B? Næsten altid bruger vi den enkleste metode fra grundkurset i statistik til at verificere hypoteser:
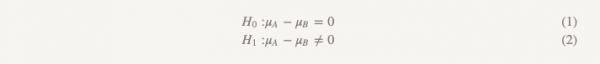
Selvom vi sjældent bruger denne betegnelse, kaldes denne form for test 'hypotese-test af overlegenhed'. Ved denne tilgang antager vi, at der ikke er nogen forskel mellem de to muligheder. Vi holder fast i denne idé og opgiver den kun, hvis de indsamlede data viser sig at være overbevisende nok til det - dvs. demonstrerer, at en af mulighederne (A eller B) er bedre end den anden.
Hypoteseundersøgelsen om overlegenhed passer til løsning af mange problemer. Vi udgiver B-versionen af anbefalingsmodellen kun, hvis den klart er bedre end den nuværende A-version. Men i nogle tilfælde fungerer denne tilgang ikke så godt. Lad os overveje nogle eksempler.
1) Vi bruger en tredjepartsservice, der hjælper med at identificere falske kreditkort. Vi har fundet en anden service, som koster betydeligt mindre. Hvis den billigere service fungerer lige så godt som den, vi bruger nu, vil vi vælge den. Den behøver ikke nødvendigvis at være bedre end den brugte service.
2) Vi ønsker at opgive datakilden A og erstatte den med datakilden B. Vi kunne udsætte opgivelsen af A, hvis B giver meget dårlige resultater, men det er ikke muligt at fortsætte med at bruge A.
3) Vi ønsker at skifte fra tilgangenA til tilgang B, ikke fordi vi forventer bedre resultater fra B, men fordi det giver os større operationel fleksibilitet. Vi har ingen grund til at tro, at B vil være dårligere, men vi vil ikke gennemføre overgangen, hvis det er tilfældet.
4) Vi har lavet nogle kvalitetsændringer i webstedets design (version B) og mener, at denne version overgår version A. Vi forventer ikke ændringer i konvertering eller nogen af de nøglepræstationsindikatorer, som vi normalt vurderer webstedet på. Men vi mener, at der er fordele i parametre, som enten er uhåndterlige, eller som vores teknologi ikke er i stand til at måle.
I alle disse tilfælde er undersøgelsen af overlegenhed ikke den mest passende løsning. Men de fleste specialister bruger det som standard i sådanne situationer. Vi udfører grundigt eksperimentet for korrekt at bestemme effektens størrelse. Hvis det var korrekt, at versionerne A og B fungerer meget ens, er der en risiko for, at vi ikke vil være i stand til at afvise nulhypotesen. Konkluderer vi, at A og B generelt fungerer ens? Nej! At vi ikke kan afvise nulhypotesen og at acceptere nulhypotesen er ikke det samme.
Beregning af stikprøvestørrelse (som du selvfølgelig har udført) udføres typisk med strengere grænser for type I-fejl (sandsynligheden for at forkaste nulhypotesen, ofte kaldet alpha) end for type II-fejl (sandsynligheden for ikke at forkaste nulhypotesen givet, at den er forkert, ofte kaldt beta). Den typiske værdi for alpha er 0,05, mens den typiske værdi for beta er 0,20, hvilket svarer til en statistisk styrke på 0,80. Det betyder, at vi med en sandsynlighed på 20% ikke kan opdage den egentlige effekt af den værdi, vi har angivet i vores styrkeberegninger, og dette er en ret alvorlig informationsmangel. Som eksempel kan vi overveje følgende hypoteser:
H0: min rygsæk ER IKKE i mit rum (3)
H1: min rygsæk er i mit rum (4)
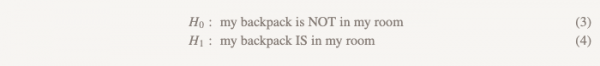
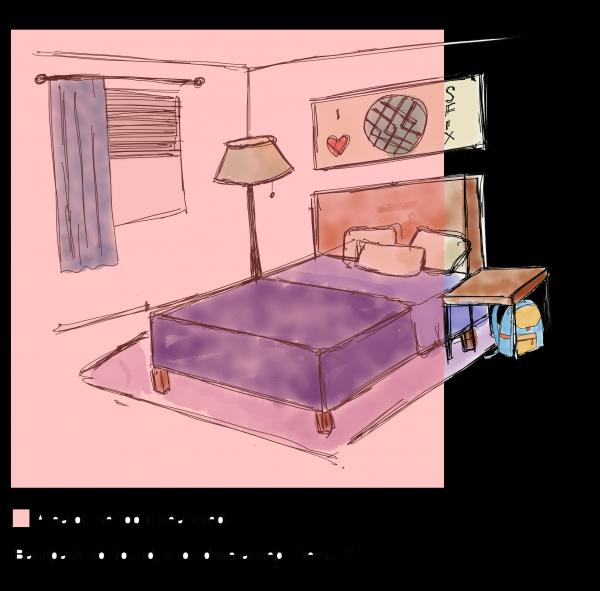
Hvis jeg har gennemsøgt mit rum og fundet min rygsæk — fantastically, jeg kan forkaste nulhypotesen. Men hvis jeg har kigget i rummet og ikke kunne finde min rygsæk (figur 1), hvilken konklusion skal jeg så drage? Er jeg sikker på, at den ikke er der? Har jeg kigget grundigt nok? Hvad hvis jeg kun har gennemsøgt 80% af rummet? At konkludere, at der bestemt ikke er nogen rygsæk i rummet, ville være en forhastet beslutning. Det er ikke overraskende, at vi ikke kan "acceptere nulhypotesen".
Området, vi har gennemsøgt
Vi fandt ikke rygsækken — skal vi acceptere nulhypotesen?
Figur 1. At gennemsøge 80% af rummet svarer omtrent til at gennemføre en undersøgelse med en styrke på 80%. Hvis du ikke fandt rygsækken ved at kigge i 80% af rummet, kan man så konkludere, at den ikke er der?
Så hvad skal dataeksperten gøre i denne situation? Du kan øge styrken af undersøgelsen betydeligt, men så skal du bruge en meget større stikprøve, og resultatet vil stadig være utilfredsstillende.
Heldigvis har lignende problemer været grundigt undersøgt inden for klinisk forskning. Lægemiddel B er billigere end lægemiddel A; lægemiddel B forventes at have færre bivirkninger end lægemiddel A; lægemiddel B er lettere at transportere, fordi det ikke skal opbevares i køleskab, mens lægemiddel A skal. Lad os teste hypotesen om ikke mindre effektivitet. Dette er nødvendigt for at vise, at version B er ligeså god som version A — i det mindste inden for en forudbestemt grænse for “ikke mindre effektivitet”, Δ. Senere vil vi se nærmere på, hvordan man fastsætter denne grænse. Men lad os nu antage, at dette er den minimale forskel, der er praktisk betydningsfuld (i konteksten af kliniske forsøg kaldes dette typisk klinisk betydning).
Hypoteser om ikke mindre effektivitet vender alt på hovedet:
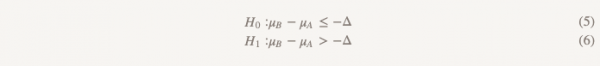
Nu antager vi i stedet, at version B er dårligere end version A, og vi vil holde fast ved denne antagelse, indtil vi demonstrerer, at det ikke er tilfældet. Det er netop her, at det giver mening at anvende en ensidet hypotese test! I praksis kan dette gøres ved at konstruere et konfidensinterval og bestemme, om intervallet faktisk er større end Δ (figur 2).
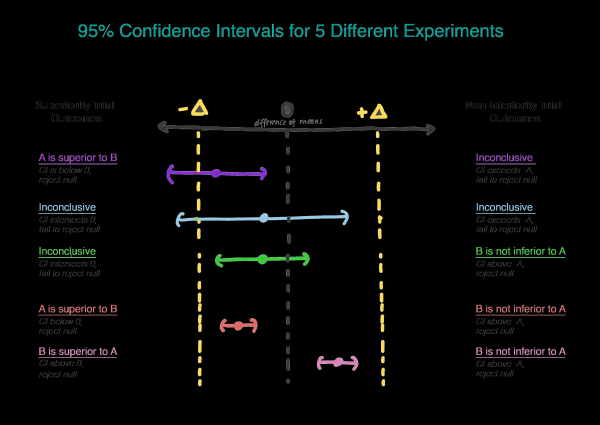
Valg af Δ
Hvordan vælger man korrekt Δ? Proces for valg af Δ inkluderer statistisk begrundelse og faglig vurdering. Inden for klinisk forskning findes der normative retningslinjer, der angiver, at delta bør repræsentere den mindste klinisk betydningsfulde forskel — en forskel der vil have betydning i praksis. Her er et citat fra det europæiske vejledning, som du kan bruge til at tjekke dig selv: «Hvis forskellen er valgt korrekt, er et konfidensinterval, der helt ligger mellem –∆ og 0…, stadig tilstrækkeligt til at demonstrere ikke mindre effektivitet. Hvis dette resultat ikke virker acceptabelt, betyder det, at ∆ ikke er blevet valgt korrekt.»
Delta må bestemt ikke overstige effekten af version A i forhold til den sande kontrol (placebo / mangel på behandling), da dette fører os til den konklusion, at version B er dårligere end den sande kontrol, samtidig med at den viser "ikke mindre effektivitet". Antag, at da version A blev præsenteret, var der på dens plads version 0, eller funktionen eksisterede slet ikke (se figur 3).
Fra resultaterne af hypotesetestningen af overlegenhed blev størrelsen af effekten E identificeret (det vil sige formodentlig μ^A−μ^0=E). Nu er A vores nye standard, og vi vil sikre os, at B ikke er ringere end A. En anden måde at skrive μB−μA≤−Δ (nulhypotese) er μB≤μA−Δ. Hvis vi antager, at det er lig med eller overstiger E, så μB ≤ μA−E ≤ placebo. Nu ser vi, at vores vurdering af μB fuldt ud overstiger μA−E, hvilket dermed fuldstændigt afviser nulhypotesen og tillader os at konkludere, at B ikke er ringere end A, men samtidig kan μB være ≤ μ placebo, og det er ikke det, vi ønsker. (figur 3).
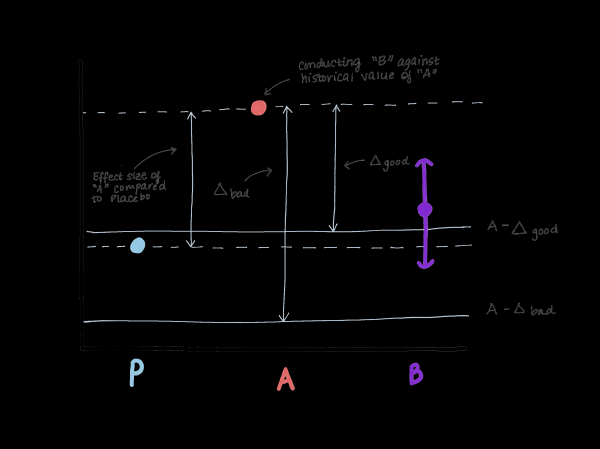
Figur 3. Demonstration af risici ved at vælge grænsen for ikke mindre effektivitet. Hvis grænsen er for høj, kan det konkluderes, at B ikke er ringere end A, men samtidig ikke adskiller sig fra placebo. Vi vil ikke ændre et lægemiddel, der klart er mere effektivt end placebo (A), til et lægemiddel, der har samme effektivitet som placebo.
Valg af α
Lad os gå videre til valget af α. Standardværdien α = 0,05 kan anvendes, men det er ikke helt retfærdigt. For eksempel når du køber noget online og bruger flere rabatkoder på én gang, selvom de ikke burde kumuleres — det var blot en fejl fra udviklerens side, og du kom godt fra det. Ifølge reglerne skal værdien af α være halvdelen af værdien af α, der bruges ved hypotesetestning af overlegenhed, det vil sige 0,05 / 2 = 0,025.
Størrelse af stikprøven
Hvordan vurderer man størrelsen af stikprøven? Hvis du mener, at den sande forskel i gennemsnit mellem A og B er lig med 0, så vil beregningen af stikprøvens størrelse være den samme som ved hypotesetestning af overlegenhed, bortset fra at du erstatter effektstørrelsen med grænsen for ikke mindre effektivitet, forudsat at du bruger α ikke mindre effektivitet = 1/2 α overlegenhed (αnon-inferiority=1/2αsuperiority). Hvis du har grund til at tro, at variant B måske er lidt dårligere end variant A, men du vil bevise, at den ikke er dårligere end Δ, så har du held! Faktisk reducerer dette størrelsen af din stikprøve, fordi det er lettere at demonstrere, at B er dårligere end A, hvis du faktisk mener, at den er lidt dårligere, og ikke lige så god.
Eksempel med beslutning
Lad os antage, at du ønsker at overgå til version B, under forudsætning af at den er dårligere end version A med ikke mere end 0,1 point på en 5-punkts skala for kundetilfredshed... Lad os nærme os denne opgave ved hjælp af hypotesen om overlegenhed.
For at teste hypotesen om overlegenhed ville vi beregne stikprøvestørrelsen på følgende måde:
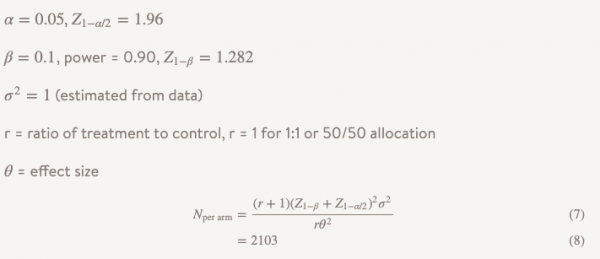
Så hvis du har 2103 observationer i din gruppe, kan du være 90 % sikker på, at du opfanger en effekt på 0,10 eller større. Men hvis 0,10 er for stort for dig, så er det måske ikke værd at teste hypotesen om overlegenhed for det. Måske beslutter du for pålidelighedens skyld at udføre en undersøgelse for en mindre effektstørrelse, f.eks. 0,05. I så fald ville du have brug for 8407 observationer, hvilket betyder, at stikprøven næsten vil stige med 4 gange. Men hvad hvis vi holder os til vores oprindelige stikprøvestørrelse, men øger styrken til 0,99, så vi ikke er i tvivl, hvis vi får et positivt resultat? I så fald vil n for én gruppe være 3676, hvilket allerede er bedre, men øger stikprøvestørrelsen med mere end 50 %. Og som følge heraf vil vi stadig ikke kunne afvise den nulhypotese, men ikke få et svar på vores spørgsmål.
Hvad hvis vi i stedet tester hypotesen om ikke mindre effektivitet?
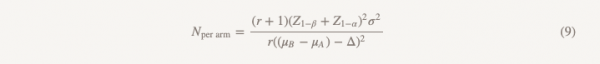
Stikprøvestørrelsen vil blive beregnet med samme formel, undtagen nævneren.
Forskellene fra formlen, der anvendes ved test af hypotesen om overlegenhed, er som følger:
— Z1−α/2 erstattes med Z1−α, men hvis du gør det hele korrekt, erstatter du α = 0,05 med α = 0,025, så det er det samme tal (1,96)
— nævneren får (μB−μA)
— θ (effektstørrelse) erstattes med Δ (grænse for ikke mindre effektivitet)
Hvis vi antager, at µB = µA, så er (µB − µA) = 0, og beregningen af stikprøvens størrelse for grænsen for ikke mindre effektivitet er præcist det, vi ville få ved at beregne overlegenhed for en effektstørrelse på 0,1, perfekt! Vi kan gennemføre en undersøgelse af samme omfang med forskellige hypoteser og en anden tilgang til konklusionerne, og vi vil få svar på det spørgsmål, vi reelt ønsker at besvare.
Lad os nu antage, at vi faktisk ikke mener, at µB = µA, og
tænker, at µB er lidt værre, måske med 0,01 enheder. Dette øger vores nævner, hvilket reducerer stikprøvestørrelsen for gruppen til 1737.
Hvad hvis version B faktisk er bedre end version A? Vi afviser nulhypotesen om, at B er værre end A med mere end Δ, og accepterer den alternative hypotese om, at B, hvis værre, ikke er værre end Δ, og muligvis er bedre. Prøv at inkludere denne konklusion i en tværfaglig præsentation og se, hvad der sker (seriøst, prøv). I en situation, hvor man skal tage hensyn til perspektivet, ønsker ingen at acceptere 'værre ikke mere end Δ og muligvis bedre'.
I dette tilfælde kan vi gennemføre en undersøgelse, der meget kort kaldes 'hypotese-testning af, at en af mulighederne overgår den anden eller er underlegen'. Den benytter to sæt hypoteser:
Det første sæt (det samme som ved hypotese-testning for ikke mindre effektivitet):
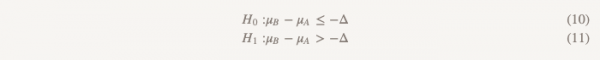
Det andet sæt (det samme som ved hypotese-testning for overlegenhed):
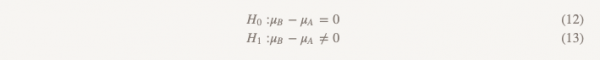
Vi tester den anden hypotese kun, hvis den første er afvist. Ved sekventiel testning bevarer vi den samlede fejltype I-niveau (α). I praksis kan dette opnås ved at skabe et 95 % konfidensinterval for forskellen mellem gennemsnittene og teste for at bestemme, om hele intervallet overstiger -Δ. Hvis intervallet ikke overstiger -Δ, kan vi ikke afvise nulhypotesen og stopper. Hvis hele intervallet faktisk overstiger -Δ, fortsætter vi og ser, om intervallet indeholder 0.
Der er en anden type undersøgelser, som vi ikke har diskuteret – ækvivalensundersøgelser.
Denne type forskning kan erstattes af forskning til at teste hypotesen om, at der ikke er nogen ringere effektivitet, og omvendt, men de har en vigtig forskel. Et forsøg på at teste hypotesen om, at der ikke er nogen ringere effektivitet, er designet til at vise, at variant B i det mindste er ligeså god som A. Forskning om ækvivalens har til formål at vise, at variant B i det mindste er ligeså god som A, og at variant A er ligeså god som B, hvilket er mere komplekst. I det væsentlige forsøger vi at bestemme, om hele konfidensintervallet for forskellen mellem gennemsnittene ligger mellem −Δ og Δ. Sådanne studier kræver en større stikprøvestørrelse og udføres sjældnere. Derfor, næste gang du laver et studie, hvor din hovedopgave er at sikre, at den nye version ikke er værre, så accepter ikke
Kilde: habr.com
