

For nylig blev der udgivet , som godt viser tendenserne inden for maskinlæring de seneste år. Kort sagt: Antallet af startups inden for maskinlæring er faldet dramatisk de seneste to år.
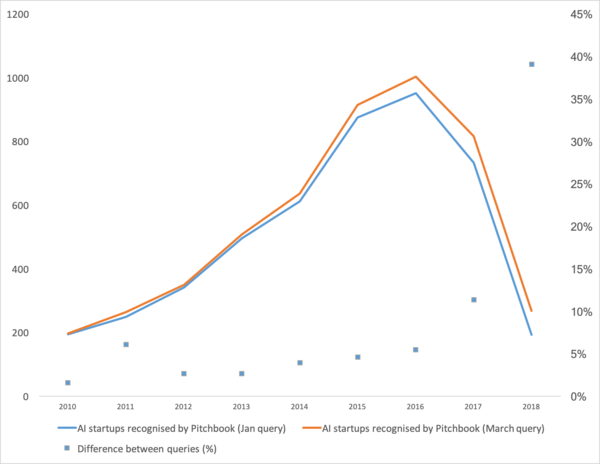
Nå, lad os tale om, "er boblen sprunget", "hvordan lever man videre" og diskutere, hvor denne mærkelige situation egentlig kommer fra.
Til at begynde med lad os tale om, hvad der var booster til denne kurve. Hvordan opstod den? Måske husker alle inden for maskinlæring i 2012 ved ImageNet-konkurrencen. Det var jo den første globale begivenhed! Men i virkeligheden er det ikke sådan. Og væksten i kurven begynder faktisk lidt tidligere. Jeg vil dele den op i flere punkter.
- Året 2008 markerede fremkomsten af termen “big data”. Rigtige produkter begyndte fra 2010. Big data er direkte relateret til maskinlæring. Uden big data er det umuligt at få stabil drift af de algoritmer, der eksisterede på det tidspunkt. Og det er ikke neurale netværk. Indtil 2012 var neurale netværk en sjældenhed for et marginalt mindretal. I stedet begyndte helt andre algoritmer at virke, som allerede havde eksisteret i år eller endda årtier: (1963, 1993) (1995), (2003),… Startups fra den tid var først og fremmest relateret til automatiseret behandling af strukturerede data: kasser, brugere, reklame, meget andet.
Afledningen af denne første bølge er et sæt rammeværk som XGBoost, CatBoost, LightGBM, osv.
- I 2011-2012 en række konkurrencer om billedgenkendelse. Den egentlige anvendelse af dem tog lidt tid. Jeg vil sige, at massivt meningsfulde startups og løsninger begyndte at dukke op fra 2014. Det tog to år at bearbejde, at neurale netværk faktisk fungerer, at lave bekvemme rammer, som kunne installeres og køres på rimelig tid, udvikle metoder, der stabiliserede og accelererede konvergensens tid.
Convolutional netværk tillod at løse opgaver inden for maskinsyn: klassificering af billeder og objekter på billeder, objektgenkendelse, genkendelse af objekter og mennesker, forbedring af billeder, osv.
- 2015-2017. Boom af algoritmer og projekter relateret til tilbagevendende netværk eller deres analoger (LSTM, GRU, TransformerNet osv.). Der kom effektive algoritmer til "tale-til-tekst", maskinoversættelsessystemer. Delvist baseret på konvolutionelle netværk til at udtrække grundlæggende funktioner. Delvist på hvad vi har lært om at samle virkelig store og gode datasæt.
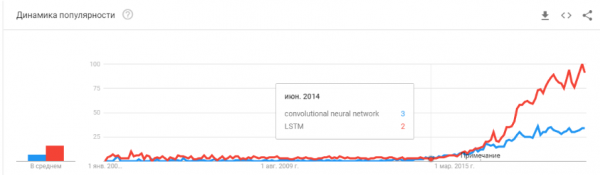
"Sprænger boblen? Er hypen overophedet? Er de døde som blockchain?"
Akkurat! I morgen holder Siri op med at fungere på din telefon, og dagen efter vil Tesla ikke kunne skelne mellem en drejning og et kænguru.
Neurale netværk arbejder allerede. De er i mange enheder. De gør det faktisk muligt at tjene penge, ændrer markedet og den omgivende verden. Hypen ser lidt anderledes ud:
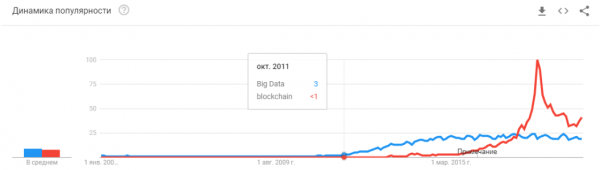
Neurale netværk er bare ikke længere noget nyt. Ja, mange mennesker har urealistiske forventninger. Men et stort antal virksomheder har lært at anvende neurale netværk og lave produkter baseret på dem. Neurale netværk giver nye funktioner, muliggør reduktion i arbejdspladser og sænker omkostninger:
- Produktionsvirksomheder integrerer algoritmer til fejlanalyse på samlebåndet.
- Landbrugsbedrifter køber systemer til overvågning af kvæg.
- Automatiske høstmaskiner.
- Automatiserede callcentre.
- Filtre i SnapChat. (nå, mindst noget nyttigt!)
Men vigtigst, og ikke så åbenlyst: "Der er ingen nye ideer, eller de vil ikke generere øjeblikkelig kapital." Neurale netværk har løst mange problemer. Og vil løse endnu flere. Alle de åbenlyse ideer, der var – har givet anledning til mange startups. Men alt det, der var på overfladen – er allerede blevet indsamlet. I de sidste to år har jeg ikke mødt nogen nye idéer til anvendelse af neurale netværk. Ingen nye tilgange (nå, okay, der er lidt rod med GAN'er).
Og hver næste startup bliver mere og mere kompleks. Den kræver ikke længere to fyre, der træner et neuralt netværk på åbne data. Den kræver programmører, servere, et team af annotatorer, kompliceret support osv.
Som resultat bliver der færre startups. Men produktionen stiger. Er der behov for at tilføje genkendelse af nummerplader? Der er hundrede specialister på markedet med relevant erfaring. Du kan hyre nogen, og på nogle måneder vil din medarbejder skabe systemet. Eller købe et færdigt. Men at lave en ny startup?.. Vanvid!
Det er nødvendigt at lave et system til sporing af besøgende - hvorfor betale for en masse licenser, når man kan lave sin egen tilpassede løsning på 3-4 måneder?
Nu gennemgår neurale netværk den samme udvikling, som mange andre teknologier har gjort før.
Husker du, hvordan begrebet 'webudvikler' har ændret sig siden 1995? Indtil markedet er mættet med specialister. Der er meget få professionelle. Men jeg vil påstå, at om 5-10 år vil der ikke være meget forskel mellem en Java-programmør og en udvikler af neurale netværk. Der vil være tilstrækkeligt med specialister inden for begge områder.
Der vil blot opstå en række opgaver, som neurale netværk kan løse. Når en opgave opstår, ansætter man en specialist.
"Og hvad så? Hvor er den lovede kunstige intelligens?"
Her er der en lille, men interessant uklarhed :)
Den teknologistak, som vi har i dag, fører os ikke til kunstig intelligens. Idéer og deres nyhed er i høj grad udtømte. Lad os tale om, hvad der holder det nuværende niveau af udvikling tilbage.
Begrænsninger
Lad os starte med selvkørende biler. Det virker som om, det er muligt at lave fuldt autonome biler med de nuværende teknologier. Men hvor mange år vil det tage, før det sker? Tesla mener, det vil ske om et par år -
Der er mange andre , som vurderer det til at tage 5-10 år.
Sandsynligvis, efter min mening, vil infrastrukturen i byerne om cirka 15 år ændre sig, så fremkomsten af autonome biler bliver uundgåelig, og de vil blive en del af infrastrukturen. Men det kan jo ikke anses for at være intelligens. Den moderne Tesla er en meget kompleks samling af datafiltering, -søgning og -genuddannelse. Det er regler-regler-regler, dataindsamling og filtre over dem (her har jeg skrevet lidt mere om det, eller se med markeringen).
Det første problem
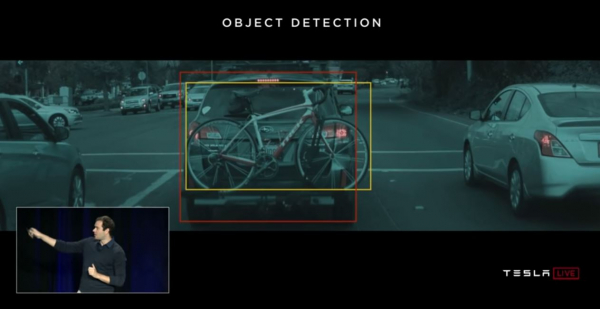
Og netop her ser vi det første fundamentale problem. Store data. Det er netop det, der har skabt den nuværende bølge af neurale netværk og maskinlæring. I dag kræver det at lave noget komplekst og automatiseret mange data. Ikke bare mange, men rigtig, rigtig mange. Der er behov for automatiserede algoritmer til indsamling, mærkning, og anvendelse af dem. Hvis vi ønsker, at maskinen skal kunne se lastbiler mod solen, skal vi først indsamle et tilstrækkeligt antal. Hvis vi vil have, at maskinen ikke skal blive forstyrret af en cykel fastgjort til bagagerummet, kræver det flere prøver.
Og én enkelt eksempel er ikke nok. Hundredvis? Tusinder?
Det andet problem
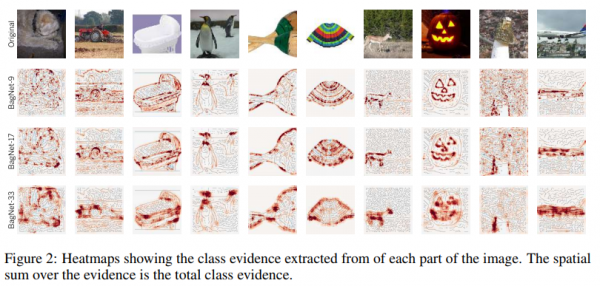
Det andet problem — visualisering af hvad vores neurale netværk har forstået. Det er en meget kompleks opgave. Indtil nu er der få, der forstår, hvordan man visualiserer det. Disse artikler er temmelig friske, og her er blot nogle få eksempler, selvom de er lidt fjerne:
affektion ved teksturer. Viser godt, hvad neuralt netværk har tendens til at fokusere på + hvad det opfatter som startinformation.
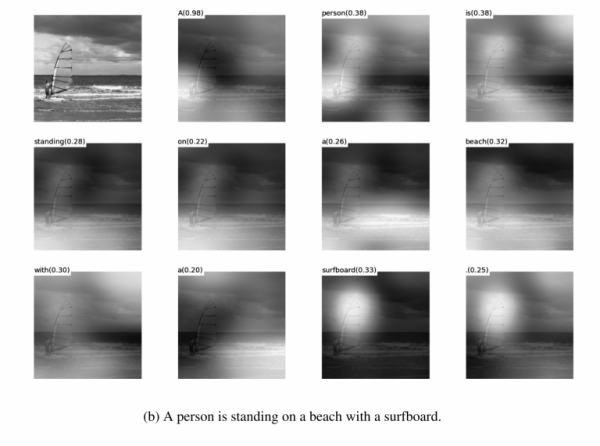
opmærksomhed ved . Faktisk kan opmærksomhed ofte bruges netop til at vise, hvad der har forårsaget den reaktion i netværket. Jeg har set sådanne ting både til debugging og produktløsninger. Der er mange artikler om dette emne. Men jo mere komplekse dataene er, jo sværere er det at forstå, hvordan man opnår en stabil visualisering.
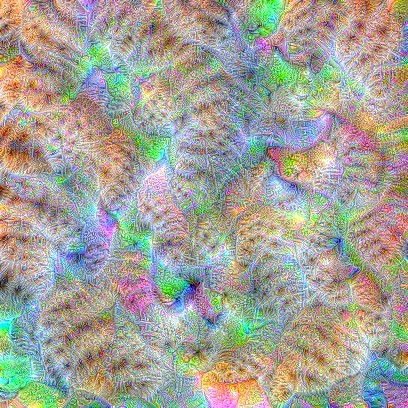
Og ja, det gamle klassiske sæt fra "se ind i nettet i ". Disse billeder var populære for 3-4 år siden, men alle indså hurtigt, at billederne er flotte, men ikke meget meningsfulde.
Jeg nævnte ikke mange andre tricks, metoder, hacks og undersøgelser om, hvordan man viser netværkets indre. Fungerer disse værktøjer? Hjælper de med hurtigt at forstå, hvad problemet er og debugge netværket?.. At få de sidste procenter ud? Tja, omtrent sådan her:
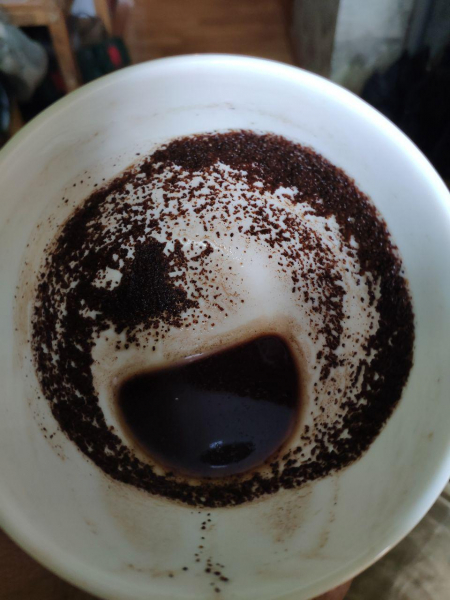
Du kan kigge på en hvilken som helst konkurrence på Kaggle. Og beskrivelsen af, hvordan folk laver de endelige løsninger. Vi har bygget 100-500-800 millioner modeller, og det har virket!
Jeg overdriver selvfølgelig. Men hurtige og direkte svar får man ikke fra disse tilgange.
Med tilstrækkelig erfaring og ved at afprøve forskellige muligheder kan man danne sig et billede af, hvorfor dit system træf en sådan beslutning. Men at justere systemets adfærd vil være svært. At sætte en nødløsning, flytte tærsklen, tilføje et datasæt, tage en anden backend-netværk.
Det tredje problem
Det tredje grundlæggende problem — netværk lærer ikke logik, men statistik. Statistikvis er det :
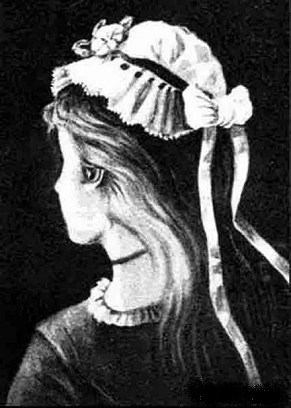
Logisk set — det ligner ikke meget. Neurale netværk lærer ikke noget komplekst, medmindre de presses. De lærer altid de mest grundlæggende træk. Er der øjne, næse, hoved? Så er det et ansigt! Ellers kom med et eksempel, hvor øjne ikke betyder ansigt. Og igen — millioner af eksempler.
Der er meget plads i bunden
Jeg vil sige, at det netop er disse tre globale problemer, der i dag begrænser udviklingen af neurale netværk og maskinlæring. Og der hvor disse problemer ikke begrænsede — det bruges allerede aktivt.
Er det slutningen? Er neurale netværk stagneret?
Uvisse. Men selvfølgelig håber alle, at det ikke er tilfældet.
Der er mange tilgange og retninger til at løse de grundlæggende problemer, som jeg har belyst ovenfor. Men indtil videre har ingen af disse tilgange tilladt os at skabe noget fundamentalt nyt, løse noget, der endnu ikke er blevet løst. Indtil videre udvikles alle fundamentale projekter på basis af stabile tilgange (Tesla) eller forbliver testprojekter fra institutioner eller virksomheder (Google Brain, OpenAI).
Hvis vi taler groft, er det primære fokus — at skabe en eller anden høj-niveau repræsentation af inddata. På en måde som “hukommelse”. Det simpleste eksempel på hukommelse er forskellige “Embedding” — repræsentationer af billeder. For eksempel, alle ansigtsgenkendelsessystemer. Netværket lærer at få en stabil repræsentation ud fra ansigtet, som ikke afhænger af drejning, belysning, eller opløsning. I bund og grund minimerer netværket metrikken “forskellige ansigt — langt væk” og “ens — tæt på”.
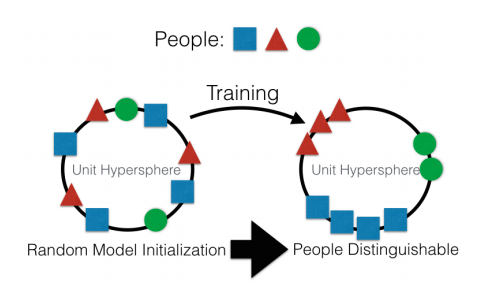
For denne type læring er der brug for titusindvis og hundrede tusinder af eksempler. Men resultatet bærer nogle spirer af “One-shot Learning”. Nu er vi ikke længere nødt til at have hundredvis af ansigt for at huske en person. Bare ét ansigt, og det er det — vi !
Men der er et lille problem… Netværket kan kun lære ret enkle objekter. Når man prøver at skelne ikke ansigt, men for eksempel “mennesker efter tøj” (opgaven ) — kvaliteten falder mange ordrer. Og netværket kan allerede ikke lære klare ændringer i perspektiv.
Og at lære på millioner af eksempler — også på en måde en skuffende underholdning.
Der er arbejde med betydelig reduktion af valg. For eksempel kan jeg straks huske et af de første arbejder inden for OneShot Learning :
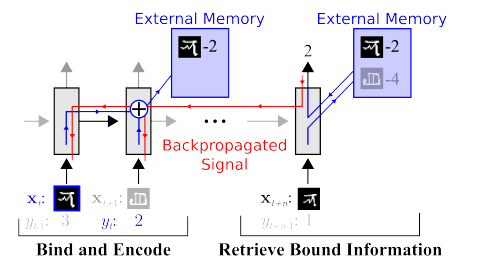
Der er mange sådanne arbejder, for eksempel eller eller .
En ulempe er, at træning ofte fungerer godt med enkle, 'MNIST'-eksempler. Men når man bevæger sig til mere komplekse opgaver, kræver det en stor database, en model til objekter eller en form for magi.
Generelt set er arbejdet med One-Shot træning et meget interessant emne. Man finder mange ideer, men de to problemer, jeg nævnte (foruddannelse på et enormt datasæt / ustabilitet på komplekse data), hæmmer træningen betydeligt.
På den anden side passer GAN - generative modstridende netværk - godt til emnet Embedding. Du har sikkert læst mange artikler om dette emne på Habr., ,)
En særpræg ved GAN er dannelsen af et internt tilstandsrum (i virkeligheden det samme som Embedding), som gør det muligt at tegne et billede. Dette kan være , det kan også være .
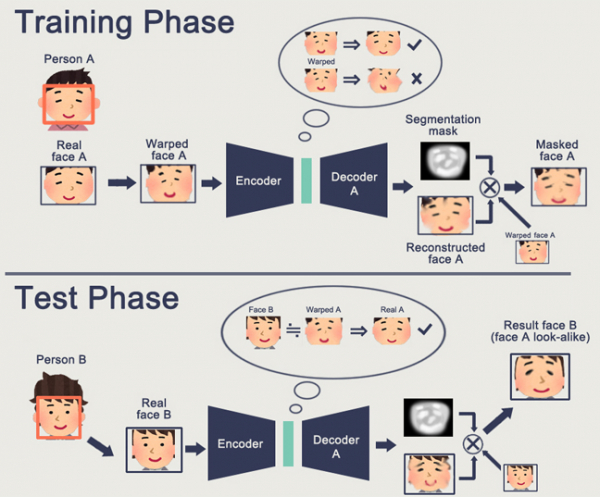
Problemet med GAN er, at jo mere kompleks det genererede objekt er, desto sværere er det at beskrive det i logikken 'generator-diskriminator'. Som et resultat er de eneste reelle anvendelser af GAN, som folk kender, kun DeepFake, som igen manipulerer billeder af ansigtstræk (for hvilke der eksisterer store databaser).
Andre nyttige anvendelser har jeg set meget lidt af. Typisk er det nogle gadgets, der tilføjer noget til billeder.
Og igen, ingen har forståelse for, hvordan det kan føre os ind i en lysere fremtid. Præsentationen af logik/rummet i et neuralt netværk er godt, men det kræver et enormt antal eksempler. Vi forstår ikke, hvordan neuronet repræsenterer dette, vi forstår ikke, hvordan vi får neuronet til at huske en reelt kompleks repræsentation.
Forstærkningslæring er en tilgang fra en helt anden vinkel. Du husker sikkert, hvordan Google besejrede alle i Go. De seneste sejre i Starcraft og Dota. Men her er alt langt fra så lovende og optimistisk. Det bedste, der beskriver RL og dets udfordringer, er .
Hvis jeg kort opsummerer, hvad forfatteren skrev:
- Modellerne fra kassen er ikke egnede / fungerer dårligt i de fleste tilfælde
- Praktiske opgaver kan bedre løses på andre måder. Boston Dynamics bruger ikke RL på grund af dets kompleksitet / uforudsigelighed / beregningsbesvær.
- For at RL skal fungere, kræves en kompleks funktion. Ofte er det svært at skabe / skrive.
- Det er vanskeligt at træne modeller. Man er nødt til at bruge masser af tid på at justere og frigøre sig fra lokale optimum.
- Som følge heraf er det svært at reproducere modellen, og modellen er ustabil ved de mindste ændringer.
- Det overfitter ofte på tilfældige mønstre, selv helt ned til en tilfældig talgenerator
Det centrale punkt er, at RL endnu ikke fungerer i produktionen. Google har nogle eksperimenter ( , ). Men jeg har ikke set noget produktionssystem.
Hukommelse. Ulempen ved alt det, der er beskrevet ovenfor, er ustrukturerethed. En af de metoder, man prøver at håndtere det på, er at give det neurale netværk adgang til separat hukommelse. Så det kan registrere og omskrive resultaterne af sine skridt der. Så kan det neurale netværk bestemmes af den nuværende tilstand af hukommelsen. Dette minder meget om klassiske processorer og computere.
Det mest kendte og populære — fra DeepMind:
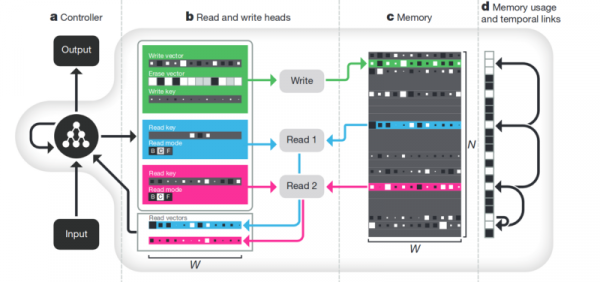
Det virker som om, her er nøglen til forståelsen af intelligens? Men sandsynligvis ikke. Systemet kræver stadig et enormt datagrundlag til træning. Og det fungerer for det meste med strukturerede tabeldata. På samme tid, da Facebook et lignende problem, så valgte de vejen "glem hukommelsen, lad os bare gøre neurala netværket mere kompleks, og få flere eksempler — og det lærer selv."
Disentanglement. En anden måde at skabe betydningsfuld hukommelse på er at tage de samme indlæringsrepræsentationer, men indføre yderligere kriterier i træningen, som ville gøre det muligt at udtrække "meninger" fra dem. For eksempel, hvis vi ønsker at træne et neuralt netværk til at adskille en persons adfærd i en butik. Hvis vi skulle følge den traditionelle vej — skulle vi lave et dusin netværk. Én søger efter personen, en anden bestemmer hvad de gør, den tredje deres alder, den fjerde — køn. En separat logik ser på den del af butikken, hvor de er, og træner på det. Den tredje bestemmer deres bane, osv.
Eller, hvis der var uendeligt mange data, kunne man træne ét netværk til alle mulige udfald (det er tydeligt, at det ikke er muligt at indsamle så store datamængder).
Disentanglement-tilgangen siger os — lad os træne netværket, så det selv kan skelne mellem begreber. Så det ved hjælp af video kan danne en indlæringsrepræsentation, hvor et område bestemmer handlingen, et andet — positionen på gulvet i tid, et andet — en persons højde, og et andet — deres køn. Ved træningen ville det være ønskeligt næsten ikke at give netværket sådanne nøglebegreber, men at det selv skulle udvælge og gruppere områder. Der findes ikke mange sådanne artikler (nogle af dem , , ) og generelt er de ret teoretiske.
Men denne retning bør, i det mindste teoretisk, adressere de nævnte problemer.
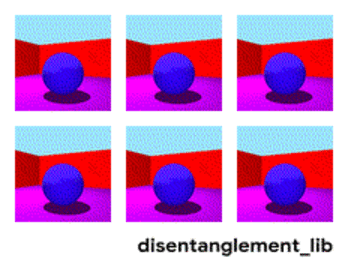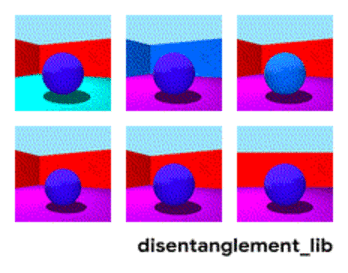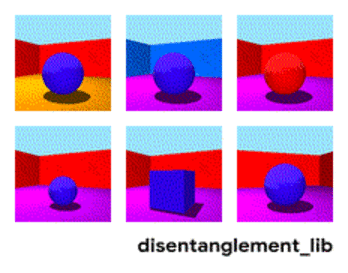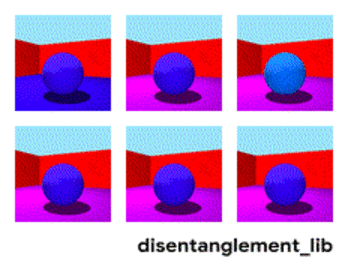
Opdeling af billedet efter parametre "vægfarve/vægfarve/objektform/objektfarve/osv."
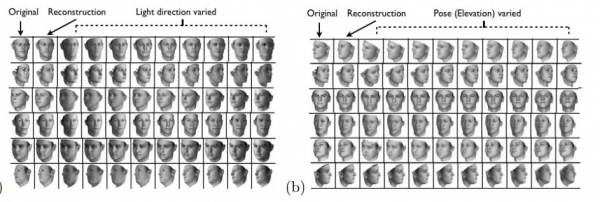
Opdeling af ansigtet efter parametre "størrelse, øjenbryn, orientering, hudfarve, osv."
Andet
Der er mange andre, ikke så globale retninger, der på en eller anden måde kan reducere databaser, arbejde med mere heterogene data osv.
Attention. Det giver nok ikke mening at fremhæve dette som en særskilt metode. Det er blot en tilgang, der styrker de andre. Der er mange artikler dedikeret til det (,,). Meningen med Attention er at forstærke netværkets reaktion på relevante objekter under træning, ofte med et eller andet ekstern målrettethed eller et lille eksternt netværk.
3D-simulering. Hvis man laver en god 3D-motor, kan man ofte dække 90% af træningsdataene (jeg har endda set et eksempel, hvor næsten 99% af dataene blev dækket af en god motor). Der er mange idéer og hacks til, hvordan man får et netværk, der er trænet på en 3D-motor, til at fungere med reelle data (Fine tuning, style transfer osv.). Men det er ofte meget sværere at lave en god motor end at indsamle data. Eksempler på, hvornår de har lavet motorer:
Træning af robotter (, )
Uddannelse varer i butikken (men i to projekter, som vi lavede, kunne vi nemt klare os uden dette).
Træning hos Tesla (igen det video, der blev nævnt ovenfor).
Konklusioner
Hele artiklen er på en eller anden måde konklusioner. Den vigtigste pointe, jeg ønskede at gøre, er - "gratis tider er forbi, neurale netværk giver ikke længere simple løsninger." Nu skal man arbejde hårdt for at bygge komplekse løsninger. Eller arbejde hårdt med komplekse videnskabelige undersøgelser.
Generelt er emnet diskuterbart. Måske har læserne mere interessante eksempler?
Kilde: habr.com
