

Forskning og udvikling er måske den mest interessante del af vores uddannelse. Ideen er at prøve sig af i det valgte område allerede på universitetet. For eksempel går studerende fra Software Engineering og Machine Learning ofte ud for at udføre forsknings- og udviklingsprojekter i virksomheder (primært JetBrains eller Yandex, men ikke kun).
I dette indlæg vil jeg fortælle om mit projekt inden for Computer Science. I forbindelse med arbejdet har jeg studeret og praktisk implementeret tilgange til at løse et af de mest kendte NP-svære problemer: vertex cover-problemet.
Der udvikles i øjeblikket hurtigt en interessant tilgang til NP-svære problemer - parametriserede algoritmer. Jeg vil prøve at introducere dig til emnet, fortælle om et par simple parametriserede algoritmer og beskrive en kraftfuld metode, der har hjulpet mig meget. Jeg præsenterede mine resultater ved PACE Challenge-konkurrencen: efter de åbne tests ligger min løsning på tredje plads, og de endelige resultater vil blive kendt den 1. juli.
Om mig
Mit navn er Vasilij Alferov, jeg er i øjeblikket ved at afslutte mit tredje år på National Research University Higher School of Economics - St. Petersburg. Jeg har været interesseret i algoritmer siden mine skoleår, da jeg gik i Moskvas 179. skole og aktivt deltog i informatikolympiader.
Et begrænset antal specialister i parametriserede algoritmer går ind i en bar...
Eksemplet er taget fra bogen
Forestil dig, at du er sikkerhedsvagt i en bar i en lille by. Hver fredag kommer halvdelen af byen ind i din bar for at slappe af, hvilket giver dig en del hovedpine: du skal smide de voldelige gæster ud for at undgå slagsmål. Til sidst bliver du træt af det og beslutter dig for at tage forebyggende foranstaltninger.
Da byen er lille, ved du præcist, hvilke par gæster der med stor sandsynlighed vil komme i slagsmål, hvis de er i baren sammen. Du har en liste over n gæster, der kommer i aften til baren. Du beslutter dig for ikke at lade nogen lokale gå ind i baren, så ingen kommer i slagsmål. Samtidig ønsker dit lederskab ikke at miste indtægt og vil ikke være tilfredse, hvis du ikke lader flere end k gæster gå ind.
Desværre er opgaven, du står overfor, et klassisk NP-hårdt problem. Du har måske kendskab til det som , or how to solve the vertex cover problem. For such problems, there are generally no algorithms that work in a reasonable time. To be precise, the unproven and fairly strong hypothesis ETH (Exponential Time Hypothesis) suggests that this problem cannot be solved in time  , meaning that nothing significantly better than brute force can be invented. For example, let's say that a total of n = 1000 people are planning to come to your bar. Then, brute forcing leads to
 combinations, which is approximately
 — an incredibly large number. Fortunately, your management has set a limit of k = 10, so the number of combinations you need to consider is much smaller: the number of subsets of ten elements is equal to
 . This is already better, but still can't be counted in a day even on a powerful cluster.
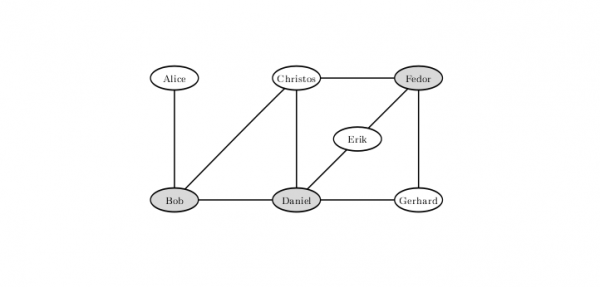
To avoid potential fights in such a tense relationship among the bar visitors, you need to exclude Bob, Daniel, and Fyodor. There is no solution where only two are left outside.
Does this mean it's time to give up and let everyone in? Let's consider other options. For example, you could not let in those who are likely to fight with a very large number of people. If someone can fight with at least k + 1 other individuals, then they definitely shouldn't be allowed in — otherwise, you'll have to turn away all k + 1 the townsfolk they could potentially fight with, which would definitely upset management.
Suppose you've thrown out everyone you could based on this principle. Then all the rest can fight with no more than k people. By removing k individuals from them, you can prevent at most  conflicts. Thus, if more than
 people are involved in at least one conflict, you definitely won’t be able to prevent them all. Since, obviously, the completely non-conflictual people will definitely be let in, you need to consider all subsets of size ten from the two hundred people. There are approximately
 , and such a number of operations can be handled on a cluster.
Hvis man sikkert kan tage helt konfliktfrie personer, hvad med dem, der kun deltager i én konflikt? Faktisk kan vi også lukke dem ind, mens vi lukker døren for deres modstander. Og sandt, hvis Alice kun har konflikt med Bob, så hvis vi lukker Alice ind af de to, taber vi ikke: Bob kan have andre konflikter, men Alice har bestemt ikke. Desuden giver det ikke mening at holde begge ude. Efter sådanne operationer er der ikke mere  gæster med uafklaret skæbne: vi har i alt
 konflikter, hver med to deltagere, og hver deltager i mindst to. Så det er kun nødvendigt at gennemgå
 muligheder, hvilket rimeligt kan gøres på en halvdag med en bærbar computer.
I virkeligheden kan man med enkle overvejelser opnå endnu mere attraktive betingelser. Bemærk, at vi nødvendigvis skal løse alle tvister, altså fra hver konfliktfugerende par vælge mindst én person, som vi ikke lukker ind. Lad os overveje en sådan algoritme: vi tager enhver konflikt, fjerner én deltager og starter rekurserende fra resten, derefter fjerner vi den anden og starter også rekurserende. Da vi fjerner nogen på hvert trin, er rekursionstræet for en sådan algoritme et binært træ i dybden k, så samlet set arbejder algoritmen på  , hvor n — antallet af noder, og m — antallet af kanter. På vores eksempel var det omkring ti millioner, hvilket kan beregnes på brøkdelen af et sekund, ikke kun på en bærbar computer, men endda på en mobiltelefon.
Det ovenfor nævnte eksempel er et eksempel på parametrisk algoritme. Parametriske algoritmer er algoritmer, der arbejder på tid f(k) poly(n), hvor p — et polynomium, f — en vilkårlig beregnelig funktion, og k — en eller anden parameter, der muligvis vil være meget mindre end størrelsen af opgaven.
Alle overvejelser frem til denne algoritme fører til et eksempel på kernelisering — en af de generelle teknikker til at skabe parameteriserede algoritmer. Kernalisering er at reducere opgavens størrelse til et niveau, der er begrænset af en funktion af parameteren. Den resulterende opgave kaldes ofte kernen. Med simple overvejelser om graderne af noderne fik vi en kvadratisk kerne til problemet Vertex Cover, parameteriseret efter svarstørrelsen. Der findes også andre parametre, der kan vælges til denne opgave (f.eks. Vertex Cover Above LP), men vi vil netop diskutere denne parameter.
Pace Challenge
Konkurrence (The Parameterized Algorithms and Computational Experiments Challenge) blev grundlagt i 2015 for at etablere en forbindelse mellem parameteriserede algoritmer og de metoder, der anvendes i praksis til at løse beregningsmæssige opgaver. De første tre konkurrencer var dedikeret til at finde træbredden af grafen (), finde Steiner-træet () og finde en klump af noder, der skærer cykler (). I år var en af opgaverne, hvor man kunne prøve sine kræfter, den ovenfor beskrevne opgave om vertexdækning.
Konkurrence vinder i popularitet for hvert år. Hvis man skal tro de foreløbige data, deltager kun i år 24 hold i konkurrencen for at løse opgaven om vertexdækning. Det skal bemærkes, at konkurrencen ikke varer i nogle timer eller endda en uge, men flere måneder. Holdene har mulighed for at studere litteraturen, komme med deres originale idé og forsøge at realisere den. I bund og grund repræsenterer denne konkurrence et forskningsarbejde. Ideerne for de mest effektive løsninger og belønningen af vinderne vil finde sted i forbindelse med konferencen (International Symposium on Parameterized and Exact Computation) inden for den største årlige algoritmiske samling i Europa . Mere detaljerede oplysninger om selve konkurrencen kan findes på , mens resultaterne fra tidligere år findes .
Løsningsdiagram
For tackling the vertex cover problem, I attempted to apply parameterized algorithms. They generally consist of two parts: simplification rules (which ideally lead to kernelization) and splitting rules. Simplification rules are a preprocessing step on the input that takes polynomial time. The purpose of applying these rules is to reduce the problem to an equivalent problem of smaller size. Simplification rules are the most resource-intensive part of the algorithm, and applying this part leads to a total runtime  instead of simple polynomial time. In our case, the splitting rules are based on the fact that for each vertex, we need to take either it or its neighbor as a response.
The overall scheme is as follows: we apply the simplification rules, then select a vertex, and make two recursive calls: in the first, we take it as a response, and in the other, we take all its neighbors. We refer to this as splitting (branching) on that vertex.
One addition will be made to this scheme in the next paragraph.
Ideas for splitting rules (branching)
Let's discuss how to choose a vertex for the splitting process.
The main idea is very greedy in an algorithmic sense: let’s take the vertex of maximum degree and split on it. Why does it seem to be a better option? Because in the second branch of the recursive call, we will thus remove a lot of vertices. We can expect that a small graph will remain, and we can work quickly on it.
This approach, combined with the previously discussed simple kernelization techniques, performs reasonably well, solving some tests with a few thousand vertices. However, it performs poorly for cubic graphs (that is, graphs where the degree of each vertex equals three).
There is another idea based on a fairly simple thought: if the graph is disconnected, the task on its connected components can be solved independently, combining the answers at the end. This is, by the way, the small promised modification in the scheme that will significantly accelerate the solution: previously, in such cases, we worked with the product of the times for counting the answers of the components, whereas now we work with the sum. To speed up branching, a connected graph needs to be transformed into a disconnected one.
Hvordan gør man det? Hvis der er et knudepunkt i grafen, skal vi bifurcere netop ved det. Et knudepunkt er en værdi, hvis fjernelse gør grafen uforbundet. Man kan finde alle knudepunkter i grafen ved hjælp af den klassiske algoritme på lineær tid. Denne tilgang accelererer bifurkationen væsentligt.
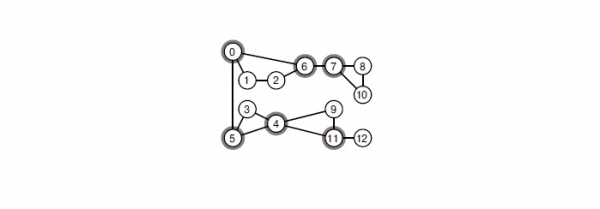
Ved at fjerne en hvilken som helst af de markerede noder, vil grafen falde sammen til forbindelseskomponenter.
Det vil vi gøre, men vi ønsker mere. For eksempel skal vi lede efter små vertex-skæringer i grafen og udføre bifurkation baseret på dem. Den mest effektive metode, jeg kender til at finde den minimale globale vertex-skæring, er at bruge Gomory-Hu træet, hvilket bygger sig på kubisk tid. I PACE Challenge er den typiske størrelse af grafen flere tusinde noder. Under sådanne omstændigheder skal milliarder af operationer udføres i hver node af tilbagekaldningstræet. Det viser sig, at det simpelthen ikke er muligt at løse opgaven inden for den afsatte tid.
Lad os forsøge at optimere løsningen. Den minimale vertex-skæring mellem et par noder kan findes ved hjælp af enhver algoritme, der bygger et maksimalt flow. Man kan anvende , som i praksis fungerer meget hurtigt. Jeg har en mistanke om, at man teoretisk kan bevise en tidsvurdering  , hvilket allerede er helt acceptabelt.
Jeg har forsøgt flere gange at finde skæringer mellem par af tilfældige noder og tage den mest afbalancerede derfra. Desværre gav dette dårlige resultater i de åbne tests af PACE Challenge. Jeg sammenlignede med algoritmen, der bifurkede på maks. grad-noder, ved at køre dem med en begrænsning på dybden af nedstigning. Efter algoritmen, der forsøgte at finde en skæring på denne måde, forblev der grafiker af større størrelse. Dette skyldes, at skæringerne var meget ubalancerede: når man fjernede 5-10 noder, kunne man kun afskære 15-20.
Det bør nævnes, at artikler om de teoretisk hurtigste algoritmer bruger meget mere avancerede teknikker til udvalg af noder til bifurkation. Sådanne teknikker har en meget kompleks implementering og ofte dårlige tids- og pladsvurderinger. Jeg har ikke været i stand til at udpege brugbare fra disse.
Hvordan man anvender forenklingeregler
Vi har allerede ideer til kernelesing. Lad mig minde om:
- Hvis der er en isoleret node, skal den fjernes.
- Hvis der er en knude med grad 1, skal den fjernes, og dens nabo tages som svar.
- Hvis der er en knude med mindst k + 1, tag den som svar.
Med de første to er det klart, men der er en lille trick med den tredje. Hvis vi i den sjove opgave om baren fik et øvre begrænsning på k, så skal vi i PACE Challenge blot finde et minimalt størrelses vertex dæk. Dette er en typisk transformation af søgningsopgaver (Search Problem) til beslutningsopgaver (Decision Problem), hvor der ofte ikke skelnes mellem de to typer opgaver. I praksis, hvis vi skriver en løser til vertex dæk-opgaven, kan der være forskel. For eksempel som i punkt tre.
Set fra implementeringens synspunkt kan vi gribe det an på to måder. Den første tilgang kaldes Iterative Deepening. Det går ud på, at vi kan starte med en rimelig nedre grænse for svaret, og derefter køre vores algoritme, hvor vi bruger denne grænse som en øvre begrænsning for svaret, uden at dykke ned i rekursioner, der er lavere end denne grænse. Hvis vi har fundet et svar, er det garanteret optimalt; ellers kan vi øge denne grænse med en enhed og starte forfra.
Den anden tilgang er at gemme et aktuelt optimalt svar og søge efter et svar af mindre størrelse og ændre denne parameter, når vi finder et. k for at skære bort unødvendige grene i søgningen.
Efter at have kørt nogle nat eksperimenter, landede jeg på en kombination af disse to metoder: først kører jeg min algoritme med en søgemulighedsdybde (vælger den, så den tager en ubetydelig tidsperiode i forhold til den primære løsning) og bruger den bedste fundne løsning som en øvre grænse for svaret — det vil sige netop det. k.
Knuder med grad 2
Vi har styr på knuderne med grad 0 og 1. Det viser sig, at det også kan gøres med knuder med grad 2, men dette kræver mere komplekse operationer i grafen.
For at forklare dette, skal vi på en eller anden måde betegne knuderne. Lad os kalde en knude med grad 2 for knuden v, og dens naboer som knuderne x og y. Derefter vil vi have to tilfælde.
- Når x og y — naboer. Så kan vi tage som svar x og y, og v fjerne. Og det er sandt, i denne trekant skal vi tage mindst to knuder som svar, og vi vil bestemt ikke tabe, hvis vi tager x og y: de har sandsynligvis også andre naboer, mens v de ikke har.
- Når x og y — ikke naboer. Så påstås det, at alle tre toppe kan klistres sammen til én. Ideen er, at der i så fald findes et optimalt svar, hvor vi tager enten v, eller begge toppe x og y. I det første tilfælde skal vi tage alle naboer med i svaret x og y, mens det i det andet ikke er nødvendigt. Dette svarer præcist til tilfældene, hvor vi ikke tager den klistrede top med i svaret, og når vi gør. Det er kun tilbage at bemærke, at svaret fra sådan en operation reduceres med én i begge tilfælde.
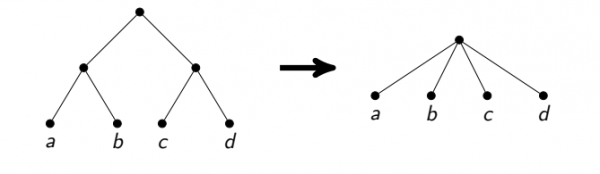
Det skal bemærkes, at en sådan tilgang er ret vanskelig at implementere korrekt på rimelig lineær tid. Klistre toppe — det er en kompleks operation, da man skal kopiere naboernes lister. Hvis man gør dette uforsigtigt, kan man få et asymptotisk suboptimalt køretid (f.eks. hvis man efter hver klistreoperation kopierer mange kanter). Jeg stoppede med at lede efter hele stier fra toppe med grad 2 og med at overveje en masse specielle tilfælde, som cykler af sådanne toppe eller af alle sådanne toppe undtagen én.
Derudover skal denne operation være reversibel, så vi kan genskabe grafen i sin oprindelige form, når vi vender tilbage fra rekursionen. For at sikre dette slettede jeg ikke listerne over kanter for de klistrede toppe; derefter vidste jeg simpelthen, hvilke kanter der skulle rettes mod hvor. En sådan grafimplementering kræver også omhu, men sikrer en rimelig lineær tid. Og for grafer med flere titusinde kanter passer det udmærket i CPU-cache, hvilket giver store hastighedsfordele.
Lineær kerne
Endelig er den mest interessante del af kernen.
For det første, lad os huske, at et minimalt vertex dække kan findes i bipartite grafer på  . For dette skal vi bruge algoritmen for at finde det maksimale match, og derefter anvende sætningen .
Ideen med den lineære kerne er som følger: først opdeler vi grafen, det vil sige, i stedet for hver top v opretter vi to toppe  og
 , og i stedet for hver kant u — v opretter vi to kanter
 og
 Den opnåede graf vil være to delte. Lad os finde en minimal hjørne dækning i den. Nogle hjørner i den oprindelige graf vil blive dækket to gange, nogle kun én gang, og nogle slet ikke. Nemhauser-Trotter teoremet siger, at i så fald kan vi fjerne de hjørner, der ikke er dækket overhovedet, og tage dem, der er dækket to gange, som svar. Desuden siger det, at blandt de tilbageværende hjørner (dem, der er dækket én gang), skal vi tage mindst halvdelen som svar.
Vi har netop lært at efterlade i grafen ikke mere end 2k hjørner. Og det er sandt, hvis svaret består af mindst halvdelen af alle hjørner, så er der ikke flere hjørner end 2k.
Her har jeg formået at tage et lille skridt fremad. Det er klart, at den kerne, der er opbygget på denne måde, afhænger af, hvilken minimal hjørne dækning i den to delte graf vi har valgt. Man ønsker at vælge en, så antallet af tilbageværende hjørner er minimalt. Tidligere kunne dette kun gøres på tid  . Jeg har dog opfundet en implementering af denne algoritme på tid
 , så denne kerne kan søges i grafer med hundrede tusinde hjørner i hvert trin af branching.
Resultat
Praksis viser, at min løsning fungerer godt på tests med flere hundrede hjørner og flere tusinde kanter. På sådanne tests kan man forvente, at løsningen findes inden for en halv time. Sandsynligheden for at finde et svar inden for acceptabel tid stiger generelt, hvis der er tilstrækkeligt mange hjørner med høj grad i grafen, for eksempel grad 10 og derover.
For at deltage i konkurrencen skulle løsningerne sendes til . Ifølge det præsenterede , tager min løsning tredjepladsen blandt tyve på åbne tests med en betydelig margen til andenpladsen. For at være helt ærlig er det ikke helt klart, hvordan løsningerne vil blive bedømt i selve konkurrencen: for eksempel min løsning bestå færre tests end løsningen på fjerdepladsen, men på dem, hvor den består, arbejder den hurtigere.
Resultaterne på de lukkede tests vil blive kendt den første juli.
Kilde: habr.com
