

Internettet virker som en stærk, uafhængig og ufravigelig struktur. I teorien burde netværkets styrke være nok til at overleve en atomexplosion. I virkeligheden kan internettet dog falde over en lille router. Alt dette skyldes, at internettet er en sammenstilling af modsigelser, sårbarheder, fejl og videoer med katte. Grundlaget for internettet - BGP-protokollen - indeholder en masse problemer. Det er en overraskelse, at det stadig fungerer. Ud over fejlene i selve internettet bliver det også angrebet af alle mulige: store internetudbydere, virksomheder, stater og DDoS-angreb. Hvad skal man gøre med dette, og hvordan skal man leve med det?
Svaret kender Alexey Uchakkin () - leder af netværksingeniørteamet hos IQ Option. Hans hovedopgave er at sikre platformens tilgængelighed for brugerne. I transskriptionen af Alexeys foredrag på diskuterer vi BGP, DDoS-angreb, afbryderen fra internettet, fejl fra udbyderne, decentralisering og tilfælde, hvor en lille router har sendt internettet på ferie. Til sidst - et par råd om, hvordan man klarer alt dette.
Dagen, hvor internettet gik ned
Jeg vil kun nævne nogle få hændelser, hvor internettets forbindelser er blevet brudt. Dette vil være nok til at give et klart billede.
«Hændelsen med AS7007». Første gang internettet gik ned var i april 1997. I softwaren på en router fra det autonome system 7007 var der en fejl. På et tidspunkt annoncerede routeren sin interne routingtabel til sine naboer og sendte halvdelen af netværket i en black hole.
«Pakistan mod YouTube». I 2008 besluttede de modige folk fra Pakistan at blokere YouTube. De gjorde det så godt, at halvdelen af verden blev uden katte.
«Ophold af præfikserne VISA, MasterCard og Symantec af Rostelecom». I 2017 begyndte Rostelecom ved en fejltagelse at annoncere præfikserne for VISA, MasterCard og Symantec. Resultatet var, at finansiel trafik blev sendt gennem kanaler, som udbyderen kontrollerede. Lækagen varede ikke længe, men finansielle virksomheder fandt det ubehageligt.
«Google mod Japan». I august 2017 begyndte Google at annoncere præfikserne for de store japanske udbydere NTT og KDDI i dele af sine uplinks. Trafikken blev sendt til Google som transit, højst sandsynligt ved en fejl. Da Google ikke er en udbyder og derfor ikke tillader transittrafik, blev en betydelig del af Japan uden internet.
»DV LINK har overtaget Google, Apple, Facebook, Microsoft's præfikser«. I 2017 begyndte den russiske udbyder DV LINK underligt nok at annoncere netværkene Google, Apple, Facebook, Microsoft og nogle andre store aktører.
»eNet fra USA har overtaget AWS Route53 og MyEtherwallets præfikser«. I 2018 annoncerede en udbyder fra Ohio eller en af hans kunder netværkene Amazon Route53 og kryptovaluta-walleten MyEtherwallet. Angrebet var en succes: På trods af det selvsignerede certifikat, der advarte brugeren ved adgang til MyEtherwallets hjemmeside, blev mange wallets stjålet, og en del kryptovaluta forsvandt.
Sådanne hændelser skete over 14.000 gange i 2017! Netværket er stadig decentraliseret, så ikke alt går ned og ikke alle rammes. Men hændelser sker med tusindvis, og alle er relateret til BGP-protokollen, som internettet fungerer på.
BGP og dets problemer
Protokol BGP - Border Gateway Protocol, blev først beskrevet i 1989 af to ingeniører fra IBM og Cisco Systems på tre »servietter« – A4-ark. Disse ligger stadig i Cisco Systems' hovedkontor i San Francisco som en relikvie fra netværksverdenen.
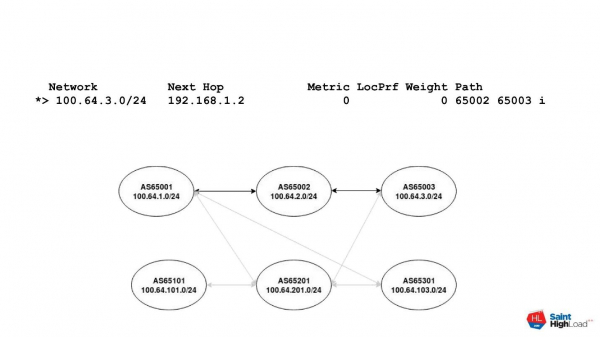
Grundlaget for protokollen er interaktionen mellem autonome systemer – Autonomous Systems eller forkortet AS. Et autonomt system er blot en ID, som i den offentlige register knytter IP-netværk. En router med sådan et ID kan annoncere disse netværk til verden. Derfor kan enhver rute på internettet betragtes som en vektor kaldet AS Path. Vektoren består af numre på autonome systemer, der skal passeres for at nå bestemmelsesnetværket.
For eksempel er der et netværk bestående af et antal autonome systemer. Man skal komme fra system AS65001 til system AS65003. Vejen fra et system er repræsenteret af AS Path på diagrammet. Den består af to autonome systemer: 65002 og 65003. For hver destinationsadresse er der en AS Path-vektor, der består af numrene på de autonome systemer, man skal passere.
Så hvilke problemer har BGP?
BGP er et tillidsprotokol
BGP-protokollen er tillidsbaseret. Det betyder, at vi som standard stoler på vores nabo. Dette er en funktion i mange protokoller, der blev udviklet i internettets tidlige dage. Lad os se nærmere på, hvad det betyder at "stole".
Ingen autentificering af naboen. Formelt set findes der MD5, men MD5 i 2019 - ja, det er ikke så godt…
Ingen filtrering. BGP har filtre, som er beskrevet, men de bruges ikke, eller de bruges forkert. Jeg vil senere forklare, hvorfor.
Meget enkelt at oprette nabolag. Konfiguration af nabolag i BGP-protokollen kan næsten gøres med et par linjer i konfigurationen på enhver router.
Ingen rettigheder kræves for at administrere BGP. Du skal ikke op til eksamen for at bekræfte din kvalifikation. Ingen vil tage dine rettigheder fra dig for at konfigurere BGP, mens du er beruset.
To hovedproblemer
Prefix hijacking. Prefix hijacking - annoncering af et netværk, som du ikke ejer, som i tilfældet med MyEtherwallet. Vi tog nogle præfikser, indgik en aftale med udbyderen eller hackede ham, og annoncerer disse netværk gennem ham.
Rute lækager. Rute lækager er lidt mere komplekse. En lækage er en ændring af AS Path. I bedste fald vil ændringen føre til højere latens, fordi en længere rute skal tages, eller en mindre effektiv link skal benyttes. I værste fald vil en situation som med Google og Japan gentage sig.
Selv Google er ikke en operatør og ikke et transit autonomt system. Men når de annoncerede netværkene af japanske operatører til deres udbyder, så trafikken igennem Google på AS Path mere prioriteret. Trafikken gik derhen og blev droppet simpelthen fordi ruteindstillingerne inden for Google er mere komplekse end blot filtre ved grænsen.
Hvorfor fungerer filtrene ikke?
Ingen bekymrer sig. Det er den primære årsag - ingen bryder sig. En administrator fra en lille udbyder eller virksomhed, der er tilsluttet en udbyder via BGP, tog en MikroTik, konfigurerede BGP på den og ved ikke engang, at der kan konfigureres filtre.
Konfigurationsfejl. Der blev debuggede noget, en fejl i masken, de satte ikke det rigtige netværk - og voila, en fejl igen.
Ingen teknisk mulighed. For eksempel har teleselskaber mange kunder. Det ville være fornuftigt automatisk at opdatere filtre for hver kunde - overvåge, at de får et nyt netværk, at de har udlejet deres netværk. Det er svært at holde øje med dette, og endnu sværere manuelt. Derfor sætter de bare afslappede filtre eller sætter slet ikke filtre.
Undtagelser. Der er undtagelser for de foretrukne og store kunder. Især i tilfælde af mellemoperatør forbindelser. For eksempel har TransTeleCom og Rostelecom mange netværk og en forbindelse imellem dem. Hvis forbindelsen falder, vil ingen have det godt, så filtrene slækkes eller fjernes helt.
Forældet eller irrelevant information i IRR. Filtrene er baseret på information, der er registreret i IRR - Internet Routing Registry. Dette er registre fra regionale internetregistratorer. Ofte indeholder registrene forældet eller irrelevant information, eller begge dele.
Hvem er disse registratorer?
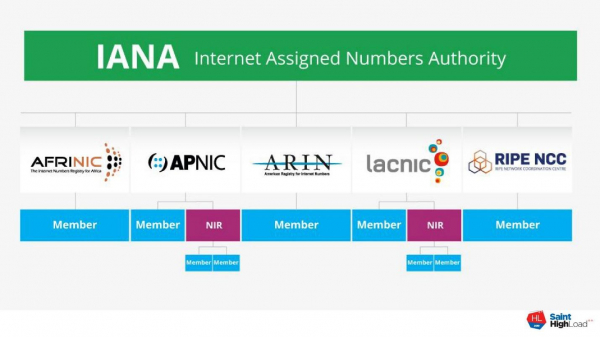
Alle adresser på internettet tilhører organisationen IANA - Internet Assigned Numbers Authority. Når du køber et IP-netværk fra nogen, køber du ikke adresserne, men retten til at bruge dem. Adresserne er en immateriel ressource, og ifølge generel overenskomst tilhører de alle IANA-agenturet.
Systemet fungerer således. IANA delegerer styringen af IP-adresser og numre til autonome systemer til fem regionale registratorer. Disse udsteder autonome systemer LIR - lokale internetregistratorer. Derefter tildeler LIR IP-adresser til slutbrugerne.
Systemets mangel er, at hver af de regionale registratorer fører deres registre på deres egen måde. Hver har sine egne synspunkter på, hvilken information der skal være i registrene, og hvem der skal eller ikke skal verificere den. Resultatet er det rod, der findes i dag.
Hvordan kan man ellers bekæmpe disse problemer?
IRR - middelmådig kvalitet. IRR er tydeligvis et problem.
BGP-communities. Dette er en bestemt attribut, der er beskrevet i protokollen. Vi kan for eksempel påføre et specielt community til vores annoncering, så naboen ikke sender vores netværk til sine naboer. Når vi har en P2P-forbindelse, udveksler vi kun vores netværk. For at forhindre, at ruten utilsigtet går til andre netværk, påfører vi et community.
Communities er ikke transitiv. Det er altid en aftale mellem to, og det er deres ulempe. Vi kan ikke påføre et hvilket som helst community, undtagen et, der er accepteret som standard af alle. Vi kan ikke være sikre på, at alle accepterer dette community og fortolker det korrekt. Derfor, i bedste fald, hvis du laver en aftale med din uplink, vil han forstå, hvad du ønsker fra ham via community. Men naboen kan muligvis ikke forstå det, eller operatøren kan blot fjerne din mærkning, og du opnår ikke det, du ønskede.
RPKI + ROA løser kun en lille del af problemerne. RPKI er Resource Public Key Infrastructure — en speciel ramme for underskrivelse af ruteinformation. Det er en god idé at tvinge LIR'er og deres kunder til at føre en opdateret database over adresseområdet. Men der er et problem med det.
RPKI er også et hierarkisk system med offentlige nøgler. IANA har en nøgle, fra hvilken RIR-nøgler oprettes, og fra dem genereres LIR-nøgler, som de signer deres adresseområde med via ROA'er — Route Origin Authorisations:
— Jeg forsikrer, at denne præfiks vil blive annonceret på vegne af denne autonomi.
Udover ROA er der også andre objekter, men dem kan vi tage en anden gang. Det virker som en god og nyttig ting. Men det beskytter os overhovedet ikke mod lækager og løser ikke alle problemer med præfiks-tyveri. Derfor er aktørerne ikke særlig ivrige efter at implementere det. Der er dog allerede fra store aktører som AT&T og større IX'er givet løfter om, at præfiks med invalid-ROA-optegnelser vil blive droppet.
Måske vil de gøre det, men indtil videre har vi et stort antal præfikser, som slet ikke er signerede. På den ene side er det uklart, om de annonceres som valide. På den anden side kan vi ikke som standard droppe dem, fordi vi ikke er sikre på, om det er korrekt.
Hvad er der ellers?
BGPSec. Det er en cool ting, som akademikere har opfundet til netværket af lyserøde ponyer. De sagde:
— Vi har RPKI + ROA — mekanismen til at bekræfte underskriften af adresseområdet. Lad os etablere en særskilt BGP-attribut og kalde den BGPSec Path. Hver router vil underskrive de annoncer, den annoncerer til naboer. Så får vi en pålidelig sti fra kæden af signerede annoncer, som vi kan verificere.
Teoretisk set er det godt, men i praksis er der mange problemer. BGPSec bryder mange eksisterende BGP-mekanikker vedrørende valg af next-hop og styring af indgående/udgående trafik direkte på routeren. BGPSec fungerer ikke, før det er implementeret af 95% af markedets deltagere, hvilket i sig selv er en utopi.
BGPSec har enorme problemer med ydeevnen. På det nuværende udstyr er hastigheden for at verificere annoncer omtrent 50 præfikser per sekund. Til sammenligning vil den nuværende internettabel med 700.000 præfikser tage 5 timer at indlæse, i løbet af hvilke yderligere 10 ændringer vil finde sted.
BGP Open Policy (Role-based BGP). Et nyt forslag baseret på modellen Gao-Rexford. Det er to forskere, der arbejder med undersøgelser af BGP.
Modellen Gao-Rexford handler om følgende. For at forenkle det kan man sige, at der er et begrænset antal typer interaktioner i forbindelse med BGP:
- Provider Kunde;
- P2P;
- intern interaktion, lad os sige iBGP.
Baseret på routerens rolle kan der automatisk pålægges visse import-/eksportpolitikker. Administratoren behøver ikke at konfigurere præfiks-lister. Baseret på den rolle, som routerne bliver enige om, kan der allerede skabes nogle standardfiltre. Dette er lige nu et udkast, der diskuteres i IETF. Jeg håber snart, at vi vil se det i form af RFC og implementeringer på hardware.
Store internetudbydere
Lad os tage eksemplet med udbyderen CenturyLink. Det er den tredjestørste udbyder i USA, der betjener 37 stater og har 15 datacentre.
I december 2018 havde CenturyLink nedbrud i det amerikanske marked i 50 timer. Under hændelsen var der problemer med bankautomater i to stater, og nummer 911 fungerede ikke i fem stater i flere timer. Desuden blev der aflyst en lotteri i Idaho. På grund af denne hændelse fører den amerikanske kommunikationskommission i øjeblikket en undersøgelse.
Årsagen til tragedien var et netværkskort i et datacenter. Kortet svigtede, sendte ukorrekte pakker, og alle 15 datacentre fra udbyderen gik ned.
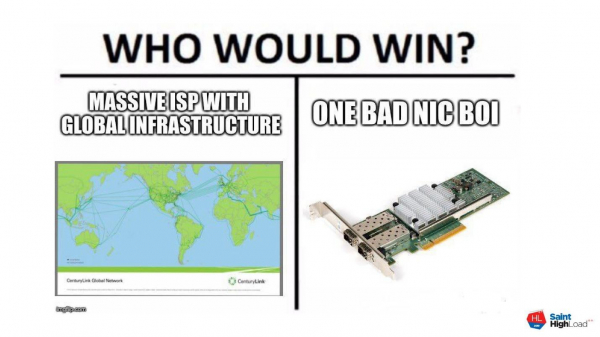
For denne udbyder fungerede ideen «for stor til at falde». Denne idé fungerer overhovedet ikke. Man kan tage enhver stor spiller og få dem til at falde på grund af noget småt. I USA er der stadig godt med forbindelser. Kunderne hos CenturyLink, der havde en reserve, forlod massivt til dem. Derefter klagede alternative operatører over overbelastning af deres forbindelser.
Hvis en hypotetisk 'Kazakhtelecom' falder, vil hele landet forblive uden internet.
Korporationer
Holder internettet sig mon oppe på Google, Amazon, Facebook og andre korporationer? Nej, de nedbryder det også.
I 2017 på konferencen ENOG13 i St. Petersborg Jeff Houston af APNIC den . Det handler om, at vi er vant til, at interaktioner, pengestrømme og trafik på internettet er vertikale. Vi har små udbydere, der betaler for forbindelser til større, og de betaler så til den globale transit.
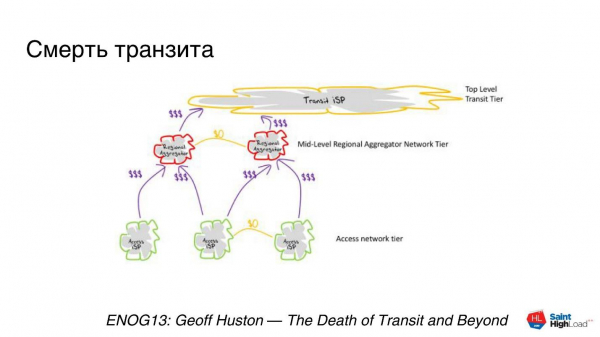
Vi har nu en sådan vertikalt orienteret struktur. Alt ville være godt, men verden ændrer sig — store aktører bygger deres transatlantiske kabler for at opbygge deres egne backbone-netværk.
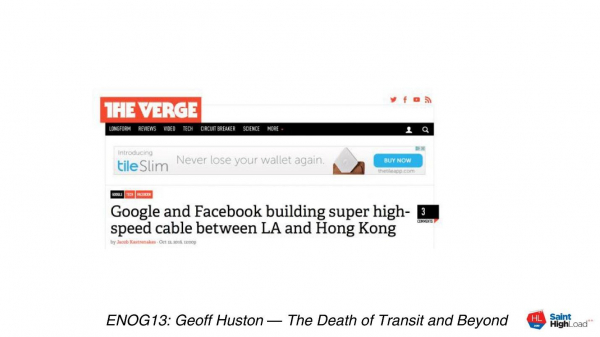
Nyhed om CDN-kabel.
I 2018 udgav TeleGeography en undersøgelse, der viste, at mere end halvdelen af trafikken på internettet allerede ikke er internet, men backbone-netværk af store aktører. Det er trafik, der relaterer sig til internettet, men det er ikke det netværk, vi talte om.
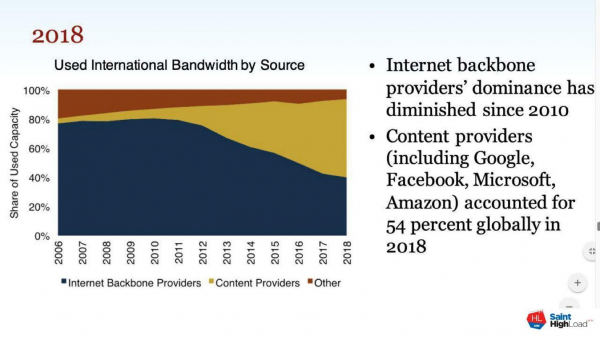
Internettet opdeles i et stort antal svagtsammenkoblede netværk.
Microsoft har sit netværk, Google har sit, og de krydser sjældent hinanden. Trafikken, der opstod et sted i USA, rejser gennem Microsofts kanaler over havet til Europa, hvor den når et CDN, dernæst tilslutter sig jeres udbyder via CDN eller IX og når jeres router.
Decentraliseringen forsvinder.
Denne styrke ved internettet, som hjælper det med at overleve efter et nukleart nederlag, går tabt. Der opstår steder med koncentration af brugere og trafik. Hvis eksempelvis Google Cloud går ned, vil der være mange berørte på én gang. Vi oplevede allerede noget, da Roskomnadzor blokerede AWS. Og med eksemplet CenturyLink er det tydeligt, at selv små ting kan udløse det.
Tidligere gik det ikke galt for alle og ikke for alt. I fremtiden kan vi komme til det punkt, hvor man ved at påvirke én stor aktør kan ødelægge meget, mange steder og for mange.
Stater
Næste på listen er stater, og med dem foregår det normalt på denne måde.
Her er vores Roskomnadzor slet ikke en pioner. En lignende praksis med internetnedlukninger findes i Iran, Indien, Pakistan. I England er der et lovforslag om muligheden for at lukke internettet.
Ethvert stort land ønsker at have en afbryder til at lukke internettet, enten helt eller delvist: Twitter, Telegram, Facebook. De forstår ikke, at de aldrig vil kunne gøre det, men de ønsker det meget. De anvender afbryderen normalt til politiske formål — for at eliminere politiske modstandere, eller ved valg, eller for at russiske hackere har ødelagt noget igen.
DDoS-angreb
Jeg vil ikke tage brødet fra mine kolleger i Qrator Labs, de gør det meget bedre end mig. De har om internettets stabilitet. Og her er, hvad de skrev i rapporten for 2018.
Den gennemsnitlige varighed af DDoS-angreb falder til 2,5 timer.. Angribere begynder også at tælle penge, og hvis ressourcen ikke blev slået ud med det samme, så efterlades den hurtigt i fred.
Intensiteten af angreb stiger. I 2018 så vi 1,7 Tb/s på Akamai-netværket, og det er ikke grænsen.
Nye angrebsvektorer dukker op, og gamle forstærkes. Nye protokoller, der er udsat for amplification, viser sig, nye angreb på eksisterende protokoller, især på TLS og lignende.
Størstedelen af trafikken kommer fra mobile enheder. Samtidig går internettrafikken over til mobile klienter. Dette skal man kunne håndtere, både for dem, der angriber, og dem, der forsvarer.
Der er ingen sårbarhed. Dette er hovedbudskabet - der eksisterer og vil aldrig komme en universel beskyttelse, der præcist beskytter mod enhver DDoS.
Systemet kan ikke sættes ud af drift, medmindre det ikke er tilsluttet internettet.
Jeg håber, jeg har skræmt dig nok. Lad os nu tænke på, hvad vi skal gøre ved det.
Hvad skal vi gøre?!
Hvis du har tid, lyst og kendskab til engelsk - deltag i arbejdsgrupper: IETF, RIPE WG. Disse er åbne mail-lister, tilmeld dig nyhedsbreve, deltag i diskussioner, kom til konferencer. Hvis du har LIR-status, kan du stemme for forskellige initiativer i RIPE.
For almindelige mennesker - det er overvågning. For at vide, hvad der er gået i stykker.
Overvågning: hvad skal kontrolleres?
Almindelig Ping, og ikke kun en binær kontrol - fungerer det eller ej. Registrer RTT i historikken for senere at kunne se anomalier.
Traceroute. Det er et hjælpeprogram til at bestemme dataenes ruter i TCP/IP-netværk. Det hjælper med at identificere anomalier og blokeringer.
HTTP checks - kontrol af brugerdefinerede URL'er og TLS-certifikater hjælper med at opdage blokeringer eller DNS-forfalskning for angreb, hvilket næsten er det samme. Blokeringer udføres ofte via DNS-forfalskning og ved at dirigere trafikken til en fejlside.
Hvis det er muligt, skal du kontrollere, at dine kunder kan løse dit origin fra forskellige steder, hvis du har en applikation. På den måde opdager du anomalier i DNS-opsamlingen, som nogle gange forekommer hos udbydere.
Overvågning: hvor skal der kontrolleres fra?
Der er ikke noget universelt svar. Tjek derfra, hvor brugeren kommer. Hvis brugerne er fra Rusland, så tjek fra Rusland, men begræns dig ikke til det. Hvis dine brugere bor i forskellige regioner - tjek fra disse regioner. Men det er bedst at tjekke fra hele verden.
Overvågning: hvad skal man tjekke?
Jeg har opfundet tre måder. Hvis du kender flere, så skriv dem i kommentarerne.
- RIPE Atlas.
- Kommersiel overvågning.
- Egen netværk af virtuelle maskiner.
Lad os tale om hver enkelt af dem.
RIPE Atlas — det er sådan en lille boks. For dem, der kender den russiske 'Revisor' — det er den samme slags boks, men med et andet klistermærke.
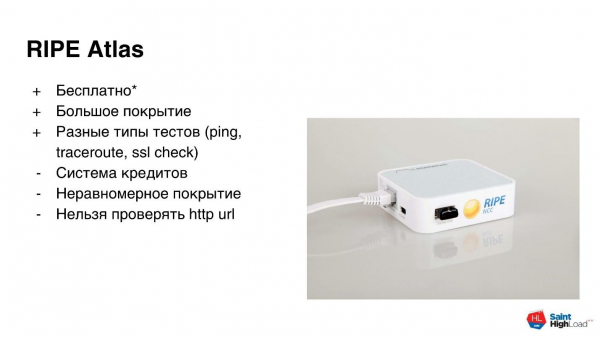
RIPE Atlas er et gratis program. Du registrerer dig, modtager en router pr. mail og tilslutter den til netværket. For at nogen andre bruger din måling, får du nogle credits. Med disse credits kan du selv foretage nogle undersøgelser. Du kan teste på forskellige måder: ping, traceroute, tjekke certifikater. Dækningen er ret stor, mange noder. Men der er nuancer.
Kreditsystemet tillader ikke at bygge produktionsløsninger. Kreditterne rækker ikke til konstant forskning eller kommerciel overvågning. Kreditterne rækker kun til kortvarig forskning eller engangstjek. Den daglige norm pr. prøve bruges op med 1-2 tjek.
Dækningen er ujævn. Da programmet er gratis fra begge sider, er dækningen god i Europa, den europæiske del af Rusland og i nogle regioner. Men hvis du har brug for Indonesien eller New Zealand, er det meget værre - 50 prøver per land er måske ikke tilstrækkeligt.
Det er ikke muligt at tjekke http fra prøven. Dette skyldes tekniske nuancer. De lover at fixe det i en ny version, men indtil videre kan http ikke tjekkes. Man kan kun tjekke certifikatet. Nogle http-tjek kan kun udføres på den specielle enhed RIPE Atlas, som kaldes Anchor.
Den anden metode er kommerciel overvågning. Med den er alt fint, du betaler penge, ikke? De lover flere dusin eller hundrede overvågningspunkter over hele verden, og tegner flotte dashboards 'out of the box'. Men igen er der problemer.
Det er betalt, nogle gange meget. Ping-overvågning, tjek fra hele verden og mange http-tjek kan koste flere tusinde dollars om året. Hvis økonomien tillader det, og du kan lide denne løsning - så gør det.
Dækningen kan være utilstrækkelig i det interessante område. Den samme ping afklarer maksimalt en abstrakt del af verden - Asien, Europa, Nordamerika. Sjældne overvågningssystemer kan detaljere målingen til et specifikt land eller region.
Svært ved at støtte custom-tests. Hvis du har brug for noget skræddersyet, og ikke bare en "kurlyk" på url, så er der også problemer med det.
Den tredje metode - din egen overvågning. Det er klassikeren: "Lad os skrive vores eget!"
Din egen overvågning bliver til udvikling af et softwareprodukt, og det er endda distribueret. Du leder efter en infrastrukturudbyder, ser på, hvordan dette skal implementeres og overvåges - overvågning skal jo overvåges, ikke sandt? Og du har også brug for support. Tænk dig godt om, før du kaster dig ud i det. Måske er det lettere at betale nogen, der kan gøre det for dig.
Overvågning af BGP-anomalier og DDoS-angreb
Her er det hele lidt simplere med de tilgængelige ressourcer. BGP-anomalier opdages ved hjælp af specialiserede tjenester som QRadar, BGPmon. De modtager full view-tabeller fra mange operatører. Baseret på, hvad de ser fra forskellige operatører, kan de opdage anomalier, finde forstærkere og meget mere. Registrering er normalt gratis - du indtaster nummeret på din autonome system og tilmelder dig meddelelser via e-mail, og tjenesten alarmerer dine problemer.
I overvågning af DDoS-angreb er det også ret enkelt. Som regel er det NetFlow-baseret og logfiler. Der findes specialiserede systemer som FastNetMon, moduler til Splunk. I sidste ende er der din DDoS-beskyttelsesudbyder. Du kan også sende NetFlow til ham, og baseret på dette vil han advare dig om angreb i din retning.
Konklusioner
Misdøg ikke - internettet vil helt sikkert gå ned. Det vil ikke bryde sammen for alle, men 14.000 hændelser i 2017 antyder, at der vil komme hændelser.
Dit mål er at opdage problemer så tidligt som muligt. Som minimum ikke senere end din bruger. Udover at opdage, skal du altid have en "plan B" klar. Planen er en strategi for, hvad du vil gøre, når alt går i stykker: reserveoperatører, datacentre, CDN. Planen er en separat tjekliste, hvorpå du kontrollerer driften af alt. Planen skal fungere uden at involvere netværksingeniører, fordi de som regel er få, og de vil gerne sove.
Det var alt. Jeg ønsker dig høj tilgængelighed og grønt overvågningsarbejde.
I næste uge forventes der sol, høj belastning og høj koncentration af udviklere i . I Sibirien er der forudset en konference om overvågning, tilgængelighed og test, sikkerhed og ledelse. Der forventes nedbør i form af skrivne notater, netværk, billeder og indlæg på sociale medier. Vi anbefaler at udsætte alle opgaver den 24. og 25. juni og . Vi glæder os til at se dig i Sibirien!
Kilde: habr.com
