

Introduktion
Informationssystemet set fra brugerens perspektiv er godt defineret i GOST RV 51987 — "et automatiseret system, hvis funktion resulterer i præsentationen af udgående information til efterfølgende brug". Betragtet ud fra den indre struktur er ethvert IS i bund og grund et system af sammenkoblede algoritmer implementeret i kode. I en bredere forståelse gennemfører Turing-Church-teoremet, at et algoritme (og dermed IS) transformationen af et sæt inputdata til et sæt outputdata.
Man kan endda sige, at meningen med eksistensen af informationssystemet ligger i transformationen af inputdata. Derfor bestemmes værdien af IS og hele komplekset af IS gennem værdien af input- og outputdata.
I lyset af dette skal designet starte med og tage data som udgangspunkt og tilpasse arkitektur og metoder til strukturen og betydningen af dataene.
Opbevarede data
En afgørende fase i forberedelsen til design er at få egenskaberne for alle datamængder, der planlægges behandlet og opbevaret. Disse egenskaber omfatter:
— Dataomfang;
— Oplysninger om dataenes livscyklus (vækst af nye data, levetid, behandling af forældede data);
— Klassificering af data set i forhold til indflydelse på virksomhedens kerneforretning (den såkaldte tredighed af fortrolighed, integritet, tilgængelighed) sammen med økonomiske indikatorer (f.eks. omkostninger ved datatab over den sidste time);
— Geografi for databehandling (fysisk placering af behandlingssystemer);
— Regulatoriske krav for hver dataklasse (f.eks. FZ-152, PCI DSS).
Informationssystemer
Data lagres ikke kun, men behandles (transformeres) også af informationssystemer. Næste skridt efter at have indsamlet dataegenskaberne er at lave en så fuldstændig opgørelse som muligt over informationssystemerne, deres arkitektoniske egenskaber, afhængigheder og krav til infrastrukturer i form af de fire ressourcekategorier:
— Processorberegningskapacitet;
— Mængden af RAM;
— Krav til mængde og ydeevne af datalageringssystemer;
— Krav til datanetværk (eksterne kanaler, kanaler mellem komponenter i IS).
Kravene skal være til stede for hver service/mikroservice i systemet.
Det er vigtigt at bemærke, at der skal være data om, hvordan systemet påvirker virksomhedens kerneforretning i form af omkostninger ved systemnedbrud (rubler per time).
Trusselsmodel
Der skal være en formel trusselsmodel, som angiver, hvilke trusler der planlægges at beskytte data/services imod. Denne model omfatter ikke kun aspekter af fortrolighed, men også integritet og tilgængelighed. For eksempel:
— Nedbrud af en fysisk server;
— Nedbrud af top-of-the-rack switch;
— Brud på den optiske kommunikationskanal mellem datacentre;
— Nedbrud af det operative SAN i sin helhed.
I nogle tilfælde skrives trusselsmodellerne ikke kun for infrastrukturelle komponenter, men også for specifikke systemer eller deres komponenter, som for eksempel nedbrud af DBMS med logisk ødelæggelse af datastrukturen.
Alle beslutninger under projektet vedrørende beskyttelse mod ikke-beskrivelige trusler er overflødige.
Regulatoriske krav
Hvis de behandlede data er omfattet af særlige regler fastsat af regulatorer, er det nødvendigt at have information om datamængder og regler for behandling/opbevaring.
Målte RPO/RTO
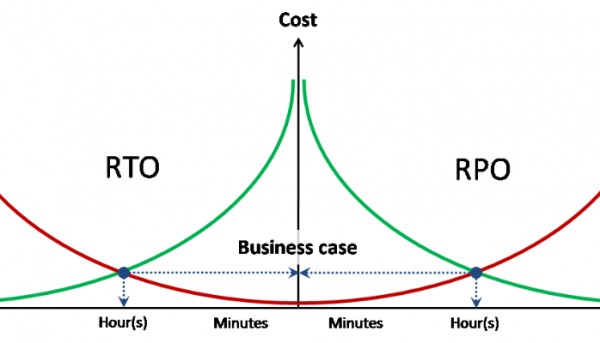
Design af enhver form for beskyttelse kræver tilstedeværelse af målte tab af data og målte restitutionstid for servicen for hver af de beskrevne trusler.
Ideelt set skal RPO og RTO have tilknyttede omkostninger ved tab af data og nedbrud pr. tidsenhed.
Opdeling i ressourcepuljer
Efter indsamling af al den primære inputinformation er det første skridt at gruppere datamængder og systemer i puljer, baseret på trusselsmodeller og regulatoriske krav. Type opdeling af de forskellige puljer bestemmes – softwaremæssigt på systemsoftware niveau eller fysisk.
Eksempler:
— Området, der behandler persondata, er helt fysisk adskilt fra de øvrige systemer;
— Sikkerhedskopier opbevares på en separat SAN.
Puljer kan dog have delvis uafhængighed; for eksempel defineres to puljer af computerressourcer (processor kapacitet + RAM), der bruger en fælles dataopbevaringspulje og en fælles dataoverførselsressourcepulje.
Processor kapacitet
De abstrakte behov for processorkraft i et virtualiseret datacenter måles i antal virtuelle processorer (vCPU) og deres konsolideringsforhold til fysiske processorer (pCPU). I dette specifikke tilfælde svarer 1 pCPU til 1 fysisk processor-kerne (uden hensyntagen til Hyper-Threading). Antallet af vCPU opsummeres på tværs af alle definerede ressourcepuljer (hver af dem kan have sit eget konsolideringsforhold).
Konsolideringsforholdet for belastede systemer opnås empirisk, baseret på eksisterende infrastruktur, eller ved pilotinstallation og belastningstestning. For ubearbejdede systemer anvendes 'best practice'. Især angiver VMware et gennemsnitligt forhold på 8:1.
RAM
Det samlede behov for hukommelse opnås ved simpel opsummering. Anvendelse af overtegning på hukommelse anbefales ikke.
Lagringsressourcer
Kraven til lagringsressourcer opnås ved simpel opsummering af alle puljer baseret på kapacitet og ydelse.
Kravene til ydelse udtrykkes i IOPS i kombination med det gennemsnitlige forhold mellem læse/skriv og, hvis nødvendigt, den maksimale svartid.
Kravene til kvaliteten af service (QoS) for specifikke puljer eller systemer skal angives særskilt.
Dataoverførselsressourcer
Kravene til dataoverførselsnetværket opnås ved simpel opsummering af alle puljer af båndbredde.
Kravene til kvaliteten af service (QoS) og forsinkelse (RTT) for specifikke puljer eller systemer skal angives særskilt.
Inden for kravene til dataoverførselsressourcer angives også krav til isolation og/eller kryptering af netværkstrafik samt præfererede mekanismer (802.1q, IPSec osv.).
Valg af arkitektur
I denne vejledning overvejes der ikke andet valg end x86-arkitekturen og 100% virtualisering af servere. Således reduceres valget af arkitektur for beregningssystemet til valg af server-virtualiseringsplatform, formfaktor for servere og generelle konfigurationskrav for servere.
Et centralt punkt i valget er klarhed i brugen af den klassiske tilgang, der adskiller databehandling, lagring og transmission, eller den konvergerende.
Klassisk arkitektur betyder brugen af intelligente eksterne lagrings- og dataoverførselssystemer, mens serverne kun bidrager til det samlede pool af fysiske ressourcer med CPU-kraft og RAM. I ekstremt tilfælde bliver serverne helt anonyme, uden hverken egne drev eller systemidentifikator. I dette tilfælde bruges boot af OS eller hypervisor fra indbyggede flash-drev eller fra et eksternt lagringssystem (boot from SAN).
Inden for den klassiske arkitektur vælges mellem blade og rack primært ud fra følgende principper:
— Økonomisk effektivitet (i gennemsnit er rack-servere billigere);
— Beregningsdensitet (blade har en højere);
— Energiforbrug og varmeudvikling (blade har højere specifik forbrug pr. enhed);
— Skalerbarhed og håndterbarhed (blade kræver generelt mindre indsats ved store installationer);
— Brug af udvidelseskort (valget for blade er meget begrænset).
Konvergerende arkitektur (også kendt som hyperkonvergerende) indebærer en kombination af funktioner til behandling og lagring af data, hvilket fører til brugen af lokale drev i serverne og dermed opgivelse af formfaktoren for klassiske blade. Til konvergerende systemer bruges enten rack-servere eller klyngesystemer, der kombinerer flere blade-servere og lokale drev i et enkelt chassis.
CPU / Hukommelse
For korrekt beregning af konfigurationen skal man forstå typen af belastning for miljøet eller hver af de uafhængige klynger.
CPU bound – et miljø, der er begrænset af CPU-kraft. Tilsætning af RAM ændrer ikke noget med hensyn til ydeevne (mængden af VM på serveren).
Memory bound – et miljø, der er begrænset af RAM. En større mængde RAM på serveren muliggør kørsel af et større antal VM på serveren.
GB / MHz (GB / pCPU) – det gennemsnitlige forhold mellem hukommelses- og CPU-forbruget for den specifikke belastning. Kan bruges til beregning af det nødvendige hukommelsesvolumen ved en given ydeevne og omvendt.
Beregning af serverkonfiguration
For starters, it is necessary to determine all types of loads and decide on whether to combine or separate different computing pools across various clusters.
Next, for each of the defined clusters, the ratio of GB / MHz is determined based on known loads. If the load is not known in advance, but there is a rough understanding of the CPU power load level, standard coefficients vCPU:pCPU can be used to convert the requirements of pools into physical ones.
For each cluster, the total requirements of the vCPU pools are divided by the coefficient:
vCPUsum / vCPU:pCPU = pCPUsum – required number of physical cores
pCPUsum / 1.25 = pCPUht – the number of cores adjusted for Hyper-Threading
Suppose we need to calculate a cluster for 190 cores / 3.5TB of RAM. In this case, we assume a target CPU load of 50% and 75% for RAM.
pCPU
190
CPU util
50%
Mem
3500
Mem util
75%
Socket
Core
Srv / CPU
Srv Mem
Srv / Mem
2
6
25,3
128
36,5
2
8
19,0
192
24,3
2
10
15,2
256
18,2
2
14
10,9
384
12,2
2
18
8,4
512
9,1
In this case, we always use rounding up to the nearest whole number (=ROUNDUP(A1;0)).
From the table, it becomes clear that several server configurations are balanced for the target indicators:
— 26 servers 2*6c / 192 GB
— 19 servers 2*10c / 256 GB
— 10 servers 2*18c / 512 GB
The choice among these configurations must be made based on additional factors, such as thermal package and available cooling, already used servers, or cost.
Features of server configuration selection
Wide VMs. If there is a need to host wide VMs (comparable to 1 NUMA node and more), it is advisable to choose a server configuration that allows such VMs to stay within a NUMA node. With a large number of wide VMs, there is a risk of fragmenting the cluster resources, and in this case, servers should be selected that allow wide VMs to be accommodated as closely as possible.
Size of the single point of failure domain.
The choice of server size is also made from the principle of minimizing the single point of failure domain. For example, when choosing between:
— 3 x 4*10c / 512 GB
— 6 x 2*10c / 256 GB
All other things being equal, the second option should be chosen since if one server fails (or is under maintenance), not 33% of the cluster's resources are lost, but 17%. Similarly, the number of VMs and IS affected by the failure is halved.
Beregning af klassisk SAN baseret på ydeevne
Klassisk SAN beregnes altid ud fra det værste scenarie (worst case scenario), som udelukker indflydelsen fra RAM-cache og optimering af operationer.
Som grundlæggende ydeevneparametre tager vi den mekaniske ydeevne fra disken (IOPSdisk):
— 7,2k – 75 IOPS
— 10k – 125 IOPS
— 15k – 175 IOPS
Antallet af diske i diskpuljen beregnes derefter med følgende formel: = TotalIOPS * ( RW + (1 –RW) * RAIDPen) / IOPSdisk. Hvor:
— TotalIOPS – den samlede krævede ydeevne i IOPS fra diskpuljen
— RW – procentdelen af læseoperationer
— RAIDpen – RAID-straf for det valgte RAID-niveau
Mere om RAID-enheder og RAID-straf findes her — og og
Baseret på det opnåede antal diske beregnes de mulige varianter, der opfylder kravene til lagerkapacitet, herunder muligheder med lagring på flere niveauer.
Beregning af systemer med SSD som lagerniveau betragtes separat.
Egenskaber ved beregning af systemer med Flash Cache
Flash Cache – en generel betegnelse for alle mærkespecifikke teknologier, der bruger flash-hukommelse som sekundært cache. Ved brug af flash-cache beregnes SAN typisk for at sikre, at belastningen fra magnetiske diske er stabil, mens den maksimale belastning håndteres af cachen.
Det er vigtigt at forstå belastningsprofilen og graden af lokaliserede henvendelser til lagervolumenerne. Flash-cache er en teknologi til belastninger med høj lokaliseringsintensitet og er praktisk talt uanvendelig for jævnt belastede volumener (som for eksempel til analyse systemer).
Beregning af hybride low-end/mid-range systemer
Hybrid systems of lower and mid-range use multi-level storage with scheduled data movement between levels. In this case, the block size of multi-level storage in the best models is 256 MB. These characteristics do not allow us to consider multi-level storage technology as a performance enhancement technology, as many mistakenly believe. Multi-level storage in lower and mid-range systems is a cost optimization technology for storage systems with pronounced uneven load.
For lagring på flere niveauer beregnes ydeevnen først og fremmest for det øverste niveau, mens det nederste lag kun betragtes som en medvirkende kapacitet. For et hybridlagringssystem er det afgørende at bruge flash-cache-teknologi for at kompensere for ydeevnedrop for pludseligt varme data fra det nederste niveau.
Brug af SSD i en multi-level diskpool
Brug af SSD i en multi-level diskpool har variationer afhængigt af producentens implementering af flash-cache-algoritmer.
Generel praksis for lagringspolitikken for en diskpool med SSD-niveau er – SSD first.
Read Only Flash Cache. For read-only flash cache, the SSD storage level appears when writing operations are significantly localized, regardless of the cache.
Read / Write Flash Cache. In the case of write flash cache, the maximum cache capacity is first set, and the SSD storage level only appears when the cache size is insufficient to handle the entire localized load.
The performance calculation for SSD and cache is performed each time based on the manufacturer's recommendations, but always for the worst-case scenario.
Kilde: habr.com
