

Introduktion
Det er tid til at købe en lagringssystem. Hvilket skal man vælge, og hvem skal man lytte til? Leverandør A fortæller om leverandør B, og så er der integrator C, som fortæller det modsatte og anbefaler leverandør D. Under sådanne omstændigheder kan selv en erfaren arkitekt inden for lagringssystemer blive forvirret, især med alle de nye leverandører og de trendy SDS og hyperkonvergens.
Så hvordan skal man navigere i alt dette uden at se dum ud? Vi ( Anton Zhbankov og Evgeny Elizarov) vil forsøge at forklare dette på et forståeligt sprog.
Artiklen har mange overlap, og er faktisk en udvidelse af “” med fokus på valg af lagringssystemer og en gennemgang af teknologierne bag lagringssystemer. Vi vil kort gennemgå den generelle teori, men anbefaler også at læse den nævnte artikel.
Hvorfor
Man kan ofte observere, hvordan en ny person kommer ind på et forum eller i en specialiseret chat, som for eksempel Storage Discussions, og stiller spørgsmålet: “jeg får tilbudt to muligheder for lagringssystemer — ABC SuperStorage S600 og XYZ HyperOcean 666v4, hvad anbefaler I?”
Og så begynder diskussionen om, hvem der har hvilke særtræk ved implementeringen af de skræmmende og uforståelige funktioner, som for en uuddannet person virker som kinesisk.
Så det første og mest grundlæggende spørgsmål, man skal stille sig selv lang tid før man sammenligner specifikationer i kommercielle tilbud — HVORFOR? Hvorfor har man brug for dette lagringssystem?
Svaret vil være overraskende, og meget i stil med Tony Robbins — for at opbevare data. Tak, kaptajn! Men nogle gange fordyber vi os så meget i sammenligningen af detaljer, at vi glemmer, hvorfor vi overhovedet gør alt dette.
Så beskyttelsen af lagringssystemet er at opbevare og give adgang til DATA med specificeret ydeevne. Det er fra dataene, at vi skal begynde.
Data
Datatype
Hvilke data planlægger vi at gemme? Et meget vigtigt spørgsmål, som kan udelukke rigtig mange Lagringssystemer fra overvejelserne. For eksempel, hvis vi planlægger at gemme videooptagelser og billeder. Vi kan straks udelukke systemer, der er beregnet til tilfældig adgang med små blokke, eller systemer med proprietære funktioner inden for kompression / deduplikation. Disse kan være fremragende systemer, og vi ønsker ikke at sige noget dårligt om dem. Men i dette tilfælde vil deres stærke sider enten blive svage (video og billeder kan ikke komprimeres) eller bare markant øge omkostningerne ved systemet.
Og omvendt, hvis den tilsigtede anvendelse er en belastet transaktionel database, så vil fremragende strømmede systemer til multimedier, der kan levere gigabyte per sekund, være et dårligt valg.
Data volumen
Hvor meget data planlægger vi at gemme? Mængden vokser altid til kvalitet, det må man aldrig glemme, især i vores tid med eksponentiel vækst i datamængden. Systemer i petabyte-klassen er allerede ikke usædvanlige, men jo større petabyte-volumen, jo mere specifik bliver systemet, og jo mindre vil den sædvanlige funktionalitet fra systemer med tilfældig adgang i lille og mellemstor mængde være tilgængelig. Simpelthen fordi selv statistikkerne for adgang til blokke bliver større end den tilgængelige mængde RAM på controllerne. For ikke at nævne kompression / tiering. Antag, at vi ønsker at skifte til en mere kraftfuld kompressionsalgoritme og presse 20 petabyte data. Hvor lang tid vil det tage: et halvt år, et år?
På den anden side, hvorfor gøre det kompliceret, hvis vi kun skal gemme og bearbejde 500 GB data? Kun 500. Almindelige SSD'er (med lav DWPD) i denne størrelse koster næsten ingenting. Hvorfor bygge en Fiber Channel-fabrik og købe et eksternt Lagringssystem i høj klasse, der koster en formue?
Hvilken procentdel af det samlede datavolumen udgør de varme data? Hvor ujævnt er belastningen i forhold til datamængden? Her kan teknologier som tiered storage eller Flash Cache være til stor hjælp, hvis mængden af varme data er minimal i forhold til totalen. Omvendt, ved en jævn belastning over det samlede volum, som ofte ses i streaming systemer (videoovervågning, visse analyse systemer), vil sådanne teknologier ikke give noget og blot øge omkostningerne/sværhedsgraden af systemet.
IS
Den modsatte side af data er et informationssystem, der bruger disse data. IS har et sæt krav, der arver dataene. Læs mere om IS i “Designet af virtualiserede datacentre”.
Krav til fejltolerance / tilgængelighed
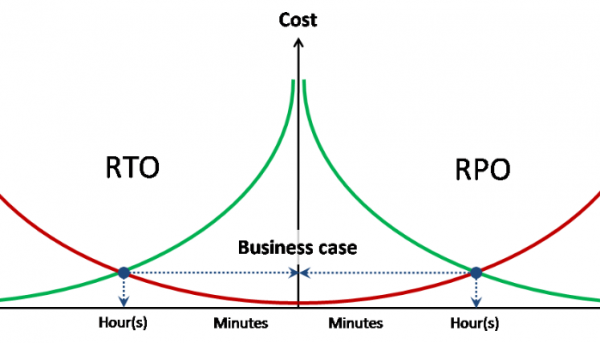
Kravene til fejltolerance / tilgængelighed af data arves fra det informationssystem, der bruger dem, og udtrykkes i tre tal — RPO, RTO, tilgængelighed.
Tilgængelighed — andelen af en given tidsperiode, hvor data er tilgængelige for behandling. Udtrykkes normalt i antallet af 9. For eksempel betyder to nicher om året, at tilgængeligheden er 99%, eller med andre ord tillades 95 timers utilgængelighed om året. Tre nicher — 9,5 timer om året.
RPO / RTO er ikke samlede mål, men gælder for hver hændelse (nedbrud), i modsætning til tilgængelighed.
RPO — mængden af data, der går tabt ved et nedbrud (i timer). For eksempel, hvis backup udføres dagligt, så er RPO = 24 timer. Dvs. Ved et nedbrud og et komplet tab af lagerenheden kan der mistes data svarende til op til 24 timer (fra tidspunktet for backup). Baseret på det angivne RPO for IS skrives der f.eks. en backup-regulering. Desuden kan man ud fra RPO forstå, hvor vigtigt det er med synkron eller asynkron data-replikation.
RTO — tiden til genopretning af tjenesten (adgang til data) efter et nedbrud. Baseret på den angivne RTO-værdi kan vi forstå, om der er brug for en metrocluster, eller om ensrettet replikation er tilstrækkeligt. Er der også brug for en multi-controller lagringsenhed i high-end klasse?
Krav til ydeevne
Selvom det er et helt åbenlyst spørgsmål, så opstår der ofte de fleste vanskeligheder med det. Afhængigt af, om man allerede har en eller anden infrastruktur eller ej, og der skal bygges måder til at indsamle den nødvendige statistik.
Har du allerede et lagringssystem, og leder du efter en erstatning eller ønsker du at købe et ekstra til udvidelse? Det er enkelt. Du ved, hvilke tjenester du allerede har, og hvilke du planlægger at implementere i den nærmeste fremtid. Baseret på de nuværende tjenester har du mulighed for at samle statistik over ydeevnen. Bestem det nuværende antal IOPS og de aktuelle latencer - hvordan er disse tal, og er de tilstrækkelige til dine opgaver? Dette kan gøres både på selve lagringssystemet og fra værtsiden, der er tilsluttet det.
Det er vigtigt at se på ikke kun den aktuelle belastning, men over en periode (helst en måned). Se på, hvad de maksimale toppe er i dagtimerne, hvilken belastning backup genererer osv. Hvis dit lagringssystem eller det software, der er tilknyttet det, ikke giver dig et komplet sæt af disse data, kan du bruge det gratis værktøj RRDtool, som kan arbejde med de fleste af de mest populære lagringssystemer og switches og kan give dig detaljeret statistik over ydeevnen. Det er også værd at se på belastningen på de værter, der arbejder med dette lagringssystem, specifikt på de virtuelle maskiner eller hvad der konkret kører på denne vært.
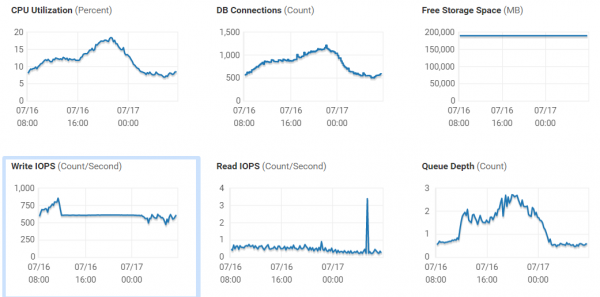
Det bør nævnes særskilt, at hvis latensen på volumen og datastore, der ligger på dette volumen, adskiller sig betydeligt - så bør du være opmærksom på dit SAN-netværk. Der er stor sandsynlighed for, at der er problemer med det, og før du køber et nyt system, skal du tage fat i dette spørgsmål, da der er en høj sandsynlighed for forbedring af ydeevnen på det nuværende system.
Du bygger en infrastruktur fra bunden, eller du køber et system til en ny tjeneste, hvis belastninger du ikke er bekendt med. Der er flere muligheder: tal med kolleger på relevante ressourcer for at forsøge at få en idé om og forudse belastningen, henvend dig til en integrator, der har erfaring med implementering af sådanne tjenester, og som kan beregne belastningen for dig. Den tredje mulighed (normalt den mest udfordrende, især hvis det drejer sig om skræddersyede eller sjældne applikationer) er at forsøge at afklare kravene til ydeevne med systemets udviklere.
Og, opmærksomhed, den mest korrekte variant med hensyn til praktisk anvendelse er en pilot på det nuværende udstyr eller udstyr, der stilles til rådighed til test af leverandøren/integratoren.
Specifikke krav
Specifikke krav er alt det, der ikke falder ind under kravene til ydeevne, fejltolerance og funktionalitet ved direkte behandling og levering af data.
Et af de simpleste specifikke krav til lagringssystemet kan betegnes som 'overførbare informationsbærere'. Og det bliver straks klart, at dette lagringssystem skal inkludere et båndbibliotek eller simpelthen en streamer, hvori en backup gemmes. Derefter underskriver en specielt uddannet person båndet og bærer stolt det ind i et særligt pengeskab.
Et andet eksempel på et specifikt krav er beskyttelsen mod stød.
Where
Den anden vigtigste faktor i valget af et givent lagringssystem er information om, HVOR dette system vil stå. Fra geografi eller klimatiske forhold til personalet.
Kunden
Hvem er denne lagringssystem planlagt til? Dette spørgsmål har følgende baggrund:
Offentlig kunde/kommerciel.
Den kommercielle kunde har ingen begrænsninger og er ikke engang forpligtet til at afholde udbud, bortset fra egne interne retningslinjer.
Den offentlige kunde er en anden sag. 44 FZ og andre fordele med udbud og kravspecifikationer, som kan blive anfægtet.
Kunde under sanktioner
Her er spørgsmålet meget enkelt — valget begrænses kun til de tilbud, der er tilgængelige for denne kunde.
Interne retningslinjer/leverandører godkendt til indkøb/modeller
Spørgsmålet er også meget enkelt, men det skal man huske på.
Hvor fysisk
I denne del ser vi på alle spørgsmål vedrørende geografi, kommunikationskanaler og mikroklimaet i lokalet, hvor systemet installeres.
Personalet
Hvem vil arbejde med dette lagringssystem? Dette er mindst lige så vigtigt som, hvad lagringssystemet direkte kan.
Uanset hvor lovende, fantastisk og fremragende lagringssystemet fra leverandør A måtte være, giver det sandsynligvis ikke meget mening at installere det, hvis personalet kun kan arbejde med leverandør B, og der ikke planlægges yderligere indkøb og konstant samarbejde med A.
Og selvfølgelig er det omvendte spørgsmål, hvor tilgængelig den nødvendige arbejdskraft er i denne geografiske placering, både i virksomheden og potentielt på arbejdsmarkedet. For regioner kan det have betydelig værdi at vælge lagringssystemer med enkle grænseflader eller mulighed for fjerncentreret administration. Ellers kan det på et tidspunkt blive smertefuldt. Internettet er fyldt med historier om, hvordan en ny medarbejder, der lige er blevet færdiguddannet, konfigurerede noget, så hele firmaet gik i stå.
Miljø
Og det er selvfølgeligt også en vigtig spørgsmål — hvilket miljø denne lagringssystem vil operere i.
- Hvad med strømforsyning / køling?
- Hvilken forbindelse
- Hvor vil den blive monteret
- Osv.
Disse spørgsmål betragtes ofte som en selvfølge og bliver ikke overvejet specielt, men nogle gange kan det netop være dem, der vender alt på hovedet.
Hvad
Leverandør
I dag (midten af 2019) kan det russiske marked for lagringssystemer opdeles i fem betingede kategorier:
- Øverste division — velrenommerede virksomheder med et bredt sortiment fra de enkleste diskregal til hi-end (HPE, DellEMC, Hitachi, NetApp, IBM / Lenovo)
- Anden division — virksomheder med et begrænset sortiment, nicheleverandører, seriøse SDS-leverandører eller nye spillere på markedet (Fujitsu, Datacore, Infinidat, Huawei, Pure osv.)
- Tredje division — nicheløsninger i low end, billig SDS, skræddersyede produkter baseret på ceph og andre åbne projekter (Infortrend, Starwind osv.)
- SOHO-segmentet — små og meget små lagringssystemer på niveau med hjem/kontor (Synology, QNAP osv.)
- Importerede lagringssystemer — disse inkluderer både hardware fra første division med omklæbede labels og sjældne repræsentanter fra anden division (RAIDIX, lad os give dem en chance som anden), men hovedsageligt er det tredje division (Aerodisk, Baum, Depo osv.)
Opdelingen er ret betinget og betyder slet ikke, at tredje eller SOHO-segmentet er dårlige og ikke kan anvendes. I specifikke projekter med klart definerede datasæt og belastningsprofiler kan de performe rigtig godt og langt overgå første division i forholdet mellem pris/ydelse. Det er vigtigt først at definere opgaverne, vækstmulighederne, den nødvendige funktionalitet — og så vil Synology tjene dig tro og loyalt, mens håret bliver blødt og silkeagtigt.
En af de vigtigste faktorer ved valg af leverandør er det nuværende miljø. Hvor mange og hvilke lagringssystemer har I allerede, og hvilke lagringssystemer kan ingeniørerne arbejde med? Har I brug for endnu en leverandør, endnu et kontaktpunkt, og vil I migrere hele belastningen gradvist fra leverandør A til leverandør B?
Man bør ikke skabe flere enheder end nødvendigt.
iSCSI / FC / File
Der er ingen enighed blandt ingeniørerne vedrørende adgangsprotokoller, og diskussionerne minder mere om teologiske debatter end om ingeniørarbejde. Men generelt kan man fremhæve følgende punkter:
FCoE er nærmere død end levende.
FC vs iSCSI. En af de vigtigste fordele ved FC i 2019 over IP-lagringssystemer, en dedikeret fabrik til adgang til data, udlignes af et dedikeret IP-netværk. Der er ingen globale fordele ved FC over IP-netværk, og på IP kan der bygges lagringssystemer med enhver belastningsniveau, ned til systemer til tunge databasesystemer for store bankers bankstyringssystemer. På den anden side har man spået FC's død i mange år, men noget forhindrer det stadig. I dag for eksempel udvikler nogle aktører på markedet aktivt standarden NVMEoF. Om det vil adskille FCoE's skæbne — vil tiden vise.
Filadgang er heller ikke noget, der er uværdigt for opmærksomhed. NFS / CIFS viser sig at fungere godt i produktionsmiljøer og har ved korrekt design ikke flere klager end blokkerede protokoller.
Hybrid / All Flash Array
Klassiske lagringssystemer findes i 2 typer:
- AFA (All Flash Array) — systemer, der er optimeret til brug af SSD.
- Hyrbid — som tillader brug af både HDD og SSD eller en kombination af dem.
Der primære forskel er de understøttede teknologier for lagringseffektivitet og det maksimale niveau af ydeevne (høje IOPS-værdier og lave latenser). Begge systemer (i de fleste af deres modeller, undtagen low-end-segmentet) kan fungere både som blok- og filsystemer. Det understøttede funktionalitet afhænger af systemets niveau, og hos de lavere modeller er det oftest begrænset til et minimalt niveau. Det er vigtigt at være opmærksom på dette, når du undersøger specifikationerne for en bestemt model, og ikke blot muligheden for hele sortimentet som helhed. Desuden afhænger de tekniske specifikationer for systemet også af niveauet, såsom CPU, hukommelseskapacitet, cache, antal og typer af porte osv. Set fra et styringsperspektiv adskiller AFA sig fra hybride (diskbaserede) systemer kun i måden, hvorpå SSD-lagringsenhederne håndteres, og selv hvis du bruger SSD'er i et hybrid-system, betyder det ikke, at du vil kunne opnå det præstationsniveau, som AFA-systemet repræsenterer. Derudover er inline mekanismerne for effektiv lagring i hybride systemer oftest deaktiverede, og aktiveringen af disse vil medføre et tab i ydeevne.
Specialiserede Lagringssystemer
Udover generelle lagringssystemer, der primært er rettet mod hurtig databehandling, findes der specialiserede lagringssystemer med centrale principper, der grundlæggende adskiller sig fra de gængse (lave latenser, mange IOPS):
Mediefiler.
Disse systemer er designet til at opbevare og behandle mediefiler, der er kendetegnet ved deres store størrelse. Derfor bliver latensen stort set irrelevant, og fokus rettes mod evnen til at modtage og sende data med en bred båndbredde i mange parallelle strømme.
Deduplicerende Lagringssystemer til Sikkerhedskopier.
Da sikkerhedskopier sjældent ligner hinanden under normale forhold (den gennemsnitlige sikkerhedskopi adskiller sig fra gårsdagens med 1-2%), er denne klassifikationssystem ekstremt effektiv til at komprimere de data, der er gemt på dem, inden for et relativt lille antal fysiske lagringsenheder. For eksempel kan kompressionsforholdet i enkelte tilfælde nå op på 200 til 1.
Objektbaserede Lagringssystemer.
I disse LAG er der ingen velkendte volumener med blokadgang og filshares; de minder mere om en stor database. Adgang til et objekt, der opbevares i et sådant system, sker via en unik identifikator eller via metadata (for eksempel alle objekter i JPEG-format, med oprettelsesdato mellem XX-XX-XXXX og YY-YY-YYYY).
Compliance-systemer.
De er ikke så almindelige i Rusland i dag, men det er værd at nævne dem. Formålet med sådanne LAG er at sikre datalagring i overensstemmelse med sikkerhedspolitikker eller regulatoriske krav. I nogle systemer (for eksempel EMC Centera) blev der implementeret en funktion til at forbyde sletning af data — så snart nøglen drejes, og systemet skifter til denne tilstand, kan hverken administratoren eller nogen anden fysisk slette allerede indspillede data.
Egen teknologi
Flash-cache
Flash-cache er et generelt udtryk for alle proprietære teknologier, der bruger flash-hukommelse som et cache-niveau. Ved brug af flash-cache er LAG normalt designet til at håndtere den etablerede belastning fra magnetiske diske, mens den peak-ydelse håndteres af cachen.
Det er vigtigt at forstå belastningsprofilen og graden af lokaliserede henvendelser til lagervolumenerne. Flash-cache er en teknologi til belastninger med høj lokaliseringsintensitet og er praktisk talt uanvendelig for jævnt belastede volumener (som for eksempel til analyse systemer).
To versioner af flash-cache er tilgængelige på markedet:
- Read Only. I dette tilfælde caches kun data til læsning, mens skrivning sker direkte på diskene. Nogle producenter, som for eksempel NetApp, mener, at skrivningen på deres LAG allerede foregår på optimal vis, og cachen vil ikke hjælpe.
- Read/Write. Både læsning og skrivning caches, hvilket gør det muligt at buffere strømmen og reducere indflydelsen af RAID-penalty, og dermed forbedre den samlede ydeevne for LAG med ikke så optimal skrive-mekanisme.
Tiering
Multiniveau lagring (tiering) er en teknologi, der kombinerer niveauer med forskellig ydeevne i en samlet diskpool, såsom SSD og HDD. I tilfælde af klart udtalte uensartetheder i henvendelserne til datablokke, vil systemet automatisk kunne ombalancere datablokkene ved at flytte de belastede til et højtydende niveau og de kolde til et langsommere.
Hybrid systems of lower and mid-range use multi-level storage with scheduled data movement between levels. In this case, the block size of multi-level storage in the best models is 256 MB. These characteristics do not allow us to consider multi-level storage technology as a performance enhancement technology, as many mistakenly believe. Multi-level storage in lower and mid-range systems is a cost optimization technology for storage systems with pronounced uneven load.
Snapshot
No matter how much we talk about the reliability of storage systems, there are many ways to lose data that do not depend on hardware problems. These can include viruses, hackers, or any other unintentional deletion or corruption of data. For this reason, backing up production data is an integral part of an engineer's work.
A snapshot is a snapshot of a volume at a certain point in time. When working with most systems, such as virtualization, databases, etc., we need to take such a snapshot from which we will copy data for backup, while our information systems can continue to operate with this volume. However, it is worth remembering that not all snapshots are equally useful. Different vendors have different approaches to creating snapshots related to their architecture.
CoW (Copy-On-Write). When attempting to write a block of data, its original content is copied to a special area, after which the write occurs normally. This prevents data corruption within the snapshot. Naturally, all these 'parasitic' manipulations with data create additional load on the storage system, and for this reason vendors with such implementation do not recommend using more than a dozen snapshots, and on heavily loaded volumes, to avoid using them altogether.
RoW (Redirect-on-Write). In this case, the original volume is naturally frozen, and when attempting to write a block of data, the storage system writes the data to a special area in free space, changing the location of this block in the metadata table. This reduces the number of overwrite operations, which ultimately mitigates performance degradation and lifts restrictions on snapshots and their quantity.
Snapshots findes også i to typer i forhold til applikationer:
Applikationskonsistent. Ved oprettelse af et snapshot aktiverer lagringssystemet agenten i slutbrugerens operativsystem, som tvangsmæssigt tømmer diskens cache fra hukommelsen til disken og tvinger applikationen til at gøre det. I dette tilfælde vil dataene være konsistente ved gendannelse fra snapshot'et.
Crash-konsistent. Her sker der ingenting lignende, og snapshot'et oprettes som det er. Ved gendannelse fra et sådant snapshot vil situationen være den samme som hvis strømmen pludselig blev afbrudt, hvilket kan medføre et vist datatab, hvor data er hængt i cache og ikke nået frem til disken. Disse snapshots er lettere at implementere og forårsager ikke nedgang i applikationens ydeevne, men er mindre pålidelige.
Hvorfor er snapshots nødvendige i lagringssystemer?
- Agentløs backup direkte fra lagringssystemet
- Oprettelse af testmiljøer baseret på ægte data
- I tilfælde af filbaserede lagringssystemer kan de bruges til at skabe VDI-miljøer ved hjælp af snapshots fra lagringssystemet i stedet for hypervisoren.
- Sikring af lave RPO'er ved at oprette snapshots efter en tidsplan med en hyppighed, der er væsentligt højere end backup-frekvensen
Kloning
Kloning af et volum er baseret på en lignende metode som snapshots, men det tjener ikke kun til at læse data, men til at arbejde fuldt ud med dem. Vi har mulighed for at få en præcis kopi af vores volumen, med alle dataene på det, uden at lave en fysisk kopi, hvilket vil spare plads. Kloning af volumener bruges normalt enten i test og udvikling, eller hvis du vil teste funktionaliteten af nogle opdateringer på dit information system. Kloning vil gøre dette så hurtigt og økonomisk som muligt i forhold til diskressourcer, da kun de ændrede datablokke vil blive skrevet.
Replikation / journaling
Replikation er en mekanisme til at lave en kopi af data på et andet fysisk lagringssystem. Der findes normalt en proprietær teknologi hos hver leverandør, der kun fungerer inden for sin egen produktlinje. Men der findes også tredjepartsløsninger, herunder dem der arbejder på hypervisor-niveau, som f.eks. VMware vSphere Replication.
Funktionaliteten af specialteknologier og brugervenligheden overstiger ofte universelle løsninger, men de viser sig at være utilgængelige, når der f.eks. er behov for at lave en replikation fra NetApp til HP MSA.
Replikation opdeles i to underkategorier:
Synchronous. Ved synkron replikation bliver skriveoperationen sendt til det andet lagersystem med det samme og bekræftes ikke, før det fjerne lagersystem har bekræftet det. Dette øger adgangsventetiden, men vi har en nøjagtig spejlbillede af dataene. Dvs. RPO = 0 i tilfælde af tab af det primære lagersystem.
Asynchronous. Skriveoperationer udføres kun på det primære lagersystem og bekræftes øjeblikkeligt, mens de akkumuleres i en buffer til batchoverførsel til det fjerne lagersystem. Denne type replikation er relevant for mindre værdifulde data eller for forbindelser med lav båndbredde eller høj ventetid (karakteristisk for afstande over 100 km). Derfor er RPO = frekvensen af batchoverførsel.
Ofte er der sammen med replikation en mekanisme for logging af diskoperationer. I dette tilfælde afsættes et særligt område til logning, og operationer lagres i en bestemt tidsdybde eller begrænset af logens størrelse. For nogle specialteknologier, som f.eks. EMC RecoverPoint, findes der integration med systemsoftware, der gør det muligt at knytte bestemte bogmærker til en bestemt post i loggen. Dette gør det muligt at tilbagestille volumenets tilstand (eller oprette en klon) ikke blot til den 23. april kl. 11:59:13, men til et tidspunkt, der forud for “DROP ALL TABLES; COMMIT”.
Metro cluster
Metro cluster — en teknologi, der muliggør tovejs synkron replikation mellem to lagersystemer, så parret ser ud som ét lagersystem. Anvendes til at skabe klynger med geografisk adskilte afstande på metroafstande (mindre end 100 km).
Ved brug i en virtualiseringsmiljø tillader metro-cluster at oprette et datastorage med virtuelle maskiner tilgængelige til skrivning i to datacentre samtidig. I dette tilfælde oprettes en klynge på hypervisor-niveau bestående af værter i forskellige fysiske datacentre, der er tilsluttet dette datastorage. Dette muliggør følgende:
- Fuld automatisering af genoprettelsesprocessen efter nedlukningen af et af datacentrene. Uden nogen yderligere midler vil alle VM'er, der har kørt i det nedlagte datacenter, automatisk blive genstartet i det tilbageværende. RTO = timeout for høj tilgængelighedsklyngen (15 sekunder for VMware) + tid til at starte operativsystemet og tjenester.
- Katastrofeundgåelse. Hvis der er planlagte strømarbejder i datacenter 1, har vi mulighed for at migrere al vigtig belastning til datacenter 2 uden stop, før arbejdet påbegyndes.
Virtualisering
Virtualisering af SAN er teknisk set brugen af volumener fra et andet SAN som diske. SAN-virtualisatoren kan simpelthen viderebringe en andens volumen til forbrugeren som sin egen, samtidig med at den spejler det til et andet SAN, eller endda skabe RAID fra eksterne volumener.
Klassiske repræsentanter i klassen for SAN-virtualisering inkluderer EMC VPLEX og IBM SVC. Og selvfølgelig SAN-enheder med virtualiseringsfunktion — NetApp, Hitachi, IBM / Lenovo Storwize.
Hvorfor kan det være nødvendigt?
- Reservedele på SAN-niveau. Et spejl oprettes mellem volumener, hvor den ene halvdel kan være på HP 3Par, og den anden på NetApp. Og virtualisatoren fra EMC.
- Flytning af data med minimal nedetid mellem SAN fra forskellige producenter. Lad os antage, at data skal migreres fra den gamle 3Par, som skal afskæres, til den nye Dell. I dette tilfælde afbrydes forbrugerne fra 3Par, volumenerne føres gennem VPLEX og præsenteres for forbrugerne igen. Da der ikke er ændret noget på volumen, fortsætter arbejdet. I baggrunden startes processen med at spejle volumen til den nye Dell, og når det er afsluttet, brydes spejlet, og 3Par afbrydes.
- Organisering af metroklustre.
Komprimering / deduplikering
Komprimering og deduplikering er teknologier, der gør det muligt at spare lagerplads på dit SAN. Det skal straks bemærkes, at ikke alle data i princippet kan komprimeres og/eller deduplikeres, samtidig med at nogle datatyper komprimeres og deduplikeres bedre, mens andre gør det modsatte.
Komprimering og deduplikering kommer i 2 typer:
Inline — komprimering og deduplikation af datablokke sker før disse data skrives til disken. På denne måde beregner systemet kun hash-værdien af blokken og sammenligner den med tabellen for allerede eksisterende. For det første udføres dette hurtigere end blot at skrive til disken, og for det andet sparer vi unødvendig diskplads.
Post — når disse operationer udføres på allerede skrevne data, der er på diskene. Dataene skrives først til disken, hvorefter hash-beregningen finder sted, og overflødige blokke slettes for at frigøre diskressourcer.
Det skal nævnes, at de fleste leverandører bruger begge metoder, hvilket gør det muligt at optimere disse processer og dermed forbedre deres effektivitet. De fleste leverandører af lagringssystemer har værktøjer, der giver mulighed for at analysere dine datasæt. Disse værktøjer fungerer efter den samme logik, som implementeres i lagringssystemerne, derfor vil den vurderede effektivitet være sammenfaldende. Det er heller ikke værd at glemme, at mange leverandører har programmer for garantier på effektivitet, som lover et niveau ikke lavere end det angivne for bestemte (eller alle) datatyper. Man bør ikke undervurdere dette program, da når man planlægger systemet til ens behov, under hensyntagen til effektiviteten af det specifikke system, kan man spare på volumen. Det er også vigtigt at bemærke, at disse programmer er designet til AFA-systemer, men ved at købe et mindre volumen af SSD i forhold til HDD i klassiske systemer, vil dette reducere omkostningerne, og hvis ikke helt nærme sig prisen for lagringssystemet, så vil det i hvert fald komme tættere på.
Model
Og her kommer vi til det korrekt stillede spørgsmål.
“Jeg får tilbudt to varianter af lagringssystemer - ABC SuperStorage S600 og XYZ HyperOcean 666v4, hvad vil du anbefale?”
Det omdannes til “Jeg får tilbudt to varianter af lagringssystemer - ABC SuperStorage S600 og XYZ HyperOcean 666v4, hvad vil du anbefale?”
Den målrettede belastning er blandede virtuelle VMware-maskiner fra produktions-/test-/udviklingsmiljøer. Test = produktion. 150 TB hver med spidsydelse på 80.000 IOPS ved 8kb blok med 50% tilfældig adgang 80/20 læsning-skrivning. 300 TB til udvikling, der vil 50.000 IOPS være tilstrækkeligt, 80 tilfældige, 80 skrivning.
Produktion er formodentlig i metrokluster RPO = 15 minutter RTO = 1 time, udvikling i asynkron replikation RPO = 3 timer, test på én platform.
Der vil være 50 TB databasesystem, det ville være godt for dem at have journaldannelse.
Vi har Dell-servere overalt, de gamle Hitachi-lagringsenheder klarede det knap, og vi planlægger en vækst på 50% i belastning både i volumen og ydeevne.
Som man siger, indeholder et korrekt formuleret spørgsmål 80% af svaret.
Yderligere oplysninger
Hvad bør man yderligere sætte sig ind i ifølge forfatterne.
Bøger
- Oliefer og Olifer 'Computer Networks'. Bogen hjælper med at systematisere og muligvis forstå bedre, hvordan dataoverførselsmiljøet fungerer for IP/Ethernet-lagringssystemer.
- EMC Information Storage and Management. En fremragende bog om grundene til, hvordan og hvorfor lagringssystemer fungerer.
Forums og chats.
Generelle anbefalinger
Priser
Nu hvad angår priserne - generelt når det kommer til lagringssystemer, er de priser, der dukker op, som regel listepriser, hvor hver kunde får en individuel rabat. Størrelsen af rabatten afhænger af mange faktorer, så det er simpelthen umuligt at forudsige, hvilken slutpris netop din virksomhed vil få uden at anmode distributøren. Men i den seneste tid er low-end modeller begyndt at dukke op i almindelige computerbutikker, såsom eksempelvis eller . I dem kan man straks købe det system, du er interesseret i, til en fast pris, ligesom enhver computerkomponent.
Men det skal straks bemærkes, at en direkte sammenligning på TB/$ ikke er korrekt. Hvis man ser det fra den vinkel, vil den billigste løsning være en simpel JBOD + server, hvilket ikke vil give den fleksibilitet eller pålidelighed, som en fuld, dual-controller lagerenhed tilbyder. Det betyder slet ikke, at JBOD er en dårlig løsning, man skal bare tydeligt forstå, hvordan og til hvilke formål du vil bruge denne løsning. Man hører ofte, at der ikke er noget, der kan gå i stykker i JBOD, der er jo kun én backplane. Men selv backplanes kan gå i stykker. Alt går i stykker før eller siden.
I alt
Man skal sammenligne systemer med hinanden ikke kun ud fra pris eller ikke kun ud fra ydeevne, men på baggrund af en samlet vurdering af alle faktorer.
Køb HDD, kun hvis du er sikker på, at du har brug for HDD. For lav belastning og usammenpresselige datatyper, bør du ellers kigge på garantiordninger for effektiv opbevaring på SSD, som nu findes hos de fleste leverandører (og de fungerer faktisk, selv i Rusland), men her afhænger det alt sammen af de applikationer og data, der skal være på denne SAN.
Jag ikke længere efter de billigste priser. Nogle gange skjuler der sig mange ubehagelige overraskelser bag dem, en af hvilke Evgeny Elizarov har beskrevet i sine artikler om . Og hvad der i sidste ende kan koste dig dyrt. Glem ikke - "den, der sparer, betaler to gange".
Kilde: habr.com
