

SDCM er slut, men den ukontrollerede trang til at skrive er stadig tilbage.
I mange år har vores bror lidt under at udføre rutinearbejde, krydset fingre inden commit og lidt søvn på grund af natlige rollback.
Men mørke tider har en ende.
Med denne artikel vil jeg starte en serie om, hvordan me automatisering ses.
Undervejs vil vi se på faserne i automatiseringen, opbevaring af variable, formaliseringsdesign, RestAPI, NETCONF, YANG, YDK, og vi vil programmere meget.
Jeg betyder, at a) det ikke er en objektiv sandhed, b) ikke nødvendigvis den bedste tilgang, c) mit syn kan ændre sig selv fra den første til den sidste artikel — ærligt talt, fra udkast til publicering har jeg omskrevet alt to gange.
Indhold
- Mål
- Netværket — som en enkelt organisme
- Testing af konfigurationen
- Versionering
- Overvågning og selvgenopretning af tjenester
- Værktøjer
- Inventarsystem
- IP-rumstyringssystem
- System til beskrivelse af netværkstjenester
- Enhedsinitialiseringsmekanisme
- Vendor-agnostisk konfigurationsmodel
- Vendor-specifik interface-driver
- Mekanisme til levering af konfiguration til enheden
- CI/CD
- Mekanisme til sikkerhedskopiering og afvigelsesforskning
- Overvågningssystem
- Konklusion
ADSMP vil jeg forsøge at føre på en lidt anderledes måde end SDCM. Store, omfattende nummerartikler vil stadig komme, og imellem dem vil jeg publicere små noter fra hverdagen. Jeg vil forsøge at bekæmpe perfektionismen her og ikke pudse hver enkelt af dem.
Hvor sjovt det er at skulle gennemgå den samme vej for anden gang.
Først måtte jeg selv skrive artikler om netværk, fordi de ikke eksisterede i den russiske internett.
Nu har jeg ikke kunnet finde et omfattende dokument, der systematiserer tilgange til automatisering og gennemgår de nævnte teknologier med simple praktiske eksempler.
Måske tager jeg fejl, så send links til gode ressourcer. Det vil dog ikke ændre min beslutsomhed til at skrive, fordi det overordnede mål er at lære noget selv, og at lette livet for andre er en dejlig bonus, der beroliger den gensidige deling af erfaring.
Vi vil prøve at tage et mellemstort datacenter LAN DC og arbejde med hele automatiseringsskemaet.
Nogle ting vil jeg gøre næsten for første gang sammen med dig.
I de beskrevne ideer og værktøjer vil jeg ikke være original. Dmitrij Figol har en fremragende .
Artiklerne vil på mange måder krydse hinanden.
I LAN DC er der 4 datacentre, omkring 250 switches, et halvt dusin routere og et par firewalls.
Det er ikke Facebook, men tilstrækkeligt til at man kan tænke dybt over automatisering.
Det er dog en udbredt opfattelse, at hvis man har mere end 1 enhed, er automatisering allerede nødvendig.
Det er faktisk svært at forestille sig, at nogen i dag kan leve uden mindst en bunke knap så grundlæggende scripts.
Selvfølgelig har jeg hørt om firmaer, hvor IP-adresser bliver registreret i Excel, og hver af de tusinde netværksenheder konfigureres manuelt og har sin egen unikke opsætning. Det kan man selvfølgelig kalde moderne kunst, men en ingeniørs følelser vil helt sikkert blive krænket.
Mål
I dag vil vi sætte de mest abstrakte mål:
- Netværket — som en enkelt organisme
- Testing af konfigurationen
- Versionsstyring af netværkets tilstand
- Overvågning og selvgenopretning af tjenester
Senere i denne artikel vil vi gennemgå hvilke værktøjer vi vil bruge, og i de følgende vil vi gå i dybden med både mål og midler.
Netværket — som en enkelt organisme
Den bestemte sætning i cyklen, selvom den ved første øjekast kan synes mindre betydningsfuld: vi vil konfigurere netværket, ikke enkeltstående enheder.
De seneste år har vi observeret et skift i fokus mod at behandle netværket som en samlet enhed, heraf de Software Defined Networking, Intent Driven Networks og Autonomous Networks.
For hvad har applikationerne globalt set brug for fra netværket: forbindelser mellem punkt A og B (nogle gange +C-D) og isolering fra andre applikationer og brugere.
Og dermed er vores opgave i denne serie — at opbygge et system, der understøtter den aktuelle konfiguration af hele netværket, som allerede kan dekomponeres til den aktuelle konfiguration på hver enhed i forhold til dens rolle og placering.
System netværksstyring indebærer, at for at foretage ændringer henvender vi os til det, og det beregner så den ønskede tilstand for hver enhed og konfigurerer den.
På den måde minimerer vi næsten helt behovet for at gå ind i CLI manuelt — alle ændringer i enhedernes indstillinger eller netværksdesign skal være formaliseret og dokumenteret — og først derefter rulles de ud på de relevante netværkelementer.
Det vil sige, for eksempel, hvis vi besluttede, at rack-switchene i Kazan fra nu af skal annoncere to netværk i stedet for ét, så
- Først dokumenterer vi ændringerne i systemerne
- Vi genererer den målrettede konfiguration for alle enheder i netværket
- Vi starter programmet til opdatering af netværkskonfigurationen, som beregner, hvad der skal fjernes på hver node, hvad der skal tilføjes, og bringer noderne til den ønskede tilstand.
I denne proces foretager vi manuelt ændringer kun i det første trin.
Testing af konfigurationen
, at 80% af problemerne opstår under ændring af konfigurationen – et indirekte bevis herpå er, at det normalt er stille i perioden omkring nytår.
Jeg har personligt været vidne til dusinvis af globale nedbrud på grund af menneskelige fejl: forkert kommando, udført i den forkerte konfigurationsgren, glemt community, globalt slettet MPLS på routeren, konfigureret fem enheder, men på den sjette bemærkede vi ikke fejlen, commitede gamle ændringer foretaget af en anden person. Der er utallige scenarier.
Automatisering vil tillade os at lave færre fejl, men i større skala. Således kan vi sætte ikke bare én enhed ud af drift, men hele netværket på én gang.
Siden tidernes morgen har vores forfædre kontrolleret korrektheden af de indførte ændringer med skarpt blik, stålæg og netværkets funktionalitet efter implementeringen.
De forfædre, hvis arbejde førte til nedetid og katastrofale tab, efterlod færre efterkommere og burde over tid uddø, men evolutionen er en langsom proces, og derfor er der stadig ikke alle, der på forhånd tester ændringer i et laboratorium.
Men på spidsen af fremskridtene er dem, der har automatiseret testprocessen for konfigurationen og dens efterfølgende anvendelse på netværket. Med andre ord – de har lånt CI/CD-processen () fra udviklerne.
I en af sektionerne vil vi se på, hvordan man realiserer dette ved hjælp af et versionskontrolsystem, sandsynligvis GitHub.
Så snart du vænner dig til ideen om netværk CI/CD, vil metoden til at kontrollere konfigurationen ved at anvende den på det arbejdsnetværk forekomme dig som tidlig middelalderlig uvidenhed. Lidt som at bankslå på en atomkrigsheading.
Den organiske forlængelse af idéerne om netværksstyringssystemet og CI/CD bliver et fuldstændigt versionsstyret konfiguration. управления сетью и CI/CD становится полноценное версионирование конфигурации.
Versionering
Vi vil antage, at ved enhver ændring, selv de mindste, selv på en usynlig enhed, går hele netværket fra en tilstand til en anden.
Og vi udfører altid ikke kommandoen på enheden, vi ændrer netværkets tilstand.
Lad os kalde disse tilstande versioner?
Lad os sige, at den aktuelle version er 1.0.0.
Skiftede Loopback-interface IP-adressen på en af Tor'erne? Det er en mindre version — den får nummer 1.0.1.
Reviderede importpolitikkerne for ruter i BGP — lidt mere alvorligt — allerede 1.1.0.
Bestemte os for at slippe af med IGP og kun skifte til BGP — det er allerede en radikal ændring af design — 2.0.0.
Derudover kan forskellige datacentre have forskellige versioner — netværket udvikler sig, nyt udstyr installeres, nogle steder tilføjes nye spines niveauer, andre steder ikke osv.
Om vi vil tale om det i en separat artikel.
Jeg gentager — enhver ændring (bortset fra fejlfinding kommandoer) er en versionopdatering. Administratorer skal informeres om eventuelle afvigelser fra den aktuelle version.
Det samme gælder for tilbagesendelse af ændringer — det handler ikke om at annullere de seneste kommandoer, det er ikke et rollback udført af en enheds operativsystem — det er at bringe hele netværket til en ny (gammel) version.
Overvågning og selvgenopretning af tjenester
Denne åbenlyse opgave i moderne netværk når et nyt niveau.
Ofte praktiserer store serviceudbydere den tilgang, at en nedbrudt service skal hurtigt rettes og en ny skal tændes, i stedet for at finde ud af, hvad der skete.
«Meget» betyder, at man fra alle sider skal være rigeligt dækket ind med overvågning, der inden for sekunder opdager de mindste afvigelser fra normen.
Og her er det ikke nok med de sædvanlige målinger, som belastningen på grænsefladen eller tilgængeligheden af noden. Det er heller ikke nok med den manuelle overvågning, som vagthavende foretager.
For mange ting skal der faktisk være — overvågningerne tændte rødt, og de gik selv og lagde et plaster der, hvor det gør ondt.
Og her overvåger vi heller ikke kun enkelte enheder, men hele netværkets sundhed, både som hvidboks, hvilket er relativt forståeligt, og som sortboks, hvilket er mere komplekst.
Hvad har vi brug for til at realisere sådanne ambitiøse planer?
- At have en liste over alle enheder i netværket, deres placering, roller, modeller, softwareversioner.
kazan-leaf-1.lmu.net, Kazan, leaf, Juniper QFX 5120, R18.3. - At have et system til beskrivelse af netværkstjenester.
IGP, BGP, L2/3VPN, Policy, ACL, NTP, SSH. - At være i stand til at initialisere en enhed.
Værtsnavn, Mgmt IP, Mgmt Rute, Brugere, RSA-nøgle, LLDP, NETCONF - Konfigurere enheden og bringe konfigurationen til den ønskede (herunder gamle) version.
- Test konfigurationen
- Regelmæssigt kontrollere tilstanden af alle enheder for afvigelser fra det aktuelle og informere de relevante parter.
Om natten tilføjede nogen stille et regel i ACL. - Overvåge driftsstatus.
Værktøjer
Det lyder ret komplekst, når man skal begynde at dekomponere projektet i komponenter.
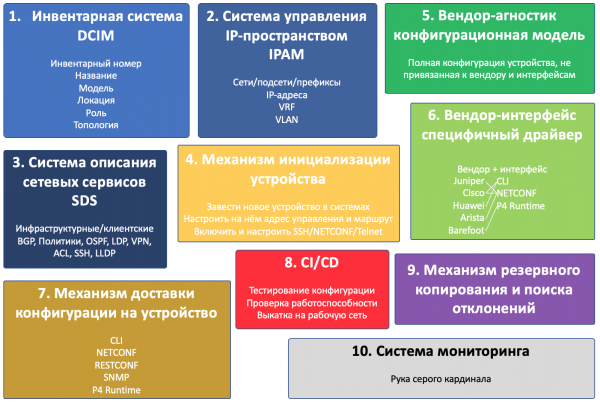
Og der vil være ti af dem:
- Inventarsystem
- IP-rumstyringssystem
- System til beskrivelse af netværkstjenester
- Enhedsinitialiseringsmekanisme
- Vendor-agnostisk konfigurationsmodel
- Vendor-specifik interface-driver
- Mekanisme til levering af konfiguration til enheden
- CI/CD
- Mekanisme til sikkerhedskopiering og afvigelsesforskning
- Overvågningssystem
Dette er for øvrigt et eksempel på, hvordan synet på målene i cyklussen har ændret sig — i udkastet til komponenterne var der 4.
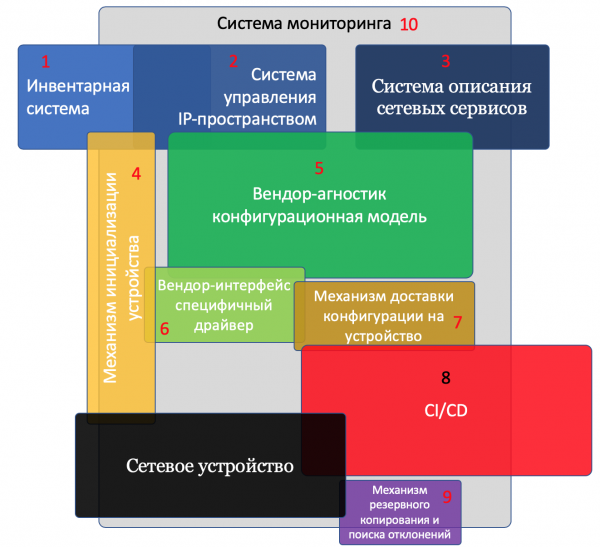
På illustrationen har jeg skildret alle komponenter og selve enheden.
Sammenfaldende komponenter interagerer med hinanden.
Jo større blokkene er, jo mere opmærksomhed kræver denne komponent.
Komponent 1. Inventar-system
Det er åbenlyst, at vi ønsker at vide, hvilket udstyr der står hvor, og hvad det er tilsluttet.
Inventar-systemet er en uundgåelig del af enhver virksomhed.
Ofte har virksomheder et særskilt inventar-system for netværksenheder, som løser mere specifikke opgaver.
I denne artikelcyklus vil vi referere til dette som DCIM — Data Center Infrastructure Management. Selvom termen DCIM strengt talt dækker meget mere.
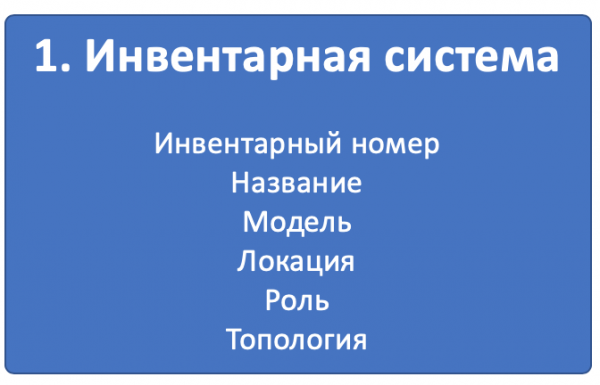
Til vores formål vil vi gemme følgende oplysninger om enheden:
- Inventarnummer
- Navn/beskrivelse
- Model (Huawei CE12800, Juniper QFX5120 osv.)
- Karakteristiske parametre (kredse, grænseflader osv.)
- Rolle (Leaf, Spine, Border Router osv.)
- Lokation (region, by, datacenter, rack, enhed)
- Interkonnekter mellem enheder
- Netværkstopologi
Det er klart, at vi gerne selv vil vide alt dette.
Men hjælper det med automatisering?
Bestemt.
For eksempel ved vi, at i dette datacenter skal ACL til filtrering af bestemt trafik på Leaf-switches, hvis det er Huawei, anvendes på VLAN, mens det, hvis det er Juniper, skal anvendes på unit 0 af den fysiske grænseflade.
Eller skal en ny Syslog-server rulles ud på alle grænser i regionen.
Her vil vi også gemme virtuelle netværksenheder, såsom virtuelle routere eller rutereflektorer. Vi kan tilføje DNS-servere, NTP, Syslog, og generelt alt, der omhandler netværket.
Komponent 2. IP-adressehåndteringssystem
Ja, i vores tid findes der stadig grupper af mennesker, der holder styr på præfikser og IP-adresser i Excel-filer. Men den moderne tilgang er trods alt en database, med et frontend på nginx/apache, API og omfattende funktioner til at holde styr på IP-adresser og netværk med opdeling i VRF.
IPAM – IP Adresse Management.
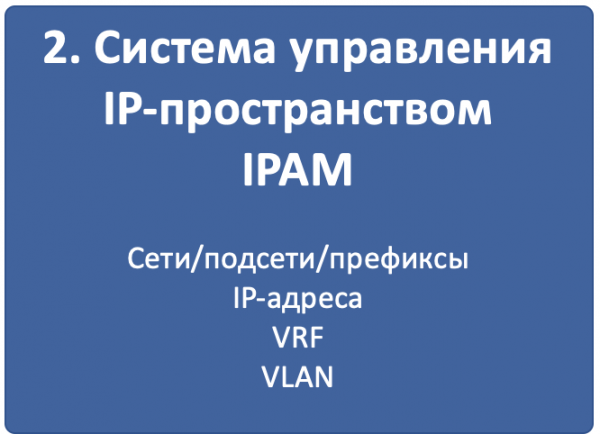
Til vores opgaver vil vi opbevare følgende information i den:
- VLAN
- VRF
- Netværk/Subnetværk
- IP-adresser
- Binding af adresser til enheder, netværk til lokationer og VLAN-numre
Det er også klart, at vi vil være sikre på, at når vi tildeler en ny IP-adresse til en ToR-loopback, ikke støder vi på, at den allerede er blevet tildelt nogen. Eller at vi har brugt den samme præfiks to gange i forskellige dele af netværket.
Men hvordan kan det hjælpe med automatisering?
Nem.
Vi anmoder systemet om præfikset med rollen Loopbacks, hvor der er tilgængelige IP-adresser til tildeling – hvis det findes, tildeler vi adressen, hvis ikke, anmoder vi om oprettelse af et nyt præfiks.
Eller når vi opretter konfigurationen af en enhed, kan vi fra dette system finde ud af, hvilket VRF interfacet skal være en del af.
Når en ny server startes, går scriptet til systemet, finder ud af, hvilken serverswitch, hvilken port og hvilket subnet der er tildelt interfacet – og derfra vil den tildeles serverens adresse.
Det er fristende at kombinere DCIM og IPAM i ét system, så vi ikke duplicerer funktioner og skal vedligeholde to lignende enheder.
Og det vil vi gøre.
Komponent 3. System til beskrivelse af netværkstjenester
Hvis de første to systemer gemmer variabler, som stadig skal bruges på en eller anden måde, så beskriver den tredje, hvordan hver rolle enhed skal konfigureres.
Det er værd at fremhæve to forskellige typer netværkstjenester:
- Infrastruktur
- Kunde.
De første er designet til at sikre basiskonnectivitet og enhedshåndtering. Dette kan inkludere VTY, SNMP, NTP, Syslog, AAA, routingprotokoller, CoPP osv.
De sidstnævnte organiserer en tjeneste til kunden: MPLS L2/L3VPN, GRE, VXLAN, VLAN, L2TP osv.
Selvfølgelig er der også grænsetilfælde – hvor skal MPLS LDP, BGP henregnes? Og routingprotokoller kan også bruges til kunder. Men det er ikke afgørende.
Begge typer tjenester deles op i konfigurationsprimitive:
- fysiske og logiske grænseflader (tag/antag, mtu)
- IP-adresser og VRF (IP, IPv6, VRF)
- ACL og trafikbehandlingspolitikker
- Protokoller (IGP, BGP, MPLS)
- Routingpolitikker (præfiks-lister, communities, ASN-filtre).
- Driftstjenester (SSH, NTP, LLDP, Syslog…)
- O.s.
Hvordan vi præcist vil gøre dette, har jeg endnu ikke fundet ud af. Vi vil se på det i en separat artikel.
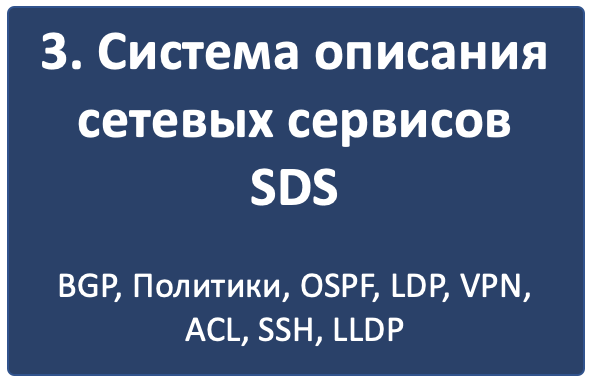
Hvis vi ser lidt mere på livet, kunne vi beskrive, hvad
Leaf-switchen skal have BGP-sessioner med alle tilsluttede Spine-switches, importere de tilsluttede netværk til processen, og kun acceptere netværk fra Spine-switches med en bestemt præfiks. Begrænse CoPP IPv6 ND til 10 pps o.s.v.
Spine-switchene har sæder med alle tilsluttede Leaf-både, fungerer som root-reflektorer og modtager kun ruter af en bestemt længde og med et bestemt community.
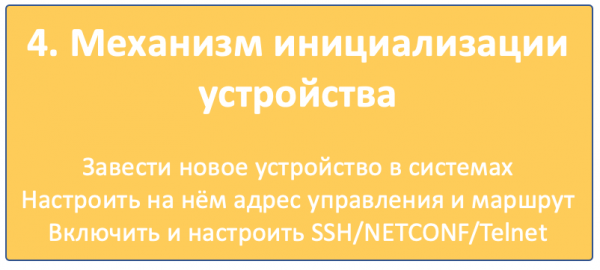
Komponent 4. Enhedens initialiseringsmekanisme
Under denne overskrift samler jeg mange handlinger, der skal finde sted, for at enheden kan blive synlig og være tilgængelig fjernbetjent.
- Tilføj enheden til inventarsystemet.
- Tildele en IP-adresse til administration.
- Konfigurere grundlæggende adgang til den:
Hostname, administrations-IP-adresse, rute til administrationsnetværket, brugere, SSH-nøgler, protokoller — telnet/SSH/NETCONF
Der er tre tilgange:
- Alt helt manuelt. Enheden bringes til en stand, hvor en almindelig person tilmelder den i systemerne, tilslutter sig via konsollen og konfigurerer den. Kan fungere i små statiske netværk.
- ZTP — Zero Touch Provisioning. Udstyr ankom, blev tilsluttet, fik en adresse via DHCP og gik til en speciel server for at selvkonfigurere.
- Infrastrukturen for konsolservere, hvor den primære konfiguration sker via konsolporten i automatiseret tilstand.
Vi vil tale om alle tre i en separat artikel.
Komponent 5. Vendor-agnostisk konfigurationsmodel
Indtil nu har alle systemer været usammenhængende lapper, der giver variable og deklarative beskrivelser af, hvad vi gerne ville se i netværket. Men før eller siden må vi håndtere konkretisering.
I dette trin kombineres primitivene, tjenesterne og variablerne for hvert specifikt udstyr i en konfigurationsmodel, der faktisk beskriver den fulde konfiguration af det specifikke udstyr, men på en vendor-uafhængig måde.
Hvad giver dette skridt? Hvorfor ikke straks danne konfigurationen af udstyret, så den bare kan uploades?
Dette løser faktisk tre opgaver:
- Undgå at tilpasse sig et specifikt interface til interaktion med enhed. Uanset om det er CLI, NETCONF, RESTCONF, SNMP — modellen vil være den samme.
- Undgå at have et antal skabeloner/scripts svarende til antallet af leverandører i netværket, og hvis designet ændres, skal du ændre det samme på flere steder.
- Indlæs konfigurationen fra enheden (backup), distribuer den i nøjagtig samme model og sammenlign den ønskede konfiguration med den eksisterende for at beregne deltaet og forberede en konfigurationspatch, der kun ændrer de dele, der er nødvendige, eller til at identificere afvigelser.
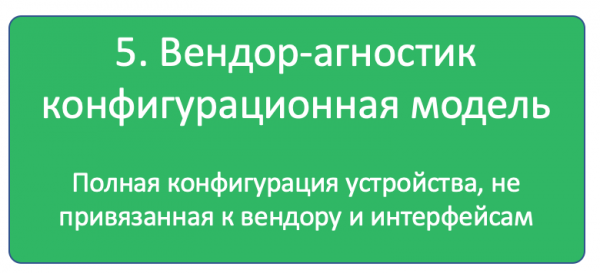
Som et resultat af dette trin får vi en leverandør-uafhængig konfiguration.
Komponent 6. Leverandør-interface specifik driver
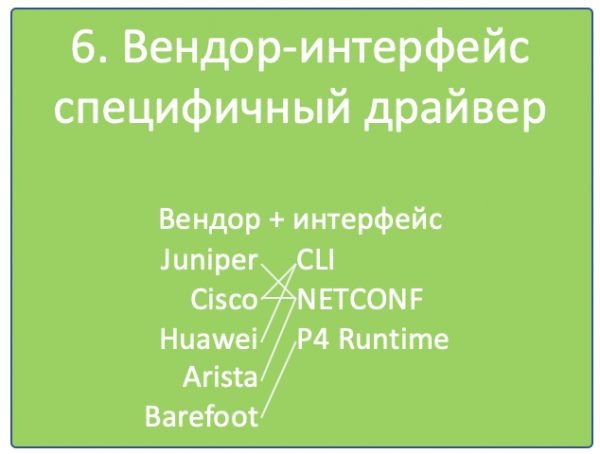
Det er ikke værd at narre sig selv med håb om, at man en dag vil kunne konfigurere Cisco præcist som Juniper ved blot at sende helt ens kald til dem. På trods af den stigende popularitet af whiteboxe og introduktionen af støtte til NETCONF, RESTCONF, OpenConfig, er det specifikke indhold, som disse protokoller leverer, forskelligt fra leverandør til leverandør, og det er en af deres konkurrencefordele, som de ikke så let vil give afkald på.
Det er omtrent det samme som OpenContrail og OpenStack, der har RestAPI som deres NorthBound-interface, men forventer helt forskellige kald.
Så på det femte trin skal den leverandør-uafhængige model tage den form, den skal have, når den skal på hardware.
Og her er alle midler gode (næsten): CLI, NETCONF, RESTCONF, SNMP — alle de gode gamle.
Derfor har vi brug for en driver, der konverterer resultatet fra det forrige trin til det nødvendige format for den specifikke leverandør: et sæt CLI-kommandoer, XML-struktur.
Komponent 7. Mekanisme til levering af konfiguration til enheden
Vi har genereret konfigurationen, men den skal også leveres til enhederne — og åbenbart ikke manuelt.
For det første, foran os opstår spørgsmålet om, hvilken transport vi skal bruge? Valget i dag er allerede ikke lille:
- CLI (telnet, ssh)
- SNMP
- NETCONF
- RESTCONF
- REST API
- OpenFlow (selvom det falder udenfor listen, da det er en måde at levere FIB, ikke konfigurationer)
Lad os her få afklaret tingene. CLI — det er legacy. SNMP… ahem.
RESTCONF — er stadig en ukendt størrelse, REST API understøttes næsten ikke af nogen. Derfor vil vi i cyklen fokusere på NETCONF.
Som faktisk allerede læseren har forstået, har vi omkring dette tidspunkt allerede bestemt os for grænsefladen — resultatet af det tidligere trin er allerede præsenteret i formatet af den valgte grænseflade.
For det andet, og hvilke værktøjer vil vi bruge til at gøre det?
Her er valget også stort:
- Eget skript eller platform. Lad os bevæbne os med ncclient og asyncIO og gøre det selv. Hvad koster det os at bygge et deploymentsystem fra bunden?
- Ansible med sit righoldige bibliotek af netværksmoduler.
- Salt med sit sparsomme arbejde med netværk og forbindelsen til Napalm.
- Egentlig Napalm, som kender et par leverandører og det hele; farvel.
- Nornir — endnu et lille dyr, som vi vil dissekere i fremtiden.
Her er der ikke valgt en favorit endnu — vi skal se os omkring.
Hvad er ellers vigtigt her? Konsekvenserne af anvendelsen af konfigurationen.
Om det er vellykket eller ej. Er der stadig adgang til hardwaren eller ej.
Det ser ud til, at et commit med bekræftelse og validering af, hvad der er blevet indlæst på enheden, vil hjælpe her.
Dette sammen med en korrekt implementering af NETCONF indsnævrer markant kredsen af egnede enheder — normale commits understøttes ikke af mange producenter. Men dette er bare et af de obligatoriske vilkår i . I sidste ende bekymrer ingen sig om, at ingen russiske leverandører vil opfylde betingelsen for 32*100GE-grænsefladen. Eller gør de?
Komponent 8. CI/CD
På dette tidspunkt har vi allerede en konfiguration klar til alle netværksenheder.
Jeg skriver "til alle", fordi vi taler om versionering af netværkets tilstand. Og selv hvis der kun er behov for at ændre indstillingerne for en enkelt switch, beregnes ændringerne for hele netværket. Det er очевидно, at de kan være nul for de fleste noder.
Men som allerede nævnt ovenfor, er vi jo ikke nogle barbarer, der smider alt lige ind i produktion.
Den genererede konfiguration skal først gå gennem Pipeline CI/CD.
CI/CD står for Continuous Integration, Continuous Deployment. Det er en tilgang, hvor teamet ikke tilbyder en ny stor opdatering hver sjette måned og helt erstatter den gamle, men regelmæssigt inkrementelt implementerer (Deployment) ny funktionalitet i små portioner, som hver især bliver grundigt testet for kompatibilitet, sikkerhed og funktionalitet (Integration).
Til dette har vi et versionskontrolsystem, der holder øje med ændringerne i konfigurationen, et laboratorium, hvor vi tester, om kundeservicen ikke går ned, et overvågningssystem, der kontrollerer dette, og det sidste trin – udrulning af ændringer til det operative netværk.
Med undtagelse af debug-kommandoer skal absolut alle ændringer på netværket gå gennem CI/CD Pipeline – det er vores garanti for en rolig tilværelse og en lang, lykkelig karriere.
Komponent 9. Backup- og afvigelsesfindingssystem
Det er ikke nødvendigt at tale om backups endnu en gang.
Vi vil bare gemme dem enten via cron eller når konfigurationen ændres i git.
Den anden del er mere interessant – nogen skal holde øje med disse backups. I nogle tilfælde skal denne person gå tilbage og gendanne alt som det var, mens de i andre tilfælde skal meow til nogen om, at der er problemer.
For eksempel, hvis der er kommet en ny bruger, som ikke er angivet i variablerne, bør man fjerne dem langt væk fra hack. Og hvis der er en ny firewallregel – bedre ikke at røre ved den, måske har nogen bare aktiveret debugging, eller måske har den nye, klodsede service ikke registreret det korrekt, og nu er der allerede brugere, der er gået ind.
På trods af enhver automatisering og en stålfast ledelse, vil vi ikke undslippe en lille delta i skalaen af hele netværket. Ingen vil ændre konfigurationen i systemerne for at debugge problemer. Desuden er det muligt, at konfigurationsmodellen slet ikke forudser dem.
For eksempel, en firewallregel til at tælle antallet af pakker til en bestemt IP for at lokalisere problemer – det er helt almindelig midlertidig konfiguration.
Komponent 10. Overvågningssystem
Først havde jeg ikke tænkt mig at belyse emnet overvågning – det er jo en omfattende, kontroversiel og kompleks sag. Men i takt med forløbet af begivenhederne viste det sig, at det er en uundgåelig del af automatiseringen. Og man kan ikke omgå det, selv uden praktisk erfaring.
Når man viderefører tanken – dette er en organisk del af CI/CD-processen. Efter udrulningen af konfigurationen til netværket, skal vi kunne afgøre, om alt nu er i orden med det.
Og det handler ikke kun og slet ikke kun om grafik af interfacebrug eller tilgængelighed af noder, men også om de mere subtile ting – tilstedeværelsen af de nødvendige ruter, attributter på dem, antallet af BGP-sessioner, OSPF-naboer, End-to-End-funktionalitet af overordnede services.
Er systemloggene stoppet med at blive sendt til den eksterne server, eller er SFlow-agenten brudt ned, eller er der begyndt at opstå drops i køerne, eller er forbindelsen mellem et eller andet par af præfikser blevet brudt?
I en separat artikel vil vi reflektere over dette også.
Konklusion
Som grundlag har jeg valgt et af de moderne datacenterdesigns - L3 Clos Fabric med BGP som routingprotokol.
Denne gang bygger vi netværket på Juniper, fordi JunOs-grænsefladen nu er en joyride.
Vi vil gøre det lidt mere kompliceret ved kun at bruge Open Source værktøjer og et multivendor-netværk - så jeg vil på vejen vælge endnu en heldig vinder udover Juniper.
Planen for de kommende publikationer ser omtrent sådan ud:
Først vil jeg tale om virtuelle netværk. Først og fremmest, fordi jeg har lyst til det, og for det andet, fordi uden det vil designet af infrastruktur-netværket ikke være særlig klart.
Derefter om netværksdesign: topologi, routing, politikker.
Vi vil samle et laboratorieopstilling.
Vi vil reflektere og måske øve os i at initialisere en enhed i netværket.
Og derefter om hver komponent i intime detaljer.
Og ja, jeg lover ikke at afslutte denne cyklus med en elegant løsning. 🙂
Nyttige links
- Før vi dykker ned i serien, er det værd at læse bogen af Natasha Samoylenko . Måske også tage .
- Det vil også være nyttigt at læse om design af datacenterfabrikker fra Facebook skrevet af Peter Lapukhov.
- Dokumentationen om arkitekturen (tidligere Open Contrail) vil give dig en forståelse af, hvordan Overlay SDN fungerer.
Tak
Roman Gorge. For kommentarer og rettelser.
Artem Chernobai. For KDPV.
Kilde: habr.com
