

I Jeg har beskrevet rammerne for netværksautomatisering. Ifølge tilbagemeldinger hos nogle personer har denne første tilgang til problemet allerede afklaret nogle spørgsmål. Det glæder mig, fordi vores mål i cyklen ikke er at dække Ansible med Python-scripts, men at opbygge et system.
Dette rammeværk fastlægger også rækkefølgen, hvori vi vil tackle emnet.
Og netværksvirtualisering, som dette afsnit er dedikeret til, falder ikke helt ind under temaet ADSM, hvor vi diskuterer automatisering.
Men lad os se på det fra en anden vinkel.
I lang tid har mange tjenester været afhængige af det samme netværk. I tilfælde af en teleudbyder kan det være 2G, 3G, LTE, bredbånd og B2B, for eksempel. I tilfælde af datacentre: forbindelse til forskellige kunder, internettet, bloklagring, objektslagring.
Og alle tjenester kræver isolation fra hinanden. Derfor opstod overlay-netværk.
Og alle tjenester vil ikke vente på, at en person manuelt konfigurerer dem. Derfor opstod orkestratorer og SDN.
Den første systematiske tilgang til netværksautomatisering, nærmere bestemt dens del, er længe blevet forsøgt og implementeret mange steder: VMWare, OpenStack, Google Compute Cloud, AWS, Facebook.
Lad os dykke ned i dette i dag.
Indhold
- Årsager
- Terminologi
- Underlay — fysisk netværk
- Overlay — virtuelt netværk
- Overlay fra ToR
- Overlay fra host
- På eksemplet med Tungsten Fabric
- Kommunikation inden for én fysisk maskine
- Kommunikation mellem VM'er, der er placeret på forskellige fysiske maskiner
- Udgang til den ydre verden
- FAQ
- Konklusion
- Nyttige links
Årsager
Og siden vi taler om det, er det værd at nævne forudsætningerne for netværksvirtualisering. Faktisk begyndte denne proces ikke i går.
Du har sikkert hørt, at netværket altid har været den mest inaktive del af ethvert system. Og det er sandt i alle henseender. Netværket er det fundament, som alt hviler på, og det er ret svært at foretage ændringer i det — tjenester kan ikke tåle, når netværket er nede. Ofte kan nedetid på én node nedlægge mange applikationer og påvirke mange kunder. Delvis derfor kan netværks-teamet modstå enhver ændring — fordi det lige nu fungerer på en eller anden måde (vi ved måske endda ikke hvordan), og nu skal noget nyt konfigureres, og det er usikkert, hvordan det vil påvirke netværket.
For ikke at skulle vente på, at netværksfolkene opsætter VLAN og registrerer tjenester på hver enkelt nodes netværk, har folk fundet på at bruge overlays — lagdelte netværk — der findes i mange variationer: GRE, IPinIP, MPLS, MPLS L2/L3VPN, VXLAN, GENEVE, MPLSoverUDP, MPLSoverGRE osv.
Deres tiltrækningskraft ligger i to enkle ting:
- Kun slutnoderne skal konfigureres — transit nodene skal ikke røres. Det fremskynder processen markant og kan nogle gange helt undgå, at netværksafdelingen involveres ved indførelsen af nye tjenester.
- Belastningen er skjult dybt inde i overskrifterne — transitnoderne behøver ikke at vide noget om det, om adressering på værterne, ruter i det lagdelte netværk. Det betyder, at der skal opbevares mindre information i tabellerne, hvilket betyder, at man kan vælge enklere/ billigere udstyr.
I denne ikke helt udtømmende udgave planlægger jeg ikke at gennemgå alle mulige teknologier, men snarere beskrive rammerne for arbejdsgangen i overlay-netværk i datacenteret.
Hele serien vil beskrive et datacenter, der består af rækker af ensartede skabe, hvor identisk serverudstyr er installeret.
På dette udstyr køres virtuelle maskiner/containere/serverless, der implementerer tjenester.
Terminologi
I cyklussen serveren vil jeg kalde programmet, der implementerer serversiden af klient-server kommunikation.
De fysiske maskiner i skabene vil blive kaldt servere ikke vil vi.
Den fysiske maskine — en x86-computer, der er installeret i et rack. Den mest anvendte betegnelse host. Så vi vil kalde den «maskine» eller host.
Hypervisor — en applikation, der kører på den fysiske maskine og emulerer de fysiske ressourcer, som de Virtuelle Maskiner kører på. I nogle litterære værker og på nettet bruges ordet «hypervisor» som synonym for «host».
Virtuel maskine — et operativsystem, der kører på den fysiske maskine ovenfor hypervisoren. For os i denne cyklus er det ikke så vigtigt, om det virkelig er en virtuel maskine eller blot en container. Det vil vi kalde «VM«
Tenant — et bredt begreb, som jeg i denne artikel definerer som en separat tjeneste eller en separat klient.
Multi-tenancy eller multi-leje — brugen af den samme applikation af forskellige klienter/tjenester. Kundenes isolering fra hinanden opnås gennem applikationens arkitektur og ikke ved separat kørende instanser.
ToR — Top of the Rack-switch — en switch, der er installeret i en rack, til hvilken alle fysiske maskiner er tilsluttet.
Udover ToR-topologien praktiserer forskellige udbydere End of Row (EoR) eller Middle of Row (selvom sidstnævnte er sjælden, og jeg har ikke mødt forkortelsen MoR).
Underlay-netværk eller underliggende netværk eller anderlayers — den fysiske netværksinfrastruktur: switches, routere, kabler.
Overlay-netværk eller overliggende netværk eller overlays — et virtuelt netværk af tunneler, der fungerer oven på det fysiske.
L3-fabrik eller IP-fabrik — en fantastisk menneskelig opfindelse, der gør det muligt ikke at gentage STP under samtaler og ikke at lære TRILL. Et koncept, hvor hele netværket op til adgangsniveauet udelukkende er L3, uden VLAN og dermed enorme strakte broadcast-domæner. Hvor ordet „fabrik“ stammer fra, vil vi undersøge i næste del.
SDN — Software Defined Network. Trænger næppe til præsentation. En tilgang til netværksstyring, hvor ændringer i netværket udføres ikke af mennesker, men af et program. Betyr normalt, at Control Plane flyttes uden for de endelige netværksenheder til en controller.
NFV — Network Function Virtualization — virtualisering af netværksenheder, hvilket indebærer, at dele af netværksfunktionerne kan køres som virtuelle maskiner eller containere for at fremskynde implementeringen af nye tjenester, organisere Service Chaining og lettere horisontal skalerbarhed.
VNF — Virtual Network Function. En specifik virtuel enhed: router, switch, firewall, NAT, IPS/IDS osv.
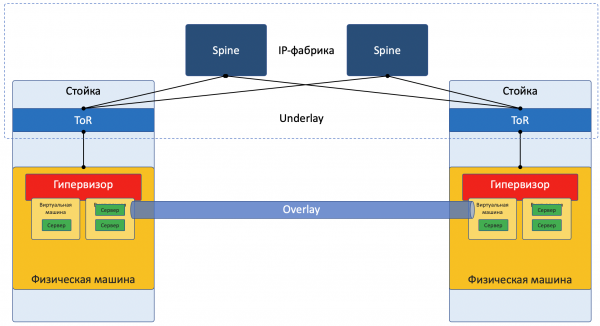
Jeg forenkler i øjeblikket beskrivelsen til den specifikke implementering for ikke at forvirre læseren. For en mere dybdegående læsning henviser jeg til sektionen . Desuden lover Roma Gorge, som kritiserer denne artikel for unøjagtigheder, at skrive et separat afsnit om virtualiseringsteknologier for servere og netværk, mere dybtgående og opmærksom på detaljerne.
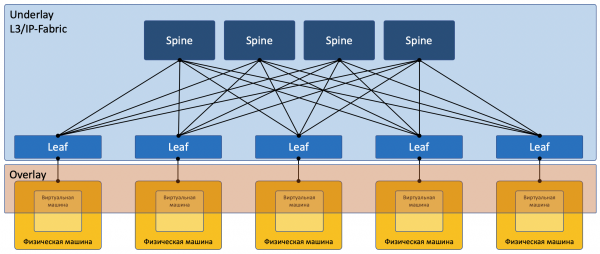
De fleste netværk i dag kan tydeligt opdeles i to dele:
Underlay — det fysiske netværk med en stabil konfiguration.
Overlay — en abstraktion over Underlay til isolering af lejere.
Dette gælder både for datacenteret (som vi vil gennemgå i denne artikel) og for ISP (som vi ikke vil gennemgå, fordi det allerede er blevet nævnt i ). For enterprise-netværk er situationen naturligvis noget anderledes.
Billede med fokus på netværket:
Underlay
Underlay er et fysisk netværk: hardware-switches og kabler. Enheder i underlay ved, hvordan de når frem til de fysiske maskiner.
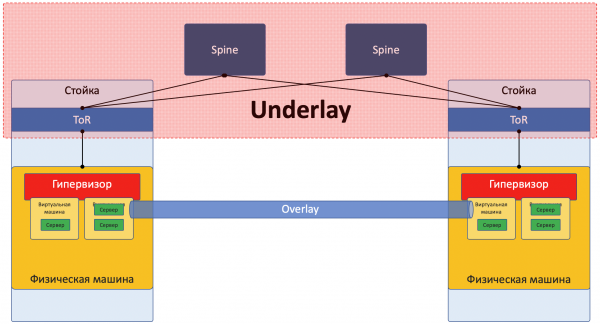
Det bygger på standardprotokoller og -teknologier. Ikke mindst fordi hardware-enheder stadig i dag fungerer på proprietær software, der ikke tillader programmering af chippen eller implementering af egne protokoller, derfor er der behov for kompatibilitet med andre leverandører og standardisering.
Men nogen som Google kan tillade sig at udvikle egne switches og undgå almindeligt anerkendte protokoller. Men LAN_DC er ikke Google.
Underlay ændres relativt sjældent, fordi dets opgave er grundlæggende IP-konnektivitet mellem fysiske maskiner. Underlay ved intet om de tjenester, kunder eller lejere, der kører ovenpå; det skal kun transportere pakker fra én maskine til en anden.
Underlay kan være for eksempel sådan:
- IPv4+OSPF
- IPv6+ISIS+BGP+L3VPN
- L2+TRILL
- L2+STP
Underlay-netværket konfigureres på klassisk vis: CLI/GUI/NETCONF.
Manuelt, via scripts eller proprietære værktøjer.
En mere detaljeret artikel om underlay vil blive dedikeret til emnet i den kommende del af cyklen.
Overlay
Overlay er et virtuelt netværk af tunneler, trukket hen over Underlay, som tillader VMs fra én kunde at kommunikere med hinanden, samtidig med at der sikres isolation fra andre kunder.
Kundens data kapsles ind i tunnelerende headers for at blive sendt over det fælles netværk.
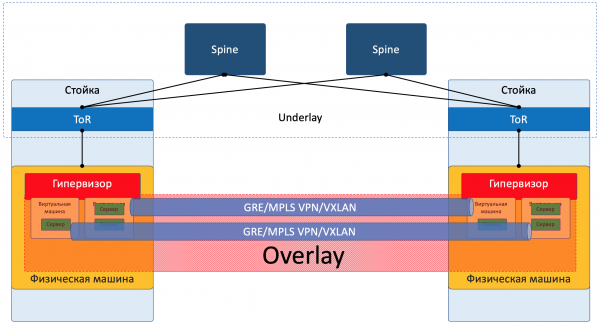
Dermed kan VMs fra én kunde (én service) kommunikere med hinanden gennem Overlay, uden at vide hvilken rute pakken reelt tager.
Overlay kan være for eksempel sådan, som jeg allerede har nævnt ovenfor:
- GRE-tunnel
- VXLAN
- EVPN
- L3VPN
- GENEVE
Overlay-netværket konfigureres og vedligeholdes typisk gennem en central controller. Herfra leveres konfigurationen, Control Plane og Data Plane til de enheder, der håndterer routing og indkapsling af kundetrafik. Lidt lader os se nærmere på dette med eksempler.
Ja, det er SDN i sin reneste form.
Der eksisterer to principielt forskellige tilgange til opbygning af et Overlay-netværk:
- Overlay fra ToR
- Overlay fra host
Overlay fra ToR
Overlay kan starte på adgangsswitchens (ToR), der står i rack, som det er tilfældet i eksempelvis VXLAN-fabrikker.
Det er en tidsafprøvet mekanisme i ISP-netværk, og alle producenter af netværksudstyr understøtter det.
Men i dette tilfælde skal ToR-switch være i stand til at adskille forskellige tjenester, og netværksadministratoren skal i et vist omfang samarbejde med administratorer af virtuelle maskiner og foretage ændringer (selv om automatisk) i enhedernes konfiguration.
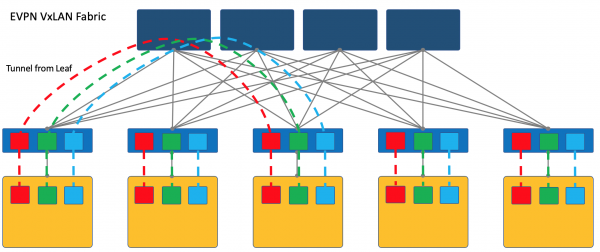
Her henviser jeg læseren til artiklen om vores gamle ven .
I denne hvor tilgange til opbygning af datacenter-netværk med EVPN VXLAN-fabrik er beskrevet i detaljer.
For en dybere forståelse kan man læse Ciscon's bog .
Jeg bemærker, at VXLAN kun er en metode til indkapsling, og terminering af tunnels kan foregå ikke på ToR, men på værten, som det er tilfældet med OpenStack, for eksempel.
Men en VXLAN-fabrik, hvor overlay starter på ToR, er et af de veletablerede design for overlay-netværk.
Overlay fra host
En anden tilgang er at starte og terminere tunneler på de endelige værter.
I dette tilfælde forbliver netværket (Underlay) så simpelt og statisk som muligt.
Og værten udfører alle nødvendige indkapslinger.
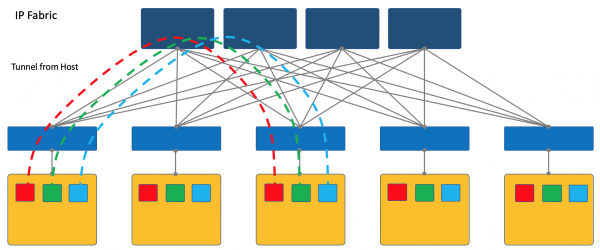
Dette kræver selvfølgelig, at man kører en særlig applikation på værterne, men det er det værd.
For det første er det lettere at starte klienten på en linux-maskine, eller man kan sige — overhovedet muligt — mens man på switchen sandsynligvis bliver nødt til at bruge proprietære SDN-løsninger, hvilket dræber ideen om multivendoritet.
For det andet kan ToR-switch i dette tilfælde holdes så simpel som muligt, både hvad angår Control Plane og Data Plane. Faktisk — med SDN-controlleren har den ikke brug for at kommunikere, og det er ikke nødvendigt at opbevare netværk/ARP'er for alle tilsluttede klienter — det er tilstrækkeligt at vide IP-adressen på den fysiske maskine, hvilket gør routing/switching tabellerne meget lettere.
I ADSM-serien vælger jeg tilgangen til overlay med værten — herefter taler vi kun om den, og vi vil ikke gå tilbage til VXLAN-fabrikken.
Det er nemmest at betragte det med eksempler. Og vi tager OpenSource SDN-platformen OpenContrail, som nu er kendt som .
Mod slutningen af artiklen vil jeg give nogle overvejelser om analogien med OpenFlow og OpenvSwitch.
På eksemplet med Tungsten Fabric
På hver fysisk maskine er der vRouter — en virtuel router, der kender til de netværk, der er tilsluttet ham, og hvilke kunder de tilhører — grundlæggende set — en PE-router. For hver kunde opretholder den en isoleret routingtabel (læs VRF). Og selve vRouter muliggør overlay tunneling.
Lidt mere om vRouter — i slutningen af artiklen.
Hver VM, der er placeret på hypervisoren, forbinder sig til vRouter'en på denne maskine via .
TAP — Terminal Access Point — et virtuelt interface i Linux-kernen, der muliggør netværksinteraktion.
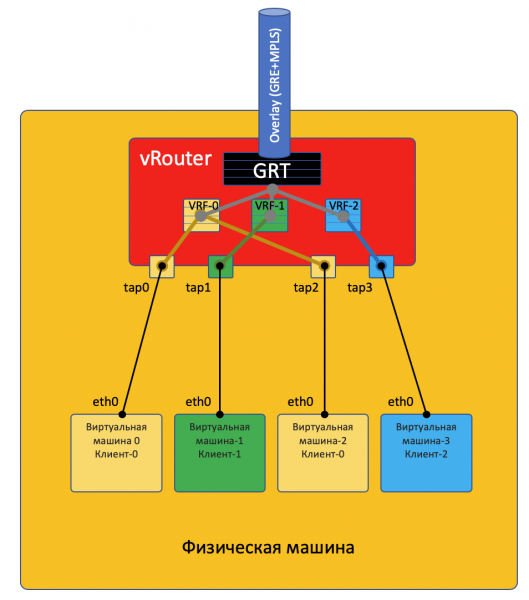
Hvis der ligger flere netværk bag vRouter'en, oprettes der et virtuelt interface for hver af dem, som tildeles en IP-adresse — det vil være den standard gateway adresse.
Alle netværk for én kunde placeres i én VRF (én tabel), forskellige — i forskellige.
Jeg vil gøre et forbehold her og sende den nysgerrige læser til slutningen af artiklen..
For at vRoutere kan kommunikere med hinanden, og dermed også VM'erne bag dem, udveksler de routinginformation gennem SDN-controlleren..
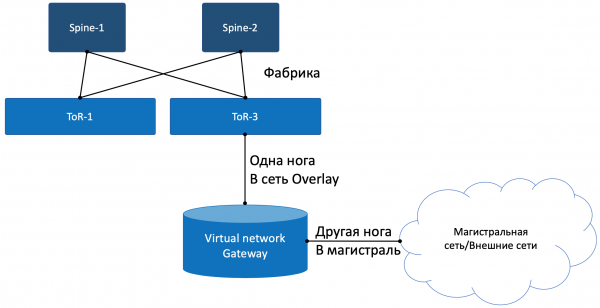
For at komme til den ydre verden findes der et udgangspunkt fra matrixen — gateway for det virtuelle netværk VNGW — Virtual Network GateWay (dette udtryk er mit).
Lad os nu se på eksempler på kommunikation — så bliver det klart.
Kommunikation inden for én fysisk maskine
VM0 ønsker at sende en pakke til VM2. Lad os antage, at dette er VM'en for én kunde.
Data Plane
- VM-0 har en standardrute i sin interface eth0. Pakken sendes derhen.
Denne interface eth0 er i virkeligheden virtuelt forbundet til den virtuelle router vRouter gennem TAP-interfacet tap0. - vRouter analyserer, hvilken interface pakken kom ind på, det vil sige, hvilken kunde (VRF) den tilhører, og tjekker mod modtagerens adresse i denne kundes routingtabel.
- Ved at opdage, at modtageren er på denne samme maskine bag en anden port, sender vRouter simpelthen pakken til den uden yderligere headers — i dette tilfælde er der allerede en ARP-post på vRouter'en.
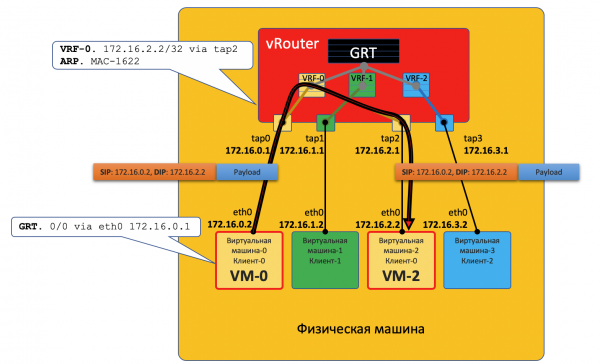
Pakken kommer i dette tilfælde ikke ud i det fysiske netværk — den er routeret internt i vRouter'en.
Control Plane
Hypervisoren informerer den virtuelle maskine ved opstart:
- Den egen IP-adresse.
- Standardruten — gennem vRouter'ens IP-adresse i dette netværk.
Hypervisoren informerer vRouter'en gennem et særligt API:
- At der skal oprettes et virtuelt interface.
- Hvilken Virtual Network der skal oprettes (for VM'en).
- Hvilken VRF den (VN) skal knyttes til.
- Den statiske ARP-post for denne VM — hvilken interface dens IP-adresse er knyttet til, og til hvilken MAC-adresse den er forbundet.
Igennem forenkles den reelle interaktionsprocedure for at forstå konceptet.
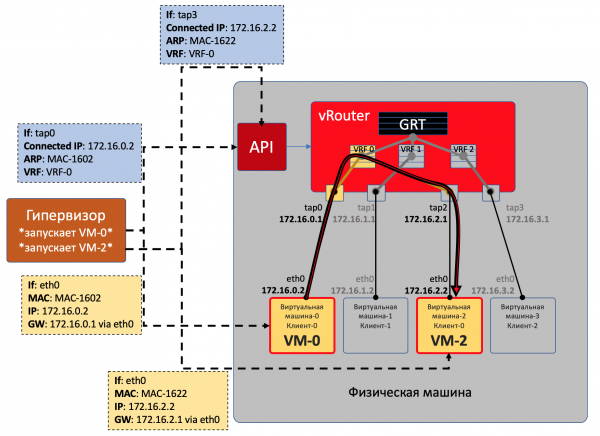
Dermed ser vRouter alle VM'er fra én kunde på denne maskine som direkte tilsluttede netværk og kan selv rute mellem dem.
Men VM0 og VM1 tilhører forskellige kunder, og befinder sig derfor i forskellige tabeller i vRouter.
Om de kan kommunikere direkte med hinanden, afhænger af indstillingerne i vRouter og netværksdesignet.
For eksempel, hvis VM'erne fra begge kunder bruger offentlige adresser, eller hvis NAT finder sted på selve vRouter, kan der laves direkte routing på vRouter.
I den modsatte situation kan der være overlap i adresseområderne — man skal gå gennem en NAT-server for at få en offentlig adresse — dette er ligesom at oprette forbindelse til eksterne netværk, som nævnt nedenfor.
Kommunikation mellem VM'er, der er placeret på forskellige fysiske maskiner
Data Plane
- Begyndelsen er præcis den samme: VM-0 sender en pakke til modtageren VM-7 (172.17.3.2) via sin standard.
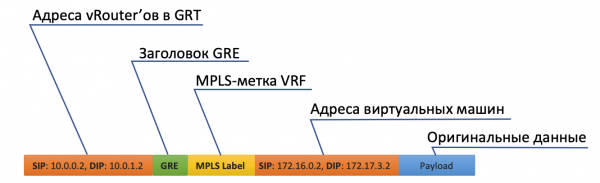
- vRouter modtager den og ser denne gang, at modtageren befinder sig på en anden maskine og er tilgængelig via tunnel Tunnel0.
- Først tilføjer den et MPLS-mærke, der identificerer den fjerne interface, så vRouter på den anden side kan bestemme, hvor denne pakke skal placeres uden yderligere omveje.
- Tunnel0 har en kilde på 10.0.0.2, modtager: 10.0.1.2.
vRouter tilføjer GRE (eller UDP) headers og en ny IP til den oprindelige pakke. - I vRouter's routingtabel er der en standardrute gennem adressen ToR1 10.0.0.1. Den sender til den adresse.

- ToR1, som deltager i Underlay-netværket, ved (for eksempel via OSPF), hvordan man når 10.0.1.2 og sender pakken via ruten. Vær opmærksom på, at der her inkluderes ECMP. På illustrationen er der to next-hops, og forskellige strømme vil blive fordelt mellem dem på baggrund af hash. I en virkelig fabrik vil der sandsynligvis være 4 next-hops.
Desuden er det ikke nødvendigt for den at vide, hvad der ligger under den ydre IP-header. Så i praksis kan der under IP være et sandwich af IPv6 over MPLS over Ethernet over MPLS over GRE over over over GRE.
- På modtagerens side fjerner vRouter GRE og forstår ud fra MPLS-mærket, hvilket interface pakken skal sendes til, adskiller den og sender den i sin oprindelige form til modtageren.
Control Plane
Når maskinen startes, sker alt det samme som beskrevet ovenfor.
Og derudover følgende:
- For each client, the vRouter assigns an MPLS label. This is a service label for L3VPN, by which clients will be segregated within the same physical machine.
In fact, the MPLS label is always unconditionally assigned by the vRouter — because it is not known in advance that the machine will only interact with other machines behind the same vRouter, and this is most likely not the case.
- The vRouter establishes a connection to the SDN controller using the BGP protocol (or one similar to it — in the case of TF it's XMPP 0_o).
- Through this session, the vRouter informs the SDN controller of the routes to the connected networks:
- Network address
- Encapsulation method (MPLSoGRE, MPLSoUDP, VXLAN)
- Client's MPLS label
- Its IP address as the nexthop
- The SDN controller receives such routes from all connected vRouters and reflects them to others. Thus, it acts as a Route Reflector.
The same happens in the opposite direction.
The overlay can change every minute. This is roughly how it happens in public clouds when clients regularly start and stop their virtual machines.
The central controller takes on all the complexities of maintaining the configuration and controlling the switching/routing tables on the vRouter.
Roughly speaking, the controller connects to all vRouters via BGP (or a similar protocol) and simply passes route information. BGP, for example, already has an Address-Family for transmitting the encapsulation method. eller .
At the same time, the configuration of the Underlay network does not change in any way, which, by the way, is significantly more complex to automate, and it is easier to break with an awkward move.
Udgang til den ydre verden
Somewhere, the simulation must end, and one must step out of the virtual world into the real one. And a gateway taxophone is required.
Two approaches are practiced:
- A hardware router is installed.
- Some appliance is launched, implementing the functions of a router (yes, following SDN, we also faced VNF). Let's call it a virtual gateway.
The advantage of the second approach is its inexpensive horizontal scalability — if additional power is needed, just start another virtual machine with a gateway. On any physical machine, without needing to look for available racks, units, power outputs, buying the hardware itself, transporting it, installing it, connecting it, configuring it, and then also replacing failed components.
Ulemperne ved en virtuel gateway er, at én fysisk router stadig er langt stærkere end en mangekerner virtuel maskine, og dens software, tilpasset dens egen hardware, fungerer betydeligt mere stabilt (nej). Det er svært at benægte, at den program- og hardwarekompleks simpelthen fungerer og kun kræver konfiguration, mens opsætningen og vedligeholdelsen af en virtuel gateway er en opgave for dygtige ingeniører.
Med én fod ser gatewayen ind i det virtuelle Overlay-netværk ligesom en almindelig virtuel maskine og kan interagere med alle andre VM'er. Den kan også terminere alle kundernes netværk og dermed udføre routing mellem dem.
Med den anden fod ser gatewayen mod det centrale netværk og ved, hvordan man kommer ud på internettet.
Data Plane
Således ser processen sådan ud:
- VM-0, med standard VRouter, sender en pakke med adressaten i den ydre verden (185.147.83.177) til interface eth0.
- VRouter modtager denne pakke og udfører et opslag af destinationsadressen i routing-tabellen — finder standardruten gennem gateway VNGW1 via Tunnel 1.
Den ser også, at det er en GRE-tunnel med SIP 10.0.0.2 og DIP 10.0.255.2, og der skal først tilføjes en MPLS-label for denne kunde, som VNGW1 forventer. - VRouter pakker den oprindelige pakke ind i MPLS, GRE og nye IP-overskrifter og sender til adressen ToR1 10.0.0.1 som standard.
- Underliggende netværk leverer pakken til gateway VNGW1.
- Gateway VNGW1 fjerner de tunnelerende GRE- og MPLS-overskrifter, ser destinationsadressen, konsulterer sin routing-tabel og forstår, at den er rettet mod internettet — hvilket betyder via Full View eller Default. Gennemfører NAT-oversættelse om nødvendigt.
- Fra VNGW til border kan der være et almindeligt IP-netværk, hvilket næppe er tilfældet.
Det kan være et klassisk MPLS-netværk (IGP+LDP/RSVP TE), det kan være en tilbageholdt fabrik med BGP LU eller en GRE-tunnel fra VNGW til border gennem et IP-netværk.
Hvordan det end er, udfører VNGW1 de nødvendige indkapslinger og sender den oprindelige pakke mod border.
Trafikken i den modsatte retning går gennem de samme trin i omvendt rækkefølge.
- Border afleverer pakken til VNGW1.
- Den fjerner overskriften, ser på modtagerens adresse og bemærker, at den er tilgængelig gennem tunnelen Tunnel1 (MPLSoGRE eller MPLSoUDP).
- Rent faktisk tilføjes en MPLS-label, GRE/UDP-overskriften og nye IP-overskrifter, og den sendes til sit ToR3 10.0.255.1.
Destination tunnel address — the IP address of the vRouter behind which the target VM resides — 10.0.0.2. - The underlay network delivers the packet to the required vRouter.
- The target vRouter strips GRE/UDP, identifies the interface based on the MPLS label, and sends a plain IP packet to its TAP interface linked to eth0 of the VM.
Control Plane
VNGW1 establishes BGP adjacency with the SDN controller, from which it receives all routing information about clients: which client is associated with which IP address (vRouter) and which MPLS label identifies it.
Similarly, it informs the SDN controller of the default route with the label of this client, indicating itself as the nexthop. This default then travels to the vRouters.
Route aggregation or NAT translation typically occurs at VNGW.
And in the opposite direction, it provides this aggregated route to sessions with borders or Route Reflectors. From them, it receives the default route or Full-View, or something else.
In terms of encapsulation and traffic exchange, VNGW is no different from vRouter.
If you broaden the scope slightly, other network devices can also be added to VNGW and vRouters, such as firewalls, traffic cleaning or enrichment farms, IPS, and so on.
Through sequential creation of VRF and proper route announcements, you can make traffic loop as you wish, which is referred to as Service Chaining.
Here, the SDN controller acts as a Route Reflector between VNGW, vRouters, and other network devices.
But in fact, the controller also provides information about ACL and PBR (Policy Based Routing), forcing individual traffic flows not to follow the route dictated to them.
FAQ
Why do you keep making the remark about GRE/UDP?
Well, actually, it can be said to be specific to Tungsten Fabric — it can really be disregarded.
But if we take it into account, TF, even when it was OpenContrail, supported both encapsulations: MPLS in GRE and MPLS in UDP.
UDP is advantageous because in the Source Port of its header, it is very easy to encode a hash function from the original IP+Proto+Port, allowing for load balancing.
In the case of GRE, unfortunately, there are only external IP and GRE headers, which are the same for all encapsulated traffic, and load balancing is not an option — few can look that deeply inside the packet.
Indtil for nylig kunne routere, hvis de kunne håndtere dynamiske tunneller, kun gøre det via MPLSoGRE, og først for nylig har de lært at håndtere MPLSoUDP. Derfor skal vi altid bemærke muligheden for to forskellige kapslinger.
For retfærdighedens skyld er det værd at bemærke, at TF også støtter L2-forbindelse ved hjælp af VXLAN.
Du lovede at drage paralleller til OpenFlow.
De er faktisk nærliggende. vSwitch i samme OpenStack laver ret lignende ting ved at bruge VXLAN, som for øvrigt også har en UDP-header.
I Data Plane fungerer de næsten ens, men Control Plane adskiller sig væsentligt. Tungsten Fabric bruger XMPP til at levere ruteinformation til vRouter, mens OpenStack bruger OpenFlow.
Kan du fortælle lidt mere om vRouter?
Det opdeles i to dele: vRouter Agent og vRouter Forwarder.
Førstnævnte kører i User Space af værtens OS og kommunikerer med SDN-kontrolleren ved at udveksle ruteinformation, VRF og ACL.
Sidstnævnte implementerer Data Plane — normalt i Kernel Space, men kan også køre på SmartNICs — netværkskort med CPU og en separat programmerbar switch-chip, hvilket aflaster CPU'et på værtmaskinen og gør netværket hurtigere og mere forudsigeligt.
Der kan også være et scenarie, hvor vRouter er en DPDK-applikation i User Space.
vRouter Agent sender indstillinger til vRouter Forwarder.
Hvad er Virtual Network?
Jeg nævnte i begyndelsen af artiklen VRF, om at hver tenant knyttes til sin egen VRF. Og mens dette var tilstrækkeligt til en overfladisk forståelse af, hvordan overlay-netværket fungerer, er det nødvendigt med præciseringer i næste iteration.
Typisk introduceres en Virtual Network-enhed (man kan betragte dette som et egennavn) separat fra kunder/tenants/virtuelle maskiner — en helt selvstændig ting. Denne Virtual Network kan så tilsluttes til en tenant, en anden, to, eller hvor som helst. Sådan implementeres for eksempel Service Chaining, når trafik skal ledes gennem bestemte noder i den rigtige rækkefølge, simpelthen ved at oprette og knytte Virtual Networks i den rigtige rækkefølge.
Derfor er der ikke noget direkte forhold mellem Virtual Network og tenant.
Konklusion
Dette er en ret overfladisk beskrivelse af, hvordan et virtuelt netværk fungerer med overlay fra værten og en SDN-controller. Men uanset hvilken virtualiseringsplatform du vælger i dag, vil den fungere på lignende måde, hvad enten det drejer sig om VMWare, ACI, OpenStack, CloudStack, Tungsten Fabric eller Juniper Contrail. De vil variere i typerne af indkapslinger og headers, og de protokoller, der bruges til at levere information til de endelige netværksenheder, men princippet for et programmatisk konfigurerbart overlay-netværk, der fungerer oven på et relativt simpelt og statisk underlay-netværk, forbliver det samme.
Man kan sige, at området for oprettelse af private cloud i dag er blevet vundet af SDN baseret på overlay-netværk. Det betyder dog ikke, at Openflow ikke har sin plads i den moderne verden - det anvendes i OpenStack og også i VMWare NSX, og så vidt jeg ved, bruger Google det til at konfigurere underlay-netværket.
Lidt længere nede har jeg inkluderet links til mere detaljerede materialer, hvis man ønsker at dykke dybere ind i emnet.
Og hvad med vores Underlay?
Overordnet set, ikke meget. Det har ikke ændret sig hele tiden. Alt, hvad det behøver at gøre i tilfælde af overlay fra værten, er at opdatere ruter og ARP'er, når vRouter/VNGW dukker op og forsvinder, og håndtere pakker imellem dem.
Lad os formulere en liste over krav til Underlay-netværket.
- At kunne håndtere en eller anden routingprotokol, i vores tilfælde - BGP.
- At have en bred båndbredde, helst uden overtegn, for at undgå pakktab på grund af overbelastninger.
- At understøtte ECMP - en uundgåelig del af fabrikken.
- At kunne sikre QoS, herunder nogle snedige ting som ECN.
- At understøtte NETCONF - en investering i fremtiden.
Jeg har brugt meget lidt tid på selve Underlay-netværket her. Det er fordi, at jeg senere i serien vil fokusere netop på det, mens vi kun vil berøre Overlay kort.
Det er tydeligt, at jeg begrænser os alle meget ved at bruge et data center-netværk bygget på Clos-fabrikken med ren IP-routing og overlay fra værten som eksempel.
Jeg er dog overbevist om, at ethvert netværk med et design kan beskrives i formelle termer og automatiseres. Min hensigt her er blot at forstå tilgange til automatisering, ikke at forvirre alle ved at løse opgaven generelt.
Som en del af ADSM planlægger jeg og Roman Gorje at udgive et særskilt nummer om virtualisering af computing ressourcer og dens interaktion med netværksvirtualisering. Bliv ved med at følge med.
Nyttige links
- .
- . 6 timer om Yandex.Cloud, hvor den virtuelle netværk på TF også diskuteres.
- .
- . Her beskrives hele netværket i datacenteret, inklusiv Underlay, Overlay, tilgange til multi-homing og styring.
Tak
- — tidligere vært for podcasten linkmeup, og nu ekspert inden for cloud-platforme. Tak for kommentarer og redigeringer. Og vi ser frem til hans dybere artikel om virtualisering i nær fremtid.
- — min kollega og ekspert inden for udvikling af virtuelle netværk. Tak for kommentarer og redigeringer.
- — min kollega og ekspert inden for Tungsten Fabric. Tak for kommentarer og redigeringer.
- — illustrator for linkmeup. Tak for KDPV.
- Alexander Limonov. Tak for meme "automato".
Kilde: habr.com
