

I dag i IT-infrastrukturen, med den udbredte brug af virtualisering, er datalagringssystemer kernen, der opbevarer alle virtuelle maskiner. En fejl i denne node kan helt stoppe driften af datacenteret. Selvom en betydelig del af serverudstyret har fejltolerance i en eller anden form 'som standard', stilles der særligt høje krav til dets 'levetid' på grund af den særlige rolle, som datalagringssystemer spiller inden for datacentret.
Den mest effektive metode til at sikre fejltolerance i IT er anvendelsen af flere eksemplarer af udstyr og software (i enkleste tilfælde - duplikation). Selvfølgelig kan datalagringssystemet duplikeres helt. Og til disaster recovery anvendes netop denne tilgang. Men langt fra alle virksomheder har råd til en sådan løsning. Det handler ikke kun om den fordoblede omkostning ved udstyret, men også om andre udgifter til organiseringen af en sådan løsning og dens fremtidige vedligeholdelse.
Muligheden for udstyrsdublikation fjerner imidlertid ikke behovet for at sikre fejltolerance på komponentniveau. Især anvendes der i datalagringssystemer redundans for strømforsyninger, kølemoduler, lagringsenheder og naturligvis controllere. Alt dette er for længst blevet hverdag. Det er svært at finde et datalagringssystem uden brug af en sådan konstruktion. her er ingen undtagelse. Men i denne artikel ønsker vi at tale om det, der ikke straks fanger øjet, og som primært er rettet mod at forbedre systemets samlede fejltolerance.
Kølemoduler
Meget ofte i med 2U-3U kabinetter anvendes kombinerede moduler, der sammenkæder strømforsyningsenheder og blæsere. På den ene side er det praktisk, da man kun skal servicere én enhed. På den anden side, hvis kølesystemet svigter, kan strømforsyningsenheden blive slukket for at undgå overophedning. Og selvom det ikke synes at være en kritisk situation, er det tydeligvis ikke ideelt at tilføre sårbarheder til datalagringssystemet.
Køling i Qsan SAN er organiseret i separate moduler med «hot-swap», uafhængige af strømforsyninger. Faktisk har strømforsyningerne deres egne blæsere, der er beregnet til at køle selve PSU'erne. Kølingsmodulet rummer to uafhængige blæsere, der sikrer hinanden. Der er to sådanne moduler i SAN, til højre og venstre – til effektiv koldning af alle komponenter. Hvis en af blæserne fejler, øger alle de resterende automatisk deres omdrejninger for at kompensere for den opståede mangel på luftstrøm. Derfor medfører en blæserfejl ikke en risiko for overophedning af hele enheden.
Topologi for tilslutning af udvidelsesrammer
Klassisk tilslutningsskema til SAN indebærer en topologi kendt som kaskade. I dette tilfælde forbindes de relevante controllerne for udvidelsesrammen og SAN med et enkelt SAS-kabel. I alt bliver det 2 kabler til et to-controller-system. Hvis det er nødvendigt at tilslutte en anden, tilsluttes den på samme måde til den første ramme. Og så videre. Fordelen ved denne topologi er, at den er nem at implementere i udstyret. Ulempen er, at den er sårbar over for pludselige brud på SAS-kæden på grund af krydsfejl mellem de ikke-forbundne controllere i SAN og rammen eller på grund af strømudfald af en af udvidelsesrammerne midt i kæden. Resultatet vil være tab af adgang til en del af diskene og mulig sammenbrud af RAID-gruppen, hvis den er «spredt» over flere kabinetter.
For krydsfejl mellem controllerne har Qsan beskyttelse i form af intern logisk forbindelse mellem controllerne via SAN'ens backplane. Dvs. SAN-controlleren ser ikke kun controlleren for JBOD, der er direkte tilsluttet den, men også controlleren for «naboen» gennem et specielt link i backplane. Resultatet er, at hvis en sådan situation opstår, og ingen fysisk trækker SAS-kablerne mellem SAN og rammen, vil adgangen til alle diske blive bevaret.
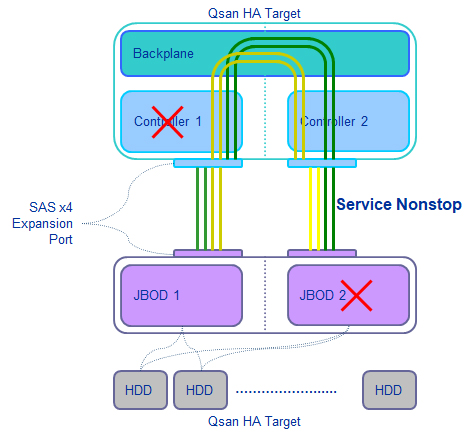
For protection against SAS chain breakage, for instance, due to power loss of an expansion shelf, a different connection topology is typically used – reverse cascade. In this case, the storage system connects directly to both the first and last shelves in the chain, gaining access to the drives as if from both sides.
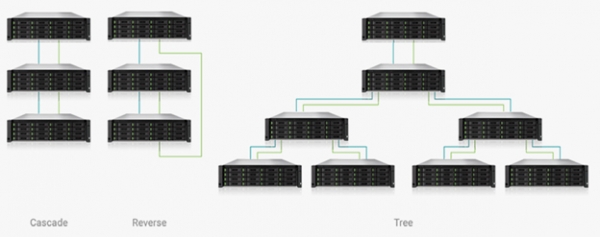
If stronger protection is desired, larger-scale configurations can be built, using, for example, a tree topology. Alternatively, you can complicate the setup by combining the mentioned topologies. This is possible due to the large number of SAS connectors on the devices (2 for each storage system controller and 5 for each JBOD controller) with automatic detection of input/output operation modes. The main thing is that the administrator does not get confused. The storage system will manage to configure the setup correctly.
Fast rebuild
The presence of hot spare disks in the system significantly increases the reliability of information storage. However, simply designating such disks does not guarantee absolute protection. The fact is that the recovery process (rebuild) is quite labor-intensive and often prolonged. The labor intensity arises from the continuous access to the main data. That is, the system must copy data to the new disk while also performing its current tasks. The duration of the rebuild directly depends on the capacity of the drive and its performance characteristics. Since the system knows nothing about the actual occupied space on the disks, it simply copies everything during the rebuild: block by block.
As a result, restoring a modern high-capacity drive of 10+ TB under heavy load on the storage system can easily take a week or more. It should also be noted that during the rebuild, there is a significantly increased risk of failure of other drives due to the increased load on them. This can present a serious danger, for example, in the case of using RAID5.
As a solution to this issue, many storage system developers have been concerned with accelerating the recovery process. Various approaches can be employed for this, but the essence remains the same – copying only the currently occupied blocks during the rebuild. Qsan has not shied away from this problem either. The storage system of this vendor, when the option is activated, Systemet tracker de blokke, der bruges til at optage data, og har dermed mulighed for, kun at kopiere dem til en ny enhed i tilfælde af, at disken svigter.
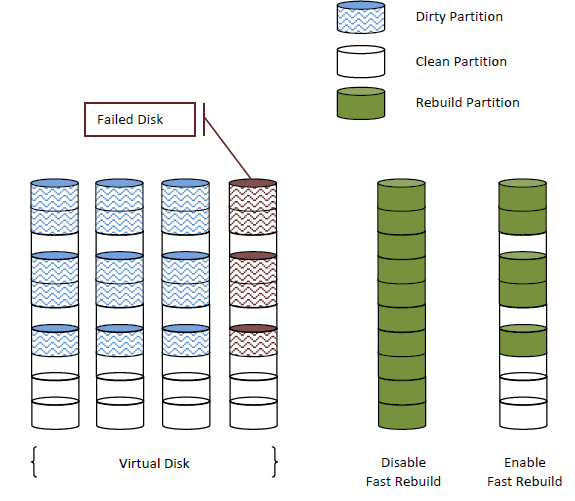
Fast Rebuild-optionen er ikke aktiveret som standard ved oprettelse af nye volumener, da dens brug påvirker ydeevnen, især under random write-operationer, fordi:
- Det er nødvendigt at føre tracking af skrivninger til blokke;
- Under rebuild-processen foretages der ikke en genberegning af kontrolsummer for ubenyttet plads, så når der skrives nyt til dette område, skal det først "initialiseres".
Derfor anbefales det ikke at bruge Fast Rebuild for volumener, f.eks. med højbelastede databaser eller i videoovervågningssystemer, hvor volumen alligevel vil blive fyldt 100%. Men for fil- eller mailservere vil denne mulighed være meget nyttig.
Afslutning
Hver producent af Lagringssystemer forudsætter, at deres enheder er pålidelige. Og hvis der ikke er fatale fejl i designet af enhederne og en utrolig trang til at spare under produktion og test, kan man generelt være enig med leverandøren. Men man skal forstå:
- Grundlæggende fejltolerance i Lagringssystemer handler først og fremmest om at fortsætte med at have adgang til data i tilfælde af, at en eller flere komponenter svigter;
- Yderligere muligheder for fejltolerance (som dem, der er beskrevet ovenfor) er undtagelser fra visse fejltyper og øger dine chancer for at få adgang til data;
- 100% pålidelighed findes desværre ikke. Men for at nærme sig dette mål, gør de fleste fornuftige Lagringssystem-leverandører (og blandt dem) alt for at forbedre deres produkter kontinuerligt, både i hardware- og softwareaspektet.
Det skal også huskes, at ingen absolut pålidelighed i Lagringssystemer ophæver behovet for backup, klare og øvede katastrofereddelsesplaner samt effektiv teknisk support fra leverandøren.
Kilde: habr.com
