

Om sommeren falder både købsaktivitet og intensiteten af ændringer i infrastrukturen for webprojekter, fortæller Captain Obvious os. Bare fordi selv it-folk, sker der, går på ferie. Og CTO'er også. Det gør det sværere for dem, der bliver på posten, men det handler ikke om det nu; muligvis er det derfor, at sommeren er den bedste tid til at tage sig tid til at overveje den eksisterende backup-ordning og lave en plan for at forbedre den. Og her kan du have gavn af erfaringen fra Yegor Andreev fra , som han delte på konferencen .
Når vi bygger backup-steder, er der flere fælder, vi kan falde i. Og det er helt uacceptabelt at falde i dem. Det, der skader os i alt dette, som i meget andet, er perfektionisme og... dovenskab. Vi prøver at få alt gjort perfekt, men det er ikke nødvendigt at gøre alt perfekt! Det er vigtigt kun at gøre bestemte ting, men gøre dem korrekt og fuldføre dem, så de fungerer ordentligt.
Failover er ikke noget sjovt og underholdende, der bare er for sjov; det er noget, der skal gøre præcis én ting — reducere nedetid, så tjenesten, firmaet, taber færre penge. Og i alle metoder til backup foreslår jeg at tænke i følgende kontekst: hvor er pengene?
Den første fælde: når vi bygger store pålidelige systemer og arbejder med backup — reducerer vi antallet af nedbrud. Det er en frygtelig misforståelse. Når vi arbejder med backup, øger vi sandsynligvis antallet af nedbrud. Og hvis vi gør alt rigtigt, vil vi samlet set reducere nedetiden. Der vil være flere nedbrud, men de vil ske med færre omkostninger. Hvad er backup? — det er en komplikation af systemet. Enhver komplikation er en dårlig ting: vi får flere små dele, flere tandhjul, kort sagt, flere elementer — og dermed er der en højere chance for, at noget går i stykker. Og de vil faktisk gå i stykker. Og de vil bryde oftere. Et enkelt eksempel: lad os sige, at vi har en hjemmeside, der bruger PHP og MySQL. Og den skal hurtigt sikres.
Så, vi tager den anden platform, bygger et identisk system... Kompleksiteten fordobles - vi har to enheder. Og så opbygger vi en bestemt logik for overførsel af data fra den ene platform til den anden - altså datareplication, kopiering af statiske filer osv. Logikken for replication er som regel meget kompleks, og dermed kan den samlede kompleksitet af systemet være ikke 2, men 3, 5, 10 gange større.
Den anden fælde: når vi bygger virkelig store komplekse systemer, fantasere vi om, hvad vi ønsker at opnå i sidste ende. Voilà: Vi ønsker at få et superpålideligt system, der fungerer uden nedetid, skifter over på et halvt sekund (eller endnu bedre øjeblikkeligt), og vi begynder at gøre vores drømme til virkelighed. Men der er også en nuance her: jo mindre den ønskede skiftetid er, desto mere kompleks bliver logikken i systemet. Jo mere kompleks logikken bliver, desto oftere vil systemet gå i stykker. Man kan havne i en meget ubehagelig situation: vi prøver med alle kræfter at reducere nedetid, men i virkeligheden gør vi alt mere kompliceret, og når noget går galt, vil nedetiden i sidste ende være større. Her fanger man ofte sig selv i tanken: ah... det ville have været bedre ikke at have reserveret. Det ville have været bedre, hvis det bare fungerede med en forståelig nedetid.
Hvordan kan man bekæmpe dette? Vi må stoppe med at lyve for os selv, stoppe med at rose os selv, om at vi her nu vil bygge et rumskib, men realistisk forstå, hvor længe projektet egentlig kan tage. Og til denne maksimale tid vil vi vælge, hvilke metoder vi vil bruge til at øge pålideligheden af vores system.
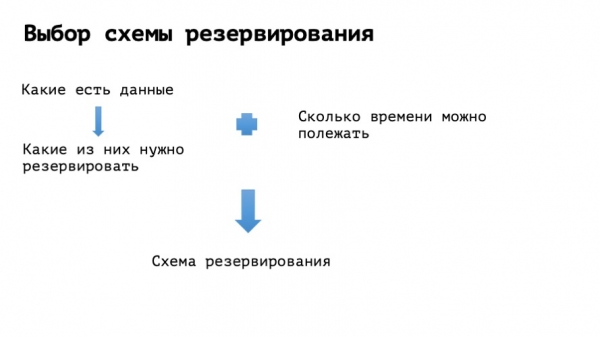
Det er tid til nogle "historier fra livet"… fra livet, selvfølgelig.
Eksempel nummer et
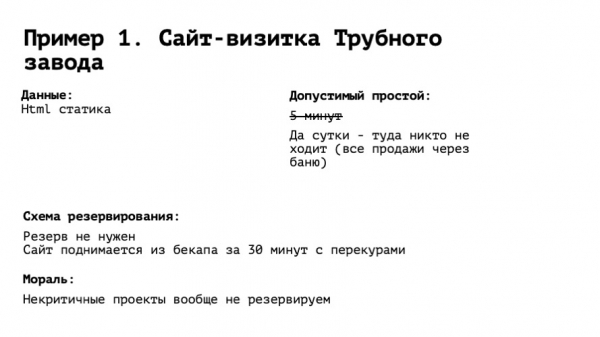
Forestil dig en visitkort website for rørproduktionsfabrikken nr. 1 i by N. Der står med store bogstaver - RØRPRODUKTION FABRIK NR. 1. Lidt længere nede - sloganet: "Vore rør er de mest runde rør i N". Og nederst telefonnummeret til direktøren og hans navn. Vi forstår, at det er vigtigt at reservere - det er virkelig en vigtig ting! Vi begynder at finde ud af, hvad det består af. Html-statik - det vil sige et par billeder, hvor direktøren faktisk sidder ved bordet i saunaen med sin partner og diskuterer en eller anden aftale. Vi begynder at tænke på nedetid. Det kommer til at tænke, at man skal ligge der i fem minutter, ikke mere. Og så spørgsmålet: hvor mange salg har vi egentlig haft fra vores hjemmeside? Hvor mange? Hvad betyder "nul"? Eller faktisk: fordi alle fire handler fra det sidste år gjorde direktøren ved det samme bord, med de samme mennesker, som de går i sauna med og sidder ved bordet. Og vi forstår, at selv hvis dagen går, kommer der ikke til at ske noget skræmmende.
Ud fra de indledende oplysninger er der en dag til at få denne historie op at køre. Vi begynder at tænke på reservationsskemaet. Og vi vælger det mest ideelle skema til reservation for dette eksempel: vi bruger ikke reservation. Hele denne ting kan enhver administrator sætte op på en halv time med pauser. Sætte en webserver op, lægge filer - det hele. Det vil køre. Der er ikke noget, man skal holde øje med, intet der kræver særlig opmærksomhed. Så konklusionen fra eksempel nummer et er temmelig indlysende: tjenester, som ikke kræver reservation - skal ikke reserveres.
Eksempel nummer to
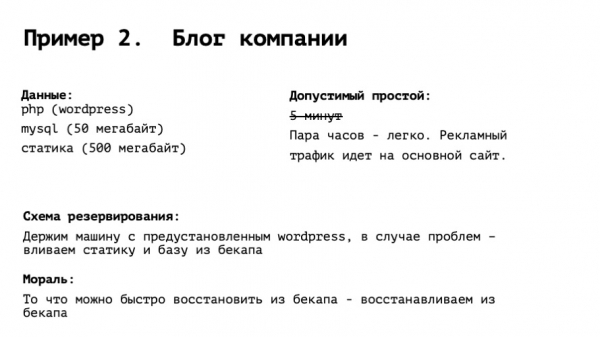
Virksomhedens blog: specialuddannede skriver nyheder der, som deltagelse i en bestemt messe, eller vores lancering af et nyt produkt osv. Antag, at det er standard PHP med WordPress, en lille database og lidt statisk indhold. Det er klart, at vi ikke må lade det ligge stille - "ikke mere end fem minutter!", og alt det der. Men lad os tænke videre. Hvad gør denne blog? Den tiltrækker besøgende fra Yandex og Google via forskellige søgninger, via organisk trafik. Det er fantastisk. Men hvordan hænger salget sammen med dette? Åbenbaring: ikke rigtig. Annoncetransporten går til hovedsiden, som er på en anden server. Vi begynder at overveje en backup-plan for bloggen. Ideelt set skal den kunne genoprettes på et par timer, og det ville være godt at forberede sig på det. Det ville være fornuftigt at tage en maskine i et andet datacenter, installere et miljø på den, altså webserver, PHP, WordPress, MySQL, og lade den stå stille. I det øjeblik vi indser, at alt er brudt sammen, skal vi gøre to ting - genskabe en MySQL-dump på 50 megabyte, det vil tage et minut, og genskabe et antal billeder fra backupen. Det er heller ikke så mange. På den måde kan hele denne ting sættes op på en halv time. Ingen replikationer, eller Gud forbyde det, automatisk failover. Konklusion: det vi hurtigt kan genskabe fra backup - det behøver ikke at blive reserveret.
Eksempel nummer tre, lidt mere kompliceret
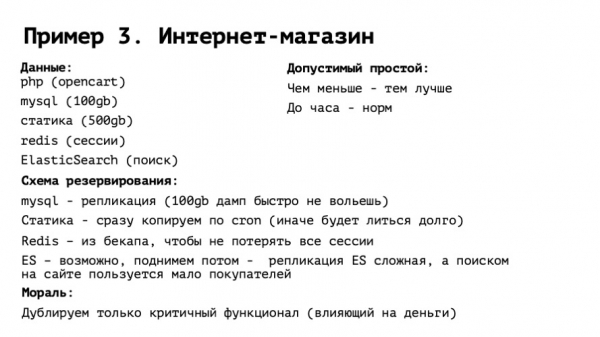
Onlinebutik. PHP med open heart er lidt modificeret, MySQL med en solid database. Ret meget statisk indhold (for der er flotte HD-billeder i en onlinebutik og alt det der), Redis til sessioner og Elasticsearch til søgning. Vi begynder at tænke på nedetid. Her er det klart, at en dag uden problemer kan internetbutikken ikke ligge stille. Jo længere tid den ligger stille, jo flere penge mister vi. Det er tid til at skynde sig. Og hvor meget? Jeg tænker, at hvis vi ligger stille i en time, så går ingen amok. Ja, vi vil miste noget, men hvis vi arbejder hårdere, så bliver det kun værre. Vi definerer niveauet for acceptabel nedetid, i timer.
Hvordan kan man reservere alt dette? Man har brug for en maskine uanset hvad: en time er ikke meget. Mysql: her kræves der allerede replikation, live replikation, fordi man sandsynligvis ikke vil kunne overføre 100 GB data på én time. Statiske filer, billeder: igen, 500 GB kan muligvis ikke overføres på en time. Derfor er det bedre straks at kopiere billederne. Redis: her bliver det interessant. I Redis ligger sessioner — vi kan ikke bare slette den. For det ville ikke være godt: alle brugere vil blive logget ud, indkøbskurve ryddes osv. Folk vil være tvunget til at indtaste deres loginoplysninger igen, og mange kan vælge at forlade og ikke gennemføre købet. Igen, konverteringen vil falde. På den anden side er Redis præcis aktuelt med de senest loggede ind brugere, så det er måske heller ikke nødvendigt. En god kompromis er at tage Redis og gendanne det fra en backup, fra i går, eller hvis der laves backup hver time — så fra en time tilbage. Heldigvis er gendannelse fra backup lige så simpelt som at kopiere én fil. Den mest interessante historie er Elasticsearch. Hvem har nogensinde opsat MySQL replikation? Hvem har nogensinde opsat Elasticsearch replikation? Og hos hvem har den fungeret ordentligt bagefter? Jeg siger: vi ser en eller anden enhed i vores system. Den virker nyttig — men den er kompleks.
Kompleks, fordi vores ingeniørkolleger ikke har erfaring med den. Enten har de haft en negativ erfaring, eller også forstår vi, at det stadig er en ret ny teknologi med nuancer eller ufuldkommenheder. Vi tænker... Hmm, elastic er også stort, det tager også lang tid at gendanne fra backup, hvad gør vi? Vi forstår, at elastic i vores tilfælde bruges til søgning. Hvordan sælger vores internetbutik? Vi går til marketingfolkene og spørger, hvor folk kommer fra. De svarer: "90% kommer direkte fra Yandex-markedet til produktkortet." Og enten køber de eller gør de ikke. Derfor har 10% af brugerne brug for søgning. Og at opretholde replikering af elastic, især mellem forskellige datacentre i forskellige zoner, er der virkelig mange nuancer. Hvad er løsningen? Vi tager elastic på et reserveret sted og gør ikke noget med det. Hvis det trækker ud, så måske rejser vi det en dag, men det er ikke sikkert. Egentlig er konklusionen plus-minus den samme: tjenester, der ikke påvirker penge, reserverer vi ikke igen. For at holde systemet simplere.
Eksempel nummer fire, endnu sværere.
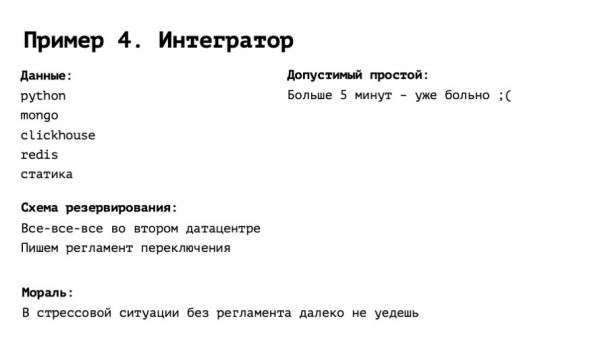
Integrator: blomstersalg, taxaopkald, salg af varer, kort sagt, hvad som helst. En seriøs ting, der arbejder 24/7 for mange brugere. Med en komplet og interessant stak, hvor der er interessante databaser, løsninger, høj belastning, og vigtigst af alt, kan det ikke være nede i mere end 5 minutter. Ikke kun fordi folk ikke vil købe, men fordi folk vil se, at denne ting ikke fungerer, bliver skuffede og måske slet ikke kommer tilbage.
Okay. Fem minutter. Hvad skal vi gøre ved dette? I dette tilfælde bygger vi, som voksne, en rigtig reserveret platform, med replikering af det hele og måske endda automatiserer overgangen til denne platform så meget som muligt. Og derudover må vi ikke glemme at gøre én vigtig ting: faktisk at skrive en overgangsprocedure. Proceduren, selvom alt er automatiseret, kan være meget simpel. I stil med "start dette ansible-scenarie", "klik på den bestemte boks i route 53" osv. — men det skal være en præcis liste over handlinger.
Og det virker til at være klart. At skifte replikationen er en triviel opgave, ellers skifter den automatisk. At omskrive domænenavnet i DNS er af samme slags. Problemet er, at når et sådant projekt falder, opstår der panik, og selv de stærkeste og mest erfarne administratorer kan blive ramt af det. Uden en klar instruktion som "åbn terminalen, gå hertil, og vores servers adresse er stadig sådan her" er det svært at overholde en tidsramme på 5 minutter til genoplivning. Og når vi bruger denne retningslinje, er det let at registrere ændringer i infrastrukturen, for eksempel, og ændre retningslinjen tilsvarende.
Men hvis reserveringssystemet er meget komplekst, og vi på et tidspunkt laver en fejl, kan vi både nedlægge vores backup-lokation og samtidig forvandle dataene til grød på begge lokationer - det vil være meget trist.
Eksempel nummer fem, hardcore.
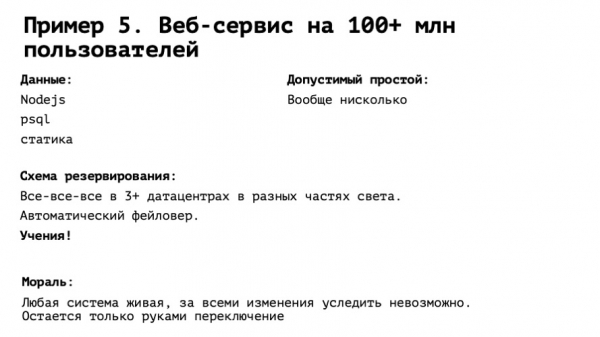
En international tjeneste med hundred millioner brugere over hele verden. Alle tidszoner, der findes, highload på max, må ikke gå ned overhovedet. Et minut, og det bliver trist. Hvad skal man gøre? Reservering, igen, fuldt program. Vi gjorde alt, hvad jeg nævnte i det forrige eksempel, og lidt mere. En ideel verden, og vores infrastruktur - den er efter alle definitioner DevOps IaaC. Så alt ligger i git, og man skal bare trykke på knappen.
Hvad mangler? En ting - træning. Uden det kan vi ikke. Det virker som om, at alt er perfekt, og at vi har alles kontrol. Vi trykker på knappen, og alt sker. Selv hvis det er sådan - og vi ved, at det ikke sker - interagerer vores system med nogle andre systemer. For eksempel DNS fra route 53, S3-lagring, integration med nogle API’er. Vi kan ikke forudse alt i dette hypotetiske eksperiment. Og indtil vi faktisk trækker kontakten - finder vi ikke ud af, om det virker eller ej.
Det var nok det hele. Vær ikke doven og overdriv ikke. Og må oppetiden være med dig!
Kilde: habr.com
