

Bem. overs.: Dailymotion — en af verdens største videotjenester og derfor en bemærkelsesværdig bruger af Kubernetes. I dette materiale deler systemarkitekten David Donchez konklusionerne fra opbygningen af virksomhedens produktionsplatform baseret på K8s, som startede med en cloudinstallation i GKE og endte som en hybridløsning, der muliggør bedre svartider og reducerede infrastrukturomkostninger.
Når man træffer beslutning om at ombygge den primære API for tre år siden, ønskede vi at udvikle en mere effektiv måde at implementere applikationer og lette . Til dette formål besluttede vi at anvende en containerorkestreringsplatform og valgte naturligvis Kubernetes.
Hvorfor bør man opbygge sin egen platform baseret på Kubernetes?
Produktionsniveau API på kort tid med Google Cloud
Sommeren 2016
For tre år siden, lige efter at Dailymotion blev købt af , fokuserede vores ingeniørteams på et globalt mål: At skabe et helt nyt Dailymotion produkt.
Efter at have analyseret containere, løsninger til orkestrering og vores tidligere erfaringer, var vi sikre på, at Kubernetes var det rigtige valg. Nogle udviklere havde allerede kendskab til grundlæggende koncepter og vidste, hvordan man brugte det, hvilket var en stor fordel for infrastrukturtransformationen.
Fra et infrastruktursynspunkt krævedes der et kraftfuldt og fleksibelt system til implementering af nye typer cloud-native applikationer. Vi valgte at forblive i skyen i begyndelsen af vores rejse for fredeligt at bygge en så pålidelig lokal platform som muligt. Vi besluttede at deploye vores applikationer med Google Kubernetes Engine, selvom vi vidste, at vi før eller senere ville gå over til vores egne datacentre og anvende en hybrid strategi.
Hvorfor valgte vi GKE?
Vi traf dette valg hovedsageligt af tekniske årsager. Desuden var der behov for hurtigt at levere infrastruktur, der imødekom virksomhedens behov. Vi havde nogle krav til implementeringen af applikationer, såsom geografisk distribution, skalerbarhed og fejlfindingskapacitet.
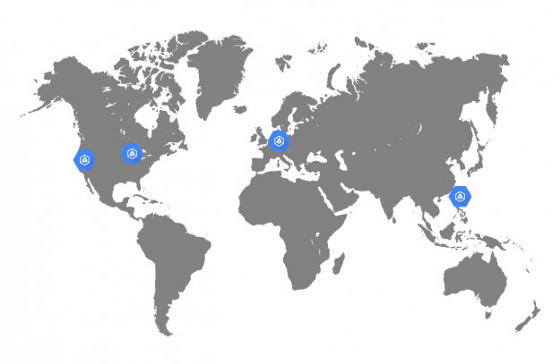
GKE-klynger i Dailymotion
Da Dailymotion er en videotjeneste, der er tilgængelig over hele verden, ønskede vi meget at forbedre servicekvaliteten ved at reducere ventetiden (latency). Tidligere var tilgængelig kun i Paris, hvilket var suboptimalt. Vi ønskede at kunne placere applikationer ikke kun i Europa, men også i Asien og USA.
Denne følsomhed over for forsinkelser betød, at vi måtte arbejde grundigt på platformens netværksarkitektur. Mens de fleste cloud-tjenester tvang os til at oprette vores netværk i hver region og derefter forbinde dem via VPN eller en eller anden administreret tjeneste, gjorde Google Cloud det muligt at oprette et helt routabelt enkelt netværk, der dækkede alle Google-regioner. Dette er et stort plus i forhold til drift og effektivitet af systemet.
Desuden fungerer netværkstjenesterne og belastningsbalancerne fra Google Cloud fremragende. De giver muligheden for at bruge vilkårlige offentlige IP-adresser fra hver region, og den fantastiske BGP-protokol håndterer resten (dvs. omdirigerer brugerne til den nærmeste klynge). Det er tydeligt, at i tilfælde af fejl vil trafikken automatisk gå til en anden region uden menneskelig indblanding.
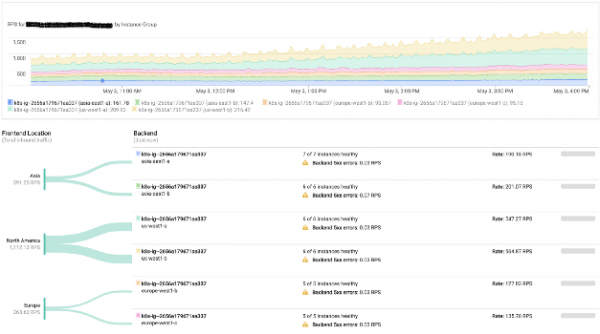
Overvågning af belastningsbalancering i Google
Vores platform bruger også GPU'er aktivt. Google Cloud gør det muligt at udnytte dem meget effektivt direkte i Kubernetes-klynger.
I mellemtiden koncentrerede infrastrukturteamet sig primært om den gamle stak, der var implementeret på fysiske servere. Derfor opfyldte brugen af en administreret tjeneste (herunder masterkomponenter fra Kubernetes) vores krav og gjorde det muligt at træne teamene i at arbejde med lokale klynger.
Som et resultat kunne vi begynde at modtage production-trafik på Google Cloud-infrastrukturen blot seks måneder efter projektets start.
Men på trods af en række fordele medfører arbejdet med en cloud-udbyder visse omkostninger, der kan stige afhængigt af belastningen. Derfor analyserede vi omhyggeligt hver administreret tjeneste, vi brugte, for at planlægge at implementere dem on-premises i fremtiden. Faktisk begyndte implementeringen af lokale klynger i slutningen af 2016, og en hybridstrategi blev også initieret dengang.
Lancering af Dailymotion's lokale containerorkestreringsplatform
Efteråret 2016
Under betingelser, hvor hele stakken var klar til produktion, mens arbejdet med API'et , der var tid til at fokusere på regionale klynger.
På det tidspunkt så brugerne mere end 3 milliarder videoer hver måned. Selvfølgelig havde vi allerede haft vores egen omfattende Content Delivery Network i flere år. Vi ønskede at udnytte denne situation og implementere Kubernetes-klynger i de eksisterende datacentre.
Dailymotion's infrastruktur bestod af mere end 2.500 servere i seks datacentre. Alle konfigureres ved hjælp af Saltstack. Vi begyndte at forberede alle nødvendige opskrifter til at oprette master- og worker-noder samt etcd-klyngen.
Netværksdelen
Vores netværk er fuldt routable. Hver server annoncerer sin IP i netværket ved hjælp af Exabgp. Vi sammenlignede flere netværksplugins, og den eneste, der opfyldte alle behov (på grund af den L3-tilgang, der blev anvendt), var . Den passede perfekt ind i den eksisterende netværksmodel for infrastrukturen.
Da vi ønskede at bruge alle de eksisterende elementer i infrastrukturen, var det først og fremmest nødvendigt at forstå vores egen netværksværktøj (der blev brugt på alle servere): at bruge det til at annoncere IP-adresseområder i netværket med Kubernetes-noder. Vi lod Calico tildele IP-adresser til pods, men brugte det ikke, og bruger det heller ikke til BGP-sessioner på netværksudstyret. Faktisk håndterer Exabgp routingen, som annoncerer de subnet, der bruges af Calico. Dette gør det muligt for os at nå enhver pod fra det interne netværk (herunder fra load balancere).
Sådan håndterer vi ingress-trafikken
For at omdirigere indkommende anmodninger til den rigtige tjeneste besluttede vi at bruge Ingress Controller på grund af dens integration med Kubernetes-ingress-resurserne.
For tre år siden var nginx-ingress-controller den mest modne controller: Nginx havde været brugt i lang tid og var kendt for sin stabilitet og ydeevne.
I vores system har vi valgt at placere controllere på dedikerede 10-gigabit blade-servere. Hver controller blev tilsluttet til endpoint'et kube-apiserver for den pågældende klynge. På disse servere blev Exabgp også anvendt til at annoncere offentlige eller private IP-adresser. Topologien i vores netværk muliggør brugen af BGP fra disse controllere til at rute al trafik direkte til pod's uden at bruge en service som NodePort. Denne tilgang hjælper med at undgå horisontal trafik mellem noderne og forbedrer effektiviteten.
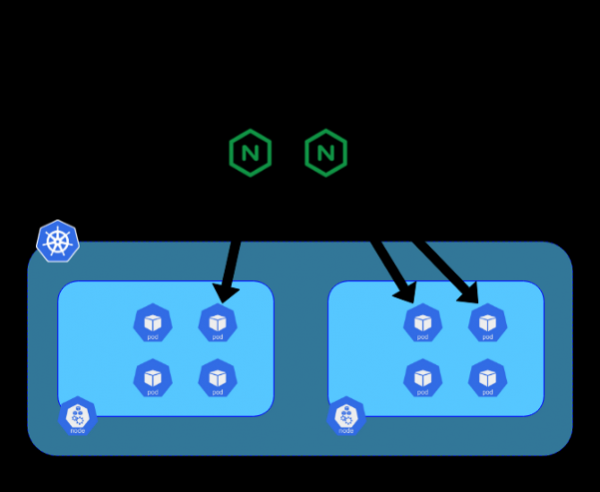
Trafikbevægelse fra internettet til pod's
Nu hvor vi har fået styr på vores hybride platform, kan vi dykke dybere ned i selve migreringsprocessen af trafikken.
Migration af trafik fra Google Cloud til Dailymotion-infrastrukturen
Efterår 2018
Efter næsten to års udvikling, testning og konfiguration har vi endelig fået en komplet Kubernetes-stack klar til at tage imod en del af trafikken.
Den aktuelle rute-strategi er ganske simpel, men tilfredsstiller behovene. Udover offentlige IP'er (i Google Cloud og Dailymotion) anvendes AWS Route 53 til at definere politikker og omdirigere brugerne til den klynge, vi vælger.
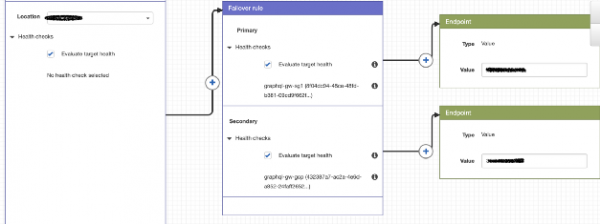
Eksempel på en rute-politik med brug af Route 53
Fra Google Cloud er det enkelt, da vi bruger en enkelt IP for alle klynger, og brugeren bliver omdirigeret til den nærmeste GKE-klynge. For vores klynger er teknologien anderledes, da deres IP'er er forskellige.
Under migreringen stræbte vi efter at omdirigere regionale forespørgsler til de relevante klynger og vurderede fordelene ved denne tilgang.
Da vores GKE-klynger er konfigureret til automatisk skalering ved hjælp af Custom Metrics, øger/reducerer de kapaciteten afhængigt af den indkommende trafik.
I normal drift bliver al regional trafik dirigeret til den lokale klynge, mens GKE fungerer som en backup i tilfælde af problemer (health-checks udføres af Route 53).
…
I fremtiden ønsker vi at automatisere routingpolitikkerne fuldstændigt for at opnå en autonom hybridstrategi, der konstant forbedrer tilgængeligheden for brugerne. Når det kommer til fordelene: omkostningerne til skyen er blevet betydeligt reduceret, og vi har endda været i stand til at reducere API-responstiden. Vi har tillid til den resulterende cloud-platform og er klar til at omdirigere mere trafik til den efter behov.
P.S. fra oversætteren
Du kunne også være interesseret i en anden nylig Dailymotion-udgivelse om Kubernetes. Den omhandler implementering af applikationer med Helm på flere Kubernetes-klynger, og for omkring en måned siden.
Læs også på vores blog:
- «».
- «»;
- «»;
- «»;
- «»;
- «»;
- «»;
- «»;
- «»;
- «»;
- «».
Kilde: habr.com
