

3. Strukturer ved brug af globale variabler
En sådan struktur som et ordnet træ har forskellige specifikke tilfælde. Lad os overveje dem, der har praktisk værdi ved arbejde med globale variabler.
3.1 Specifikt tilfælde 1. En node uden grene
 Globale variabler kan bruges ikke kun som et array, men også som almindelige variable. For eksempel som en tæller:
Set ^counter = 0  ; opsæt tæller
Set id=$Increment(^counter) ;  atomisk inkrementering
Samtidig kan den globale variabel, ud over værdien, også have grene. Det ene udelukker ikke det andet.
3.2 Specifikt tilfælde 2. En top og mange grene
Generelt set er dette en klassisk key-value database. Og hvis vi gemmer et tuple af værdier som værdi, får vi et helt almindeligt bord med en primær nøgle.
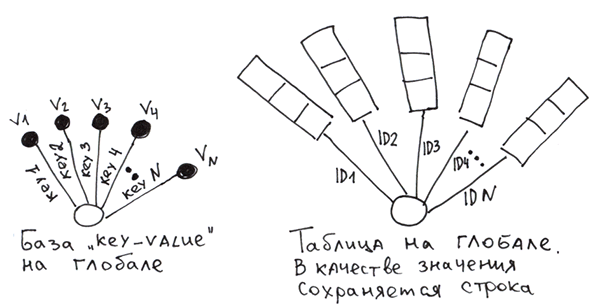
For at implementere tabellen med globale variabler skal vi selv danne strenge fra kolonneværdierne og derefter gemme dem i den globale variabel med den primære nøgle. For at det skal være muligt at opdele strengen tilbage i kolonner, kan vi bruge:
- adskillelsessymboler.
Set ^t(id1) = "col11/col21/col31" Set ^t(id2) = "col12/col22/col32" - en fast skema, hvor hvert felt optager et forudbestemt antal byte. Som det gøres i relationelle databaser.
- en speciel funktion $LB (tilgængelig i Cache), som sammensætter en streng af værdier.
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^t(id2) = $LB("col12", "col22", "col32")
Det er interessant, at det ikke er svært at lave noget svarende til sekundære indekser i relationelle databaser med globale variabler. Lad os kalde disse strukturer indeksglobaler. En indeksglobal er et hjælpetræ til hurtig søgning i felter, der ikke er dele af den primære nøgle i den grundlæggende globale variabel. For at fylde og bruge det kræves der ekstra kode.
Lad os oprette en indeksglobal baseret på den første kolonne.
Set ^i("col11", id1) = 1
Set ^i("col12", id2) = 1
Nu skal vi for hurtig information søge i den globale variabel ^i og finde de primære nøgler (id), der svarer til den ønskede værdi i den første kolonne.
Ved indsættelse af en værdi kan vi straks oprette både værdi og indeksglobale variabler for de ønskede felter. For pålidelighed kan vi indkapsle det hele i en transaktion.
TSTART
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^i("col11", id1) = 1
TCOMMIT
Detaljer om, hvordan man laver på M , .
Tabellerne vil fungere lige så hurtigt som i traditionelle databaser (eller endda hurtigere), hvis indsætnings-/opdaterings-/slettefunktionerne skrives i COS/M og kompilere.Dette udsagn har jeg testet med store INSERT- og SELECT-kommandoer i en to-kolonne tabel, inklusiv brugen af TSTART- og TCOMMIT-kommandoer (transaktioner).
Jeg har ikke testet mere komplekse scenarier med konkurrentadgang og parallelle transaktioner.
Uden brug af transaktioner var indsætningshastigheden ved en million værdier 778.361 indsætninger/sekund.
Ved 300 millioner værdier var hastigheden 422.141 indsætninger/sekund.
Ved brug af transaktioner var hastigheden 572.082 indsætninger/sekund på 50M indsætninger. Alle operationer blev udført fra kompilert M-kode.
De anvendte harddiske var almindelige, ikke SSD. RAID5 med Write-back. Processor: Phenom II 1100T.
For tilsvarende test af SQL-databaser skal man skrive en gemt procedure, der i en løkke foretager indsættelser. Under test af MySQL 5.5 (InnoDB-lager) fik jeg ikke tal højere end 11K indsætninger i sekundet.
Ja, implementeringen af tabeller i globale ser mere kompleks ud end i relationelle databaser. Derfor har industrielle databaser på globale SQL-adgang for at forenkle arbejdet med tabeldata.
 Generelt, hvis dataskemaet ikke ændres ofte, er indsættelseshastigheden ikke kritisk, og hele databasen kan let repræsenteres som normaliserede tabeller, så det er lettere at arbejde med SQL, da det giver et højere abstraheringsniveau.
 I dette specifikke tilfælde ville jeg vise, at globale kan fungere som en byggesten til at skabe andre databaser. Ligesom assembler, på hvilket man kan skrive andre sprog. Her er eksempler på, hvordan man kan skabe på globale svarende til
Hvis man skal oprette en eller anden ikke-standard database med minimale anstrengelser, er det værd at kigge mod globale.
3.3 Specifik tilfælde 3. To-niveau træ, hvor hver node på det andet niveau har et fast antal grene
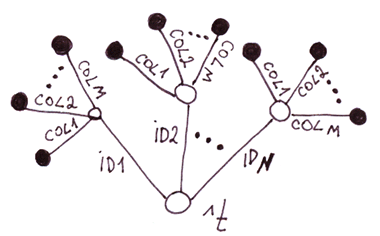 Du har sikkert gættet det: dette er en alternativ implementering af tabeller på globale. Lad os sammenligne denne implementering med den tidligere.
Tabeller i to-niveau træ vs. i et en-niveau træ.
Ulemper
Fordele
- Langsommere ved indsættelse, da man skal sætte antallet af noder lig med antallet af kolonner.
- Større forbrug af diskplads. Da globale indekser (i forståelsen af indekser i arrays) med kolonnenavne optager plads på disken og duplikeres for hver række.
- Hurtigere adgang til værdier i enkelte kolonner, da du ikke behøver at parse rækken. I mine tests hurtigere med 11,5 % for 2 kolonner og endnu mere for et større antal kolonner.
- Nemmere at ændre dataskemaet
- Koden er mere overskuelig
Output: til den enkelte. Da hastighed er et af de mest centrale fordele ved globaler, giver det næsten ikke mening at bruge denne implementering, da den sandsynligvis ikke vil være hurtigere end tabeller i relationelle databaser.
3.4 Generel sag. Træer og ordnede træer
Enhver datastruktur, der kan repræsenteres som et træ, passer perfekt til globaler.
3.4.1 Objekter med underobjekter
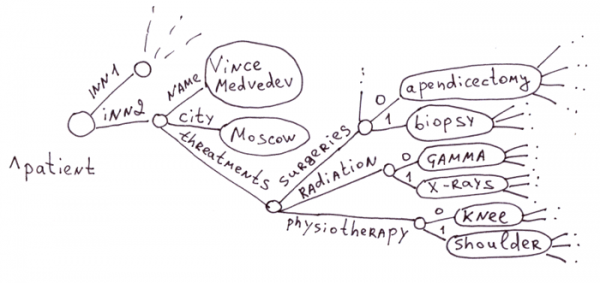
Dette er området for traditionel anvendelse af globaler. I den medicinske sektor er der et enormt antal sygdomme, lægemidler, symptomer, behandlingsmetoder. At oprette en tabel for hver patient med en million felter er ufornuftigt. Især da 99 % af felterne vil være tomme.
Forestil dig en SQL-database fra tabeller: "patient" ~ 100.000 felter, "lægemiddel" - 100.000 felter, "terapi" - 100.000 felter, "komplikationer" - 100.000 felter osv. Du kan også oprette en database med mange tusinde tabeller, hver til en specifik patienttype (og de kan jo overlappe!), behandling, medicin, og også tusindvis af tabeller til forbindelser mellem disse tabeller.
Globaler passer perfekt til medicin, da de giver mulighed for at lave en præcis beskrivelse af hver patients sygehistorie, forskellige terapier, lægers handlinger i form af et træ, uden at spilde unødig diskplads på tomme kolonner, som det ville være i det relationelle tilfælde.
 Med globaler er det praktisk at lave en database med oplysninger om mennesker, når det er vigtigt at indsamle og systematisere maksimalt varieret information om kunden. Dette er efterspurgt i medicin, banksektoren, marketing, arkivering og andre områder
.
Uden tvivl kan man også simulere et træ i SQL med blot et par tabeller (, ,,,,,,,,,), men det er væsentligt mere komplekst, og det vil fungere langsommere. I realiteten ville det kræve at skrive globale funktioner, der arbejder på tabeller og skjule al arbejde med tabeller bag et abstraktionslag. Det er ikke korrekt at emulere lavniveau teknologi (globale funktioner) med højniveau værktøjer (SQL). Det er uhensigtsmæssigt.
Det er ingen hemmelighed, at det kan tage lang tid at ændre dataskemaer på kæmpestore tabeller (ALTER TABLE). MySQL, for eksempel, udfører ALTER TABLE ADD|DROP COLUMN ved fuld kopiering af information fra den gamle til den nye tabel (jeg har testet motorerne MyISAM, InnoDB). Dette kan få en aktiv database med milliarder af poster til at hænge i dage, hvis ikke uger.
 Ændring af datastukturen, hvis vi bruger globale funktioner, koster os ingenting. Vi kan når som helst tilføje de nødvendige nye egenskaber til ethvert objekt på ethvert niveau i hierarkiet. Ændringer relateret til renaming af grene kan køres i baggrunden på en aktiv database.
Derfor, når det kommer til opbevaring af objekter med et enormt antal valgfri egenskaber, er globale funktioner et fremragende valg.
Og husk, adgangen til enhver af egenskaberne er øjeblikkelig, da alle stier i globalen repræsenterer et B-træ.
Databaser baseret på globale funktioner er generelt en form for dokumentorienterede databaser med mulighed for at lagre hierarkisk information. Derfor kan dokumentorienterede databaser konkurrere med globale funktioner inden for opbevaring af medicinske journaler. Men det er stadig ikke helt det samme.Lad os tage f.eks. MongoDB til sammenligning. Inden for dette område taper den over for globale funktioner af følgende grunde:
- Dokumentstørrelse. Opbevaringsenheden er tekst i JSON-format (mere præcist BSON) med en maksimal størrelse på cirka 16 MB. Begrænsningen er sat for at sikre, at JSON-databasen ikke bremser ved parsning, hvis den gemmer et stort JSON-dokument, og derefter vil blive tilgået efter felterne. Alle oplysninger om patienten skal være koncentreret i dette dokument. Vi ved alle, hvor tykke patientjournaler kan være. Den maksimale størrelse på journalen på 16 MB sætter straks en stopper for patienter, hvis sygdomsjournaler inkluderer MR-filer, røntgenbilleder og andre undersøgelser. I en gren af den globale funktion kan man dog have information op til gigabyte og terabyte. I princippet kan dette være konklusionen, men jeg fortsætter.
- Tid til bevidsthed/ændring/fjernelse af nye egenskaber i patientkortet. Sådan en database skal læse hele kortet ind i hukommelsen (det er et stort volum!), parse BSON, tilføje/ændre/fjerne en ny knude, opdatere indekser, pakke ind i BSON og gemme det på disken. Globalen har dog kun brug for at henvise til en specifik egenskab og udføre manipulationer med den.
- Hastighed ved adgang til individuelle egenskaber. Når der er mange egenskaber i dokumentet og dets flerdimensionale struktur, vil adgangen til individuelle egenskaber være hurtigere, da hver vej i globalen er et B-træ. I BSON skal dokumentet dog parses lineært for at finde den ønskede egenskab.
3.3.2 Associerede arrays
Associerede arrays (selv med indlejrede arrays) passer glimrende til globaler. For eksempel vil et sådant array fra PHP blive vist i det første billede 3.3.1.
$a = array(
  "name" => "Vince Medvedev",
  "city" => "Moscow",
  "treatments" => array(
    "surgeries" => array("apedicectomy", "biopsy"),
    "radiation" => array("gamma", "x-rays"),
    "physiotherapy" => array("knee", "shoulder")
  )
);
3.3.3 Hierarkiske dokumenter: XML, JSON
De gemmes også let i globaler. For opbevaring kan de struktureres på forskellige måder.
XML
Den enkleste måde at strukturere XML på i globaler er at gemme attributter af tags i noderne. Hvis der er behov for hurtig adgang til tag-attributter, kan vi trække dem ud i separate grene.
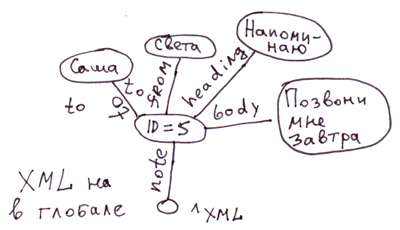
<note id="5">
<to>Vase</to>
<from>Sveta</from>
<heading>Påmindelse</heading>
<body>Ring til mig i morgen!</body>
</note>
I COS vil denne kode svare til:
Set ^xml("note")="id=5"
Set ^xml("note","to")="Sasha"
Set ^xml("note","from")="Sveta"
Set ^xml("note","heading")="Påmindelse"
Set ^xml("note","body")="Ring til mig i morgen!"
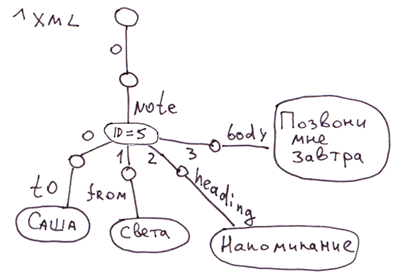
Bemærk: Der kan tænkes mange forskellige måder til at afspejle XML, JSON, associerede arrays i globaler. I dette tilfælde har vi ikke afspejlet rækkefølgen af indlejrede tags i tagget note. I globalen ^xml vil indlejrede tags blive vist i alfabetisk rækkefølge. For præcist at afspejle rækkefølgen kan man bruge for eksempel denne afspejling:
JSON.
I det første billede fra sektion 3.3.1 vises afspejlingen af dette JSON-dokument:
var document = {
  "name": "Vince Medvedev",
  "city": "Moscow",
  "treatments": {
    "surgeries": ["apedicectomy", "biopsy"],
    "radiation": ["gamma", "x-rays"],
    "physiotherapy": ["knee", "shoulder"]
  },
};
3.3.4 Ensartede strukturer med hierarkiske relationer
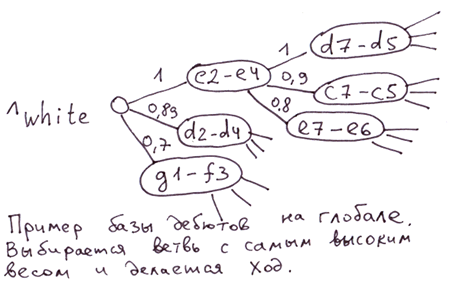
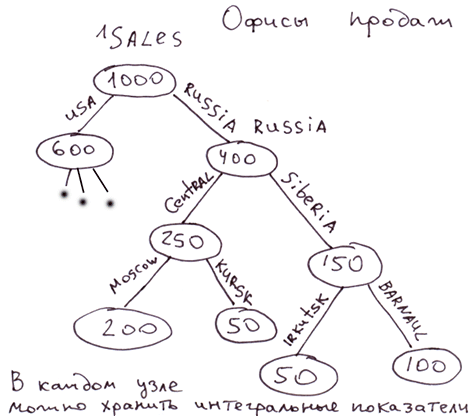
Eksempler: struktur af salgs kontorer, placering af mennesker i MLM-strukturen, database af debuttræk i skak.
Debutdatabase. Som kan anvendes som værdien af global node indeks, kan vurderingen af trækkraft anvendes. Så for at vælge den stærkeste bevægelse, skal du blot vælge den gren med den største vægt. I globalen vil alle grene på hvert niveau være sorteret efter styrken af trækkraft.
Strukturen af salgscontorer, strukturen af personerne i MLM. I noder kan man gemme visse cache-værdier, der afspejler egenskaberne ved hele undertræet. For eksempel volumen af salg for dette undertræ. På ethvert tidspunkt kan vi få tallet, der afspejler præstationerne for enhver gren.
4. Hvornår er det mest fordelagtigt at bruge globaler
I den første kolonne er de tilfælde præsenteret, hvor du vil få en betydelig hastighedsfordel ved at bruge globaler, og i den anden, hvornår udviklingen eller datamodellen vil blive forenklet.
Hastighed
Bekvemmelighed ved behandling / præsentation af data
- Indsættelse [med automatisk sortering på hvert niveau], [indeksering efter hovednøgle]
- Fjernelse af undertræer
- Objekter med masser af indlejrede egenskaber, som har brug for individuel adgang
- Hierarkisk struktur med mulighed for at gennemgå dattergrene fra enhver, selv en ikke-eksisterende
- Gennemgang af undertræer i dybden
- Objekter / enheder med et stort antal valgfri [og / eller indlejrede] egenskaber / enheder
- Schemasfri data (schema-less). Når nye egenskaber ofte kan dukke op og gamle forsvinde.
- Det er nødvendigt at oprette en ikke-standard database.
- Veje databaser og beslutningstræer. Når veje er praktiske at repræsentere som et træ.
- Fjernelse af hierarkiske strukturer uden brug af rekursion
Fortsættelse .
Ansvarsfraskrivelse: Denne artikel og mine kommentarer til den er min mening og har ikke noget at gøre med den officielle position fra InterSystems.
Kilde: habr.com
