

I de sidste par år er tidsserie-databaser blevet transformeret fra en eksotisk ting (der blev anvendt enten i åbne overvågningssystemer, knyttet til specifikke løsninger, eller i Big Data-projekter) til en «forbrugsvare». I Rusland skal særlig anerkendelse gives til Yandex og ClickHouse for dette. Indtil da, hvis du havde behov for at gemme store mængder tidsseriedata, måtte du enten acceptere nødvendigheden af at opsætte en enorm Hadoop-stak og vedligeholde den, eller kommunikere med protokoller, der er specifikke for hvert enkelt system.
Det kan virke som om, at i 2019 vil en artikel om, hvilken TSDB man bør bruge, kun bestå af én sætning: «brug bare ClickHouse». Men… der er nuancer.
Faktisk udvikler ClickHouse sig aktivt, brugerbasen vokser, og supporten er meget aktiv, men er vi blevet fanget i ClickHouse's offentlige succes, som har overskygget andre, måske mere effektive/pålidelige løsninger?
I begyndelsen af sidste år tog vi fat på at redesigne vores eget overvågningssystem, hvor vi stod over for spørgsmålet om valg af den rette database til datalagring. Om historien bag dette valg vil jeg her fortælle.
Problemformulering
Først og fremmest - det nødvendige forord. Hvorfor har vi overhovedet brug for et eget overvågningssystem, og hvordan var det opbygget?
Vi begyndte at yde supporttjenester i 2008, og i 2010 blev det klart, at det blev vanskeligt at aggregere data om, hvad der sker i klienternes infrastruktur med de løsninger, der var tilgængelige på det tidspunkt (vi taler om, undskyld, Cacti, Zabbix og det spirende Graphite).
Vores primære krav var:
- vedligeholdelse (på det tidspunkt - titusinder, og på sigt - hundredvis) af kunder inden for ét system, samtidig med at der var et centraliseret alarmsystem;
- fleksibilitet i styringen af alarmsystemet (eskalering af alarmer mellem vagter, hensyntagen til tidsplaner, vidensdatabase);
- mulighed for dybdegående detaljerede grafer (Zabbix tegnede på det tidspunkt grafer som billeder);
- langvarig opbevaring af store mængder data (et år eller mere) og muligheden for hurtig forespørgsel.
I denne artikel er vi interesseret i det sidste punkt.
Når det kommer til lagring, var kravene følgende:
- systemet skal være hurtigt;
- det ville være ønskeligt, at systemet havde en SQL-interface;
- systemet skal være stabilt og have en aktiv brugerbase og support (vi har tidligere været nødt til at støtte systemer som MemcacheDB, som ikke længere blev udviklet, eller det distribuerede lagersystem MooseFS, hvis bug tracker var på kinesisk: vi ønskede ikke at gentage denne historie for vores projekt);
- overholdelse af CAP-teoremet: Consistency (nødvendigt) — data skal være aktuelle, vi vil ikke have, at systemet for advarsler ikke modtager nye data og spammer med advarsler om manglende data for alle projekter; Partition Tolerance (nødvendigt) — vi vil ikke opleve et Split Brain-system; Availability (ikke kritisk, hvis der eksisterer en aktiv replika) — vi kan selv skifte til det backup-system i tilfælde af en nedbrud, ved hjælp af kode.
Mærkeligt nok var MySQL på det tidspunkt den ideelle løsning for os. Vores datamodel var ekstremt simpel: id for server, id for tæller, timestamp og værdi; hurtig forespørgsel af varme data blev sikret ved en stor buffer pool, mens forespørgslen af historiske data blev håndteret af SSD.
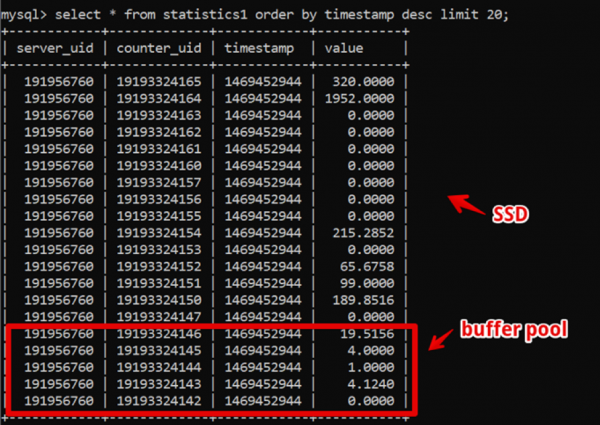
Dermed opnåede vi forespørgsler af friske data fra de seneste to uger med en detaljegrad ned til sekunder på 200 ms før fuld rendering af dataene, og vi levede i dette system i lang tid.
Imens gik tiden, og mængden af data voksede. I 2016 havde datamængderne nået titusinder af terabyte, hvilket var en betydelig omkostning under lejeaftaler for SSD-lagringssystemer.
På dette tidspunkt havde søjledatabaser fået en aktiv udbredelse, og vi begyndte at tænke aktivt over dem: i søjledatabaser gemmes data, som navnet antyder, i kolonner, og hvis vi ser på vores data, er der mange dubletter, som kunne komprimeres, hvis vi brugte en søjledatabase.
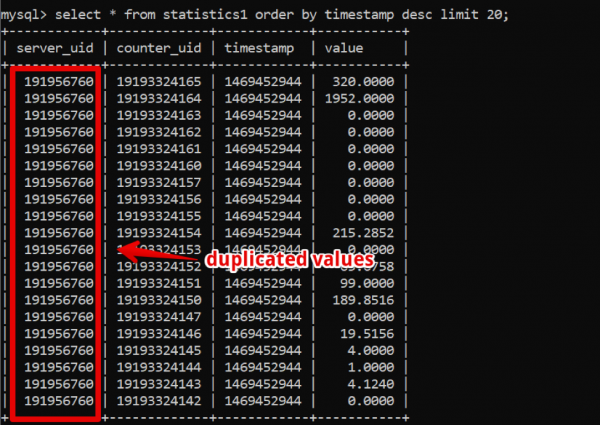
Men den nøglefunktionelle system for virksomheden fortsatte med at køre stabilt, og vi ønskede ikke at experimentere med at skifte til noget andet.
I 2017 delt udviklerne af Clickhouse sandsynligvis første gang deres budskab på Percona Live-konferencen i San Jose. Ved første øjekast var systemet produktionsklart (nå, Yandex.Metrica er en hård produktion), supporten var hurtig og enkel, og vigtigst af alt, driften var ligetil. Siden 2018 har vi igangsat overgangen. Men på det tidspunkt var der mange 'voksne' og tidstestede TSDB-systemer, og vi besluttede at afsætte betydelig tid til at sammenligne alternativer for at sikre, at der ikke findes alternative løsninger til Clickhouse, der opfylder vores krav.
Ud over de allerede nævnte krav til lagringssystemet kom der nye:
- det nye system skal sikre mindst samme ydelse som MySQL på det samme antal servere;
- lagringssystemet skal tage betydeligt mindre plads;
- DBMS'en skal stadig være let at administrere;
- vi ønskede at ændre applikationen mindst muligt ved skift af DBMS.
Hvilke systemer begyndte vi at overveje
Apache Hive/Apache Impala
Den gamle, veldokumenterede Hadoop-stak. I det væsentlige er det et SQL-grænseflade, der er bygget oven på lagring af data i egne formater på HDFS.
Fordele.
- Ved stabil drift er det meget nemt at skalere data.
- Der findes kolonne-baserede løsninger til datalagring (mindre plads).
- Meget hurtig udførelse af parallelle opgaver ved tilstrækkelige ressourcer.
Ulemper.
- Det er Hadoop, og det er komplekst at drifte. Hvis vi ikke er klar til at tage en færdig løsning i skyen (og vi er ikke klart i forhold til omkostninger), vil hele stakken skulle samles og vedligeholdes af administratorer, og det ville vi helst undgå.
- Dataene aggregeres .
Men:
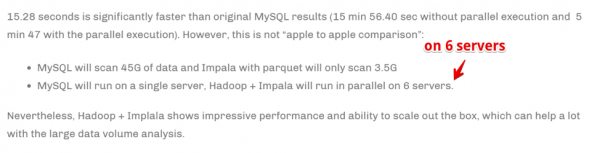
Hastigheden opnås ved at skalere antallet af compute-servere. For at sige det enkelt, hvis vi er en stor virksomhed, der beskæftiger sig med analyse, og det er kritisk for forretningen, at vi hurtigst muligt kan aggregere information (selv hvis det koster at bruge mange compute-ressourcer), kan dette være vores valg. Men vi var ikke klar til at øge antallet af servere betydeligt for hastigheden ved udførelse af opgaver.
Druid/Pinot
Allerede meget mere specifikt om TSDB, men igen — Hadoop-stak.
Der er .
Hvis man skulle opsummere: Druid/Pinot ser bedre ud end Clickhouse i tilfælde, hvor:
- Du har en heterogen datakarakter (i vores tilfælde registrerer vi kun tidsserier af servermetrikker, og det er i bund og grund én tabel. Men der kan være andre tilfælde: tidsserier af udstyr, økonomiske tidsserier osv. — hver med sin egen struktur, som skal aggregeres og behandles).
- Der er imidlertid rigtig meget af disse data.
- Tabeller og data med tidsserier dukker op og forsvinder (det vil sige, et databesæt ankom, blev analyseret og derefter slettet).
- Der er ingen klare kriterier, som data kan partitioneres efter.
I modsatte tilfælde viser ClickHouse sig at være bedre, og det er vores tilfælde.
ClickHouse
- SQL-lignende.
- Nem at administrere.
- Folk siger, at den fungerer.
Kommer på shortlisten til testning.
InfluxDB
Udenlandsk alternativ til ClickHouse. Ulemper: High Availability findes kun i den kommercielle version, men det skal sammenlignes.
Kommer på shortlisten til testning.
Cassandra
På den ene side ved vi, at den bruges til opbevaring af metriske tidsserier af overvågningssystemer som f.eks. eller OkMeter. Der er dog specifikheder.
Cassandra er ikke en kolonne-database i dens sædvanlige forståelse. Den ligner mere en række-database, men i hver række kan der være et forskelligt antal kolonner, hvilket gør det nemt at organisere et kolonneformat. I denne forstand er det klart, at med en grænse på 2 milliarder kolonner kan visse data gemmes netop i kolonnerne (f.eks. de samme tidsserier). I MySQL er der en grænse på 4096 kolonner, og man kan let støde på en fejl med koden 1117, hvis man prøver at gøre det samme.
Cassandra-motoren er designet til at gemme store datamængder i et distribueret system uden en master, og ifølge den nævnte CAP-teorem er Cassandra mere fokuseret på AP, hvilket betyder datatilgængelighed og modstandsdygtighed over for partiopdeling. Derfor kan dette værktøj være ideelt, hvis man primært skriver til databasen og kun sjældent læser fra den. Det giver mening at bruge Cassandra som et "koldt" lager, det vil sige som et langvarigt pålideligt opbevaringssted for store mængder historiske data, som sjældent er nødvendige, men som kan hentes, hvis det er nødvendigt. Ikke desto mindre, for fuldstændighedens skyld, lad os også teste det. Men som jeg tidligere har nævnt, er der ikke lyst til aktivt at omskrive koden til den valgte databaseringsløsning, så vi vil teste den med nogle begrænsninger — uden at tilpasse databasens struktur til Cassandra's specifikationer.
Prometheus
Og ud af ren interesse besluttede vi at teste ydeevnen af Prometheus-lageret — bare for at finde ud af, om vi er hurtigere eller langsommere end de nuværende løsninger, og i hvilken grad.
Metode og testresultater
Så vi testede 5 databaser i de følgende 6 konfigurationer: ClickHouse (1 node), ClickHouse (fordelt tabel på 3 noder), InfluxDB, Mysql 8, Cassandra (3 noder) og Prometheus. Testplanen er som følger:
- vi uploader historiske data for en uge (840 millioner værdier om dagen; 208.000 metrikker);
- vi genererer skrivebelastning (vi så på 6 belastningsscenarier, se nedenfor);
- samtidig med skrivningen laver vi periodisk forespørgsler, som imiterer en bruger, der arbejder med grafer. For at holde det enkelt valgte vi data for 10 metrikker (præcis så mange som på CPU-grafen) over en uge.
Vi belaster systemet ved at efterligne adfærden af vores overvågningsagent, som sender værdier til hver metrisk hvert 15. sekund. I den forbindelse er vi interesserede i at variere:
- det samlede antal metrikker, der modtager data;
- intervallet for sending af værdier til en metrisk;
- batchstørrelsen.
Om batchstørrelsen. Da næsten alle vores forsøgsdatabaser ikke anbefales at blive belastet med enkelte indsætninger, har vi brug for en relay, der indsamler de indkommende metrikker og grupperer dem, så de kan skrives i databasen ved batchindsætning.
For a better understanding of how to interpret the obtained data, let's imagine that we are not just sending a bunch of metrics, but that the metrics are organized into servers — with 125 metrics per server. Here, a server is simply a virtual entity — just to illustrate that, for example, 10,000 metrics correspond to about 80 servers.
Considering all this, our 6 modes of database writing load are:
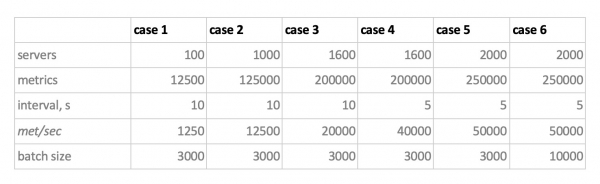
There are two points here. First, for Cassandra, such batch sizes turned out to be too large; there we used values of 50 or 100. Secondly, since Prometheus operates strictly in pull mode, meaning it fetches data from metric sources itself (and even pushgateway, despite its name, does not fundamentally change the situation), the corresponding loads were implemented using a combination of static configs.
The testing results are as follows:
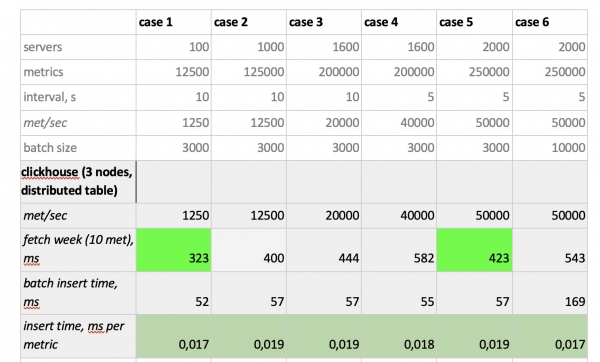
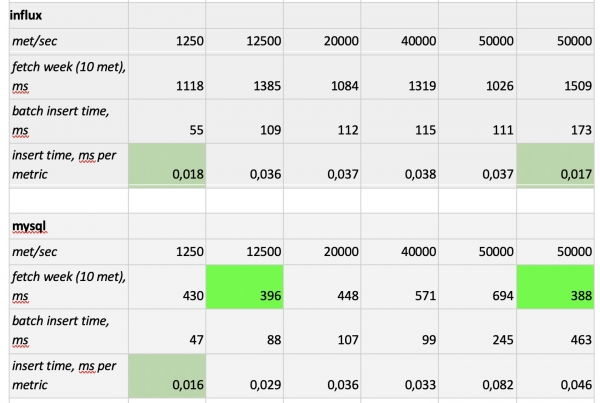
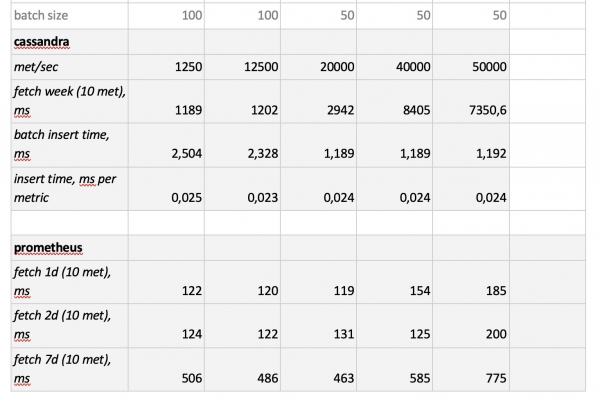
What is worth noting: fantastically fast queries from Prometheus, horribly slow queries from Cassandra, unacceptably slow queries from InfluxDB; ClickHouse won in terms of write speed, while Prometheus does not participate in the competition because it performs inserts internally, and we are not measuring anything.
In the end,: ClickHouse and InfluxDB performed the best, but a cluster of Influx can only be built on the Enterprise version, which costs money, while ClickHouse is free and made in Russia. Logically, in the USA, the choice is perhaps in favor of InfluxDB, whereas here it is in favor of ClickHouse.
Kilde: habr.com
