

Hej, Habr! I denne artikel vil jeg gerne fortælle om et fantastisk værktøj til udvikling af batch-processer til databehandling, for eksempel i infrastrukturen af virksomhedens DWH eller dit DataLake. Det handler om Apache Airflow (herefter Airflow). Det er uretfærdigt undervurderet på Habr, og i hovedparten af artiklen vil jeg forsøge at overbevise dig om, at Airflow i hvert fald er værd at overveje, når du vælger en planlægger til dine ETL/ELT-processer.
Tidligere skrev jeg en serie artikler om DWH, da jeg arbejdede i Tinkoff-banken. Nu er jeg blevet en del af Mail.Ru Group-teamet og arbejder med udviklingen af platformen til dataanalyse inden for spilområdet. Edele, efterhånden som nyheder og interessante løsninger dukker op, vil vi i teamet fortælle her om vores platform til dataanalyse.
Prolog
Lad os komme i gang. Hvad er Airflow? Det er et bibliotek (eller ) til udvikling, planlægning og overvågning af arbejdsprocesser. Den primære egenskab ved Airflow: til beskrivelse (udvikling) af processer bruges kode på Python. Dette fører til mange fordele for organiseringen af dit projekt og udvikling: i bund og grund er dit (for eksempel) ETL-projekt bare et Python-projekt, og du kan organisere det som du ønsker, med hensyn til infrastruktur, teamstørrelse og andre krav. Det hele er enkelt værktøjsmæssigt. Brug for eksempel PyCharm + Git. Det er fantastisk og meget praktisk!
Lad os nu se på de grundlæggende enheder i Airflow. Når du forstår deres essens og formål, vil du optimalt kunne organisere arkitekturen af processerne. Måske er den grundlæggende enhed Directed Acyclic Graph (herefter DAG).
DAG
DAG er en semantisk samling af dine opgaver, som du ønsker at udføre i en strengt defineret rækkefølge efter et bestemt skema. Airflow tilbyder et brugervenligt webinterface til arbejde med DAG'er og andre enheder:
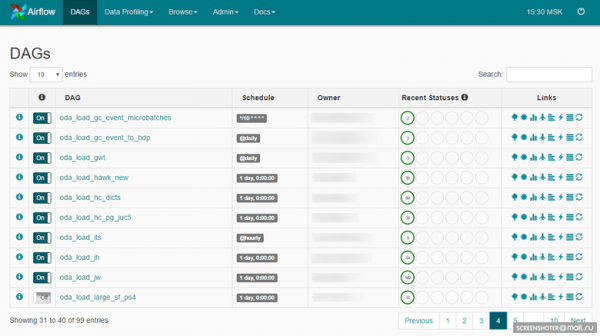
DAG kan se således ud:
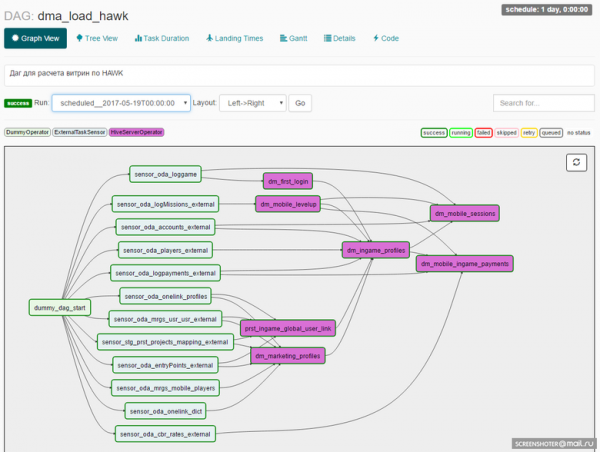
Når en udvikler designer en DAG, indbygger han et sæt operatorer, som opgaverne inden for DAG'en vil blive bygget på. Her kommer vi til en anden vigtig enhed: Airflow Operator.
Operatører
En operator er en enhed, hvorpå instanser af opgaver skabes, og som beskriver, hvad der vil ske under udførelsen af instansen af opgaven. indeholder allerede et sæt operatorer, der er klar til brug. Eksempler:
- BashOperator — operator til at udføre bash-kommandoer.
- PythonOperator — operator til at kalde Python-kode.
- EmailOperator — operator til at sende e-mails.
- HTTPOperator — operator til at håndtere http-forespørgsler.
- SqlOperator — operator til at udføre SQL-kode.
- Sensor — en operator, der venter på en begivenhed (f.eks. tidspunkt, tilstedeværelsen af en nødvendig fil, en række i databasen, svar fra API'en osv.).
Der er mere specifikke operatorer: DockerOperator, HiveOperator, S3FileTransferOperator, PrestoToMysqlOperator, SlackOperator.
Du kan også udvikle operatorer tilpasset dine behov og bruge dem i dit projekt. For eksempel har vi skabt MongoDBToHiveViaHdfsTransfer, en operator til eksport af dokumenter fra MongoDB til Hive, og flere operatorer til at arbejde med : CHLoadFromHiveOperator og CHTableLoaderOperator. I bund og grund, så snart der opstår hyppigt anvendt kode baseret på de grundlæggende operatorer i dit projekt, kan du overveje at samle det i en ny operator. Dette vil forenkle den fremtidige udvikling og berige dit biblioteks samling af operatorer.
Dernæst skal alle disse opgaver udføres, og nu handler det om planlæggeren.
Scheduler
Opgaveplanlæggeren i Airflow er bygget på . Celery er et Python-bibliotek, der gør det muligt at organisere en kø samt asynkron og distribueret udførelse af opgaver. I Airflow opdeles alle opgaver i puljer. Puljerne oprettes manuelt. Formålet er typisk at begrænse belastningen på arbejdet med kilden eller kategorizere opgaver inden for DWH. Puljerne kan administreres via webgrænsefladen:
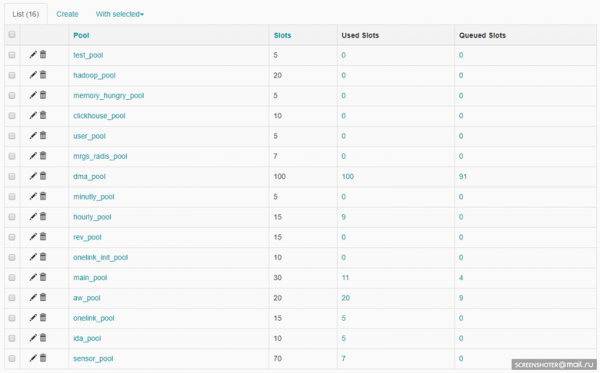
Hver pulje har en grænse for antallet af pladser. Når der oprettes en DAG, tildeles den en pulje:
ALERT_MAILS = Variable.get("gv_mail_admin_dwh")
DAG_NAME = 'dma_load'
OWNER = 'Vasya Pupkin'
DEPENDS_ON_PAST = True
EMAIL_ON_FAILURE = True
EMAIL_ON_RETRY = True
RETRIES = int(Variable.get('gv_dag_retries'))
POOL = 'dma_pool'
PRIORITY_WEIGHT = 10

start_dt = datetime.today() - timedelta(1)
start_dt = datetime(start_dt.year, start_dt.month, start_dt.day)

default_args = {
    'owner': OWNER,
    'depends_on_past': DEPENDS_ON_PAST,
    'start_date': start_dt,
    'email': ALERT_MAILS,
    'email_on_failure': EMAIL_ON_FAILURE,
    'email_on_retry': EMAIL_ON_RETRY,
    'retries': RETRIES,
    'pool': POOL,
    'priority_weight': PRIORITY_WEIGHT
}
dag = DAG(DAG_NAME, default_args=default_args)
dag.doc_md = __doc__
Puljen, der er angivet på DAG-niveau, kan overskrives på opgavniveau.
En separat proces, Scheduler, er ansvarlig for planlægning af alle opgaver i Airflow. Scheduler håndterer al mekanikken bag placeringen af opgaver til udførelse. En opgave går gennem flere faser, før den kan udføres:
- I DAG'en er de tidligere opgaver udført, og en ny kan sættes i kø.
- Køen sorteres afhængigt af opgavernes prioritet (prioriteterne kan også styres), og hvis der er en ledig slot i puljen, kan opgaven tages under arbejde.
- Hvis der er en ledig celery-worker, sendes opgaven til den; arbejdet, som du har programmeret i opgaven, påbegyndes ved hjælp af den eller den anden operator.
Det er relativt enkelt.
Scheduler'en arbejder på tværs af alle DAG'er og alle opgaver inden for DAG'erne.
For at Scheduler'en kan begynde at arbejde med DAG'en, skal DAG'en have et tidsplan:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='@hourly')Der er et sæt af færdige presets: @once, @hourly, @daily, @weekly, @monthly, @yearly.
Du kan også bruge cron-udtryk:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='*/10 * * * *')Execution Date
For at forstå, hvordan Airflow fungerer, er det vigtigt at forstå, hvad Execution Date for en DAG er. I Airflow har en DAG en dimension Execution Date, det vil sige, at der oprettes instanser af opgaver for hver Execution Date baseret på DAG'ens arbejdsplan. Og for hver Execution Date kan opgaverne udføres igen — eller f.eks. kan DAG'en køre samtidig i flere Execution Dates. Dette er illustreret her:
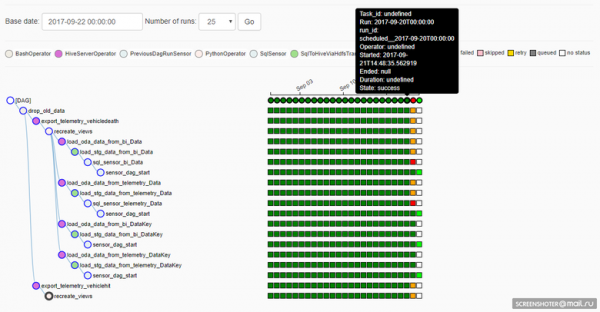
Desværre (eller måske heldigvis: det afhænger af situationen), hvis implementeringen af en opgave i DAG'en ændres, vil udførelsen i tidligere Execution Dates allerede ske med hensyn til justeringerne. Dette er godt, hvis du skal genberegne data fra fortiden med en ny algoritme, men dårligt, fordi reproducerbarheden af resultatet går tabt (selvfølgelig er der intet, der forhindrer dig i at trække den nødvendige version af kilden tilbage fra Git og engangsberegne det, der er nødvendigt, på den måde, det er nødvendigt).
Generering af opgaver
Implementeringen af DAG'en er kode i Python, så vi har en meget praktisk måde at reducere mængden af kode på, når vi arbejder med f.eks. sharded datakilder. Antag, at du har tre sharder MySQL som datakilde, og du skal tilgå hver enkelt og hente nogle data. Og det uafhængigt og parallelt. Koden i Python i DAG'en kan se således ud:
connection_list = lv.get('connection_list')

export_profiles_sql = '''
SELECT
  id,
  user_id,
  nickname,
  gender,
  {{params.shard_id}} as shard_id
FROM profiles
'''

for conn_id in connection_list:
    export_profiles = SqlToHiveViaHdfsTransfer(
        task_id='export_profiles_from_' + conn_id,
        sql=export_profiles_sql,
        hive_table='stg.profiles',
        overwrite=False,
        tmpdir='/data/tmp',
        conn_id=conn_id,
        params={'shard_id': conn_id[-1:], },
        compress=None,
        dag=dag
    )
    export_profiles.set_upstream(exec_truncate_stg)
    export_profiles.set_downstream(load_profiles)
DAG'en ser således ud:
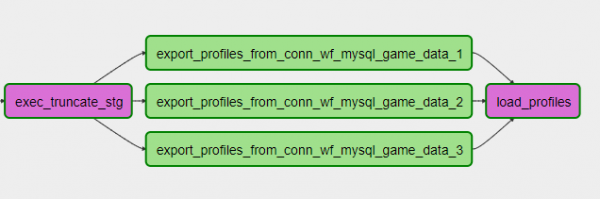
Man kan tilføje eller fjerne et shard ved blot at justere indstillingen og opdatere DAG'en. Nemt!
Det er også muligt at bruge en mere kompleks kodegenerering, for eksempel at arbejde med kilder i form af databaser eller beskrive tabelstrukturen, algoritmen til at arbejde med tabellen og under hensyntagen til DWH-infrastrukturens særegenheder generere en indlæsningsproces af N tabeller til dit lager. Eller for eksempel, hvis du arbejder med et API, der ikke understøtter parameteren som en liste, kan du generere N opgaver i DAG'en fra denne liste, begrænse parallellitet af API-anmodninger med en pool og trække de nødvendige data fra API'en. Fleksibelt!
Repositoryet
Airflow har sit eget backend-repositorium, en database (kan være MySQL eller Postgres, vi bruger Postgres), der gemmer tilstanden af opgaver, DAG'er, forbindelsesindstillinger, globale variabler osv. Her skal det nævnes, at repositoriet i Airflow er meget simpelt (omkring 20 tabeller) og bekvemt, hvis du vil opbygge en eller anden proces over det. Man mindes om de 100500 tabeller i Informatica-repositoriet, som man skulle bruge lang tid på at forstå, før man kunne bygge en forespørgsel.
Overvågning
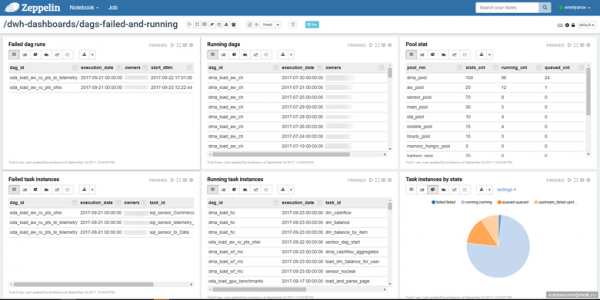
Givet repositoriets enkelhed kan du selv opbygge en proces til overvågning af opgaverne, som passer til dig. Vi bruger en notesbog i Zeppelin, hvor vi kan se opgavens tilstand:
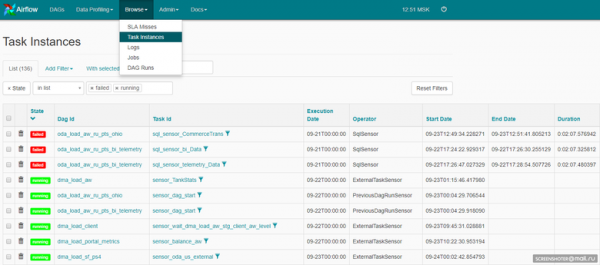
Det kan også være web-grænsefladen til selve Airflow:
Koden til Airflow er åben, derfor har vi tilføjet alarmering til Telegram. Hver instans af en opgave, hvis der opstår en fejl, spammer i en gruppe i Telegram, hvor hele udviklings- og supportteamet deltager.
Vi får hurtig respons via Telegram (hvis det kræves) og en overordnet oversigt over opgaverne i Airflow via Zeppelin.
I alt
Airflow er først og fremmest open source, og der er ikke behov for at forvente mirakler. Vær forberedt på at bruge tid og kræfter på at opbygge en fungerende løsning. Målet er inden for rækkevidde, tro mig, det er det værd. Hurtigheden af udviklingen, fleksibiliteten, letheden ved at tilføje nye processer - du vil kunne lide det. Selvfølgelig skal der bruges meget opmærksomhed på organiseringen af projektet og stabiliteten i Airflow's drift: mirakler findes ikke.
I øjeblikket udfører vores Airflow dagligt omkring 6.500 opgaver.. De er ret forskellige i deres art. Der er opgaver med at indlæse data i hoved DWH fra mange forskellige og meget specifikke kilder, der er opgaver med at beregne visninger inden for hoved DWH, der er opgaver med at publicere data i hurtigt DWH, og der er mange, mange forskellige opgaver - og Airflow håndterer dem alle dag for dag. For at sige det med tal, så er det 2,3 tusinde ELT-opgaver af forskellig kompleksitet inden for DWH (Hadoop), cirka 2,5 hundrede databaser kilder, det er et team af fire ETL-udviklere, der opdeler sig mellem ETL-behandling af data i DWH og ELT-behandling af data i DWH, og selvfølgelig også en admin, som håndterer serviceinfrastrukturen.
Fremtidige planer
Antallet af processer stiger uundgåeligt, og det primære, vi vil fokusere på i forhold til Airflow-infrastrukturen, er skalering. Vi ønsker at opbygge et Airflow-klynge, tildele et par ben til worker'ne i Celery og lave et dupliceret hoved med jobplanlægningsprocesser og et repository.
Epilog
Det er selvfølgelig langt fra alt, hvad jeg gerne ville fortælle om Airflow, men jeg har forsøgt at belyse de vigtigste punkter. Appetitten kommer under spisningen, prøv det - og du vil kunne lide det 🙂
Kilde: habr.com
