

Moderne informationssystemer er ret komplekse. Deres kompleksitet skyldes i høj grad mangfoldigheden af de data, der behandles i dem. Datakompleksiteten ligger ofte i den variation, der findes i de anvendte datamodeller. Når data bliver 'store', betragtes ikke kun mængden ('volume') som en udfordrende egenskab, men også variationen ('variety').
Hvis du ikke finder nogen mangler i ræsonneringen indtil videre, så læs videre.
Indhold
Polyglot persistence
Det, der er nævnt ovenfor, fører til, at der ofte i selv et enkelt system er behov for at anvende flere forskellige databaser til opbevaring af data og til løsning af forskellige opgaver relateret til databehandling, hvor hver enkelt understøtter sin egen datamodel. Med en let hånd fra M. Fowler, en række velkendte bøger og en af til Agile Manifesto, har denne situation fået navnet multivariat opbevaring (‘polyglot persistence’).
Fowler giver også et eksempel på organiseringen af datalagring i en fuldkommen og højt belastet applikation inden for e-handel.
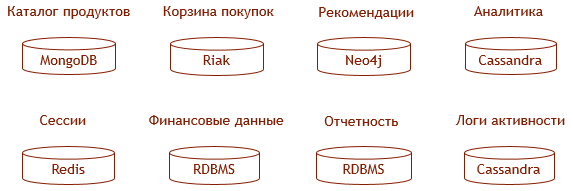
Dette eksempel er naturligvis lidt overdrevet, men der kan findes nogle overvejelser til fordel for valget af den eller den specifikke database til det tilsvarende formål, for eksempel, .
Det er klart, at det ikke er let at være udbyder i en sådan zoologisk have.
- Mængden af kode, der udfører dataopbevaring, vokser proportionalt med antallet af anvendte databaser; mængden af kode, der synkroniserer data, vokser – godt hvis ikke i kvadratet af dette antal.
- Omkostningerne ved at sikre enterprise-egenskaber (skalerbarhed, fejltolerance, høj tilgængelighed) stiger i takt med antallet af anvendte databaser.
- Det er umuligt at sikre enterprise-egenskaberne i lagersystemet som helhed – især transaktionalitet.
Set fra zooparkdirektørens perspektiv ser det således ud:
- En stigning i licens- og supportomkostninger fra producenten af DBMS.
- Oppustning af medarbejderstaben og forlængelse af deadlines.
- Direkte økonomiske tab eller bødestraffe som følge af datainkonsekvenser.
Der er en betydelig stigning i de samlede ejeromkostninger ved systemet (TCO). Er der nogen løsning på udfordringen ved "multimodel lagring"?
Multimodalitet
Terminologien "multimodel lagring" blev almindeligt anvendt i 2011. At erkende problemerne ved tilgangen og finde en løsning tog flere år, og inden 2015 blev svaret formuleret af analytikere fra Gartner:
- Fra "»:
Fremtiden for DBMS, deres arkitekturer og anvendelsesmetoder er multimodel.
- Fra "»:
Førende operationelle DBMS vil tilbyde flere modeller — relationelle og ikke-relationelle — inden for en enkelt platform.
Det ser ud til, at analytikere fra Gartner denne gang ikke tog fejl i deres prognoser. Hvis man besøger siden med af DBMS på DB-Engines, kan man se, at defleste afdem, der er i toppen, positionerer sig som multimodel DBMS. Det samme gælder for enhver specifik rangering.
I tabellen nedenfor præsenteres DBMS, der er ledere inden for hver specifik rangering og erklærer deres multimodelløsninger. For hver DBMS angives den oprindelige understøttede model (som engang var den eneste) samt de nuværende modeller. Derudover præsenteres DBMS, der positionerer sig som "oprindeligt multimodel" uden nogen påstande om en tidligere arvet model.
| DBMS | Oprindelig model | Yderligere modeller |
|---|---|---|
| Oracle | Relationel | Grafisk, dokumentær |
| MS SQL | Relationel | Grafisk, dokumentær |
| PostgreSQL | Relationel | Grafisk*, dokumentær |
| MarkLogic | Dokumentær | Grafisk, relationel |
| MongoDB | Dokumentær | Nøgle-værdi, grafisk* |
| DataStax | Bred kolonne | Dokumentær, grafisk |
| Redis | Nøgle-værdi | Dokumentær, grafisk* |
| ArangoDB | — | Grafisk, dokumentær |
| OrientDB | — | Grafisk, dokumentær, relationel |
| Azure CosmosDB | — | Grafisk, dokumentær, relationel |
Bemærkninger til tabellen
Udråbstegn i tabellen markerer udsagn, der skal uddybes:
- DBMS PostgreSQL understøtter ikke den grafiske datamodel, men et produkt , som for eksempel AgensGraph, understøtter det.
- I forhold til MongoDB er det mere korrekt at tale om eksistensen af grafiske operatorer i forespørgselsprotokollen (, ), med hensyn til understøttelsen af grafmodellen, selvom introduktionen af den naturligvis krævede nogle optimeringer på niveauet for fysisk opbevaring i retning af støtte til grafmodellen.
- I relation til Redis henvises der til udvidelsen .
Dernæst viser vi for hver af klasserne, hvordan understøttelsen af flere modeller implementeres i databaserne af denne klasse. Vi betragter relationelle, dokumentære og grafmodeller som de mest vigtige og vil på eksempler fra specifikke databaser vise, hvordan de "mangler" implementeres.
Multimodale databaser baseret på den relationelle model
De førende databaser i øjeblikket er relationelle; Gartner-spådommen ville ikke kunne betragtes som opfyldt, hvis RDBMS'er ikke viste bevægelser i retning af multimodularitet. Og de viser det. Nu kan overvejelserne om, at en multimodal database er som en schweizisk lommekniv, hvor man ikke kan gøre noget godt, sendes straks til Larry Ellison.
Forfatteren foretrækker dog implementeringen af multimodalitet i Microsoft SQL Server, hvor understøttelsen af RDBMS af dokumentære og grafmodeller vil blive beskrevet.
Dokumentmodellen i MS SQL Server
Om hvordan dokumentmodellen understøttes i MS SQL Server, har der allerede været to fremragende artikler på Habr, så jeg vil nøjes med et kort resumé og kommentar:
Måden at understøtte dokumentmodellen i MS SQL Server er ret typisk for relationelle databaser: JSON-dokumenter foreslås at blive gemt i almindelige tekstfelter. Understøttelsen af dokumentmodellen består i at tilvejebringe specielle operatorer til parsing af denne JSON:
- til udtrækning af skalarværdier fra attributterne,
- til udtrækning af underdokumenter.
Den anden argument for begge operatorer er et udtryk i JSONPath-lignende syntaks.
Abstrakt kan man sige, at de opbevarede dokumenter på denne måde ikke er "første klasses entiteter" i en relationel database, i modsætning til tupler. Specifikt i MS SQL Server er der i øjeblikket ingen indekser på felterne i JSON-dokumenterne, hvilket gør det vanskeligt at udføre join-operationer på værdierne af disse felter og endda at vælge dokumenter baseret på disse værdier. Dog kan man oprette en beregnet kolonne baseret på et sådant felt og en indeks på det.
Yderligere giver MS SQL Server mulighed for let at konstruere et JSON-dokument fra indholdet af tabellerne ved hjælp af operatoren — en mulighed, der i en vis forstand er kontrær til den forrige, almindelig opbevaring. Det er klart, at uanset hvor hurtig en RDBMS er, strider denne tilgang imod ideologien for dokumentbaserede DBMS, som grundlæggende opbevarer klare svar på populære forespørgsler og kun kan løse problemer med udviklingsvenlighed, men ikke performance.
Endelig gør MS SQL Server det muligt at løse opgaven omvendt af opbygningen af dokumentet: man kan opdele JSON i tabeller ved hjælp af . Hvis dokumentet ikke er helt fladt, kræves det at bruge CROSS APPLY.
Grafmodellen i MS SQL Server
Støtte til grafisk (LPG) model er også helt : der tilbydes specialtabeller til opbevaring af noder og til opbevaring af kanter i grafen. Sådanne tabeller oprettes ved hjælp af udtryk CREATE TABLE AS NODE og CREATE TABLE AS EDGE henholdsvis.
Tabeller af første type ligner almindelige tabeller til opbevaring af poster med den eneste ydre forskel, at tabellen indeholder et systemfelt $node_id — en unik identifier for grafens node inden for databasen.
Tilsvarende har tabeller af anden type systemfelter $from_id og $to_id, poster i sådanne tabeller angiver forståeligt forbindelser mellem noderne. Til opbevaring af forbindelser af hver type bruges separate tabeller.
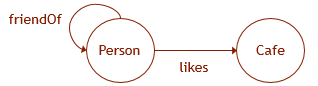 Lad os illustrere dette med et eksempel. Antag at de grafiske data har et skema som vist på den vedhæftede skitse. For at oprette den tilsvarende struktur i databasen skal følgende DDL-forespørgsler udføres:
CREATE TABLE Person (
  ID INTEGER NOT NULL,
  name VARCHAR(100)
) AS NODE;

CREATE TABLE Cafe (
  ID INTEGER NOT NULL,
  name VARCHAR(100),
) AS NODE;

CREATE TABLE likes (
  rating INTEGER
) AS EDGE;

CREATE TABLE friendOf
  AS EDGE;

ALTER TABLE likes
  ADD CONSTRAINT EC_LIKES CONNECTION (Person TO Cafe);
Den væsentligste specialitet ved sådanne tabeller er, at man i forespørgsler til dem kan bruge grafmønstre med Cypher-lignende syntaks (dog understøttes «*» og lignende endnu ikke). På baggrund af præstationsmålinger kan man også antage, at måden at opbevare data i disse tabeller adskiller sig fra mekanismen til opbevaring af data i almindelige tabeller og er optimeret til at udføre sådanne grafforespørgsler.
SELECT Cafe.name
  FROM Person, likes, Cafe
  WHERE MATCH (Person-(friendOf)-(likes)->Cafe)
  AND Person.name = 'John';
Desuden er det temmelig svært at arbejde med sådanne tabeller uden at bruge disse grafmønstre, da almindelige SQL-forespørgsler til løsning af lignende opgaver kræver yderligere indsats for at få systemets "graf"-identifikatorer for noderne ($node_id, $from_id, $to_id; af samme grund er forespørgsler til indsættelse af data ikke inkluderet her, da de ville være alt for tunge).
Når man opsummerer beskrivelsen af implementeringer af dokument- og grafmodeller i MS SQL Server, vil jeg sige, at sådanne implementeringer af én model oven på en anden primært ikke virker godt ud fra et sprogd design. Det kræver, at ét sprog udvides med et andet, og sprogene er ikke helt "ortogonale"; kompatibilitetsreglerne kan være noget særprægede.
Multimodale databaser baseret på dokumentmodellen
I dette afsnit ønsker jeg at illustrere implementeringen af multimodularitet i dokumentbaserede DBMS ved hjælp af et eksempel fra ikke den mest populære af dem, MongoDB (som nævnt er der kun betingede grafoperatorer i den, $lookup og $graphLookup, som ikke fungerer på sharded-samlinger), men ved hjælp af et mere modent og "enterprise"-DBMS. .
Lad os sige, at samlingen indeholder et sæt XML-dokumenter som følgende (MarkLogic tillader også opbevaring af JSON-dokuments):
John
  Smith
Relationel model i MarkLogic
Den relationelle repræsentation af dokumentkollektionen kan oprettes ved hjælp af (indholdet af elementerne value i eksemplet nedenfor kan være vilkårlig XPath):
/Person


      Person


          SSN
          @SSN
          string


          name
          name


          surname
          surname
Den oprettede visning kan adresseres med en SQL-forespørgsel (f.eks. via ODBC):
SELECT name, surname FROM Person WHERE name="John"Desværre er den relationelle repræsentation oprettet ved hjælp af visningsskabelonen kun tilgængelig til læsning. Når en forespørgsel behandles til den, vil MarkLogic forsøge at bruge Tidligere var der i MarkLogic også begrænsede relationelle visninger, som var helt og tilgængelige til skrivning, men nu betragtes de som deprecated.
Grafmodel i MarkLogic
Med understøttelse af den grafiske (RDF) model fungerer det på samme måde. Igen kan man med hjælp fra oprette et RDF-repræsentation af dokumentsamlingen fra det ovenstående eksempel:
/Person
PREFIX
"http://example.org/example#"
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || surname )
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || name )
Der kan rettes en SPARQL-forespørgsel til den resulterende RDF-graf:
PREFIX :
SELECT ?name ?surname {
  :631803299804 :name ?name ; :surname ?surname .
}
I modsætning til den relationelle model understøtter grafmodellen i MarkLogic også på to andre måder:
- DBMS kan være et fuldt separat lager til RDF-data (triplerne vil blive kaldt i modsætning til de ovenfor beskrevne ).
- RDF i en særlig serialisering kan simpelthen indsættes i XML- eller JSON-dokumenter (og triplerne vil så blive kaldt ). Det er sandsynligvis et alternativ til mekanismerne
idrefog andre.
Et godt indtryk af, hvordan "det virkelig er" i MarkLogic, gives af , i denne forstand er det lavniveau, selvom dets hensigt er noget anderledes — at forsøge at abstrahere fra den anvendte datamodel og sikre en ensartet håndtering af data på tværs af forskellige modeller, transaktionalitet osv.
Multimodale databaser 'uden hovedmodel'
På markedet findes også DBMS, som positionerer sig som oprindeligt multimodale, uden nogen arvet hovedmodel. Blandt dem er , (siden 2018 har udviklerfirmaet tilhørt SAP) og (en service i Microsoft Azures cloud-platform).
I virkeligheden er der "grundlæggende" modeller i ArangoDB og OrientDB. I begge tilfælde er det deres egne datamodeller, der er generaliseringer af dokumentmodellen. Generelt handler det om at lette muligheden for at udføre både grafiske og relationelle forespørgsler.
Disse modeller er de eneste tilgængelige i de nævnte DBMS'er, og deres egen forespørgselssprog er beregnet til at arbejde med dem. Uden tvivl er disse modeller og DBMS'er lovende, men mangel på kompatibilitet med standardmodeller og -sprog gør det umuligt at bruge disse DBMS'er i arvede systemer - erstatning af de DBMS'er, der allerede anvendes der.
Der har allerede været en fantastisk artikel om ArangoDB og OrientDB på Habr: .
ArangoDB
ArangoDB hævder at støtte grafdatastrukturen.
Noder i grafen i ArangoDB er almindelige dokumenter, mens kanter er dokumenter af en særlig art, som har de almindelige systemfelter (_key, _id, _rev) systemfelter _from og _to. Dokumenter i dokument-DBMS'er samles traditionelt i kollektioner. Kollektioner af dokumenter, der repræsenterer kanter, kaldes edge-kollektioner i ArangoDB. For øvrigt er dokumenter i edge-kollektioner også dokumenter, så kanter i ArangoDB kan også fungere som noder.
Kildedata
Lad os antage, at vi har en kollektion persons, hvis dokumenter ser således ud:
[
  {
    "_id"  : "people/alice" ,
    "_key" : "alice" ,
    "name" : "Alice"
  },
  {
    "_id"  : "people/bob" ,
    "_key" : "bob" ,
    "name" : "Bob"
  }
]
Lad os også have en kollektion cafes:
[
  {
    "_id" : "cafes/jd" ,
    "_key" : "jd" ,
    "name" : "John Donne"
  },
  {
    "_id" : "cafes/jj" ,
    "_key" : "jj" ,
    "name" : "Jean-Jacques"
  }
]
Så kan kollektionen likes se således ud:
[
  {
    "_id" : "likes/1" ,
    "_key" : "1" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jd",
    "since" : 2010
  },
  {
    "_id" : "likes/2" ,
    "_key" : "2" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jj",
    "since" : 2011
  } ,
  {
    "_id" : "likes/3" ,
    "_key" : "3" ,
    "_from" : "persons/bob" ,
    "_to" : "cafes/jd",
    "since" : 2012
  }
]
Forespørgsler og resultater
En grafstil forespørgsel i det AQL-sprog, der anvendes i ArangoDB, som returnerer oplysninger om, hvem der kan lide hvilket café i et menneskeligt læseligt format, ser sådan ud:
FOR p IN persons
  FOR c IN OUTBOUND p likes
  RETURN { person : p.name , likes : c.name }
I relationel stil, når vi i højere grad "beregner" forbindelser i stedet for at gemme dem, kan denne forespørgsel skrives om sådan (forresten, uden kollektion likes kunne man klare sig uden):
FOR p IN persons
  FOR l IN likes
  FILTER p._key == l._from
    FOR c IN cafes
    FILTER l._to == c._key
    RETURN { person : p.name , likes : c.name }
Resultatet vil i begge tilfælde være det samme:
[
  { "person" : "Alice" , likes : "Jean-Jacques" } ,
  { "person" : "Alice" , likes : "John Donne" } ,
  { "person" : "Bob" , likes : "John Donne" }
]
Flere forespørgsler og resultater
Hvis det ser ud til, at formatet af resultatet ovenfor er mere karakteristisk for en relationel DBMS end for en dokumentdatabase, kan man prøve denne forespørgsel (eller man kan bruge ):
FOR p IN persons
  RETURN {
    person : p.name,
    likes : (
      FOR c IN OUTBOUND p likes
      RETURN c.name
    )
}
Resultatet vil have følgende form:
[
  { "person" : "Alice" , likes : ["Jean-Jacques" , "John Donne"]  } ,
  { "person" : "Bob" , likes : ["John Donne"] }
]
OrientDB
Basis for implementeringen af den grafbaserede model over dokumentmodellen i OrientDB er dokumentfelter, der har, udover mere eller mindre standard scalarværdier, også værdier af typer såsom LINK, LINKLIST, LINKSET, LINKMAP og LINKBAG. Værdierne af disse typer er henvisninger eller samlinger af henvisninger til dokumenter.
Den systemtilknyttede identifikator for et dokument har "fysisk mening", idet den angiver positionen af posten i databasen, og ser omtrent sådan ud: @rid : #3:16. Derved er værdierne af referencens egenskaber faktisk mere som pegepinde (som i den grafiske model) snarere end som udvælgelsesbetingelser (som i den relationelle).
Ligesom i ArangoDB repræsenteres kanter i OrientDB som separate dokumenter (selvom hvis en kant ikke har sine egne egenskaber, kan den gøres , og der vil ikke være et separate dokument for den).
Kildedata
I et format, der ligner for OrientDB, ville data fra det tidligere eksempel for ArangoDB se nogenlunde sådan ud:
[
     {
      "@type": "document",
      "@rid": "#11:0",
      "@class": "Person",
      "name": "Alice",
      "out_likes": [
        "#30:1",
        "#30:2"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#12:0",
      "@class": "Person",
      "name": "Bob",
      "out_likes": [
        "#30:3"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#21:0",
      "@class": "Cafe",
      "name": "Jean-Jacques",
      "in_likes": [
        "#30:2",
        "#30:3"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#22:0",
      "@class": "Cafe",
      "name": "John Donne",
      "in_likes": [
        "#30:1"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#30:1",
      "@class": "likes",
      "in": "#22:0",
      "out": "#11:0",
      "since": 1262286000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:2",
      "@class": "likes",
      "in": "#21:0",
      "out": "#11:0",
      "since": 1293822000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:3",
      "@class": "likes",
      "in": "#21:0",
      "out": "#12:0",
      "since": 1325354400000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    }
  ]
Som vi kan se, gemmer noderne også oplysninger om indgående og udgående kanter. Ved Dokument API til referencetilslutning skal overvåges manuelt, mens Graph API tager denne opgave på sig. Lad os se, hvordan interaktionen med OrientDB ser ud i "rene", ikke integrerede forespørgsler.
Forespørgsler og resultater
En forespørgsel, der svarer til forespørgslen fra eksemplet til ArangoDB, ser sådan ud i OrientDB:
SELECT name AS person_name, OUT('likes').name AS cafe_name
   FROM Person
   UNWIND cafe_name
Resultatet vil blive præsenteret som følger:
[
  { "person_name": "Alice", "cafe_name": "John Donne" },
  { "person_name": "Alice", "cafe_name": "Jean-Jacques" },
  { "person_name": "Bob",  "cafe_name": "Jean-Jacques" }
]
Hvis formatet for resultatet igen virker for "relationelt", skal du fjerne linjen med :
[
  { "person_name": "Alice", "cafe_name": [ "John Donne", "Jean-Jacques" ] },
  { "person_name": "Bob",  "cafe_name": [ "Jean-Jacques" ] }
]
Forespørgselssproget i OrientDB kan karakteriseres som SQL med Gremlin-lignende indsættelser. I version 2.2 blev der introduceret en Cypher-lignende forespørgselsform, :
MATCH {CLASS: Person, AS: person}-likes->{CLASS: Cafe, AS: cafe}
RETURN person.name AS person_name, LIST(cafe.name) AS cafe_name
GROUP BY person_name
Resultatformatet vil være det samme som i den tidligere forespørgsel. Tænk over, hvad der skal fjernes for at gøre det mere "relationelt", som i den allerførste forespørgsel.
Azure CosmosDB
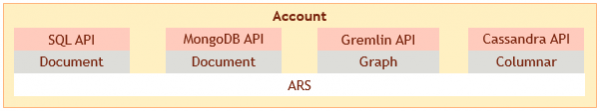
I mindre grad gælder det ovenstående vedrørende ArangoDB og OrientDB for Azure CosmosDB. CosmosDB tilbyder følgende API'er til datatilgang: SQL, MongoDB, Gremlin og Cassandra.
SQL API og MongoDB API anvendes til at tilgå data i dokumentmodellen. Gremlin API og Cassandra API anvendes til at tilgå data i henholdsvis graf- og kolonneformater. Data i alle modeller gemmes i formatet for CosmosDBs interne model: ("atom-record-sequence"), som også er tæt på dokumentformatet.
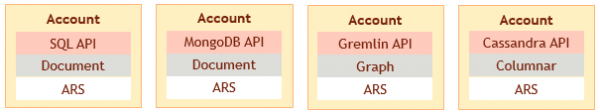
Men den valgte datamodel og den anvendte API fastlægges på tidspunktet for oprettelsen af kontoen i tjenesten. Det er ikke muligt at tilgå data indlæst i én model i formatet af en anden model, hvilket kunne illustreres med sådan et billede:
Dermed repræsenterer multimodalitet i Azure CosmosDB i dag blot muligheden for at bruge flere databaser, der understøtter forskellige modeller, fra én leverandør, hvilket ikke løser alle problemer med variantopbevaring.
Multimodale databaser baseret på grafmodellen?
Det er bemærkelsesværdigt, at der endnu ikke findes multimodale DBMS'er, der har en grafmodel som grundlag (med mindre man betragter støtte til samtidig to grafmodeller: RDF og LPG som multimodalitet; se nærmere herom i ). De største udfordringer opstår ved implementeringen over en grafmodel for dokumenter, og ikke en relationel.
Spørgsmålet om, hvordan man implementerer en relationel model oven på en grafmodel, blev drøftet allerede i de tidlige dage af sidstnævnte. Som , for eksempel, :
Der er ikke noget iboende i graftilgangen, der forhindrer oprettelsen af et lag (f.eks. ved passende indeksering) på en grafdatabase, der muliggør en relationel visning med (1) genfinding af tupler fra de sædvanlige nøgle-værdi-par og (2) gruppering af tupler efter relationstype.
Når man implementerer en dokumentmodel på en grafmodel, skal man have følgende in mente:
- JSON-arrayelementer betragtes som ordnede, men udgående fra toppen af grafens kant — gør ikke.
- Data i dokumentmodellen er normalt denormaliserede; man ønsker ikke at gemme flere kopier af det samme indlejrede dokument, og underdokumenter har normalt ikke identifikatorer.
- På den anden side er ideologien bag dokumentdatabaser netop, at dokumenter er færdige 'aggregater', som ikke skal konstrueres fra bunden hver gang. Det kræver, at grafmodellen muliggør hurtig adgang til en undergraf, der svarer til det færdige dokument.
Lidt reklame
Artiklens forfatter er involveret i udviklingen af databasesystemet NitrosBase, hvis interne model er grafisk, mens de eksterne modeller — relationelle og dokumentære — er dens repræsentationer. Alle modeller er ligestillede: praktisk talt alle data er tilgængelige i hver af dem ved hjælp af det naturlige forespørgselsprog. Desuden kan dataene ændres i enhver repræsentation. Ændringerne vil blive reflekteret i den interne model og dermed i de andre repræsentationer.
Hvordan modellerne ser ud i NitrosBase — vil jeg forsøge at beskrive i en af de kommende artikler.
Konklusion
Jeg håber, at de generelle rammer for det, der kaldes multimodel, er blevet mere eller mindre klart for læseren. Multimodellerede databaser er ret forskellige, og 'support for flere modeller' kan se forskellig ud. For at forstå, hvad der menes med 'multimodel' i hvert konkret tilfælde, er det nyttigt at besvare følgende spørgsmål:
- Handler det om støtte til traditionelle modeller, eller handler det om en eller anden form for 'hybrid' model?
- Er modellerne 'ligestillede', eller er en af dem underlagt de andre?
- Er modellerne «ligeglad» med hinanden? Kan data, der er indtastet i en model, blive læst i en anden eller endda overskrevet?
Jeg tror, at spørgsmålet om relevansen af multimodel-databaser allerede kan besvares positivt, men det interessante spørgsmål er, hvilke specifikke varianter der vil være mere eftertragtede i den nærmeste fremtid. Det ser ud til, at multimodel-databaser, der understøtter traditionelle modeller, især relationelle, vil være mere efterspurgte; populariteten af multimodel-databaser, der tilbyder nye modeller, som kombinerer fordele fra forskellige traditionelle, er dog et emne for en mere fjern fremtid.
Kun registrerede brugere kan deltage i undersøgelsen. , please.
Bruger du multimodel-databaser?
Vi bruger ikke, vi opbevarer alt i én database og én model.
Vi bruger multimodel-muligheder fra traditionelle databaser.
Vi praktiserer polyglot persistence.
Vi bruger nye multimodel-databaser (Arango, Orient, CosmosDB).
19 brugere stemte. 4 brugere afholdt sig.
Kilde: habr.com
