

Ideen til artiklen opstod spontant fra en diskussion i kommentarerne til artiklen .
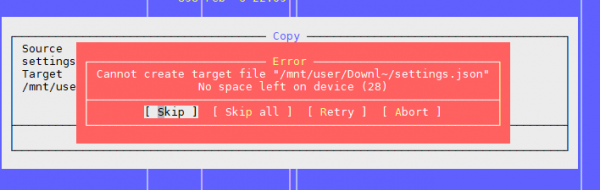
Det er sådan, at den interne specifikation af vores services er opbevaringen af enorme mængder små filer. Lige nu har vi omkring flere hundrede terabyte af sådanne data. Og vi er stødt på nogle åbenlyse og ikke så åbenlyse problemer og har heldigvis klaret os forbi dem.
Derfor deler jeg vores erfaring, måske kan den være til hjælp for nogen.
Problem nummer et: „Ingen plads tilbage på enheden“
Som nævnt i den ovenfor nævnte artikel, er problemet, at der er ledige blokke på filsystemet, men at inodes er udtømt.
Antallet af brugte og ledige inodes kan tjekkes med kommandoen df -ih:
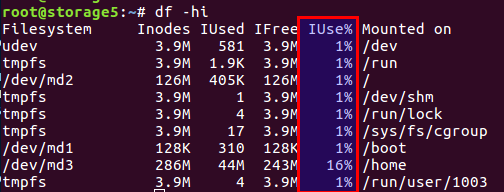
Jeg vil ikke gentage artiklen, men kort sagt er der på disken både blokke direkte til data og blokke til metadata, som er inodes (indeksnoder). Deres antal bestemmes ved initialisering af filsystemet (både ext2 og dens efterkommere), og derefter ændres det ikke. Balancen mellem datablokke og inodes beregnes udfra gennemsnitsdata, men i vores tilfælde, hvor der er mange små filer, bør balancen skubbes i retning af antallet af inodes - der skal være flere af dem.
I Linux er der allerede forudsete muligheder med forskellig balance, og alle disse forudberegnede konfigurationer findes i filen /etc/mke2fs.conf.
Derfor kan man angive den ønskede profil ved den primære initialisering af filsystemet via mke2fs.
Her er nogle eksempler fra filen:
    small = {
        blocksize = 1024
        inode_size = 128
        inode_ratio = 4096
    }

    big = {
        inode_ratio = 32768
    }

    largefile = {
        inode_ratio = 1048576
        blocksize = -1
    }
Man kan vælge den ønskede anvendelse ved hjælp af optionen „-T“ ved kald af mke2fs. Man kan også manuelt angive de ønskede parametre, hvis der ikke er en klar løsning.
Flere detaljer er beskrevet i manualerne for mke2fs.conf og mke2fs.
En funktion, der ikke er berørt i den ovennævnte artikel, er muligheden for at angive størrelsen på datablokken. Det er åbenlyst, at for store filer giver det mening med en større blokstørrelse, for små filer med en mindre.
Men man skal tage højde for en interessant egenskab, som er processorarkitekturen.
Engang tænkte jeg, at jeg havde brug for en større blokstørrelse til store fotofiler. Det var i hjemmemiljøet på en WD-filopbevaring baseret på ARM-arkitektur. Uden at tænke nærmere over det satte jeg blokstørrelsen til enten 8k eller 16k i stedet for den standard 4k, efter at jeg havde målt besparelsen. Og alt var vidunderligt, indtil lageret pludselig svigtede, selvom disken stadig virkede. Da jeg satte disken i en almindelig computer med en almindelig Intel-processor, fik jeg en overraskelse: understøttet blokstørrelse. Datan er der, alt ser godt ud, men det er umuligt at læse det. i386-processorer og lignende kan ikke arbejde med blokstørrelser, der ikke svarer til størrelsen på hukommelsessiden, som netop er 4k. Alt i alt endte det med at bruge værktøjer fra brugerrummet; alt var langsomt og trist, men vi reddede data. For dem, der er interesserede — goggle efter navnet på værktøjet. fuseext2. Moralen er: enten tænke på alle scenarier på forhånd, eller ikke opføre sig som en superhelt og bruge standardindstillingerne til hjemmebrugere.
UPD. Ifølge brugerens bemærkning præciserer jeg, at for i386 må blokstørrelsen ikke overstige 4k, men behøver ikke nødvendigvis at være præcis 4k, det vil sige 1k og 2k er tilladt.
Sådan løste vi problemerne.
For det første stødte vi på problemet, da den mange terabyte store disk var fyldt med data, og vi kunne ikke ændre konfigurationen af filsystemet.
For det andet var der brug for en hurtig løsning.
Vi kom derfor frem til, at vi skulle ændre balancen ved at mindske antallet af filer.
For at reducere antallet af filer blev det besluttet at samle filerne i et fælles arkiv. I betragtning af vores specifik, samlede vi alle filer i et arkiv for en bestemt tidsperiode, og vi udførte arkiveringen med en cron-opgave hver nat.
Valgt zip-arkiv. I kommentarerne til den tidligere artikel blev tar foreslået, men der er en udfordring: det har ikke et indholdsfortegnelse, og filerne opbevares i en fortløbende strøm (og det er ikke for ingenting, at "tar" er en forkortelse for "Tape Archive", et levn fra båndopbevaring), dvs. hvis man skal læse en fil i slutningen af arkivet, skal man læse hele arkivet, da der ikke er offsets for hver fil i forhold til arkivets begyndelse. Derfor er det en lang operation. I zip er alt meget bedre: det har det ønskede indholdsfortegnelse og offsets for filerne inden i arkivet, og adgangstiden til hver fil er uafhængig af dens placering. I vores tilfælde kunne vi desuden angive kompressionsmuligheden til "0", da alle filer allerede var komprimeret i gzip.
Kunderne henter filer via nginx, og i henhold til det gamle API angives blot filnavnet, f.eks. således:
http://www.server.com/hydra/20170416/0453/3bd24ae7-1df4-4d76-9d28-5b7fcb7fd8e5
For at dekomprimere filer on-the-fly fandt vi og tilsluttede nginx-unzip-module () og indstillede to upstreams.
Resultatet blev en konfiguration som denne:
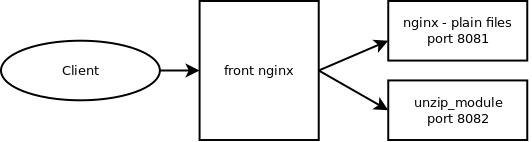
De to værter i indstillingerne så således ud:
server {
  listen *:8081;

  location / {
    root      /home/filestorage;
  }
}
server {
listen *:8082;
location ~ ^/hydra/(d+)/(d+)/(.*)$ {
root /home/filestorage;
file_in_unzip_archivefile "/home/filestorage/hydra/$1/$2.zip";
file_in_unzip_extract "$2/$3";
file_in_unzip;
}
}
Og konfigurationen af upstreams på den overordnede nginx:
upstream storage {
  server server.com:8081;
  server server.com:8082;
}
Sådan fungerer det:
- Klienten går til front nginx
- Front nginx forsøger at sende filen fra den første upstream, dvs. direkte fra filsystemet
- Hvis filen ikke er tilgængelig — forsøger den at sende fra den anden upstream, som leder efter filen inden i arkivet
Det andet problem: igen "No space left on device"
Dette er det andet problem, vi stødte på, når der er mange filer i kataloget.
Vi forsøger at oprette en fil, men systemet klager over, at der ikke er plads. Vi ændrer filnavnet og prøver at oprette det igen.
Det virker.
Ser omtrent sådan her ud:

Kontrol af inodes gav ingen resultater — der er mange ledige.
Pladskontrol — det samme.
Vi tænkte, at der måske var for mange filer i kataloget, og at der er en begrænsning, men igen ikke: Maximum number of files per directory: ~1.3 × 10^20
Og filen kan oprettes, hvis man ændrer navnet.
Konklusion — problemet ligger i filnavnet.
Yderligere undersøgelser viste, at problemet lå i hash-algoritmen, når der bygges en indeksering af kataloget, da der er et stort antal filer, der observeres sammenfald med alle de konsekvenser, der følger. Man kan læse mere her:
Du kan deaktivere denne mulighed, men... søgningen efter en fil efter navn kan blive uforudsigeligt lang, når alle filer gennemgås.
tune2fs -O "^dir_index" /dev/sdb3
Generelt kan det virke som en midlertidig løsning.
Moralen: mange filer i en mappe er som regel en dårlig idé. Det bør man undgå.
I sådanne tilfælde opretter man som regel underkataloger baseret på de første bogstaver i filnavnet eller efter andre parametre, for eksempel efter datoer; i de fleste tilfælde hjælper det.
Men det samlede antal små filer er stadig et problem, selvom de er opdelt i mapper — så se på det første problem.
Problem tre: hvordan ser man en liste over filer, hvis der er mange?
I vores situation, når vi har mange filer, støder vi på problemet med at se indholdet af en mappe.
Den standardløsning er kommandoen ls.
Okay, lad os se, hvad der sker med 4772098 filer:
$ time ls /home/app/express.repository/offercache/ >/dev/null

real	0m30.203s
user	0m28.327s
sys	0m1.876s
30 sekunder... det vil være for meget. Og det meste af tiden går med at behandle filer i brugerområdet, ikke på selve kernen.
Men der er en løsning:
$ time find /home/app/express.repository/offercache/ >/dev/null

real	0m3.714s
user	0m1.998s
sys	0m1.717s
3 sekunder. 10 gange hurtigere.
Hurra!
UPD.
Endnu en hurtigere løsning fra en bruger — deaktivering af sorteringen hos ls
time ls -U /home/app/express.repository/offercache/ >/dev/null
real	0m2.985s
user	0m1.377s
sys	0m1.608s
Problem fire: høj LA ved håndtering af filer
Der opstår jævnligt situationer, hvor man skal kopiere en masse filer fra én maskine til en anden. Ofte stiger LA markant, da det hele afhænger af diskens ydeevne.
Det mest fornuftige ville være at bruge SSD. Virkelig fantastisk. Spørgsmålet er dog prisen på manges terabytes SSD.
Men hvis diskene er almindelige, skal filer kopieres, og det er desuden en produktionssystem, hvor overbelastning fører til utilfredshed fra kunderne? Der er mindst to nyttige værktøjer: nice og ionice.
nice — reducerer processens prioritet, hvilket gør, at scheduler giver flere tidskvoter til andre, mere prioriterede processer.
I vores erfaring har det hjulpet at sætte nice til maksimum (19 — det mindste prioritet, -20 (minus 20) — maksimum).
ionice — justerer tilsvarende input/output prioriteten (I/O scheduling)
Hvis du bruger RAID, og det pludselig har brug for at synkronisere (efter en mislykket genstart eller hvis RAID-arrayet skal gendannes efter udskiftning af en disk), giver det i visse situationer mening at sænke synkroniseringshastigheden, så andre processer kan fungere nogenlunde ordentligt. Dette kan opnås med følgende kommando:
echo 1000 > /proc/sys/dev/raid/speed_limit_max
Problem nummer fem: Hvordan synkroniserer man filer i realtid
Vi har de samme store mængder filer, der skal sikkerhedskopieres til en anden server for at undgå… Filer skrives konstant, så for at minimere tab skal de kopieres så hurtigt som muligt.
Standardløsning: Rsync over SSH.
Det er en god mulighed, medmindre det kun skal gøres hvert par sekunder. Og der er mange filer. Selv hvis de ikke skal kopieres — skal man stadig på en eller anden måde forstå, hvad der er ændret, og at sammenligne flere millioner filer tager tid og belaster disken.
Det vil sige, at vi skal vide med det samme, hvad der skal kopieres, uden at sammenligningen skal køres hver gang.
Redningen er — lsyncd. Lsyncd — . Den fungerer også via rsync, men den overvåger desuden filsystemet for ændringer ved hjælp af inotify og fsevents og starter kun kopieringen af de filer, der er blevet tilføjet eller ændret.
Problem nummer seks: hvordan man forstår, hvem der belaster disken
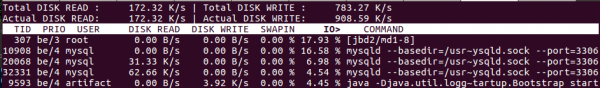
Det ved sikkert alle, men alligevel for fuldstændighedens skyld: til overvågning af diskundersystemet findes kommandoen iotop — ligesom top, men viser de processer, der aktivt bruger disken mest.
Desuden gør den gamle gode top det også muligt at forstå, om der er problemer med disken eller ej. Der er to parametre, der er mest relevante: Load Average og IOwait.
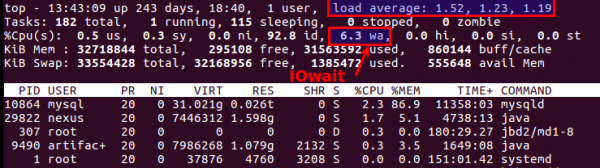
Den første viser, hvor mange processer der venter på betjening; normalt, hvis der er mere end 2, er der allerede noget, der ikke fungerer korrekt. Ved aktiv kopiering til backup-servere tillader vi op til 6-8, hvorefter situationen betragtes som unormal.
Den anden viser, hvor meget CPU'en er brugt på diskoperationer. IOwait >10% — er en grund til bekymring, selvom vi på servere med specifik belastningsprofil stabilt kan have 40-50%, og det er reelt en norm.
Jeg vil afslutte her, selvom der helt sikkert er mange aspekter, som vi ikke har været udsat for, og jeg ser frem til kommentarer og beskrivelser af interessante virkelige sager.
Kilde: habr.com
