

Lad os forestille os. I et rum er 5 katte låst inde, og for at vække ejeren skal de blive enige om det, for døren kan kun åbnes, hvis de alle fem skubber imod den. Hvis en af kattene er Schrödingers kat, og de andre katte ikke ved, hvad han har besluttet, opstår spørgsmålet: "Hvordan kan de gøre det?"
I denne artikel vil jeg med en enkel beskrivelse forklare den teoretiske del af verdenen af distribuerede systemer og principperne for deres drift. Jeg vil også kort nævne den centrale idé, der ligger til grund for Paxos.
Når udviklere bruger cloud-infrastrukturer, forskellige databaser, og arbejder i klynger med mange noder, er de sikre på, at dataene vil være intakte, sikre og altid tilgængelige. Men hvor kommer garantierne fra?
I bund og grund er de garantier, vi har, garantier fra leverandøren. De beskrives i dokumentationen omtrent således: "Denne tjeneste er ret pålidelig, den har en fastsat SLA, bekymre dig ikke, alt vil fungere distribueret, som du forventer."
Vi har en tendens til at tro på det bedste, for kloge fyre fra store virksomheder har forsikret os om, at alt vil være i orden. Vi stiller ikke spørgsmålet: hvorfor, hvorfor overhovedet, kan dette fungere? Er der nogen formel begrundelse for korrektheden af disse systemers funktion?
For nylig var jeg til og jeg blev meget inspireret af emnet. Forelæsningerne i skolen mindede mere om timer i matematisk analyse end noget, der var relateret til computersystemer. Men det var netop sådan, vigtige algoritmer, som vi bruger hver dag, blev bevist, uden at vi selv er klar over det.
I de fleste moderne distribuerede systemer anvendes konsensusalgoritmen Paxos og dens forskellige modifikationer. Det mest fantastiske er, at holdbarheden og muligheden for, at denne algoritme eksisterer, kan bevises med blot en pen og papir. Samtidig anvendes algoritmen i praksis i store systemer, der kører på et stort antal noder i skyen.
En let illustration af, hvad der vil blive diskuteret næste gang: to generalers problemLad os for sjov tage fat på .
Vi har to hære - den røde og den hvide. De hvide styrker er baseret i den belejrede by. De røde styrker under ledelse af generalerne A1 og A2 er placeret på to sider af byen. Opgaven for de røde er at angribe den hvide by og vinde. Men styrken af hver rød general er mindre end styrken af de hvide.
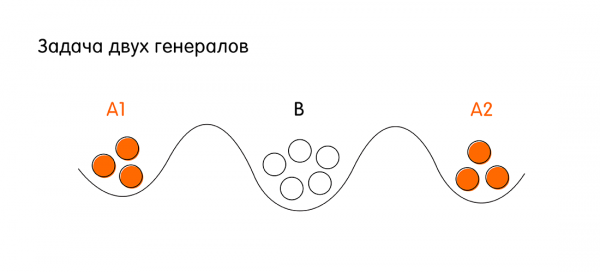
Vilkårene for sejr for de røde: begge generaler skal angribe samtidig for at have et numerisk overtag over de hvide. For dette skal generalerne A1 og A2 blive enige med hinanden. Hvis hver af dem angriber enkeltvis, vil de røde tabe.
For at blive enige kan generalerne A1 og A2 sende budbringere til hinanden over det hvide byområde. Budbringeren kan nå frem til den allierede general eller kan blive opfanget af fjenden. Spørgsmålet er: findes der en sekvens af kommunikation mellem de røde generaler (sekvensen af budbringere fra A1 til A2 og omvendt fra A2 til A1), hvor de garanteret kan blive enige om angrebet på tidspunktet X. Her forstås garantien som, at begge generaler vil have entydig bekræftelse på, at deres allierede (den anden general) helt sikkert vil angribe på det angivne tidspunkt X.
Antag, at A1 sender en budbringer til A2 med beskeden: 'Lad os angribe i aften ved midnat!'. General A1 kan ikke angribe uden bekræftelse fra general A2. Hvis budbringeren fra A1 er nået frem, så sender general A2 en bekræftelse med beskeden: 'Ja, lad os gå efter de hvide i aften'. Men nu ved general A2 ikke, om hans budbringer er nået frem eller ej; han har ingen garantier for, at angrebet bliver simultant. Nu skal general A2 igen have bekræftelse.
Hvis vi fortsætter deres kommunikation, vil det blive klart, at uanset hvor mange cykler af meddelelser der udveksles, er der ingen måde at garantere, at begge generaler bliver underrettet om, at deres meddelelser er modtaget (givet at enhver budbringer kan blive opfanget).
Opgaven med de to generaler er en glimrende illustration af et meget simpelt distribueret system, hvor der er to noder med usikker kommunikation. Det betyder, at vi ikke har 100 % garanti for, at de synkroniseres. Jeg vil senere i artiklen tale om sådanne problemer, men i en større skala.
Vi indfører begrebet distribuerede systemer.
Et distribueret system er en gruppe af computere (her kaldet noder), der kan udveksle beskeder. Hver enkelt node er en selvstændig enhed. En node kan selvstændigt behandle opgaver, men for at interagere med andre noder skal den sende og modtage beskeder.
Hvordan beskederne konkret er implementeret, hvilke protokoller der anvendes, er ikke vores fokus i denne sammenhæng. Det vigtige er, at noderne i det distribuerede system kan udveksle data med hinanden ved at sende beskeder.
Selve definitionen virker ikke særlig kompleks, men det er vigtigt at tage højde for, at et distribueret system har en række attributter, som vil være vigtige for os.
Attributter for distribuerede systemer
- Samtidighed – muligheden for, at der opstår samtidige eller konkurrerende hændelser i systemet. Desuden vil vi betragte hændelser, der finder sted på to forskellige noder, som potentielt konkurrenceprægede, indtil vi har en klar rækkefølge af disse hændelser. Og normalt har vi ikke den rækkefølge.
- Manglen på globale ur. Vi har ikke en klar rækkefølge af hændelser på grund af fraværet af et globalt ur. I den normale verden er vi vant til, at vi har ure og tid er absolut. Alt ændrer sig, når det kommer til distribuerede systemer. Selv de mest præcise atomur har drift, og der kan opstå situationer, hvor vi ikke kan sige, hvilken af de to hændelser der skete først. Derfor kan vi heller ikke stole på tiden.
- Uafhængig fejl i noderne i systemet. Der er et andet problem: noget kan gå galt ganske enkelt fordi vores noder ikke er evige. En harddisk kan svigte, en virtuel maskine i skyen kan genstarte, netværket kan blinke, og meddelelser kan gå tabt. Desuden er der situationer, hvor noderne fungerer, men samtidig arbejder imod systemet. Den sidste klasse af problemer har endda fået et særligt navn: problemet . Det mest populære eksempel på et distribueret system med et sådant problem er Blockchain. Men i dag vil vi ikke se på denne særlige klasse af problemer. Vi vil være interesserede i situationer, hvor blot en eller flere noder kan fejle.
- Kommunikationsmodeller (beskedsystemer) mellem noderne. Vi har allerede fundet ud af, at noder kommunikerer ved at udveksle beskeder. Der er to kendte modeller for beskedudveksling: synkron og asynkron.
Kommunikationsmodeller mellem noder i distribuerede systemer
Synkron model – vi ved præcist, at der er en kendt tidsforsinkelse, hvor en besked garanteret når fra én node til en anden. Hvis denne tid er udløbet, og beskeden ikke er ankommet, kan vi med sikkerhed sige, at noden er nede. I en sådan model har vi en forudsigelig ventetid.
Asynkron model – i asynkrone modeller antager vi, at ventetiden er endelig, men der findes ikke en tidsforsinkelse, efter hvilken vi kan garantere, at noden er nede. Dvs. ventetiden for en besked fra noden kan være ubegribelig lang. Dette er en vigtig definition, og vi vil tale mere om det senere.
Begrebet konsensus i distribuerede systemer
Før vi formelt definerer begrebet konsensus, lad os overveje et eksempel på en situation, hvor det er nødvendigt, nemlig – State Machine Replication.
Vi har en vis distribueret log. Vi ønsker, at den skal være konsistent og indeholde identiske data på alle noder i det distribuerede system. Når en af noderne får kendskab til en ny værdi, som den vil skrive til loggen, bliver dens opgave at foreslå denne værdi til alle andre noder, så loggen opdateres på alle noder, og systemet kommer ind i en ny konsistent tilstand. Det er vigtigt, at noderne bliver enige: alle noder er enige om, at den foreslåede nye værdi er korrekt, alle noder har accepteret denne værdi, og kun i så fald kan alle skrive den nye værdi til loggen.
Med andre ord: ingen af noderne har indsigelser mod, at de har mere aktuel information, og at den foreslåede værdi er forkert. Enigheden mellem noderne og enigheden om den samme korrekte accepterede værdi er konsensus i et distribueret system. Senere vil vi tale om algoritmer, der tillader det distribuerede system at opnå konsensus med garanti.
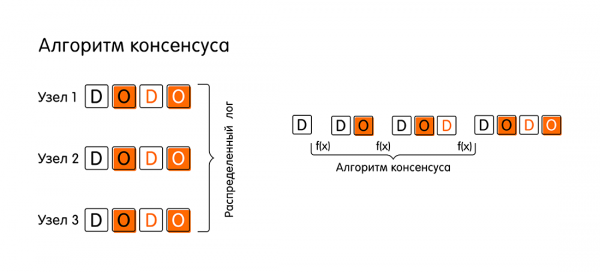
Mere formelt kan vi definere en konsensusalgoritme (eller blot konsensusalgoritmen) som en funktion, der fører et distribueret system fra tilstand A til tilstand B. Dette tilstand skal være accepteret af alle noder, og alle noder skal kunne bekræfte det. Det viser sig, at denne opgave slet ikke er så triviel, som det ser ud ved første øjekast.
Egenskaber ved konsensusalgoritmen
Konsensusalgoritmen skal have tre egenskaber for at systemet kan fortsætte med at eksistere og have fremdrift i overgangen fra tilstand til tilstand:
- Enighed – alle korrekt fungerende noder skal acceptere den samme værdi (i artiklerne kaldes denne egenskab også sikkerhedsegenskab). Alle noder, der i øjeblikket fungerer (ikke er brudt ned og ikke har mistet forbindelsen til de andre), skal nå til enighed og acceptere en fælles endelig værdi.
Her er det vigtigt at forstå, at noderne i det distribuerede system, vi taler om, ønsker at blive enige. Det vil sige, at vi nu taler om systemer, hvor noget måske kan gå galt (f.eks. kan en node fejle), men i dette system er der bestemt ikke noder, der arbejder imod de andre (problemet med de byzantinske generaler). På grund af denne egenskab forbliver systemet konsistent.
- Integritet – hvis alle korrekt fungerende noder tilbyder den samme værdi v, skal hver korrekt fungerende node acceptere denne værdi v.
- Afslutning – alle korrekt fungerende noder vil til sidst acceptere en værdi (levende egenskab), hvilket giver algoritmen mulighed for at have fremdrift i systemet. Hver enkelt korrekt fungerende node skal en dag have accepteret den endelige værdi og bekræftet det: "For mig er denne værdi sand, jeg er enig med hele systemet".
Eksempel på konsensusalgoritmens funktion
Selv om egenskaberne ved algoritmen måske ikke er helt klare, vil vi derfor illustrere, hvilke faser den enkleste konsensusalgoritme gennemgår i et system med en synkron kommunikationsmodel, hvor alle noder fungerer som de skal, beskeder ikke går tabt, og intet går i stykker (kan det virkelig ske?).
- Det hele begynder med et forslag om hånden og hjertet (Propose). Lad os antage, at en klient har tilsluttet sig noden kaldet "Nod 1" og påbegyndt en transaktion ved at overføre en ny værdi – O. Fra dette øjeblik vil vi kalde "Nod 1" proposer. Som proposer skal "Nod 1" nu underrette hele systemet om, at den har friske data. Den sender beskeder til alle de andre noder: "Se! Jeg har modtaget værdien 'O', og jeg ønsker at gemme den! Bekræft venligst, at I også vil gemme 'O' i jeres log."

- Næste fase er afstemning for den foreslåede værdi (Voting). Hvad er formålet med den? Det kan ske, at andre noder har modtaget mere friske oplysninger, og at de har data vedrørende den samme transaktion.
Når noden "Nod 1" sender sit proposal, kontrollerer de andre noder deres logfiler for data relateret til denne hændelse. Hvis der ikke er nogen uoverensstemmelser, erklærer noderne: "Ja, jeg har ingen andre data vedrørende denne hændelse. Værdien 'O' er de nyeste oplysninger, vi har fået."I alle andre tilfælde kan noderne svare til "Nod 1": "Hør her! Jeg har mere friske data om denne transaktion. Ikke 'O', men noget bedre."
I afstemningsfasen træffer noderne en beslutning: enten accepterer alle samme værdi, eller en af dem stemmer imod, hvilket angiver, at den har mere friske data.
- Hvis afstemningsrunden er vellykket, og alle stemmer 'ja', går systemet videre til en ny fase – accept af værdien (Accept). "Nod 1" indsamler alle svar fra de andre noder og meddeler: "Alle er enige om værdien 'O'! Jeg erklærer nu officielt, at 'O' er vores nye værdi, fælles for alle! Skriv det ned i jeres bøger, glem det ikke. Skriv det i jeres log!"
- De andre noder sender bekræftelse (Accepted) om, at de har gemt værdien 'O', og der er ikke kommet noget nyt i mellemtiden (en slags to-faset commit). Efter denne betydningsfulde begivenhed betragter vi, at den distribuerede transaktion er gennemført.
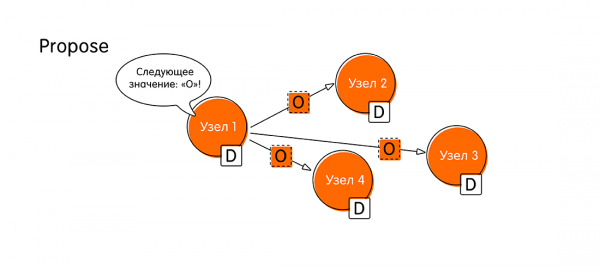
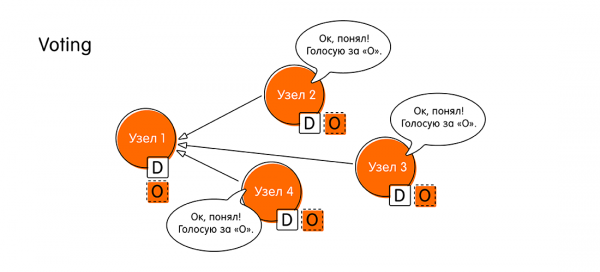
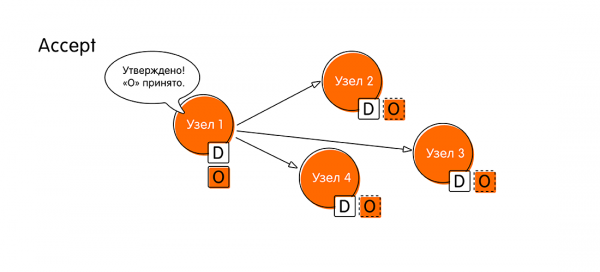
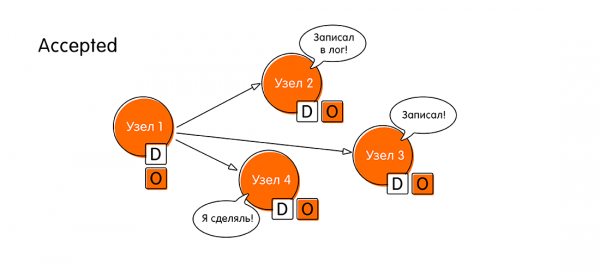
På den måde består konsensusalgoritmen i den enkle situation af fire trin: propose, afstemning (voting), accept (accept), bekræftelse af accept (accepted).
Hvis vi ikke kan opnå enighed på et hvilket som helst trin, starter algoritmen forfra med in mente den information, de noder, der nægtede at bekræfte den foreslåede værdi, vil give.
Konsensusalgoritme i et asynkront system
Indtil nu har alt været glat, for vi har talt om en synkron model for meddelelsesudveksling. Men vi ved, at vi i den moderne verden er vant til at gøre alt asynkront. Hvordan fungerer den tilsvarende algoritme i et system med en asynkron meddelelsesmodel, hvor vi antager, at ventetiden på et svar fra en node kan være ubegribelig lang (forresten kan en nodes nedbrud også betragtes som et eksempel, hvor noden kan svare uendeligt langsomt).
Nu, når vi ved, hvordan konsensusalgoritmen grundlæggende fungerer, stilles der et spørgsmål til de nysgerrige læsere, som er nået hertil: Hvor mange noder i et system med N noder med asynkron meddelelsesmodel kan gå ned, så systemet stadig kan opnå konsensus?
Det rigtige svar og begrundelse er bag spoileren.Det rigtige svar: 0. Hvis blot én node i et asynkront system går ned, kan systemet ikke opnå konsensus. Denne påstand er bevist i den kendte teorem FLP (1985, Fischer, Lynch, Paterson, henvisning til det originale i slutningen af artiklen): "Det er umuligt at opnå distribueret konsensus, når mindst én node går ud af drift."
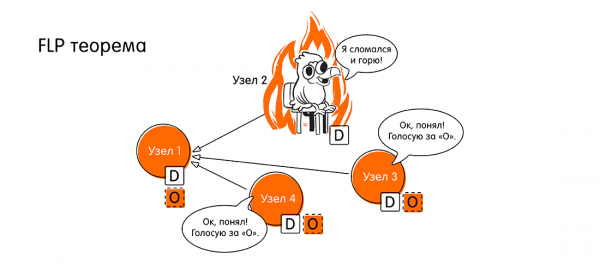
Drenge, så har vi et problem, vi er vant til, at alt er asynkront. Og så er der dette. Hvordan skal vi så leve videre?
Vi har lige talt om teorien, om matematikken. Hvad betyder "konsensus ikke kan opnås" når vi oversætter fra matematiksprog til vores - ingeniørmæssige? Det betyder, at "det ikke altid kan opnås", dvs. der findes et tilfælde, hvor konsensus ikke er muligt. Hvad er dette tilfælde?
Dette er netop en overtrædelse af liveness property, som beskrevet ovenfor. Vi har ikke enighed, og systemet kan ikke have fremskridt (kan ikke afsluttes inden for en endelig tid), når vi ikke har svar fra alle noder. Fordi i et asynkront system har vi ikke forudsigelig svartid, og vi kan ikke vide, om en node er gået ned eller blot svarer langsomt.
Men i praksis kan vi finde en løsning. Lad vores algoritme kunne fungere længe ved fejl (kan potentielt fungere uendeligt). Men i de fleste situationer, når de fleste noder fungerer korrekt, vil vi have fremskridt i systemet.
I praksis arbejder vi med delvist synkrone kommunikationsmodeller. Delvis synkronisering forstås således: I almindelighed har vi en asynkron model, men der indføres formelt et begreb kaldet 'global stabiliseringstid' for et bestemt tidspunkt.
Dette tidspunkt kan muligvis ikke opstå i lang tid, men en dag skal det komme. En virtuel alarm vil ringe, og fra dette øjeblik kan vi forudsige tidsdeltaget, som det vil tage for beskederne at nå frem. Fra dette øjeblik omdannes systemet fra asynkront til synkront. I praksis arbejder vi netop med sådanne systemer.
Paxos-algoritmen løser konsensusproblemer
– det er en familie af algoritmer, der løser konsensusproblemet for delvist synkrone systemer, under forudsætning af, at nogle noder kan fejle. Forfatteren af Paxos er . Han præsenterede et formelt bevis på eksistensen og korrektheden af algoritmen i 1989.
Men beviset viste sig at være alt andet end trivielt. Den første publikation blev udgivet først i 1998 (33 sider) med en beskrivelse af algoritmen. Det viste sig, at den var ekstremt svær at forstå, og i 2001 blev der offentliggjort en forklaring på artiklen, som fyldte 14 sider. Omfanget af publikationerne er angivet for at vise, at konsensusproblemet faktisk ikke er simpelt, og at der ligger enorme anstrengelser fra kloge mennesker bag sådanne algoritmer.
Interessant nok bemærkede Leslie Lamport selv i sin forelæsning, at der i den anden forklarende artikel er en sætning, en linje (han specificerede ikke hvilken), som kan tolkes på forskellige måder. Og på grund af dette fungerer mange moderne implementeringer af Paxos ikke helt korrekt.
En detaljeret gennemgang af Paxos' funktion vil ikke være nok til en enkelt artikel, så jeg vil forsøge at formidle hovedideerne i algoritmen meget kort. I linksene i slutningen af min artikel vil du finde materiale til videre fordybelse i dette emne.
Roller i Paxos
I Paxos-algoritmen findes der et begreb om roller. Lad os se på tre grundlæggende (der er modificationer med ekstra roller):
- Proposers (der kan også findes termer som: ledere eller koordinatorer). Dette er fyre, der lærer om en ny betydning fra brugeren og tager rollen som leder. Deres opgave er at starte en runde med at foreslå en ny betydning og koordinere de efterfølgende handlinger fra noderne. Paxos tillader desuden, at der i bestemte situationer kan være flere ledere.
- Acceptorer (Vælgere). Dette er noder, der stemmer for eller imod accepten af en eller anden værdi. Deres rolle er meget vigtig, fordi det afhænger af dem, hvilken tilstand systemet vil overgå til (eller ikke overgå til) efter næste fase af konsensusalgoritmen.
- Lærere. Noder, der blot modtager og registrerer den nyeste accepterede værdi, når systemets tilstand ændres. De træffer ikke beslutninger, men modtager data og kan videregive dem til slutbrugeren.
En enkelt node kan kombinere flere roller i forskellige situationer.
Begrebet quorum
Vi antager, at vi har et system med N noder. Og maksimalt F noder kan svigte. Hvis F noder svigter, betyder det, at vi i klyngen skal have mindst 2F + 1 acceptornoder.
Dette er nødvendigt, så vi altid, selv i den værste situation, har et flertal af "gode", korrekt fungerende noder. Det vil sige, at vi har F + 1 "gode" noder, som har accepteret, og den endelige værdi vil blive vedtaget. Ellers kan der opstå situationer, hvor forskellige lokale grupper vil acceptere forskellige værdier og ikke kan blive enige. Derfor har vi brug for et absolut flertal for at vinde afstemningen.
Den overordnede idé bag Paxos konsensusalgoritmen
Paxos-algoritmen har to store faser, som hver i sig selv opdeles i to skridt:
- Fase 1a: Forbered. I forberedelsesfasen informerer lederen (proposer) alle noder: „Vi starter en ny afstemningsfase. Vi har en ny runde. Nummeret på denne runde er n. Nu begynder vi at afgive stemmer“. Indtil nu fortæller han blot om starten på en ny cyklus, men han angiver ikke en ny værdi. Formålet med denne fase er at igangsætte en ny runde og informere alle om dens unikke nummer. Runde nummeret er vigtigt, det skal være et tal, der er større end alle tidligere afstemningsnumre fra alle tidligere ledere. Netop fordi rundenummeret gør, at andre noder i systemet forstår, hvor friske dataene er hos lederen. Det er sandsynligt, at andre noder allerede har afstemningsresultater fra meget senere runder, og de vil blot fortælle lederen, at han er bagud.
- Fase 1b: Løfte. Når acceptor-noderne har modtaget nummeret på den nye afstemningsfase, er der to mulige udfald:
- Nummeret n for den nye afstemning er større end nummeret på nogen af de tidligere afstemninger, hvori acceptoren har deltaget. Så sender acceptoren et løfte til lederen om, at han ikke vil deltage i afstemninger med et lavere nummer end n. Hvis acceptoren allerede har stemt for noget (dvs. han allerede i anden fase har accepteret en bestemt værdi), så vedlægger han den accepterede værdi og afstemningsnummeret, hvori han deltog, til sit løfte.
- I modsat fald, hvis acceptoren allerede kender til en afstemning med et højere nummer, kan han ganske enkelt ignorere forberedelsesfasen og ikke svare lederen.
- Fase 2a: Accepter. Lederen skal vente på svar fra kvorumet (flertallet af noderne i systemet), og hvis det nødvendige antal svar er modtaget, har han to mulige udfald:
- Nogle af acceptorerne har sendt værdier, som de allerede har stemt for. I så fald vælger lederen værdien fra afstemningen med det maksimale nummer. Lad os kalde denne værdi x, og sender en besked til alle noderne i formatet: „Accept (n, x)“, hvor den første værdi er afstemningsnummeret fra hans eget Propose trin, og den anden værdi er det, som alle samlet set har stemt for.
- Hvis ingen af acceptorerne har sendt nogen værdier, men blot har lovet at stemme i denne runde, kan lederen foreslå dem at stemme på sin værdi, den værdi, som han overhovedet er blevet leder for. Lad os kalde den y. Han sender en meddelelse til alle noder: «Accept (n, y)», ligesom ved det tidligere resultat.
- Fase 2b: Accepteret. Derefter, når acceptornoderne modtager meddelelsen «Accept(…)» fra lederen, accepterer de den (sender en bekræftelse til alle noder om, at de er enige i den nye værdi) kun, hvis de ikke har lovet en (anden) leder at deltage i afstemninger med rundenummeret n’ > n, ellers ignorerer de anmodningen om bekræftelse.
Hvis lederen får svar fra flertallet af noderne, og alle har bekræftet den nye værdi, betragtes den nye værdi som accepteret. Hurra! Hvis flertallet ikke er nået, eller der er noder, der nægter at acceptere den nye værdi, starter det hele forfra.
Sådan fungerer Paxos-algoritmen. Hver af disse faser har mange nuancer; vi har næsten ikke behandlet forskellige typer fejl, problemer med flere ledere og meget mere, men målet med denne artikel er blot at introducere læseren til den overordnede verden af distribuerede beregninger.
Det er også værd at bemærke, at Paxos ikke er den eneste af sin slags; der findes andre algoritmer, såsom , men det er et emne for en anden artikel.
Links til materialer til videre studie
Niveau «nybegynder»:
- , Preethi Kasireddy, blogartikel på Medium
- , Adi Kancherla, blogartikel på Medium
- , Ittai Abraham, blog
- , Ittai Abraham, blogartikel
Niveau «Leslie Lamport»:
- , Fischer, Lynch og Paterson, forskningspapir, 1985
- , Leslie Lamport, forskningspapir, 1998
- , Leslie Lamport, forskningspapir, 2001
Kilde: habr.com
