

Bem. overs.: Forfatteren af denne artikel er Cindy Sridharan, ingeniør hos imgix, der beskæftiger sig med API-udvikling og specielt test af mikrotjenester. I denne artikel deler hun sin omfattende indsigt i de aktuelle problemer indenfor distribueret sporing, hvor hun mener, at der er en mangel på virkelig effektive værktøjer til løsning af presserende opgaver.
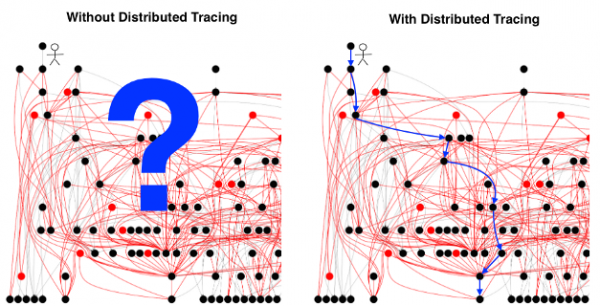
[Illustrationen er lånt fra om distribueret sporing.]
Det anses for svært at implementere, og gevinsten fra den . Problematikken omkring sporing forklares med mange årsager, og der refereres ofte til den tidskrævende opsætning af hver komponent i systemet til at sende de relevante headers med hver forespørgsel. Selvom dette problem bestemt findes, kan det slet ikke betegnes som uovervindeligt. Det forklarer for øvrigt ikke, hvorfor udviklere ikke er så glade for sporing (selv når det allerede er implementeret).
Den største udfordring med distribueret sporing er ikke indsamling af data, ikke standardisering af distributions- og præsentationsformater, og ikke at definere hvornår, hvor og hvordan der skal samples. Jeg forsøger bestemt ikke at fremstille trivielle de „brugeroplevelsesproblemer“ — faktisk eksisterer der betydelige tekniske og (hvis vi ser på virkelig Open Source ) politiske udfordringer, som skal overvindes, for at de problemer kan betragtes som løst.
Men, hvis vi forestiller os, at alle disse problemer er løst, er der en høj sandsynlighed for, at intet væsentligt vil ændre sig med hensyn til brugeroplevelsen. Sporingen kan stadig ikke give praktisk værdi i de mest almindelige fejsøgningsscenarier — selv efter den er implementeret.
Sådan en usædvanlig sporing
Distribueret sporing omfatter flere adskilte komponenter:
- udstyre applikationer og middleware med kontrolmidler;
- overførsel af distribueret kontekst;
- indsamling af sporingsdata;
- opbevaring af sporingsdata;
- deres hentning og visualisering.
Mange diskussioner om distribueret sporing reduceres til at betragte det som en form for unenighed operation, hvis eneste mål er at hjælpe med den fulde diagnosticering af systemet. Dette hænger i høj grad sammen med, hvordan opfattelsen af distribueret sporing historisk har udviklet sig. I... , der blev lavet, da kildekoderne til Zipkin blev åbnet, nævntes det, at... det [Zipkin] gør Twitter hurtigere.De første kommercielle tilbud til sporing blev også promoveret som... .
Bem. overs.: For at den efterfølgende tekst skal opfattes bedre, lad os definere to grundlæggende termer i forhold til... :
- Span — den grundlæggende enhed af distribueret sporing. Det repræsenterer en beskrivelse af en bestemt arbejdsproces (for eksempel en forespørgsel til databasen) med et navn, start- og sluttid, tags, logs og kontekst.
- Span'er indeholder typisk henvisninger til andre span'er, som muliggør sammenstilling af flere span'er i... Trace — en visualisering af livscyklussen for en anmodning, mens den bevæger sig gennem et distribueret system.
Trace'er indeholder utrolig værdifulde data, der kan hjælpe med opgaver såsom: testning i produktion, udførelse af katastrofegendannelsestests, testning med fejlindgreb osv. Faktisk bruger nogle virksomheder allerede sporing til sådanne formål. Lad os starte med, at... har andre anvendelser udover blot at overføre span'er til lagringssystemet:
- For eksempel, Uber... sporingsdata til at adskille testtrafik fra produktionstrafik.
- Facebook trace-data til analyse af kritiske stier og til trafikskift under regelmæssige katastrofegendannelsestests.
- Den sociale medieplatform... Jupyter-notebooks, der giver udviklere mulighed for at udføre vilkårlige forespørgsler baseret på sporingsresultater.
- Tilhængere af... (Lineage Driven Failure Injection)... distribuerede trace'er til testning med fejlindgreb.
Ingen af de nævnte muligheder falder helt inden for scenariet... for debugging..., hvor ingeniøren forsøger at løse et problem ved at se på trace.
Når det kommer til... tilfælde... når vi taler om debugging, forbliver den primære grænseflade diagrammet... traceview... (selvom nogle også kalder det... «Gantt-diagrammet»... eller «kaskade-diagrammet»...). À propos... traceview... til dette alle spans og tilknyttede metadata, der tilsammen udgør trace. Hver open source tracing-system samt enhver kommerciel tracing-løsning tilbyder en baseret på traceview... brugergrænseflade til visualisering, detaljer og filtrering af traces.
Problemet med alle tracing-systemer, som jeg har haft mulighed for at gennemgå indtil videre, er, at det endelige visualisering (traceview) næsten helt afspejler egenskaberne ved genereringen af trace. Selv når alternative visualiseringer tilbydes: intensitetskarter (heatmaps), service topologier, latency histogrammer, ender de alligevel med at traceview....
Tidligere har jeg over, at de fleste "innovationer" inden for tracing vedrørende UI/UX synes at være begrænset til yderligere metadata i trace, indlejret i information med høj kardinalitet (high-cardinality) eller at give mulighed for at detaljere specifikke spans eller udføre forespørgsler mellem og inden for trace. I denne forbindelse traceview... forbliver det primære visualiseringsværktøj. Så længe denne situation varer, vil distribueret tracing (i bedste fald) tage 4. plads som fejlfinding værktøj, efter metrics, logs og stack traces, og i værste fald vil det være en tom spild af penge og tid.
Problemet med traceview
Formål traceview... er at give et klart billede af bevægelsen af en enkelt forespørgsel gennem alle komponenter i det distribuerede system, som den er relateret til. Nogle mere avancerede tracing-systemer tillader detaljerede spans og viser tidsfordelingen indenfor af en enkelt proces (når spans har funktionelle grænser).
Den grundlæggende forudsætning for mikrotjenestearkitektur er ideen om, at den organisatoriske struktur vokser sammen med virksomhedens behov. Befalere af mikrotjenester hævder, at fordelingen af forskellige forretningsopgaver på separate tjenester giver små, autonome udviklerteams kontrol over hele livscyklussen for sådanne tjenester, hvilket giver dem mulighed for uafhængigt at skabe, teste og implementere disse tjenester. Ulempen ved en sådan fordeling er dog tabet af information om, hvordan hver tjeneste interagerer med andre. Under sådanne forhold gør distribueret sporing krav på at være et uundgåeligt værktøj til for debugging... komplekse interaktioner mellem tjenester.
Hvis du virkelig har , så kan ingen person holde hele dens billede i hovedet. Faktisk er udviklingen af et værktøj baseret på antagelsen om, at det overhovedet er muligt, noget der ligner et antipattern (en ineffektiv og ikke-produktiv tilgang). Ideelt kræver debugging et værktøj, der hjælper med at indsnævre søgeområdet , så ingeniører kan fokusere på et udsnit af målinger (tjenester/bruger/værter osv.), der er relevante for det pågældende problem. Når årsagen til en fejl undersøges, skal ingeniørerne ikke forstå, hvad der skete ialle tjenester på én gang , da et sådant krav ville være imod selve ideen om mikrotjenestearkitektur.Men traceview udgør netop
dette. Ja, nogle sporing systemer tilbyder komprimerede traceview, når antallet af span's i en trace er så stort, at de ikke kan vises inden for én visualisering. Men på grund af den store mængde information, der er indeholdt selv i en sådan forkortet visualisering, er ingeniører stadig nødt til at "sieve" den manuelt for at indsnævre deres udvalg til sæt af problemerkilde-tjenester. Desværre er maskiner langt hurtigere end mennesker på dette område, mindre tilbøjelige til fejl, og deres resultater er mere gentagne. En anden grund til, at jeg mener metoden traceview er forkert, har at gøre med, at den er dårlig til debugging baseret på hypoteser. I sin kerne er debugging en
... iterativ en proces, der starter med en hypotese, efterfulgt af kontrol af forskellige observationer og fakta, der er indsamlet fra systemet over forskellige biblioteker, konklusioner/sammenfatninger og en videre vurdering af hypotesens sandhed.
Mulighed hurtigt og billigt at teste hypoteser og forbedre den mentale model derefter er hjørnestenen i fejlfinding. Ethvert fejlfindingværktøj skal være interaktivt og indsnævre søgeområdet eller, i tilfælde af falske spor, tillade brugeren at gå tilbage og fokusere på et andet område af systemet. Det ideelle værktøj vil gøre dette proaktivt, straks trække brugerens opmærksomhed til potentielt problematiske områder.
Desværre, traceview... kan det ikke kaldes et værktøj med en interaktiv grænseflade. Det bedste, man kan håbe på ved brugen af det, er at opdage en kilde til øget forsinkelse og gennemse alle mulige tags og logs relateret til det. Det hjælper ikke ingeniøren med at identificere mønstre i trafikken, såsom specifikationen for forsinkelsesfordeling, eller finde korrelationer mellem forskellige målinger. kan hjælpe med at omgå nogle af disse problemer. Faktisk, på succesfuld analyse ved hjælp af maskinlæring til at identificere anomale spans og identificere et subset af tags, der kan være relateret til anomalt adfærd. Ikke desto mindre har jeg endnu ikke set overbevisende visualiseringer af fund foretaget med maskinlæring eller dataanalyse anvendt på spans, der markant adskiller sig fra traceview eller DAG (rettet acyklisk graf).
Spans er for lavt niveau
Det fundamentale problem med traceview er, at spans er for lavt niveau primitive til både latency-analyse og årsagsanalyse. Det svarer til at analysere individuelle CPU-kommandoer i et forsøg på at løse et undtagelsestilfælde, vel vidende at der findes meget mere høj-niveau værktøjer som backtrace, som er meget lettere at arbejde med.
Desuden vil jeg vove at påstå, at ideelt set ikke har vi brug for en komplet billede som sker under livscyklussen for forespørgslen, præsenteret af moderne værktøjer til sporing. I stedet kræves en form for højere abstraktion, der indeholder oplysninger om, hvad der er gået galt (analogt med backtrace), sammen med noget kontekst. I stedet for at se hele trace foretrækker jeg at se det del, hvor der sker noget interessant eller usædvanligt. I øjeblikket sker søgningen manuelt: ingeniøren får trace og analyserer selv spans for at finde noget interessant. Tilgangen, hvor folk stirrer på spans i separate traces i håbet om at opdage mistænkelig aktivitet, skalerer absolut ikke (især når de skal forstå alt metadataene kodet i forskellige spans, såsom span ID, RPC metode navn, varighed af span, logs, tags osv.).
Alternativer til traceview
Resultaterne fra sporing er mest nyttige, når de kan visualiseres på en måde, der giver en ikke-triviel præsentation af, hvad der sker i de sammenkoblede dele af systemet. Indtil da forbliver fejlfinding i høj grad inaktiv og afhænger af brugerens evne til at bemærke de rette korrelationer, kontrollere de korrekte dele af systemet eller samle brikkerne i puslespillet - i modsætning til værktøjet, der hjælper brugeren med at formulere disse hypoteser.
Jeg er ikke en visuel designer og ikke en specialist i UX, men i det følgende afsnit vil jeg gerne dele nogle idéer om, hvordan sådanne visualiseringer kan se ud.
Fokus på specifikke tjenester
I en situation, hvor branchen konsolideres omkring ideer , virker det rimeligt, at de enkelte teams primært bør overvåge overensstemmelsen mellem deres tjenester og disse mål. Heraf følger, at serviceorienteret visualisering er bedst egnet til sådanne teams.
Trace, især uden sampling, er en guldgrube af information om hver komponent i et distribueret system. Disse oplysninger kan fodres til en smart behandler, som vil levere til brugerne serviceorienterede opdagelser. De kan identificeres på forhånd - før brugeren ser på traces:
- Diagrammer for forsinkelsesfordelinger, kun for udstående anmodninger (outlier requests);
- Diagrammer for forsinkelsesfordelinger, når SLO-målene for tjenesten ikke opnås;
- De mest "almindelige", "interessante" og "mærkelige" tags i anmodninger, der oftest gentages;
- Opdeling af forsinkelser, når afhængigheder af tjenesten ikke når de fastsatte SLO-mål;
- Opdeling af forsinkelser efter forskellige downstream-tjenester.
Nogle af disse spørgsmål kan de indbyggede metriker simpelthen ikke svare på, hvilket tvinger brugerne til omhyggeligt at undersøge spans. I sidste ende har vi en ekstremt brugervennlig mekanisme.
I den forbindelse opstår spørgsmålet: Hvad med de komplekse interaktioner mellem forskellige tjenester, der styres af forskellige teams? Er det ikke traceview... den mest hensigtsmæssige løsning til at belyse en sådan situation?
Mobiludviklere, ejere af stateless-tjenester, ejere af administrerede stateful-tjenester (såsom databaser) og ejere af platforme kan være interesserede i en anden repræsentation af det distribuerede system; traceview... – det er en for universel løsning til disse fundamentalt forskellige behov. Selv i en meget kompleks mikrotjenestearkitektur har tjeneste-ejere ikke brug for dybdegående viden om mere end to til tre upstream- og downstream-tjenester. I de fleste scenarier er det tilstrækkeligt for brugerne at besvare spørgsmål vedrørende et begrænset sæt tjenester.
Det ligner at betragte et lille udvalg af tjenester gennem et forstørrelsesglas for at studere dem nøje. Dette vil give brugeren mulighed for at stille mere relevante spørgsmål vedrørende de komplekse interaktioner mellem disse tjenester og deres umiddelbare afhængigheder. Det svarer til et backtrace i tjenesteverdenen, hvor ingeniøren ved, hvad hvordan tingene ikke er, men også har en idé om, hvad der sker i de omgivende tjenester, for at forstå, hvorfor.
Den tilgang, jeg promoverer, er en fuldstændig modsætning til den "top-down" tilgang, der er baseret på traceview, hvor analysen starter med hele trace'et og derefter gradvist arbejder sig ned til individuelle spans. I stedet starter "bottom-up" tilgangen med at analysere et lille område, tæt på den potentielle årsag til hændelsen, og udvider derefter søgeområdet om nødvendigt (med mulighed for involvering af andre teams for at analysere et bredere spektrum af tjenester). Den anden tilgang er bedre tilpasset hurtig verifikation af indledende hypoteser. Når der foreligger konkrete resultater, kan der skiftes til en mere målrettet og detaljeret analyse.
Opbygning af topologi
Tjeneste-specifikke visninger kan være utrolig nyttige, hvis brugeren ved, hvilken tjeneste eller gruppe af tjenester der er ansvarlig for at øge forsinkelser eller er kilde til fejl. Men i et komplekst system kan det være en udfordrende opgave at identificere den problematiske tjeneste under nedbrud, især hvis der ikke er modtaget fejlmeddelelser fra tjenesterne.
Opbygning af service-topologier kan i høj grad hjælpe med at finde ud af, hvilken tjeneste der viser et spike i fejlhyppigheden eller en stigning i forsinkelsen, hvilket resulterer i en mærkbar forringelse af tjenestens ydeevne. Når jeg taler om opbygning af topologi, mener jeg ikke et servicekort, der viser hver enkelt tjeneste i systemet og er kendt for sine . Sådan en repræsentation er ikke bedre end traceview baseret på en rettet acyklisk graf. I stedet vil jeg gerne se dynamisk genereret service-topologi, baseret på specifikke attributter såsom fejlhyppighed, responstid eller på enhver brugerdefineret parameter, der hjælper med at klarlægge situationen med specifikke mistænkelige tjenester.
Lad os tage et eksempel. Forestil dig en hypotetisk nyhedsside. Servicen for startsiden (front page) udveksler data med Redis, med anbefalingsservicen, med reklameservicen og videoservicen. Videoservicen henter videoer fra S3, mens metadataene kommer fra DynamoDB. Anbefalingsservicen får metadata fra DynamoDB, henter data fra Redis og MySQL, og skriver beskeder til Kafka. Reklameservicen får data fra MySQL og skriver beskeder til Kafka.
Nedenfor er et skematisk billede af denne topologi (topologier opbygges ofte af mange kommercielle programmer til sporingsformål). Det kan være nyttigt, hvis man skal forstå afhængighederne mellem tjenester. Men under for debugging..., når en bestemt tjeneste (lad os sige videoservicen) viser en øget responstid, er en sådan topologi ikke særlig nyttig.
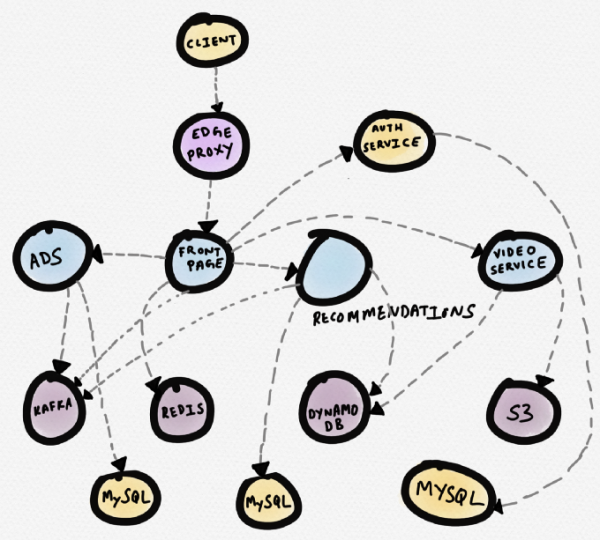
Diagram over tjenesterne på en hypotetisk nyhedsside
En diagramtype, der ville være mere velegnet, er den nedenfor. Den viser den problematiske tjeneste (video) placeret direkte i midten. Brugeren bemærker den straks. Fra denne visualisering fremgår det tydeligt, at videoservicen fungerer unormalt på grund af en øget responstid fra S3, hvilket påvirker indlæsningstiden af en del af hovedsiden.
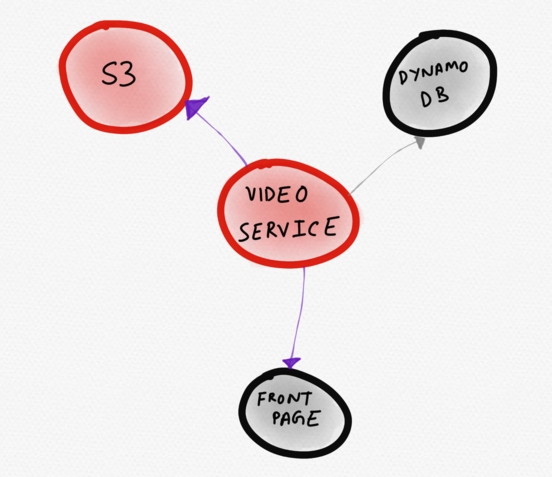
Dynamisk topologi, der viser kun de 'interessante' tjenester
Dynamisk genererede topologiske diagrammer kan vise sig at være mere effektive end statiske kort over tjenester, især i elastiske, autoskalerende infrastrukturer. Muligheden for at sammenligne og matche tjenesterne i topologier giver brugeren mulighed for at stille mere relevante spørgsmål. Mere præcise spørgsmål om systemet fører med større sandsynlighed til en bedre forståelse af, hvordan systemet fungerer.
Sammenlignende visualisering
En anden nyttig visualisering vil være en sammenlignende visning. I øjeblikket er spor (traces) ikke meget velegnede til side-by-side sammenligning, så der sammenlignes normalt spans. Og hovedideen med denne artikel er netop, at spans er for lavniveau til at udtrække den mest værdifulde information fra sporingsresultaterne.
At sammenligne to spor kræver ikke fundamentalt nye visualiseringer. Faktisk er det nok med noget så simpelt som et histogram, der repræsenterer den samme information som traceview. Overraskende nok kan selv denne enkle metode bringe langt større udbytte end blot at studere to spor enkeltvis. Endnu mere kraftfuld ville muligheden for visualisere sammenligning af spor sammen med. Det ville være ekstremt nyttigt at se, hvordan en nyligt implementeret ændring i databaskonfigurationen med aktiveret GC (garbage collection) påvirker svartiden for downstream-tjenesten over et par timer. Hvis det, jeg beskriver her, lyder som en A/B-analyse af effekten af infrastrukturændringer, i flere tjenester , så er du ikke langt fra sandheden.
Konklusion
Jeg sætter ikke spørgsmålstegn ved nytten af sporingen. Jeg tror oprigtigt, at der ikke er nogen anden metode til at indsamle lige så rige, kausale og kontekstuelle data som dem, der findes i en spor. Men jeg mener også, at alle sporingsløsninger bruger disse data ekstremt ineffektivt. Så længe værktøjerne til sporing fokuserer på traceview-visualisering, vil de være begrænset i deres evne til at maksimere værdifuld information, der kan udtrækkes fra dataene i sporene. Desuden er der en risiko for at udvikle en helt uvenlig og ikke-intuitiv visuel grænseflade, som kraftigt vil begrænse brugerens evne til at fejlsøge i applikationen.
Fejlfinding af komplekse systemer, selv med de nyeste værktøjer, er utrolig vanskelig. Værktøjerne skal hjælpe udvikleren med at formulere og teste hypoteser, aktivt levere relevant information, identificere udliggere og bemærke mønstre i latenstidens fordeling. For at sporing skal blive det foretrukne værktøj for udviklere til at løse nedbrud i produktion eller løse problemer, der spænder over forskellige tjenester, er originale brugergrænseflader og visualiseringer nødvendige, der i højere grad svarer til de mentale modeller hos udviklerne, der skaber og driver disse tjenester.
Det vil kræve betydelig mental anstrengelse at designe et system, der præsenterer forskellige signaler tilgængelige i sporingsresultaterne på en måde, der er optimeret til at lette analysen og ræsonneringen. Det er nødvendigt at overveje, hvordan man kan abstrahere systemets topologi under fejlfinding, så det hjælper brugeren med at overvinde blinde pletter uden at skulle kigge ind i individuelle spor eller spans.
Vi har brug for gode muligheder for abstrahering og lagdeling (især i UI). Sådanne muligheder, der passer godt ind i en hypotese-baseret fejlfinding, hvor man iterativt kan stille spørgsmål og teste hypoteser. De vil ikke løse alle problemer med observabilitet automatisk, men vil hjælpe brugerne med at skærpe deres intuition og formulere mere velovervejede spørgsmål. Jeg opfordrer til en mere eftertænksom og innovativ tilgang til visualisering. Her er der en reel mulighed for at udvide horisonterne.
P.S. fra oversætteren
Læs også på vores blog:
- «»;
- «»;
- «».
Kilde: habr.com
