

Når det kommer til at overvåge sikkerheden i et internt virksomheds- eller myndighedsnetværk, tænker mange på kontrol af informationslæksager og implementering af DLP-løsninger. Men hvis vi forsøger at præcisere spørgsmålet og spørge, hvordan I opdager angreb i det interne netværk, vil svaret normalt være nævnelsen af indtrængningsdetekteringssystemer (intrusion detection systems, IDS). Og det, der for 10-20 år siden var den eneste mulighed, er i dag blevet en anakronisme. Der findes en mere effektiv, og visse steder endda den eneste mulige metode til at overvåge det interne netværk — at bruge flow-protokoller, der oprindeligt var beregnet til at finde netværksproblemer (troubleshooting), men som med tiden har udviklet sig til et meget interessant sikkerhedsinstrument. I denne artikel vil vi tale om, hvilke flow-protokoller der findes, og hvilke der bedst hjælper med at opdage netværksangreb, hvor monitorering af flow er bedst at implementere, hvad man skal være opmærksom på ved opsætning af et sådant system, og hvordan man 'starter' det hele på indenlandsk udstyr.
Jeg vil ikke stoppe op ved spørgsmålet 'Hvorfor er overvågning af den interne infrastruktur nødvendig?' Svaret på det er tilsyneladende klart. Men hvis du stadig gerne vil sikre dig, at vi i dag ikke kan undvære det, en kort video, der forklarer, hvordan man kan trænge ind i et corporate netværk, der er beskyttet af en firewall, på 17 forskellige måder. Så lad os antage, at vi forstår, at intern overvågning er nødvendig, og nu skal vi blot finde ud af, hvordan vi kan organisere den.
Jeg vil fremhæve tre nøglekilder til data til overvågning af infrastrukturen på netværksniveau:
- den 'rå' trafik, som vi opfanger og sender til analyse af visse analyse-systemer,
- nationale enheders hændelser, som trafikken passerer gennem,
- information om trafikken, der modtages via en af flow-protokollerne.
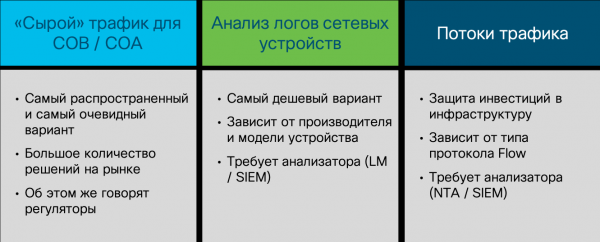
Indfangning af rå trafik er den mest populære metode blandt sikkerhedseksperter, da den historisk set er den, der først blev udviklet. De første kommercielle netværksovervågningssystemer (den første var NetRanger fra Wheel Group, købt af Cisco i 1998) beskæftigede sig netop med at indfange pakker (og senere sessioner), hvor der blev søgt efter specifikke signaturer (”afgørende regler” i FSTEK-terminologi), der indikerede angreb. Selvfølgelig kan rå trafik analyseres ikke kun med IDS, men også ved hjælp af andre værktøjer (f.eks. Wireshark, tcpdump eller funktionaliteten NBAR2 i Cisco IOS), men disse har typisk ikke den vidensbase, der adskiller et informationssikkerhedsværktøj fra et almindeligt IT-værktøj.
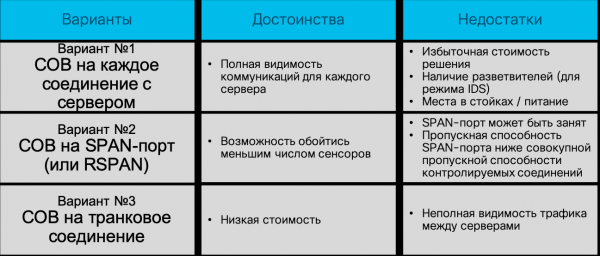
Så lad os tale om angrebsdetekteringssystemer. Den ældste og mest populære metode til detektion af netværksangreb, som gør det ret godt på perimeteren (uanset hvilken - virksomhed, datacenter, segment osv.), men som halter bagud i moderne væksel- og softwaredefinerede netværk. I tilfælde af et netværk bygget på standard switcher, bliver infrastrukturen af sensorer til angrebsdetektion for stor - du bliver nødt til at installere en sensor på hver forbindelse til en node, hvis angreb du ønsker at overvåge. Enhver fabrikant vil selvfølgelig være glad for at sælge dig hundreder og tusinder af sensorer, men jeg tror, at dit budget ikke kan klare sådanne udgifter. Jeg kan sige, at selv hos Cisco (hvor vi udvikler NGIPS) har vi ikke været i stand til at gøre det, selvom det umiddelbart synes, at prisen ikke skulle være et problem — det er jo vores eget produkt. Derudover opstår spørgsmålet, hvordan man skal tilslutte sensoren i en sådan opsætning? I brud? Hvad hvis selve sensoren går i stykker? Skal der være en bypass-modul i sensoren? Bruge tap-splittere? Alt dette øger omkostningerne og gør det uoverskueligt for virksomheder af enhver størrelse.
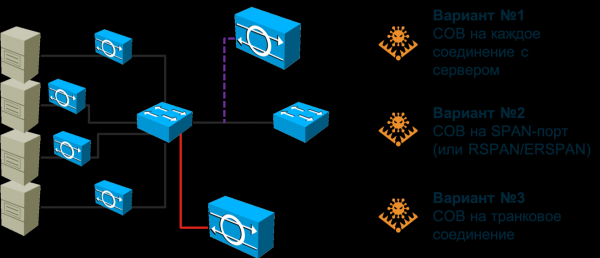
Du kan forsøge at "hæfte" sensoren til en SPAN/RSPAN/ERSPAN-port og dirigere trafik fra de nødvendige porte på switchen til den. Denne løsning løser delvist problemet beskrevet i det forrige afsnit, men skaber et andet — SPAN-porten kan ikke acceptere al den trafik, der dirigeres til den — den har ikke nok båndbredde. Du må ofre noget. Enten skal nogle noder være uden overvågning (i så fald skal du først prioritere dem), eller også skal du kun dirigere en bestemt type trafik fra noden og ikke al trafik. Uanset hvad kan vi misse nogle angreb. Desuden kan SPAN-porten være optaget til andre formål. I sidste ende må vi genoverveje den eksisterende netværks-topologi og muligvis ændre den for at maksimere dækningen af dit netværk med det antal sensorer, du har (og koordinere det med IT).
Men hvad hvis dit netværk bruger asymmetrisk routing? Hvad hvis du har implementeret eller planlægger at implementere SDN? Hvad hvis du skal overvåge virtualiserede maskiner eller containere, hvis trafik slet ikke når den fysiske switch? Disse spørgsmål er producenterne af traditionelle IDS mindre glade for, fordi de ikke ved, hvordan de skal svare på dem. Måske vil de forsøge at overbevise dig om, at alle disse trendy teknologier er hype, og at du ikke har brug for dem. Måske vil de tale om nødvendigheden af at starte småt. Eller måske vil de sige, at du skal sætte en kraftig maskine i midten af netværket og dirigere al trafikken til den ved hjælp af load balancere. Uanset hvilket forslag du får, er det vigtigt, at du selv tydeligt forstår, hvor godt det passer til dine behov. Og først derefter træffe beslutninger om, hvilken tilgang du skal vælge til overvågning af IT-sikkerheden i dit netværksinfrastruktur. Når det gælder pakkeoptagelse, vil jeg sige, at denne metode stadig er meget populær og vigtig, men dens primære formål er grænsekontrol; grænserne mellem din organisation og Internettet, grænserne mellem datacenteret og resten af netværket, grænserne mellem automatisk kontrolsystem og det virksomhedsmæssige segment. I disse områder har klassiske IDS/IPS stadig en berettigelse og klarer sig godt med de opgaver, de får.
Lad os gå videre til den anden mulighed. Analyse af hændelser, der kommer fra netværksudstyr, kan også bruges til angrebsdetektering, men ikke som den primære mekanisme, da den kun kan detektere en lille klasse indbrud. Desuden har den en vis reaktivitet - et angreb skal først finde sted, derefter skal det registreres af netværksudstyret, som på en eller anden måde vil signalere om problemet med informationssikkerhed. Der er flere metoder til dette. Det kan være syslog, RMON eller SNMP. Sidstnævnte to protokoller til netværksovervågning i forbindelse med informationssikkerhed anvendes kun, når vi har brug for at opdage en DoS-angreb på selve netværksudstyret, da RMON og SNMP kan bruges til at overvåge belastningen på enhedens centrale processor eller dens interfaces. Dette er en af de mest “omkostningseffektive” (syslog eller SNMP er tilgængelig for alle), men også den mest ineffektive metode til overvågning af informationssikkerhed i den interne infrastruktur - mange angreb er simpelthen skjulte for den. Selvfølgelig skal man ikke ignorere dem, og den samme syslog-analyse hjælper dig med at identificere ændringer i konfigurationen af selve enheden, kompromittering af den, men det er ikke særlig velegnet til at opdage angreb på hele netværket.
Den tredje mulighed er at analysere information om trafikken, der passerer gennem en enhed, der understøtter en af flere flow-protokoller. I dette tilfælde, uanset protokollen, består infrastrukturen til arbejde med flows altid af tre komponenter:
- Generering eller eksport af flow. Denne rolle tildeles normalt en router, switch eller andet netværksudstyr, der, mens det passerer netværkstrafik, kan udtrække nøgleparametre, som derefter sendes til indsamlingen. For eksempel understøtter Cisco-protokollen Netflow ikke kun routere og switche, herunder både virtuelle og industrielle, men også trådløse controllere, firewall og endda servere.
- Indsamling af flow. Da der i moderne netværk typisk er mere end en netværksenhed, opstår der en opgave med indsamling og konsolidering af flows, som løses ved hjælp af såkaldte collectorer, der behandler de modtagne flows og derefter sender dem til analyse.
- Flow-analyse. Analyseværktøjet tager den primære intellektuelle opgave og anvender forskellige algoritmer på strømme for at drage visse konklusioner. For eksempel kan et sådant analyseredskab inden for IT-funktionen identificere flaskehalse i netværket eller analysere trafikbelastningsprofilen for yderligere at optimere netværket. Og til informationsbeskyttelse kan et sådant analyseredskab identificere datalækager, spredning af malware eller DoS-angreb.
Man skal ikke tro, at en sådan tre-lags arkitektur er for kompleks — alle andre muligheder (undtagen måske netværksovervågningssystemer, der arbejder med SNMP og RMON) fungerer også i henhold til denne. Vi har en datagenerator til analyse, der fungerer som et netværksapparat eller en selvstændig sensor. Vi har et alarmsignalindsamlingssystem, og vi har et system til at styre hele overvågningsinfrastrukturen. De sidste to komponenter kan sammenlægges inden for en enkelt enhed, men i mere eller mindre store netværk er de normalt fordelt over mindst to enheder for at sikre skalerbarhed og pålidelighed.
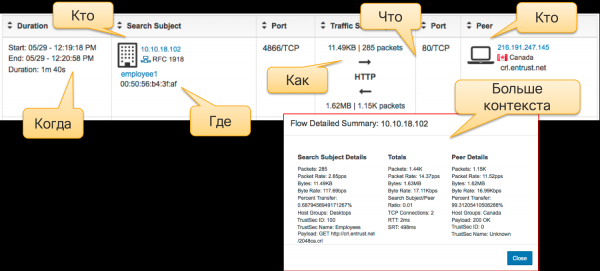
I modsætning til pakkekanalanalyse, der er baseret på undersøgelse af header og indhold af hver pakke samt de sessioner, der består af dem, hviler flowanalysen på indsamling af metadata om netværkstrafik. Hvornår, hvor meget, hvorfra og til hvor, hvordan... det er spørgsmål, som netværkstelemetrianalysen besvarer ved hjælp af forskellige flow-protokoller. Oprindeligt blev de brugt til at analysere statistik og finde IT-problemer i netværket, men senere, efterhånden som de analytiske mekanismer udviklede sig, blev det muligt at anvende dem på samme telemetri til sikkerhedsformål. Her skal det endnu en gang bemærkes, at flow-analyse ikke erstatter eller annullerer pakkefangst. Hver af disse metoder har sit anvendelsesområde. Men i konteksten af denne artikel er det netop flow-analyse, der bedst egner sig til overvågning af den interne infrastruktur. Du har netværksenheder (og det er ligegyldigt, om de arbejder i en softwaredefineret paradigme eller i henhold til statiske regler), som en angreb ikke kan omgå. En classic IDS-sensor kan den omgå, men et netværksapparat, der understøtter flow-protokollen, kan den ikke. Dette er fordelene ved denne metode.
På den anden side, hvis du har brug for beviser til retshåndhævelse eller din egen efterforskningsgruppe for hændelser, kan du ikke undgå at bruge pakkeoptagelse — netværkstelemtri er ikke en kopi af trafikken, der kan bruges ved indsamling af beviser; det er nødvendigt for hurtig opdagelse og beslutningstagning inden for informationssikkerhed. På den anden side, ved at bruge telemetrianalyse, kan du "skrive" ikke al netværkstrafik (i øvrigt, Cisco og datacentre håndterer det :-), men kun den trafik, der er involveret i angrebet. Værktøjer til telemetrianalyse supplerer på dette område godt de traditionelle pakkeoptagelsesmekanismer, hvilket giver mulighed for selektiv optagelse og opbevaring. Ellers skal du have en kolossal opbevaringsinfrastruktur.
Lad os forestille os et netværk, der opererer med en hastighed på 250 Mbit/s. Hvis du ønsker at gemme hele dette volumen, har du brug for 31 MB opbevaring for et sekunds trafikoverførsel, 1,8 GB for et minut, 108 GB for en time, og 2,6 TB for en dag. For at gemme daglige data fra et netværk med en båndbredde på 10 Gbit/s, har du brug for 108 TB opbevaring. Og nogle tilsynsmyndigheder kræver, at data gemmes i årevis... Optagelse "on demand", som telemetrianalysen hjælper med at realisere, hjælper med at reducere disse værdier med flere størrelser. For øvrigt, når vi taler om forholdet mellem mængden af gemte data fra netværkstelemtri og den fulde dataoptagelse, er det cirka 1 til 500. For de samme nævnte værdier ville lagringen af den fulde dekodning af al daglig trafik være henholdsvis 5 GB og 216 GB (det kan endda gemmes på et almindeligt USB-drev).
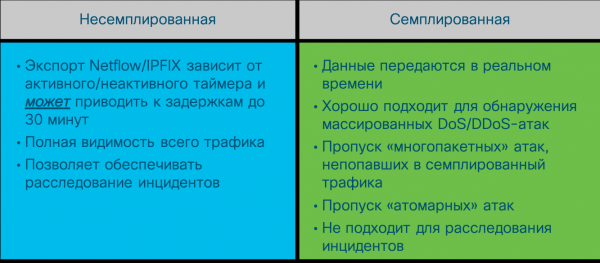
Hvis metoden til at indsamle rå netværksdata er næsten ens fra leverandør til leverandør, er situationen en anden, når det kommer til strøm-analyse. Der findes flere varianter af flow-protokoller, som det er vigtigt at kende forskellene på i sikkerhedssammenhæng. Den mest populære er Netflow-protokollen, udviklet af Cisco. Der findes flere versioner af denne protokol, som adskiller sig i deres muligheder og mængden af trafikdata, der registreres. Den aktuelle version er niende (Netflow v9), som danner grundlaget for industristandarden Netflow v10, også kendt som IPFIX. I dag understøtter de fleste netværksleverandører enten Netflow eller IPFIX i deres udstyr. Men der er også forskellige andre varianter af flow-protokoller — sFlow, jFlow, cFlow, rFlow, NetStream osv., hvor sFlow er den mest populære. Det er netop sFlow, som oftest understøttes af indenlandske producenter af netværksudstyr på grund af den enkle implementering. Hvad er de vigtigste forskelle mellem Netflow, som er blevet de facto standard, og sFlow? Jeg ville fremhæve flere nøgleforskelle. For det første har Netflow brugerdefinerede felter, i modsætning til de faste felter i sFlow. For det andet, som er det vigtigste i vores tilfælde, indsamler sFlow det såkaldte samplede telemetri; i modsætning til det usamplede hos Netflow og IPFIX. Hvad er forskellen mellem dem?
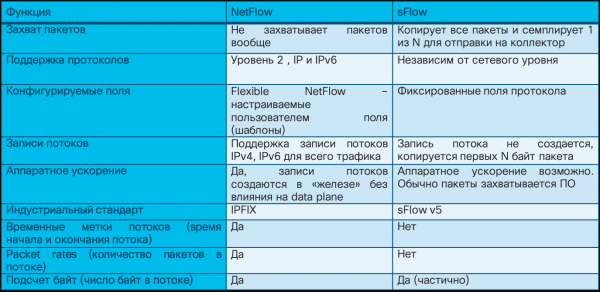
Forestil dig, at du har besluttet at kigge nærmere på bogen “” af mine kolleger — Gary McIntyre, Joseph Muniz og Nadem AlFardan (du kan downloade en del af bogen via linket). Du har tre muligheder for at nå dit mål — læse bogen helt, skimme den og stoppe ved hver 10. eller 20. side, eller forsøge at finde en opsummering af de vigtigste koncepter i en blog eller tjeneste som SmartReading. Det usamplede telemetri er at læse hver “side” af netværkstrafikken, det vil sige at analysere metadataene for hver pakke. Det samplede telemetri er en udvalgt undersøgelse af trafikken i håbet om, at der i de udvalgte samples vil være det, du har brug for. Afhængigt af hastigheden på kanalen vil det samplede telemetri levere hver 64., 200., 500., 1000., 2000. eller endda 10000. pakke til analyse.
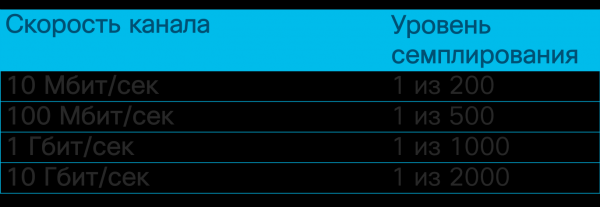
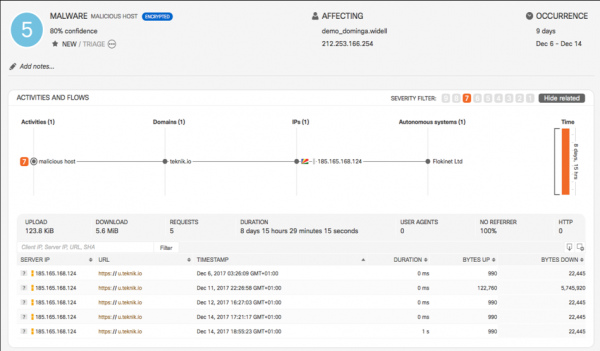
I konteksten af overvågning af IKT betyder det, at den sampled telemetri er velegnet til at opdage DDoS-angreb, scanninger, spredning af malware, men kan overse atomiske eller multi-paket angreb, der ikke er inkluderet i det sample, der blev sendt til analyse. Den unsampled telemetri har ikke sådanne ulemper, og med dens hjælp er spektret af opdagede angreb langt bredere. Her er en kort liste over begivenheder, der kan opdages med hjælp af analyseværktøjer til netværkstelemetri.
Naturligvis, en eller anden open source Netflow-analysator vil ikke kunne gøre dette, da dens primære opgave er at indsamle telemetri og udføre en grundlæggende analyse set fra et IT-perspektiv. For at identificere trusler til IKT baseret på flow, skal analysatoren udstyres med forskellige motorer og algoritmer, som vil identificere cybersikkerhedsproblemer baseret på standard eller brugerdefinerede Netflow-felter, berige standarddata med eksterne data fra forskellige kilder til trussel efterretning osv.
Så hvis du har valget, så vælg Netflow eller IPFIX. Men selv hvis dit udstyr kun arbejder med sFlow, som det gør hos indenlandske producenter, kan du stadig få fordel af det i sikkerhedssammenhæng.
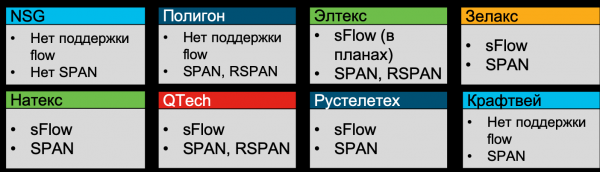
I sommeren 2019 analyserede jeg mulighederne, som de russiske producenter af netværksudstyr har, og alle, undtagen NSG, Poligon og Kraftvey, hævdede at støtte sFlow (i det mindste Zelax, Natex, Eltex, QTech, Rusteletech).
Det næste spørgsmål, du må stille dig selv, er, hvor man implementerer flow-support til sikkerhedsmæssige formål? Faktisk er spørgsmålet stillet lidt ukorrekt. På moderne udstyr er der næsten altid support for flow-protokoller. Derfor ville jeg omformulere spørgsmålet: Hvor er det mest effektivt at indsamle telemetri i forhold til sikkerhed? Svaret vil være temmelig åbenlyst — på adgangsniveauet, hvor du ser 100% af al trafik, hvor du har detaljeret information om værter (MAC, VLAN, interface-ID), og hvor du kan spore endda P2P-trafik mellem værter, hvilket er kritisk for at opdage scanning og spredning af ondsindet software. På kerne-niveau kan du simpelthen ikke se en del trafik, og på perimeter-niveau vil du højst se en fjerdedel af al din netværkstrafik. Men hvis der af en eller anden grund er kommet ukendte enheder ind i dit netværk, som tillader angribere at "gå ind og ud", omgås perimetret, så vil analyse af telemetri fra dem ikke give dig noget. Derfor anbefales det for maksimal dækning at aktivere indsamling af telemetri netop på adgangsniveauet. Det er værd at bemærke, at selvom vi taler om virtualisering eller containere, så findes der ofte support for flow i moderne virtuelle switche, hvilket gør det muligt at kontrollere trafikken der.
Men da jeg nu har taget emnet op, må jeg svare på spørgsmålet: Hvad hvis udstyret, fysisk eller virtuelt, ikke understøtter flow-protokoller? Eller hvis dens aktivering er forbudt (for eksempel i industrielle segmenter for at sikre pålidelighed)? Eller hvis aktivering fører til høj belastning på centralprocessoren (det kan ske på gammelt udstyr)? For at løse denne opgave findes der specialiserede virtuelle sensorer (flow sensor), som i bund og grund er almindelige fordelere, der lader trafik passere gennem dem og transmitterer det som flow til en indsamlingsmodul. Men i dette tilfælde får vi hele bunken af problemer, som vi talte om tidligere i forbindelse med pakkeopsamlingsværktøjer. Det vil sige, man skal forstå ikke kun fordelene ved flow-analyseteknologi, men også dens begrænsninger.
En anden ting at huske, når man taler om analysesoftware til datastreams, er, at hvis vi anvender metrikken EPS (events per second, hændelser pr. sekund) til almindelig sikkerhedsgenerering, så gælder den ikke for telemetryanalyse; her erstattes den af FPS (flows per second, strømme pr. sekund). Ligesom med EPS kan vi ikke beregne dette på forhånd, men vi kan vurdere det omtrentlige antal strømme, som en enhed genererer afhængigt af dens opgave. Du kan finde tabeller online med omtrentlige værdier for forskellige typer af virksomhedsenheder og betingelser, som vil hjælpe dig med at estimere, hvilke licenser du har brug for til analyseværktøjer, og hvilken arkitektur der vil være nødvendig. Sensoren til IDS har en begrænset båndbredde, som den kan "trække", og flowkollektoren har sine egne begrænsninger, som man skal forstå. Derfor er der typisk flere kollektorer i store, geografisk distribuerede netværk. Da jeg beskrev, , nævnte jeg allerede antallet af vores kollektorer — 21. Og det gælder for et netværk, der strækker sig over fem kontinenter og omfatter omkring en halv million aktive enheder).
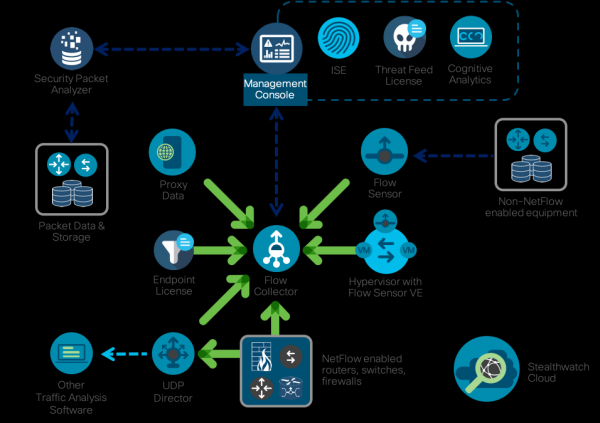
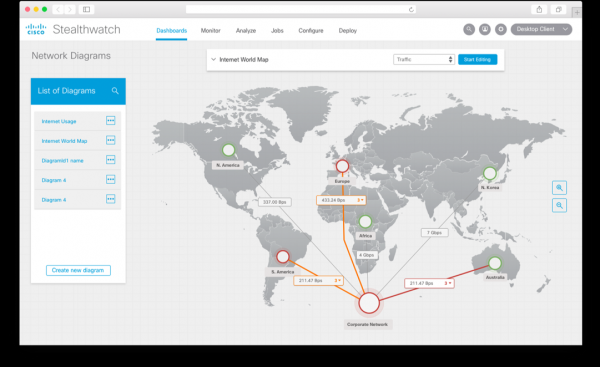
Som overvågningssystem for Netflow bruger vi vores eget , som er specielt rettet mod at løse sikkerhedsopgaver. Den har mange indbyggede motorer til at opdage anomal, mistænkelig og åbenlyst skadelig aktivitet, hvilket gør det muligt at detektere et bredt spektrum af forskellige trusler — fra kryptovalutaudvinding til datalækager, fra spredning af skadelig kode til svindel. Ligesom de fleste strømmeanalysatorer er Stealthwatch bygget på et tre-niveau skema (generator — samler — analyser), men den er suppleret med en række interessante funktioner, der er vigtige i konteksten af det materiale, vi behandler. For det første integreres den med packet capturing-løsninger (f.eks. Cisco Security Packet Analyzer), hvilket gør det muligt at optage udvalgte netværkssessioner til efterfølgende dybdegående undersøgelse og analyse. For det andet, med henblik på at udvide sikkerhedsopgaverne, har vi udviklet en særlig protokol kaldet nvzFlow, som gør det muligt at
transmittere
SiLK — et sæt af værktøjer (System for Internet-Level Knowledge) til trafikanalyse, udviklet af det amerikanske CERT/CC, som støtter Netflow (de femte og niende, de mest populære versioner), IPFIX og sFlow. Det gør det muligt at udføre forskellige operationer på netværkstelemtri ved hjælp af forskellige værktøjer (rwfilter, rwcount, rwflowpack osv.) med det formål at opdage tegn på uautoriserede handlinger. Men der er et par vigtige punkter at bemærke. SiLK er et kommandolinjeværktøj, så operationel analyse kræver indtastning af kommandoer som (opdagelse af ICMP-pakker større end 200 byte):
rwfilter --flowtypes=all/all --proto=1 --bytes-per-packet=200- --pass=stdout | rwrwcut --fields=sIP,dIP,iType,iCode --num-recs=15
det er ikke særlig praktisk. Du kan bruge den grafiske grænseflade i iSiLK, men den vil ikke gøre din hverdag meget lettere, da den kun fungerer som visualisering og ikke som erstatning for analytikeren. Og det er det andet punkt. I modsætning til kommercielle løsninger, som allerede har en solid analytisk base, algoritmer til opdagelse af anomalier, relevante workflows osv., skal du i tilfælde af SiLK selv udføre alt dette, hvilket kræver lidt andre kompetencer end at bruge et allerede færdigt værktøj. Dette er hverken godt eller dårligt — det er en egenskab ved næsten ethvert gratis værktøj, som antager, at du ved, hvad du laver, og det kun hjælper dig med det (kommercielle værktøjer er mindre afhængige af deres brugeres kompetencer, selvom de også forudsætter, at analytikere forstår i det mindste grundlæggende netværksundersøgelser og overvågning). Men lad os gå tilbage til SiLK. Arbejdscyklussen for analytikeren ser sådan ud:
- Formulering af hypotese. Vi skal forstå, hvad vi leder efter i netværkstelemtrien, og kende de unikke attributter, som vi vil bruge til at identificere bestemte anomalier eller trusler.
- Modellering. Når vi har formuleret vores hypotese, programmerer vi den ved hjælp af Python, shell eller andre værktøjer, der ikke er en del af SiLK.
- Testning. Nu er det tid til at teste rigtigheden af vores hypotese, som bekræftes eller afkræftes ved hjælp af SiLK-værktøjer, der starter med ‘rw’, ‘set’, ‘bag’.
- Analyse af reelle data. I industriel drift hjælper SiLK med at identificere noget, og analytikeren skal besvare spørgsmål som "Har vi fundet det, vi antog?", "Stemmer dette overens med vores hypotese?", "Hvordan kan vi mindske antallet af falske alarmer?", "Hvordan kan vi forbedre genkendelsesniveauet?" osv.
- Forbedring. I den afsluttende fase forbedrer vi det tidligere udførte — vi skaber skabeloner, forbedrer og optimerer koden, omformulerer og præciserer hypotesen osv.
Denne cyklus vil også være anvendelig for Cisco Stealthwatch, dog automatiserer den sidstnævnte i videst muligt omfang de fem trin, hvilket reducerer analytikernes fejl og øger hastigheden på opdagelse af hændelser. For eksempel kan du i SiLK berige netværksstatistik med eksterne data om ondsindede IP-adresser ved hjælp af selvskrevne scripts, mens det i Cisco Stealthwatch er en indbygget funktion, der straks viser en alarm, hvis der er interaktion med IP-adresser fra en sortliste i netværkstrafikken.
Hvis man går højere op i "betalingspyramiden" for flow-analyse software, vil den helt gratis SiLK blive efterfulgt af et betinget gratis ELK, bestående af tre nøglekomponenter — Elasticsearch (indeksering, søgning og dataanalyse), Logstash (dataindgang/udgang) og Kibana (visualisering). I modsætning til SiLK, hvor alt skal skrives fra bunden, har ELK allerede mange færdige biblioteker/moduler (nogle er betalte, andre ikke), der automatiserer analysen af netværkstelemetri. For eksempel tillader GeoIP-filteret i Logstash at knytte de observerede IP-adresser til deres geografiske placering (den funktion er indbygget i Stealthwatch).
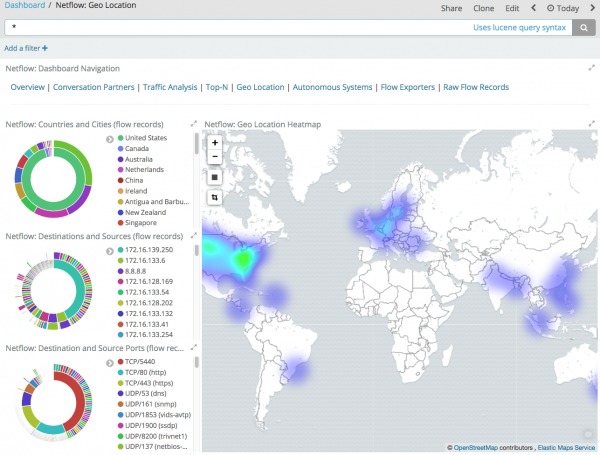
ELK har også et stort fællesskab, der tilføjer manglende komponenter til denne overvågningsløsning. For eksempel, for at arbejde med Netflow, IPFIX og sFlow kan du benytte modulet , hvis du ikke er tilfreds med Logstash Netflow Module, som kun understøtter Netflow.
Ved at give mere hastighed til indsamling af flow og søgning i det, har ELK i øjeblikket ikke en rig indbygget analyse til opdagelse af anomalier og trusler i netværkstelemetri. Det vil sige, at hvis man følger den ovenfor beskrevne livscyklus, bliver man nødt til selv at beskrive brudmodeller og derefter bruge dem i det operative system (der er ingen indbyggede modeller der).
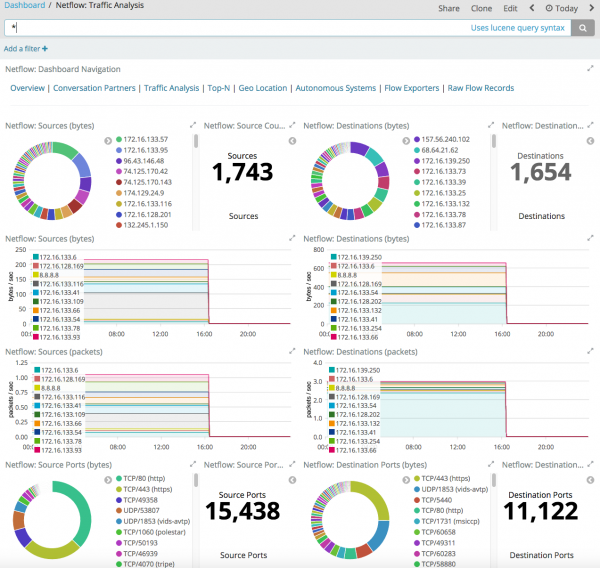
Der findes selvfølgelig også mere avancerede udvidelser til ELK, hvor nogle modeller til opdagelse af anomalier i netværkstelemetri allerede er indbygget, men sådanne udvidelser koster penge, og så står spørgsmålet - er det pengene værd? Skal man selv skrive en lignende model, købe en implementering til sit overvågningssystem eller købe en færdig løsning inden for Network Traffic Analysis?
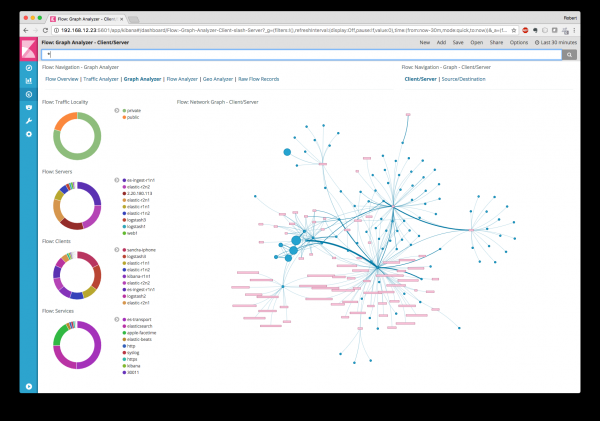
Jeg vil egentlig ikke gå ind i polemik om, hvad der er bedst: at bruge penge på at købe en færdig løsning til overvågning af anomalier og trusler i netværkstelemetri (f.eks. Cisco Stealthwatch) eller selv sætte sig ind i det og tilpasse f.eks. SiLK, ELK eller nfdump eller OSU Flow Tools (jeg henviser til de sidste to) sidste gang)? Hver vælger for sig selv, og hver har sine egne motiver for at vælge en af de to muligheder. Jeg ville bare vise, at netværkstelemetri er et meget vigtigt værktøj til at sikre netværkssikkerheden i ens interne infrastruktur, og man bør ikke negligere det for ikke at ende på listen over virksomheder, hvis navne nævnes i medierne sammen med epitetter som "brudt", "ikke overholdt kravene til informationssikkerhed", "ikke tænkt på sikkerheden af sine egne data og kunders data".
Afslutningsvis vil jeg gerne opsummere nogle nøgle råd, som man bør følge, når man indretter overvågning af informationssikkerheden i sin interne infrastruktur:
- Begræns dig ikke kun til perimetret! Brug (og vælg) netværksinfrastrukturen ikke kun til at overføre trafik fra punkt A til punkt B, men også til at håndtere spørgsmål om cybersikkerhed.
- Undersøg de eksisterende overvågningsmekanismer i dit netværksudstyr og anvend dem.
- Til intern overvågning skal du prioritere analyse af telemetri - det muliggør opdagelse af op til 80-90% af alle netværksrelaterede sikkerhedshændelser, hvilket gør det muligt at gøre noget, som ikke kan lade sig gøre med indsamling af netværkspakker, samtidig med at det sparer plads til opbevaring af alle sikkerhedshændelser.
- Til overvågning af strømmene skal du bruge Netflow v9 eller IPFIX – de giver mere information i sikkerhedssammenhæng og gør det muligt at overvåge ikke kun IPv4, men også IPv6, MPLS osv.
- Brug et ikke-prøvet flowprotokol – det giver mere information til opdagelse af trusler. For eksempel, Netflow eller IPFIX.
- Kontroller indlæsningen af dit netværksudstyr – det kan være, at det ikke kan håndtere flow-protokollen. Overvej derfor at anvende virtuelle sensorer eller en Netflow Generation Appliance.
- Implementer kontrol først og fremmest på adgangsniveau – det vil give dig mulighed for at se 100% af al trafik.
- Hvis du ikke har noget valg og bruger russisk netværksudstyr, så vælg det, der understøtter flow-protokoller eller har SPAN/RSPAN-porte.
- Kombiner systemer til opdagelse/forebyggelse af indbrud/angreb på grænserne og systemer til analyse af flow i det interne netværk (herunder også i skyen).
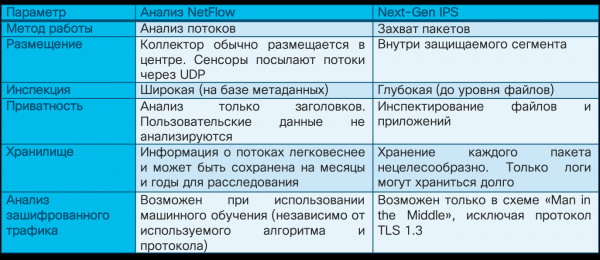
Hvad angår det sidste råd, vil jeg gerne give en illustration, som jeg tidligere har nævnt. Du kan se, at hvis Cisco's Informationssikkerhedstjeneste tidligere næsten udelukkende byggede sit overvågningssystem på systemer til opdagelse af indbrud og signaturmetoder, så står de nu for kun 20% af hændelserne. Yderligere 20% henføres til systemer til analyse af flow, hvilket viser, at disse løsninger ikke er en luksus, men et reelt værktøj i informationssikkerhedstjenesternes arbejde i moderne virksomheder. Især da du har det vigtigste til deres implementering – netværksinfrastrukturen, investeringer i hvilken kan beskyttes yderligere ved at pålægge netværket også overvågningsfunktioner.
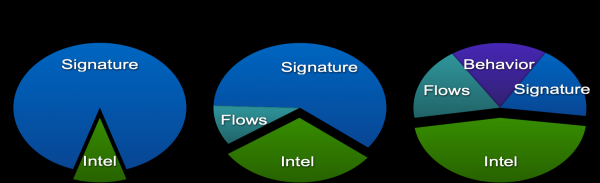
Jeg har bevidst ikke berørt emnet om reaktion på identificerede anomalier eller trusler i netværksflow, men jeg tror, det er klart, at overvågning ikke bør stoppe ved blot at opdage en trussel. Der bør følge en reaktion, helst i en automatisk eller automatiseret tilstand. Men det er allerede emnet for separate materiale.
Yderligere information:
P.S. Hvis det er lettere for dig at opfatte alt, hvad der er skrevet ovenfor, så kan du se en times præsentation, som dannede grundlaget for denne note.

Kilde: habr.com
