

I løbet af sine år har Pinterest haft 300 millioner brugere, som har oprettet over 200 milliarder pins på mere end 4 milliarder boards. For at betjene denne hær af brugere og den omfattende indholdsbasis har platformen udviklet tusindvis af tjenester, lige fra mikrotjenester, som kan løses af et par CPU'er, til enorme monolitter, der kører på en hel flåde af virtuelle maskiner. Og nu er tiden kommet, hvor virksomhedens blik er faldet på k8s. Hvad har 'kuben' der tiltalte 'Pinterest'? Det kan du finde ud af i vores oversættelse af den friske artikel fra .
Så, hundrede millioner brugere og hundrede milliarder pins. For at betjene denne hær af brugere og den omfattende indholdsbasis, har vi udviklet tusindvis af tjenester, lige fra mikrotjenester, som kan løses af et par CPU'er, til enorme monolitter, der kører på en hel flåde af virtuelle maskiner. Derudover har vi forskellige rammer, der også kan kræve CPU-ressourcer, hukommelse eller adgang til I/O-operationer.
Under vedligeholdelsen af denne zoologiske have af værktøjer står udviklingsteamet over for en række problemer:
- Ingeniørerne har ikke en ensartet måde at starte et arbejdsmiljø på. Stateless-tjenester, stateful-tjenester og projekter under aktiv udvikling er baseret på fuldstændig forskellige teknologiske stakke. Dette har ført til oprettelsen af et fuldt træningskursus for ingeniørerne og komplicerer betydeligt arbejdet for vores infrastrukturteam.
- Udviklere, der har deres eget udvalg af virtuelle maskiner, skaber enorm belastning på de interne administratorer. Resultatet er, at selv simple operationer som opdatering af OS eller AMI strækker sig over uger og måneder. Dette fører til en stigende belastning i, tilsyneladende, fuldstændig dagligdags situationer.
- Udfordringer med at skabe globale infrastrukturv administreringsværktøjer oven på allerede eksisterende løsninger. Situationen kompliceres desuden af, at det er svært at finde ejere af de virtuelle maskiner. Det betyder, at vi ikke ved, om vi sikkert kan udnytte disse ressourcer til at arbejde på andre dele af vores infrastruktur.
Containeriseringssystemer til orkestrering er en måde at standardisere håndteringen af arbejdsbelastninger på. De åbner vejen for hurtigere udvikling og forenkler administrationen af infrastrukturen, da alle ressourcer involveret i projektet styres af et centralt system.
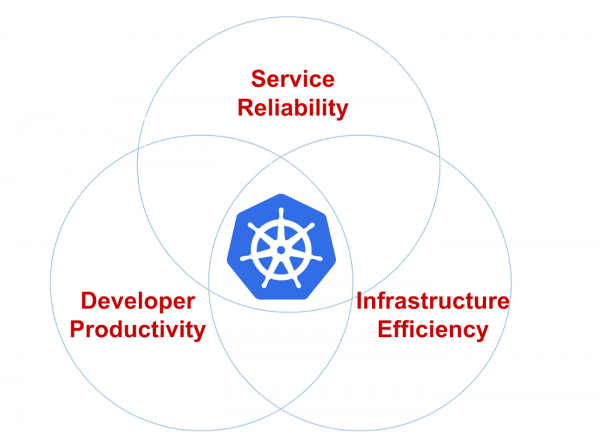
Figur 1: Infrastruktursprioriteter (pålidelighed, udvikleres ydeevne og effektivitet).
Cloud Management Platform-teamet hos Pinterest stødte på K8s i 2017. I første halvdel af 2017 dokumenterede vi størstedelen af vores produktionskapacitet, herunder API'er og alle vores webservere. Derefter gennemførte vi en grundig evaluering af forskellige systemer til containerorkestrering, clusteropbygning og drift. I slutningen af 2017 besluttede vi os for at tage Kubernetes i brug. Det var tilstrækkeligt fleksibelt og havde stor støtte i udviklingssamfundet.
På nuværende tidspunkt har vi skabt vores egne værktøjer til primær opstart af klyngen baseret på Kops og flyttet eksisterende infrastrukturelle komponenter som netværk, sikkerhed, metrics, logning, identitetshåndtering og trafik til Kubernetes. Vi har også implementeret et belastningssimuleringssystem til vores ressource, hvis kompleksitet er skjult for udviklerne. Vi fokuserer nu på at sikre stabilitet i klyngen, dens skalering og tilslutning af nye kunder.
Kubernetes: Pinterest's vej
At implementere Kubernetes i stor skala hos Pinterest som en platform, der vil blive elsket af vores ingeniører, medførte mange udfordringer.
Som en stor virksomhed har vi investeret betydeligt i infrastrukturelle værktøjer. Eksempler inkluderer sikkerhedsværktøjer, der håndterer certifikater og distribuerer nøgler, trafikstyringskomponenter, serviceopdagelsessystemer, synligheds- og loggingssystemer. Alt dette blev bygget op af en grund: Vi har gennemgået en normal proces med prøvelser og fejl, og derfor ønskede vi at integrere alt dette ind i den nye infrastruktur på Kubernetes i stedet for at opfinde den gamle cykel igen på en ny platform. Denne tilgang har overordnet set forenklet migreringen, da al applikationssupport allerede eksisterer og ikke skal opbygges fra bunden.
På den anden side er der ikke tilstrækkeligt med modeller til belastningsprognoser i selve Kubernetes (for eksempel deployment, jobs og Daemon sets) til vores projekt. Disse brugervenlighedsproblemer udgør enorme forhindringer for overgangen til Kubernetes. For eksempel har vi hørt udviklere af tjenester klage over manglende eller forkert konfiguration af indgange. Vi har også oplevet forkert brug af templating, hvor der blev oprettet hundrede kopier med samme specifikation og opgave, hvilket førte til mareridtslignende debug-problemer.
Det var også meget vanskeligt at understøtte forskellige versioner i den samme klynge. Forestil dig kompleksiteten ved kundesupport, når du skal arbejde med mange versioner af det samme runtime-miljø, med alle deres problemer, bugs og opdateringer.
Pinterest-brugerressourcer og -controllere
For at lette vores ingeniørers implementeringsproces af Kubernetes og forenkle infrastrukturen samt øge dens ydeevne, har vi udviklet vores egne definitioner af brugerressourcer (CRD).
CRD tilbyder følgende funktionaliteter:
- Sammenfletning af forskellige native Kubernetes-ressourcer, så de fungerer som en samlet belastning. For eksempel inkluderer ressourcen PinterestService deployment, indgangstjeneste og konfigurationskort. Dette gør det muligt for udviklere ikke at bekymre sig om DNS-konfiguration.
- Implementering af nødvendig applikationsunderstøttelse. Brugeren skal kun fokusere på specifikationen af containeren i henhold til sin forretningslogik, mens CRD-controlleren implementerer alle nødvendige init-containere, miljøvariabler og pod-specifikationer. Dette sikrer et fundamentalt anderledes niveau af komfort for udviklerne.
- CRD-controllere styrer også livscyklussen for de egne ressourcer og øger tilgængeligheden af debugging. Dette inkluderer afstemning af ønskede og faktiske specifikationer, opdatering af CRD-status og logføring af hændelser og meget mere. Uden CRD ville udviklere blive nødt til at administrere en omfattende mængde ressourcer, hvilket blot ville øge sandsynligheden for fejl.
Her er et eksempel på PinterestService og den interne ressource, der styres af vores controller:
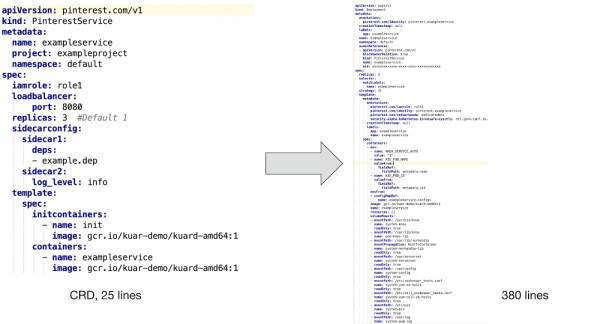
Som nævnt ovenfor, for at understøtte den brugerdefinerede container, er det nødvendigt at integrere den med en initialiseringscontainer og flere tilføjelser for at sikre sikkerhed, synlighed og håndtering af netværkstrafik. Derudover har vi oprettet skabeloner til konfigurationskort og implementeret understøttelse af PVC-skabeloner til batchopgaver, samt trackning af mange miljøvariabler for at overvåge identifikation, ressourceforbrug og affaldssamling.
Det er svært at forestille sig, at udviklere ville ønske at skrive disse konfigurationsfiler manuelt uden understøttelse fra CRD, for slet ikke at tale om videre støtte og fejlfinding af konfigurationerne.
Workflow til deployment af applikationer
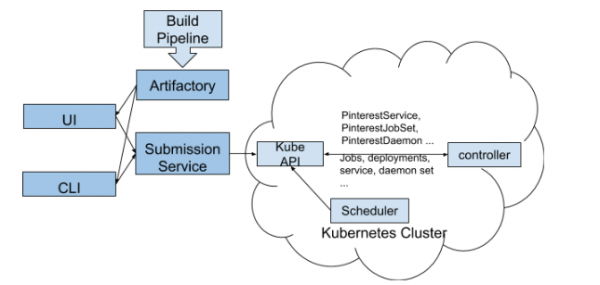
Illustrationen ovenfor viser, hvordan man deployer en brugerdefineret ressource Pinterest i et Kubernetes-kluster:
- Udviklere interagerer med vores Kubernetes-kluster via CLI og brugergrænsefladen.
- CLI / UI-værktøjerne henter YAML-filer for workflow-konfiguration og andre byggeegenskaber (den samme versionsidentifikation) fra Artifactory, hvorefter de sender dem til Job Submission Service. Dette skridt sikrer, at kun fungerende versioner bliver leveret til klusteret.
- JSS fungerer som en gateway for forskellige platforme, herunder Kubernetes. Her sker brugergodkendelse, tildeling af kvoter og delvis konfiguration af vores CRD.
- Efter validering af CRD på JSS-siden sendes informationen til k8s-platformens API.
- Vores CRD-controller overvåger begivenheder på alle brugerdefinerede ressourcer. Den konverterer CR til native k8s-ressourcer, tilføjer nødvendige moduler, sætter relevante miljøvariabler og udfører andre støtteopgaver, hvilket sikrer tilstrækkelig infrastrukturunderstøttelse for de containerbaserede brugerdefinerede applikationer.
- Derefter videregiver CRD-controlleren de indsamlede data til Kubernetes API, så de kan behandles af scheduler og køres.
Bemærk: dette præ-releases workflow for deployment blev oprettet til de første brugere af den nye k8s-platform. Vi er nu i gang med at forbedre denne proces for fuldt ud at integrere os med vores nye CI/CD. Det betyder, at vi ikke kan dele alt relateret til Kubernetes. Vi ser frem til at dele vores erfaringer og fortælle om teamets fremskridt i denne retning i vores næste blogindlæg "Building a CI/CD platform for Pinterest".
Typer af specialressourcer
Baseret på de specifikke behov fra Pinterest har vi udviklet følgende CRD'er, der passer til forskellige arbejdsprocesser:
- PinterestService er allerede etablerede stateless tjenester. Mange af vores kerne-systemer er bygget på et sæt af sådanne tjenester.
- PinterestJobSet modellerer komplette batch-job. I Pinterest er der et almindeligt scenarie, hvor flere job kører de samme containere parallelt, uafhængigt af andre lignende processer.
- PinterestCronJob anvendes ofte i forbindelse med små periodiske belastninger. Det er en wrapper til den native cron-implementering med supportmekanismer fra Pinterest til sikkerhed, trafik, logs og metrics.
- PinterestDaemon omfatter infrastruktur-dæmoner. Denne familie fortsætter med at vokse, efterhånden som vi tilføjer mere support til vores klynger.
- PinterestTrainingJob dækker processen for Tensorflow og Pytorch og sikrer det samme niveau af support under drift som alle andre CRD'er. Da Pinterest aktivt bruger Tensorflow og andre systemer til maskinlæring, var der grund til at opbygge en separat CRD omkring dem.
Vi arbejder også på PinterestStatefulSet, som snart vil blive tilpasset til datalagre og andre stateful-systemer.
Support for kørsel miljø
Når en applikationsmodul starter op i Kubernetes, modtager den automatisk et certifikat for at identificere sig selv. Dette certifikat bruges til at få adgang til den hemmelige opbevaring eller til at kommunikere med andre tjenester via mTLS. I mellemtiden vil konfigurationen til containerinitialisering og dæmonen indlæse alle nødvendige afhængigheder inden opstarten af containerapplikationen. Når alt er klar, registrerer sidecar og dæmonen modulens IP-adresse i vores Zookeeper, så kunderne kan opdage den. Alt dette fungerer, da netmodulet blev konfigureret, inden applikationen blev startet.
Ovenstående er typiske eksempler på support til arbejdsbelastninger under kørsel. For andre typer arbejdsbelastninger kan der være behov for lidt anderledes support, men alle præsenteres som pod-niveau sidecar, node- eller VM-niveau dæmoner. Vi sikrer, at alt dette implementeres som en del af den styrende infrastruktur og er koordineret mellem applikationerne, hvilket i sidste ende markant reducerer belastningen i forhold til teknisk arbejde og kundesupport.
Test og QA
Vi har samlet en end-to-end testpipeline oven på den eksisterende testinfrastruktur i Kubernetes. Disse tests strækker sig over alle vores klynger. Vores pipeline har gennemgået mange omarbejder, før den blev en del af produktklyngen.
Udover testsystemer har vi overvågnings- og varslingssystemer, der konstant holder øje med systemkomponenternes tilstand, ressourceforbrug og andre vigtige metrics, og de varsler os kun, når der er behov for menneskelig indgriben.
Alternativer
Vi har overvejet nogle alternativer til brugerdefinerede ressourcer, såsom mutationsadgangskontrollere og skabelonsystemer. Men alle disse indebærer betydelige driftsudfordringer, så vi valgte vejen med CRD.
Mutationsadgangskontrolleren blev brugt til at indføre sidecars, miljøvariabler og anden support under kørsel. Dog støder den på forskellige problemer, for eksempel med ressourcebinding og styring af deres livscyklus, hvilket ikke opstår med CRD.
Bemærk: Skabelonsystemer, såsom Helm-diagrammer, anvendes også bredt til at lancere applikationer med lignende konfigurationer. Dog er vores arbejdsapplikationer for forskellige til at blive styret med skabeloner. Derudover vil der opstå for mange fejl under kontinuerlig implementering ved brug af skabeloner.
Kommende arbejde
Vi håndterer i øjeblikket en blandet belastning på alle vores klynger. For at understøtte sådanne processer af forskellige typer og størrelser arbejder vi i følgende retninger:
- Klyngesamlingen distribuerer store applikationer på tværs af forskellige klynger for at sikre skalerbarhed og stabilitet.
- Sikring af stabilitet, skalerbarhed og synlighed af klyngen for at etablere forbindelsen mellem applikationen og dens SLA.
- Resource- og kvoteadministration, så applikationer ikke konflikter med hinanden, og skalaen af klyngen kontrolleres fra vores side.
- Ny CI/CD-platform til support og implementering af applikationer i Kubernetes.
Kilde: habr.com
