

Kilde:
Lineær regression er en af de grundlæggende algoritmer inden for mange områder relateret til dataanalyse. Årsagen hertil er åbenlys. Det er en meget simpel og forståelig algoritme, hvilket gør den bredt anvendelig i mange årtier, hvis ikke hundreder, nu. Ideen er, at vi antager en lineær afhængighed af én variabel fra et sæt af andre variable, og derefter forsøger vi at genskabe denne afhængighed.
Men i denne artikel vil vi ikke fokusere på anvendelsen af lineær regression til løsning af praktiske opgaver. Her vil vi se på interessante egenskaber ved implementeringen af distribuerede algoritmer til dens genskabelse, som vi stødte på, da vi skrev en maskinlæringsmodul i . Noget grundlæggende matematik, grundlæggende maskinlæringsprincipper og distribueret computing vil hjælpe med at forstå, hvordan man kan genskabe lineær regression, selvom dataene er fordelt mellem tusindvis af noder.
Hvad handler det om?
Vi står over for opgaven at genskabe den lineære afhængighed. Som inputdata gives et sæt vektorer af formodede uafhængige variable, hvor hver af dem svarer til en værdi af den afhængige variabel. Disse data kan repræsenteres som to matricer:

Nu, da der antages en afhængighed, og det er en lineær en, lad os skrive vores antagelse som et matrixprodukt (for at forenkle notationen antages det her og fremad, at den frie led i ligningen er skjult bag  , og den sidste kolonne i matricen
 indeholder etere):

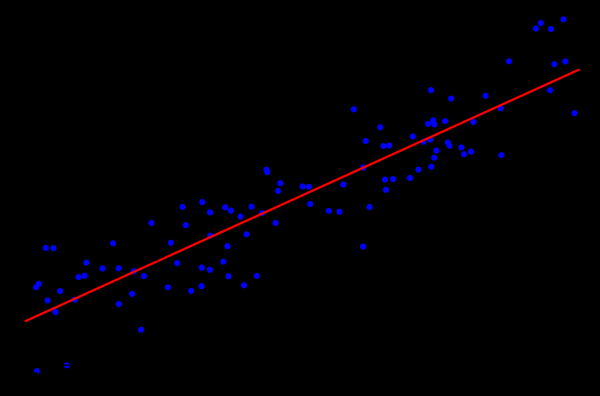
Det ligner meget et system af lineære ligninger, gør det ikke? Det ligner, men sådant et system af ligninger vil sandsynligvis ikke have nogen løsninger. Årsagen til dette er støj, der praktisk talt findes i alle virkelige data. En anden årsag kan være fraværet af en lineær afhængighed som sådan, som man kan forsøge at tackle ved at indføre yderligere variable, der ikke-lineært afhænger af de oprindelige. Lad os overveje følgende eksempel:
Kilde:
Dette er et simpelt eksempel på lineær regression, der viser afhængigheden af én variabel (på aksen  ) fra en anden variabel (på aksen
 ). For the system of linear equations to have a solution, all points must lie exactly on one line. But this is not the case. They do not lie on one line precisely because of noise (or because the assumption of linear dependence was incorrect). Thus, to recover linear dependence from real data, it is usually necessary to introduce one more assumption: the input data contains noise and this noise has . Other types of noise distributions can also be assumed, but in the overwhelming majority of cases, it is specifically the normal distribution that is considered, which will be discussed further.
Maximum likelihood-metoden
So, we have assumed the presence of randomly normally distributed noise. What should we do in this situation? Mathematics has a widely used approach for this. . In short, it involves selecting and subsequently maximizing it.
Returning to the restoration of linear dependence from data with normal noise, note that the presumed linear dependence represents the mathematical expectation  of the existing normal distribution. At the same time, the probability that
 takes a certain value, given the presence of observed
 , looks as follows:

Now, let's substitute the necessary variables instead of  og
 :

We only need to find the vector  , for which this probability is maximized. To maximize such a function, it is convenient to first logarithm it (the logarithm of the function will reach its maximum at the same point as the function itself):

Which, in turn, reduces to minimizing the following function:

By the way, this is called the method of . Often, all of the above reasoning is omitted, and this method is simply used.
QR decomposition
The minimum of the above function can be found by locating the point at which the gradient of this function is zero. The gradient will be written as follows:

is a matrix method for solving the minimization problem used in the least squares method. In this regard, let's rewrite the equation in matrix form:

Thus, we decompose the matrix  into matrices
 og
 og udfører en række transformationer (selve QR-faktoriseringen vil ikke blive diskuteret her, kun dens anvendelse i forhold til den stillede opgave):

Matrix  er ortogonal. Dette giver os mulighed for at undgå produktet
 :

Og hvis vi erstatter  og få en fungerende kommando.
 , så får vi
 . I betragtning af at
 er en øverste trekantet matrix, ser det således ud:

Det kan løses ved substitutionsmetoden. Elementet  er fundet som
 , det forrige element
 er fundet som
 og så videre.
Her skal det bemærkes, at kompleksiteten af den resulterende algoritme ved brug af QR-faktorisering er lig med  . Selvom matrixmultiplikation kan parallelliseres godt, er det ikke muligt at skrive en effektiv distribueret version af denne algoritme.
Gradientfald
Når man taler om optimering af en given funktion, er det altid værd at huske metoden for (stochastic) gradientfald. Det er en simpel og effektiv metode til at minimere, baseret på iterativ beregning af gradienten af funktionen på et punkt og derefter flytning i retning modsat gradienten. Hvert sådant skridt bringer løsningen tættere på minimum. Gradientet ser dermed stadig sådan ud:

Denne metode kan desuden lettet parallelliseres og distribueres takket være de lineære egenskaber ved gradientoperatoren. Bemærk, at de uafhængige led i summen er indeholdt i formlen ovenfor. Med andre ord kan vi beregne gradienten uafhængigt for alle indekser  fra den første til
 , samtidig med dette kan vi beregne gradienten for indekserne fra
 op til
 . Derefter kan de opnåede gradienter lægges sammen. Resultatet af summen vil være det samme, som hvis vi havde beregnet gradienten med det samme for indekserne fra den første til
 . Dermed, hvis dataene er fordelt mellem flere datadelinger, kan gradienten beregnes uafhængigt på hver del, og derefter kan resultaterne af disse beregninger summeres for at opnå det endelige resultat:

Set fra implementeringssynspunktet falder dette ind under paradigmet . I hvert skridt af gradientfaldet sendes der en opgave til hver dataknode for at beregne gradienten, derefter samles de beregnede gradienter, og resultatet af deres summation bruges til at forbedre resultatet.
På trods af den enkle implementering og muligheden for at udføre i MapReduce-paradigmet har gradientfaldet også sine ulemper. Især er antallet af skridt, der kræves for at nå konvergens, betydeligt højere sammenlignet med andre, mere specialiserede metoder.
LSQR
er endnu en metode til at løse det stillede problem, der er velegnet til både genopbygning af lineær regression og løsning af systemer af lineære ligninger. Dens hovedkarakteristika er, at den kombinerer fordelene fra matrixmetoder og den iterative tilgang. Implementeringer af denne metode kan findes i biblioteket . Vi kan gøre dette, da vi har ledige porte (eller vi frigør dem på forhånd) i switchene . Beskrivelsen af denne metode vil ikke blive præsenteret her (den kan findes i artiklen ). I stedet vil der blive vist en tilgang til at tilpasse LSQR til udførelse i et distribueret miljø.
Kernen i LSQR-metoden er . Dette er en iterativ procedure, hvor hver iteration består af følgende trin:
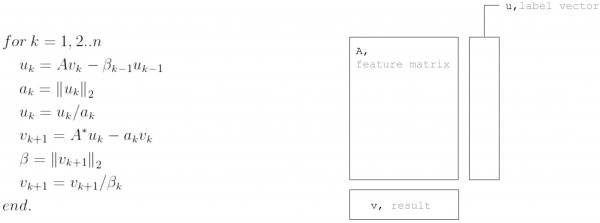
Men hvis vi antager, at matrixen er vandret partitioneret, kan hver iteration præsenteres som to MapReduce-trin. På denne måde lykkes det at minimere datasendinger under hver iteration (kun vektorer med længde svarende til antallet af ukendte):  Netop denne tilgang anvendes ved implementeringen af lineær regression i
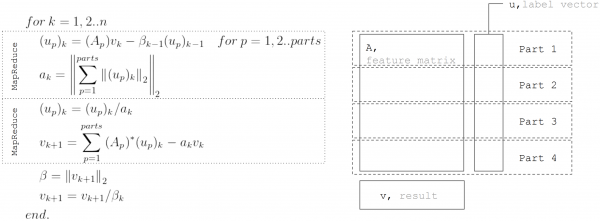
Apache Ignite ML .
Konklusion
Beta-versionen af Vivaldi-browseren er tilgængelig til Android
Kilde: habr.com
