

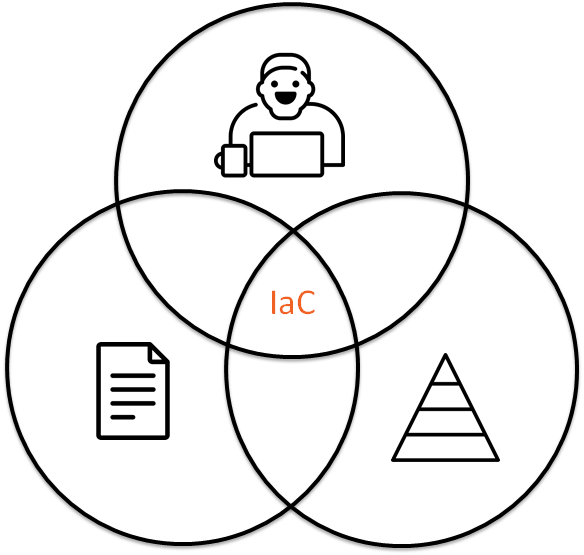
Tilgang IaC (Infrastructure as Code) består ikke kun af koden, der opbevares i et repository, men også af de mennesker og processer, der omkranser denne kode. Kan vi genbruge tilgange fra softwareudvikling i forvaltningen og beskrivelsen af infrastruktur? Det vil ikke være skadelig at holde denne idé i tankerne, mens du læser artiklen.
Dette er en transkription af mit og få en fungerende kommando. .
Slides og videoer
- Dry run 2019-04-24
Infrastructure as bash history
Lad os antage, at du kommer til et nyt projekt, og de siger til dig: «vi har Infrastructure as Code«. I virkeligheden viser det sig, Infrastructure as bash history eller for eksempel Documentation as bash history. Dette er en helt reel situation, for eksempel blev en lignende sag beskrevet af Denis Lysenko i sit foredrag , han fortalte om, hvordan de fik en velordnet infrastruktur på projektet ud af bash-historik.
Med lidt vilje kan man sige, at Infrastructure as bash history det er ligesom kode:
- reproducerbarhed: du kan tage bash-historik, udføre kommandoerne derfra, og måske, forresten, vil du få en fungerende konfiguration som resultat.
- versionskontrol: du ved, hvem der har været inde og hvad de har gjort, igen, ikke sikkert at dette fører dig til en fungerende konfiguration som resultat.
- om VPN-udbyderen UFO, der havde en offentligt tilgængelig Elasticsearch-database på 894 GB. Udbyderen præsenterede sig selv som en, der tager hensyn til brugernes privatliv og ikke fører logfiler. På trods af denne påstand indeholdt den eksponerede database logfiler, der inkluderede oplysninger om IP-adresser, sessioner knyttet til tid, placeringstags, oplysninger om operativsystemet og brugerens enhed, samt lister over domæner til reklamesubstitution i usikret HTTP-trafik. Endda var der adgangskoder i klartekst og sessionstokens, der muliggør dekryptering af opsnappede sessioner i databasen.: historien om hvem og hvad der blev gjort. kun vil du ikke kunne bruge den, hvis du mister serveren.
Hvad skal vi så gøre?
Infrastructure as Code
Selv sådan en mærkelig situation som Infrastructure as bash history kan trækkes ind med kraft til Infrastructure as Code, men når vi ønsker at gøre noget mere komplekst end den gamle gode LAMP-server, vil vi komme til den indsigt, at denne kode skal på en eller anden måde modifiseres, ændres, forbedres. Herefter vil vi se på parallellerne mellem Infrastructure as Code og softwareudvikling.
D.R.Y.
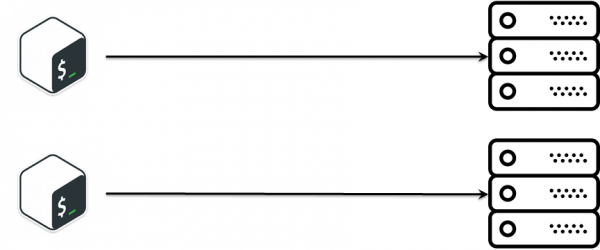
På et projekt om udvikling af storage controller, var der en delopgave : vi udgiver en ny version - den skal rulles ud til videre test. Opgaven er yderst simpel:
- gå ind her via ssh og udfør kommandoen.
- kopier filen derhen.
- ret konfigurationen her.
- start tjenesten der
- …
- PROFIT!
Til den beskrevne logik er bash mere end tilstrækkeligt, især i de tidlige faser af projektet, når det lige er startet. Det er , men med tiden opstår der behov for at udvikle noget lignende, men en smule anderledes. Det første, der falder i tankerne: copy-paste. Og nu har vi allerede to meget lignende scripts, der næsten gør det samme. Med tiden voksede antallet af scripts, og vi stødte på et problem med, at der er en bestemt forretningslogik for implementeringen, som skal synkroniseres mellem de forskellige scripts, og det er ret udfordrende.
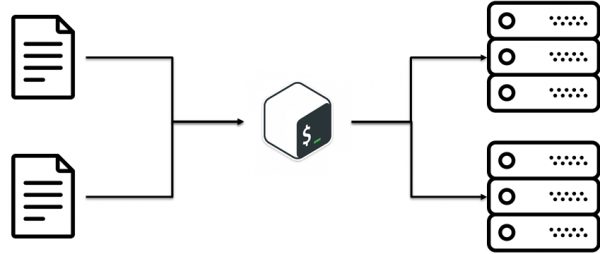
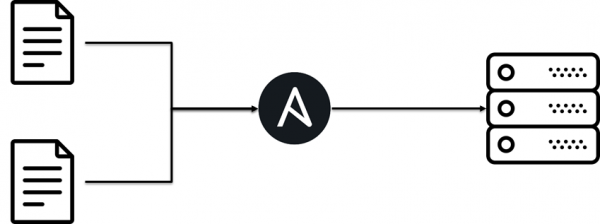
Det viser sig, at der er en praksis kaldet D.R.Y. (Do not Repeat Yourself). Ideen er at genbruge eksisterende kode. Det lyder simpelt, men vi kom ikke til denne konklusion med det samme. I vores tilfælde var det en grundlæggende idé: adskille konfigurationer fra scripts. Det vil sige, at forretningslogikken for implementeringen er adskilt, konfigurationer er adskilt.
S.O.L.I.D. for CFM
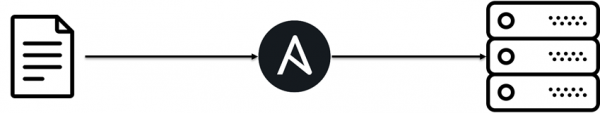
Med tiden voksede projektet, og for Ansible at komme til. Den primære årsag til dens opståen var, at vi allerede havde ekspertise i teamet, og at bash ikke er designet til kompleks logik. Ansible begyndte også at indeholde kompleks logik. For at den komplekse logik ikke skulle blive til kaos, eksisterer der i softwareudvikling principper for organisering af kode. S.O.L.I.D. For eksempel nævnte Grigory Petrov i sin præsentation "Hvorfor en IT-specialist har brug for et personligt brand" spørgsmålet, at mennesker er sådan indrettet, at det er lettere for dem at operere med sociale enheder; i softwareudvikling er det objekter. Hvis man kombinerer disse to ideer og fortsætter med at udvikle dem, kan man også observere, at beskrivelsen af infrastruktur kan bruge S.O.L.I.D. for at gøre det lettere at vedligeholde og modificere denne logik fremadrettet.
The Single Responsibility Principle
Hver klasse udfører kun én opgave.
Man skal ikke blande kode og lave monolitiske, guddommelige spaghetti-monstre. Infrastrukturen bør bestå af enkle klodser. Det viser sig, at hvis man opdeler Ansible playbook i små bidder, læs Ansible roller, bliver det nemmere at vedligeholde dem.
The Open Closed Principle
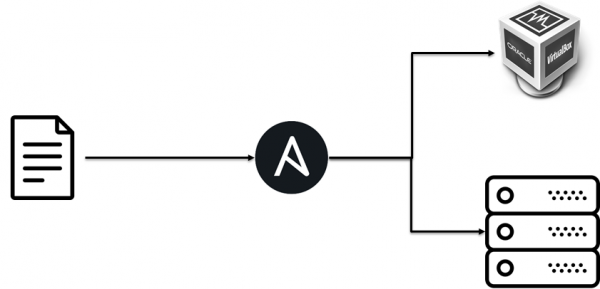
Princippet om åbenhed/lukkethed.
- Åbne for udvidelse: betyder, at adfærden af en enhed kan udvides ved at oprette nye typer enheder.
- Lukket for ændringer: som følge af udvidelsen af enheds adfærd må der ikke foretages ændringer i koden, der bruger disse enheder.
Oprindeligt etablerede vi testinfrastruktur på virtuelle maskiner, men da forretningslogikken for opstillingen var adskilt fra implementeringen, kunne vi problemfrit tilføje udrulning på bare metal.
Liskov Substitution Principle
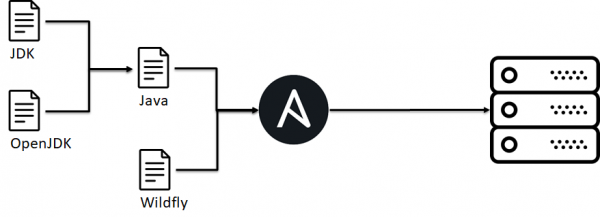
Liskovs substitutionsprincip. Objekter i programmet skal kunne erstattes med instanser af deres underklasser uden at ændre programmets korrekthed.
Hvis man ser bredere på det, så er det ikke en egenskab ved et specifikt projekt, som kan anvendes. S.O.L.I.D., det handler generelt om CFM, for eksempel i et andet projekt skal man udrulle en klargjort Java-applikation over forskellige Java-applikationsservere, databaser, operativsystemer osv. På dette eksempel vil jeg overveje de videre principper. S.O.L.I.D.
I vores tilfælde er der i infrastrukturen en aftale om, at hvis vi har installeret rollen imbjava eller oraclejava, så har vi en binær eksekverbar fil java. Dette er nødvendigt, da de overordnede roller er afhængige af denne adfærd, de forventer tilstedeværelsen af java. Samtidig giver det os mulighed for at erstatte en implementering/version af java med en anden uden at ændre logikken i applikationens udrulning.
Problemet her ligger i, at det ikke kan realiseres i Ansible, som følge heraf opstår der nogle aftaler inden for teamet.
Interface Segregation Principle
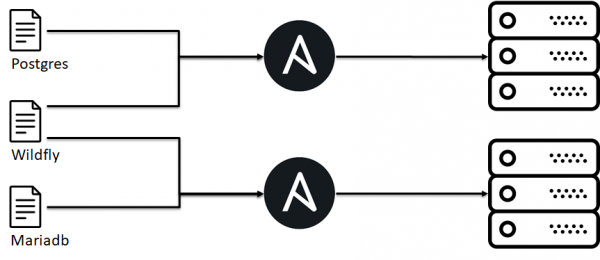
Princippet om interface-segregering: 'mange interfaces, der er specielt designet til kunder, er bedre end et generelt interface.'
Oprindeligt forsøgte vi at samle al variabilitet i udrulningen af applikationen i én Ansible playbook, men det var svært at vedligeholde, og den tilgang, hvor vi har et specificeret interface udadtil (kunden forventer port 443), gør det muligt at komponere infrastrukturen ud fra separate byggeklodser til en specifik implementering.
Dependency Inversion Principle
Princippet om inversionsafhængighed. Moduler af højere niveau må ikke afhænge af moduler af lavere niveau. Begge typer moduler skal afhænge af abstraktioner. Abstraktioner må ikke afhænge af detaljer. Detaljer skal afhænge af abstraktioner.
Her vil eksemplet være baseret på et antipattern.
- En af vores kunder havde en privat sky.
- Inden i skyen bestilte vi virtuelle maskiner.
- Men på grund af skyens specifikationer var udrulning af applikationen bundet til, hvilken hypervisor VM'en landede på.
Det vil sige, at den højniveau logik til implementering af applikationen, afhængigheder, blev overført til de underliggende niveauer af hypervisoren, og det betød problemer ved genbrug af denne logik. Lad vær med det.
Interaktion
Infrastruktur som kode handler ikke kun om kode, men også om forholdet mellem kode og mennesker, om interaktionen mellem infrastrukturudviklere.
Bus faktor
Lad os antage, at der er en person ved navn Vasja på dit projekt. Vasja ved alt om din infrastruktur; hvad vil der ske, hvis Vasja pludselig forsvinder? Det er en ganske reel situation, for han kan blive kørt over af en bus. Sådanne ting sker. Hvis det sker, og viden om koden, dens struktur, hvordan den fungerer, brugernavne og adgangskoder ikke er fordelt i teamet, kan det føre til en række ubehagelige situationer. For at minimere disse risici og fordele viden inden for teamet kan forskellige tilgange anvendes.
Pair Devopsing
Det er ikke sådan , hvor administratorer drikker øl, ændrer adgangskoder, mens det er en analogi til parprogrammering. Det vil sige, at to ingeniører sætter sig ved én computer, én tastatur og begynder sammen at konfigurere din infrastruktur: indstille serveren, skrive en Ansible-rolle osv. Det lyder godt, men det fungerede ikke for os. Men nogle specifikke tilfælde af denne praksis fungerede. En ny medarbejder kom, hans mentor tog sammen med ham en reel opgave, arbejde — overførte viden.
Et andet specifikt tilfælde er incident call. Under et problem samles en gruppe beredskabsfolk og involverede, en leder udpeges, som deler sin skærm og formidler sine tanker. De andre deltagere følger lederens tankegang, kigger på tricks i konsollen, tjekker om der er noget der er overset i loggen, og lærer noget nyt om systemet. Denne tilgang har fungeret bedre end ikke.
Code Review
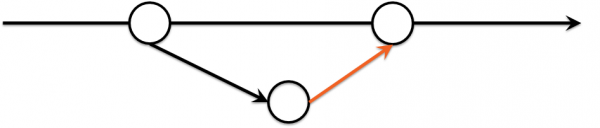
Subjektivt set er den mest effektive måde at sprede viden om infrastrukturen og dens opbygning gået gennem code review:
- Infrastrukturen er beskrevet i kode i et repository.
- Ændringer finder sted i en separat gren.
- Ved en merge request kan man se forskellen i ændringerne til infrastrukturen.
Det der gjorde det særligt her var, at anmeldere blev valgt skiftevis, efter en tidsplan, så med en vis sandsynlighed ville du komme ind i et nyt område af infrastrukturen.
Kodedesign
Over time, there started to be conflicts during reviews, as reviewers had their own styles and the rotation of reviewers stacked them with different styles: 2 spaces or 4, camelCase or snake_case. Implementing this was not immediate.
- The initial idea was to recommend using a linter, after all, engineers are smart. But different editors and operating systems made it inconvenient.
- This evolved into a bot that would message problematic commits in Slack and attach the linter output. However, in most cases, more important tasks were found, and the code remained uncorrected.
Green Build Master
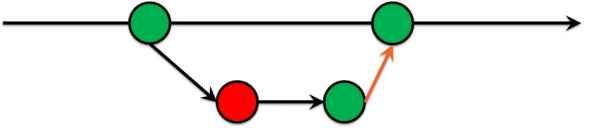
Time goes by, and we came to the point where we could not allow commits into the master that did not pass certain tests. Voilà! We invented the Green Build Master, which has long been practiced in software development:
- Development occurs in a separate branch.
- Tests are run on that branch.
- If the tests do not pass, then the code will not enter the master.
Making this decision was quite painful, as it caused many disputes, but it was worth it, as merge requests began to come to the review without style disagreements, and over time the number of problematic areas decreased.
IaC Testing
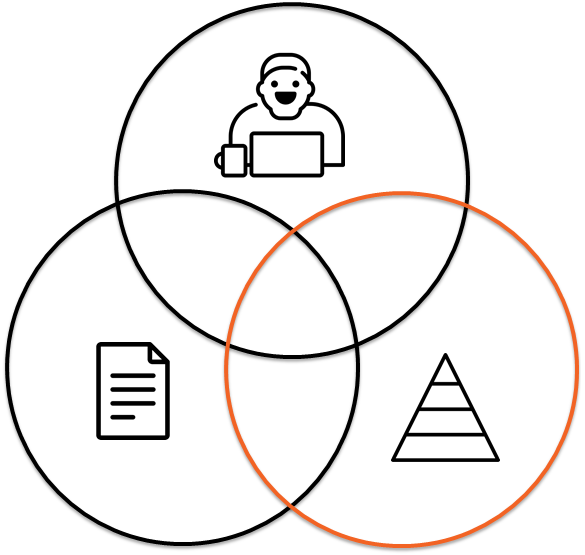
In addition to style checks, other things can be used, for example, to check that your infrastructure can indeed be deployed. Or to verify that changes in the infrastructure will not lead to a financial loss. Why might this be necessary? It’s a complex and philosophical question, better answered with a story: there was once an auto-scaler on Powershell that did not check edge conditions => it created more VMs than needed => the client spent more money than planned. Not pleasant, but this mistake could have been caught at an earlier stage.
One might ask, why make complex infrastructure even more complicated? Tests for infrastructure, just like for code, are not about simplification, but about knowing how your infrastructure should work.
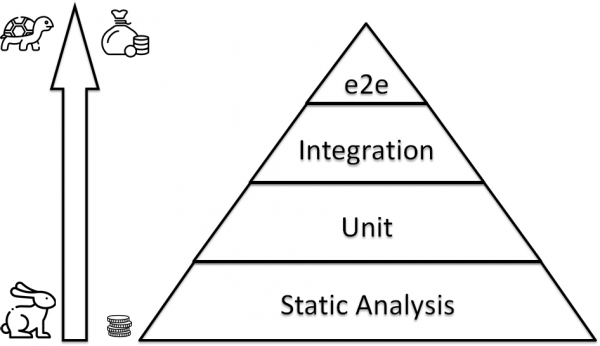
IaC Testing Pyramid
IaC Testing: Static Analysis
If you deploy the entire infrastructure at once and check that it works, it may turn out that it takes a lot of time and requires a lot of resources. Therefore, there should be something that works quickly, is extensive, and covers many primitive aspects.
Bash is tricky
Lad os tage et banalt eksempel. Vælg alle filer i den aktuelle mappe og kopier dem et andet sted. Det første, der falder en ind:
for i in * ; do
    cp $i /some/path/$i.bak
done
Men hvad hvis der er et mellemrum i filnavnet? Nå ja, vi er jo kloge, vi kan bruge citater:
for i in * ; do cp "$i" "/some/path/$i.bak" ; doneDygtige? Nej! Hvad hvis der ikke er noget i mappen, dvs. globbing virker ikke.
find . -type f -exec mv -v {} dst/{}.bak ;Er vi dygtige nu? Nej… Vi glemte, at der kan være n.
touch x
mv x "$(printf "foonbar")"
find . -type f -print0 | xargs -0 mv -t /path/to/target-dir
Statisk analyseværktøjer
Problemet fra det forrige trin kunne være fanget, når vi glemte citaterne; der findes mange værktøjer til dette. , der er mange af dem, og du kan sandsynligvis finde en linter til dit IDE til din stak.
Sprog
Værktøj
bash
Ruby
python
ansible
IaC Testning: Enhedstest
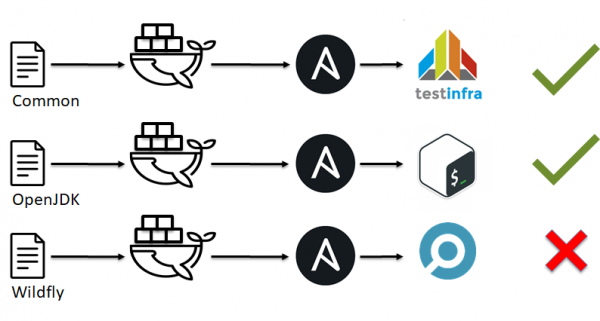
Som vi så fra det forrige eksempel, er linters ikke almægtige og kan ikke påpege alle problematiske steder. I analogi med testning i softwareudvikling kan vi huske på enhedstest. Her tænker vi straks på , , , . Men hvad med ansible, chef, saltstack og de lignende?
I starten talte vi om S.O.L.I.D. og at vores infrastruktur skal bestå af små mursten. De skal nu bruges.
- Infrastrukturen opdeles i små mursten, for eksempel Ansible-roller.
- Et eller andet miljø sættes op, hvad enten det er docker eller VM.
- Vi anvender vores Ansible-rolle på dette testmiljø.
- Vi kontrollerer, at alt fungerer, som vi forventer (kører testene).
- Vi afgør om det er okay eller ikke.
IaC Testning: Værktøjer til enhedstest
Spørgsmålet er, hvad der er tests for CFM? Man kan enkelt køre et script eller man kan bruge færdige løsninger til dette:
CFM
Værktøj
Ansible
Chef
Chef
saltstack
Et eksempel for testinfra, vi kontrollerer, at brugerne test1, test2 eksisterer og tilhører gruppen sshusers:
def test_default_users(host):
    users = ['test1', 'test2' ]
    for login in users:
        assert host.user(login).exists
        assert 'sshusers' in host.user(login).groups
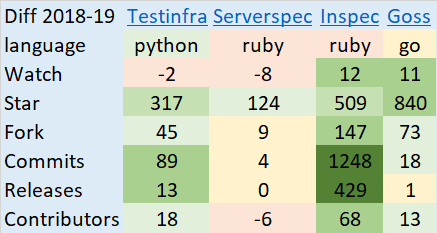
Hvad skal man vælge? Det er et svært og komplekst spørgsmål, her er et eksempel på ændringerne i projekter på Github i 2018-2019:
IaC Testning frameworks
Hvordan skal man samle det hele og køre det? Man kan hvis man har et tilstrækkeligt antal ingeniører. Eller man kan tage nogle færdige løsninger, men der er egentlig ikke mange:
CFM
Værktøj
Ansible
Chef
Terraform
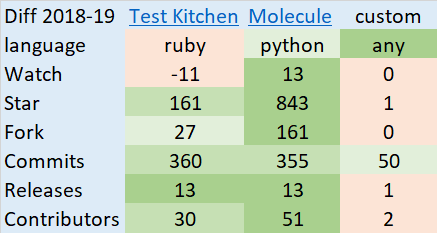
Et eksempel på ændringerne i projekter på Github i 2018-2019:
Molecule vs. Testkitchen
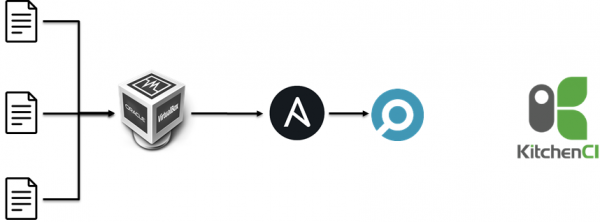
Oprindeligt :
- Opret VM i parallel.
- Anvend Ansible-roller.
- Køre inspec.
For 25-35 roller tog det 40-70 minutter, hvilket var lang tid.
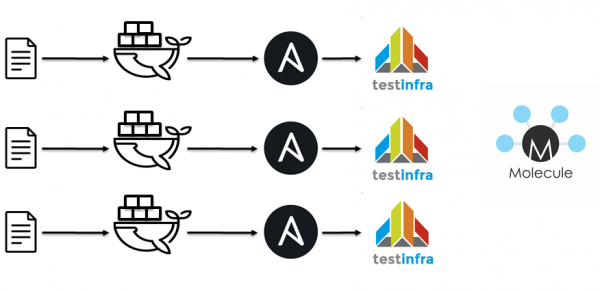
Næste skridt var at migrere til jenkins / docker / ansible / molecule. Ideologisk set er alt det samme.
- Linting playbooks.
- Linting roller.
- Starte container.
- Anvend Ansible-roller.
- Køre testinfra.
- Tjekke idempotens.
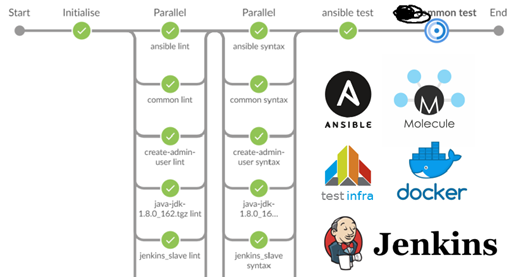
Linting for 40 roller og tests for et dusin tog omkring 15 minutter.
Hvad man vælger afhænger af mange faktorer som den anvendte stak, ekspertise i teamet osv. Her beslutter hver enkelt, hvordan man håndterer unit-testning.
IaC-test: Integrationstests.
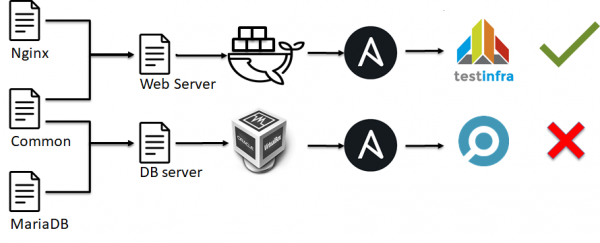
På den næste trin i testpyramiden optræder integrationstests. De ligner unit-tester:
- Infrastrukturen opdeles i små byggeklodser, såsom Ansible-roller.
- Et eller andet miljø sættes op, hvad enten det er docker eller VM.
- Denne testmiljø anvendes. mange Ansible-roller.
- Vi tjekker, at alt har fungeret, som vi forventede (kører tests).
- Vi afgør om det er okay eller ikke.
Groft sagt, vi tjekker ikke funktionaliteten af det enkelte element i systemet som i unit-tests; vi tjekker hvordan serveren er konfigureret som helhed.
IaC-test: End to End-tests.
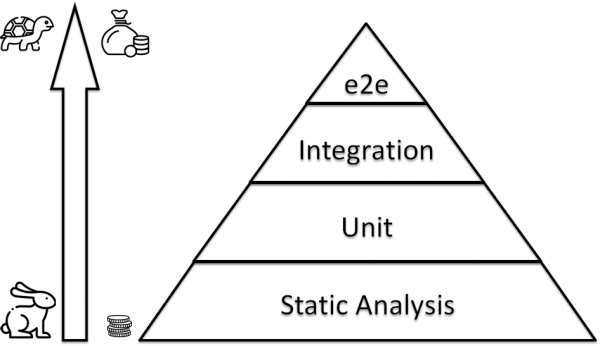
På toppen af pyramiden møder vi End to End-tests. Dvs. vi tjekker ikke funktionaliteten af en enkelt server, et enkelt script eller en enkelt byggeklods i vores infrastruktur. Vi tjekker, at mange servere, der er forenet, fungerer som forventet. Desværre har jeg ikke set færdige box-løsninger, sandsynligvis fordi infrastrukturen ofte er unik og det er svært at lave en skabelon og framework til testning. Som resultat skaber alle deres egne løsninger. Der er efterspørgsel, men ikke noget svar. Derfor vil jeg fortælle, hvad der findes, for at inspirere andre til sunde tanker eller påpege mig, hvis alt allerede er opfundet før os.
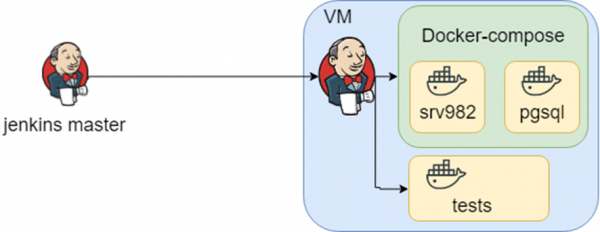
Projekt med en rig historie. Bruges i store organisationer, og sandsynligvis har hver af jer indirekte været i kontakt med det. Applikationen understøtter mange databaser, integrationer osv. Viden om, hvordan infrastrukturen kan se ud, inkluderer mange docker-compose filer, mens viden om, hvilke tests der skal køres i hvilket miljø, stammer fra jenkins.
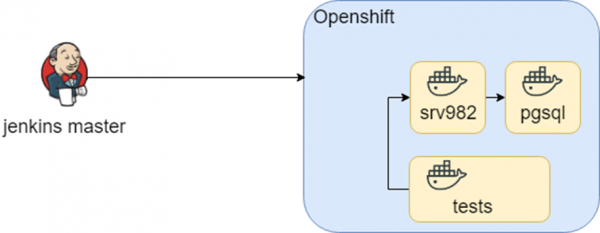
Denne ordning fungerede i lang tid, indtil vi forsøgte at flytte det til Openshift. Containerne forblev de samme, men kørselmiljøet ændrede sig (hej D.R.Y. igen).
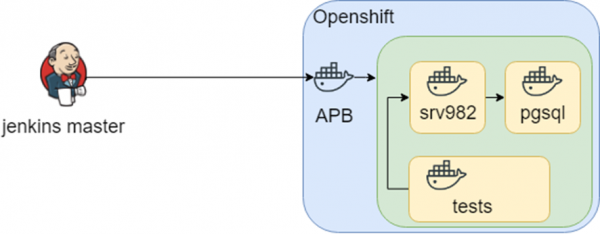
Forskningsidéen har gået videre, og i Openshift fandtes der noget, der hedder APB (Ansible Playbook Bundle), som gør det muligt at pakke viden om, hvordan man implementerer infrastrukturer i en container. Altså er der et reproducerbart, testbart punkt med viden om, hvordan man implementerer infrastrukturen.
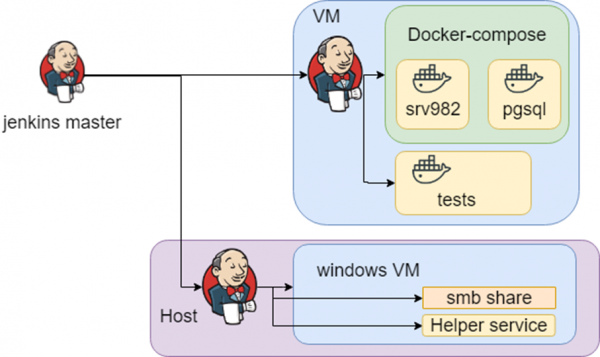
Alt dette lød godt, indtil vi stødte på en heterogen infrastruktur: vi har brug for Windows til vores tests. Resultatet er, at viden om, hvordan man implementerer og tester, ligger i Jenkins.
Konklusion
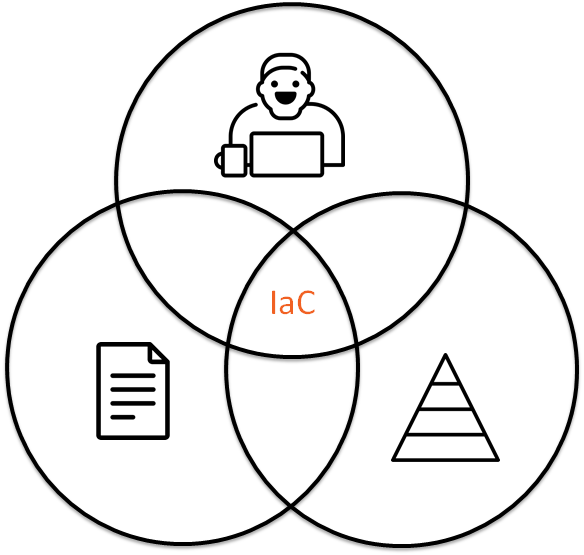
Infrastructure as Code er
- Kode i et repository.
- Interaktion mellem mennesker.
- Testning af infrastrukturen.
links
- Dry run 2019-04-24
- &
Kilde: habr.com
