

TL;DR
- For high observability of containers and microservices, logs and primary metrics are not enough.
- To achieve faster recovery and improve the resilience of applications, they must apply the High Observability Principle (HOP).
- At the application level, HOP requires proper logging, thorough monitoring, health checks, and performance/tracing transitions.
- As an element of HOP, use health checks. readinessProbe og livenessProbe Kubernetes.
What is a Health Check Template?
When designing a critical and highly available application, it's essential to consider aspects like resilience. An application is considered resilient if it quickly recovers after a failure. A typical cloud application uses a microservices architecture—where each component is placed in a separate container. To ensure that the application on k8s is highly available, certain templates must be followed when designing the cluster. Among these is the Health Check Template. It defines how the application communicates its health to k8s. This includes not just information about whether the pod is running, but also how it accepts and responds to requests. The more Kubernetes knows about the pod's health, the smarter its decisions for traffic routing and load balancing will be. Thus, the High Observability Principle allows the application to respond to requests in a timely manner.
The High Observability Principle (HOP)
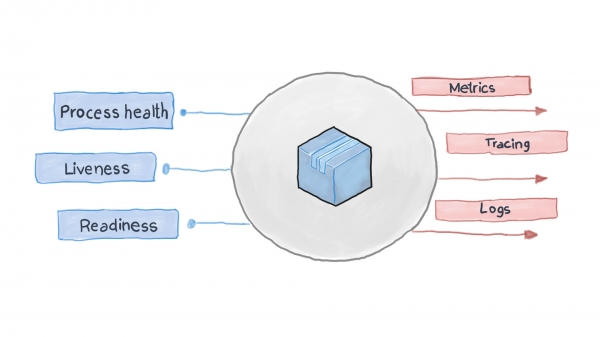
The High Observability Principle is one of . I mikrotjeneste-arkitektur er det ikke vigtigt for tjenesterne, hvordan deres anmodning behandles (og det er rigtigt), men hvordan man modtager svar fra modtagende tjenester. For eksempel sender en container en HTTP-anmodning til en anden for at autentificere brugeren og venter på svar i et bestemt format – og det er det. Anmodningen kan håndteres af PythonJS, og svaret kan komme fra Python Flask. Containerne er for hinanden som sorte bokse med skjult indhold. Men princippet om HSR kræver, at hver tjeneste afslører flere API-endepunkter, der viser, hvor vidt den er operativ, samt dens tilstand og modstandsdygtighed. Disse målinger anmodes Kubernetes om, for at tænke igennem de næste skridt for routing og belastningsbalancering.
Et veludviklet cloud-applikation logger sine hovedbegivenheder ved hjælp af standard input-output strømme STDERR og STDOUT. Derefter kører en hjælpe-tjeneste, for eksempel filebeat, logstash eller fluentd, der leverer loggene til et centralt overvågningssystem (som Prometheus) og et logindsamlingssystem (ETL-softwaren ELK). På diagrammet nedenfor vises, hvordan cloud-applikationen fungerer i overensstemmelse med Health Check-mønstret og princippet om høj observabilitet.
Hvordan anvendes Health Check-mønstret i Kubernetes?
Fra kassen monitorerer k8s tilstanden af pods ved hjælp af en af controllerne (, , , og andre). Når controlleren opdager, at en pod er faldet af en eller anden grund, forsøger den at genstarte den eller planlægge den på en anden node. Men en pod kan rapportere, at den kører og fungerer, mens den i virkeligheden ikke gør det. Lad os give et eksempel: dit applikation bruger Apache som webserver, og du har installeret komponenten på flere pods i klyngen. Da biblioteket var konfigureret forkert, svarer alle anmodninger til applikationen med kode 500 (intern serverfejl). Ved kontrol af leveringen giver statuskontrollen for pods et succesfuldt resultat, men kunderne mener noget andet. Denne uønskede situation vil vi beskrive således:
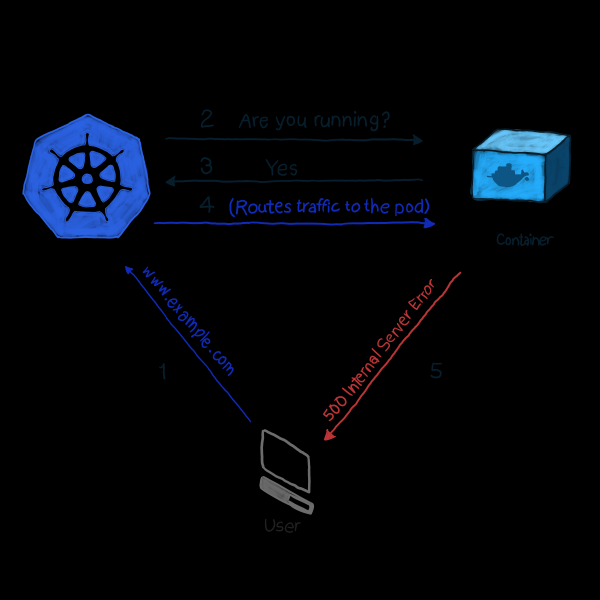
I vores eksempel udfører k8s helsecheckI denne type kontrol overvåger kubelet konstant tilstanden af processen i containeren. Så snart det registrerer, at processen er stoppet, genstarter den den. Hvis fejlen kan løses med en simpel genstart af applikationen, og programmet er designet til at lukke ned ved enhver fejl, så er det tilstrækkeligt at kontrollere processens livskraft for at følge NORM og Kontrolskabelonen. Det er ærgerligt, at ikke alle fejl kan løses ved en genstart. I sådanne tilfælde tilbyder k8s to dybere metoder til at identificere problemerne med pod’en: og .
LivenessProbe
Under livenessProbe kubelet udfører 3 typer kontroller: den fastslår ikke kun, om pod’en fungerer, men også om den er klar til at modtage og korrekt svare på forespørgsler:
- Etabler en HTTP-anmodning til pod’en. Svaret skal indeholde en HTTP-statuskode inden for intervallet 200 til 399. Således signalerer koderne 5xx og 4xx, at der er problemer med pod’en, selvom processen fungerer.
- For at kontrollere pods med ikke-HTTP tjenester (f.eks. mailserveren Postfix) skal der oprettes en TCP-forbindelse.
- Udførelse af en vilkårlig kommando for pod’en (internt). Kontrollen betragtes som vellykket, hvis afslutningskoden for kommandoen er 0.
Et eksempel på, hvordan dette fungerer. Definitionen af den følgende pod indeholder en NodeJS-applikation, der returnerer fejl 500 ved HTTP-anmodninger. For at sikre at containeren genstarter ved sådan en fejl, bruger vi parameteren livenessProbe:
apiVersion: v1
kind: Pod
metadata:
 name: node500
spec:
 containers:
   - image: magalix/node500
     name: node500
     ports:
       - containerPort: 3000
         protocol: TCP
     livenessProbe:
       httpGet:
         path: /
         port: 3000
       initialDelaySeconds: 5
Dette adskiller sig ikke fra enhver anden pod-definition, men vi tilføjer objektet .spec.containers.livenessProbe. Parameter httpGet modtager stien, hvor HTTP GET-anmodningen sendes (i vores eksempel er det /, men i produktionsscenarier kan det være noget lignende /api/v1/status). Desuden tager livenessProbe parameteren initialDelaySeconds, som instruerer kontroloperationerne om at vente et bestemt antal sekunder. Ventetiden er nødvendig, fordi containeren har brug for tid til at starte, og den vil være utilgængelig i nogen tid ved genstart.
For at anvende denne konfiguration på klyngen, brug:
kubectl apply -f pod.yamlEfter et par sekunder kan du kontrollere indholdet af pod’en med følgende kommando:
kubectl describe pods node500I slutningen af outputtet skal du finde .
Som du kan se, har livenessProbe initieret en HTTP GET-anmodning, og containeren gav en fejl 500 (som den var programmeret til), kubelet genstartede den.
Hvis du er interesseret i, hvordan NideJS-applikationen blev programmeret, er her filen app.js og Dockerfile, der blev brugt:
app.js
var http = require('http');

var server = http.createServer(function(req, res) {
    res.writeHead(500, { "Content-type": "text/plain" });
    res.end("Vi er løbet ind i en fejln");
});

server.listen(3000, function() {
    console.log('Server kører på 3000')
})
Dockerfile
FROM node
COPY app.js /
EXPOSE 3000
ENTRYPOINT [ "node","/app.js" ]
Det er vigtigt at bemærke følgende: livenessProbe genstarter containeren kun ved fejlfunktion. Hvis genstarten ikke løser fejlen, der forhindrer containerens funktion, kan kubelet ikke tage skridt til at rette fejlen.
readinessProbe
readinessProbe fungerer analogt med livenessProbe (GET-anmodninger, TCP-forbindelser og udførelse af kommandoer), undtagen handlinger til fejlfinding. En container, som har registreret en fejl, genstartes ikke, men isoleres fra indkommende trafik. Forestil dig, at en af containerne udfører mange beregninger eller er under tung belastning, hvilket resulterer i øget svartid på anmodninger. I tilfældet med livenessProbe udføres en tilgængelighedstjek (via parameteren timeoutSeconds), hvorefter kubelet genstarter containeren. Når containeren er genstartet, begynder den at udføre ressourcekrævende opgaver, og den genstartes igen. Dette kan være kritisk for applikationer, der har brug for hurtig respons. For eksempel venter en maskine i bevægelse på et svar fra serveren, svaret forsinkes – og maskinen havarerer.
Lad os skrive en definition af readinessProbe, der sætter svartiden på GET-anmodningen til højst to sekunder, mens applikationen svarer på GET-anmodningen efter 5 sekunder. Filen pod.yaml skal se således ud:
apiVersion: v1
kind: Pod
metadata:
 name: nodedelayed
spec:
 containers:
   - image: afakharany/node_delayed
     name: nodedelayed
     ports:
       - containerPort: 3000
         protocol: TCP
     readinessProbe:
       httpGet:
         path: /
         port: 3000
       timeoutSeconds: 2
Lad os deployere pod'en med kubectl:
kubectl apply -f pod.yamlLad os vente et par sekunder og derefter se, hvordan readinessProbe reagerede:
kubectl describe pods nodedelayedI slutningen af output kan man se, at nogle begivenheder er ens med .
Som du kan se, genstartede kubectl ikke pod'en, da kontroltiden overskred 2 sekunder. I stedet annullerede den anmodningen. Indkommende forbindelser omdirigeres til andre, fungerende pod'er.
Bemærk: nu hvor den unødvendige belastning er fjernet fra pod'en, sender kubectl igen forespørgsler til den: svar på GET-forespørgsler bliver ikke længere forsinket.
Til sammenligning: her er den ændrede fil app.js:
var http = require('http');

var server = http.createServer(function(req, res) {
   const sleep = (milliseconds) => {
       return new Promise(resolve => setTimeout(resolve, milliseconds))
   }
   sleep(5000).then(() => {
       res.writeHead(200, { "Content-type": "text/plain" });
       res.end("Hellon");
   })
});

server.listen(3000, function() {
   console.log('Server kører på 3000')
})
TL;DR
Før fremkomsten af cloud-applikationer var logs det primære middel til overvågning og kontrol af applikationernes tilstand. Dog var der ingen midler til at tage skridt til at løse problemer. Logs er stadig nyttige i dag, og de skal indsamles og sendes til en logindsamlingstjeneste for at analysere fejl og træffe beslutninger. [det kunne også gøres uden cloud-applikationer ved hjælp af monit, for eksempel, men med k8s er det blevet meget lettere 🙂 – red. note. ]
I dag skal rettelser faktisk laves næsten i realtid, så applikationer må ikke længere være sorte bokse. Nej, de skal vise slutpunkter, der giver overvågningssystemer mulighed for at anmode om og indsamle værdifulde data om processernes tilstand, så de kan reagere straks, hvis det er nødvendigt. Dette kaldes designmønsteret for sundhedstjek og følger princippet om høj observabilitet (HOP).
Kubernetes tilbyder som standard 2 typer sundhedstjek: readinessProbe og livenessProbe. Begge bruger de samme typer tjek (HTTP GET-anmodninger, TCP-forbindelser og udførelse af kommandoer). De adskiller sig i, hvilke beslutninger der træffes som svar på problemer i pod'ene. livenessProbe genstarter containeren i håbet om, at fejlen ikke gentager sig, mens readinessProbe isolerer pod'en fra indgående trafik – indtil årsagen til problemet er løst.
Korrekt design af applikationen bør inkludere begge typer tjek og sikre, at de indsamler tilstrækkelige data, især når der opstår en undtagelsessituation. Den skal også vise de nødvendige API-slutpunkter, der sender vigtige driftsmetrikker til overvågningssystemet (som Prometheus).
Kilde: habr.com
