

Som en del af forskningsprojektet er arbejdet begyndt på at tilføje en funktion til GCC, der muliggør opdeling af kompilationsprocessen i flere parallelt kørende tråde. I øjeblikket anvendes der til hurtigere byggeri på multikernet systemer en metode i make-utility, der starter separate kompilatorprocesser, hvor hver enkelt behandler en separat kodefil. Det nye projekt eksperimenterer med at sikre parallelisering på kompilatorniveau, hvilket potentielt kan øge effektiviteten på multikernet systemer.
Til testformål en separat paralleliserende gren af GCC, hvor et nyt parameter "--param=num-threads=N" er foreslået til at angive antallet af tråde. I den indledende fase er der realiseret parallelisering af interprocedurale optimeringer, som cyklisk kaldes for hver funktion og i høj grad kan paralleliseres. Der er blevet trukket GIMPLE-operationer ud i separate tråde, som udfører hardware-uafhængige optimeringer, der vurderer interaktionen mellem funktioner.
I næste fase planlægges det også at flytte interprocedurale RTL-optimeringer, der tager højde for hardwareplatformens karakteristika, ud i separate tråde. Derefter planlægges det at implementere parallelisering af intraprocedurale optimeringer (IPA), der anvendes på koden inden for funktionen, uafhængigt af kaldets karakteristika. En begrænsning er i øjeblikket garbage collector, som har fået en global lås, der deaktiverer garbage collection-operationer under drift i multi-threaded tilstand (i fremtiden vil garbage collectoren blive tilpasset for multi-threaded udførelse af GCC).
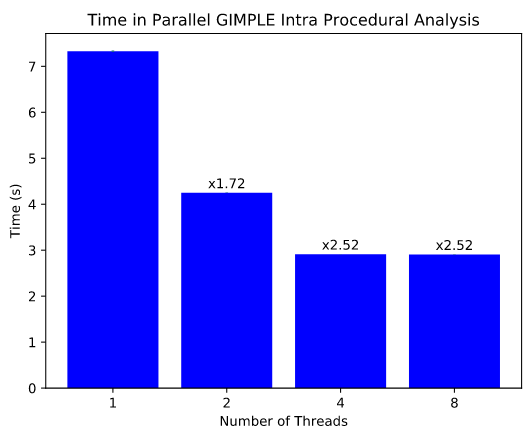
For at vurdere ændringen i ydeevnen er en test suite blevet forberedt, der udfører bygningen af filen gimple-match.c, som indeholder mere end 100.000 linjer kode og 1.700 funktioner. Tests på et system med en Intel Core i5-8250U CPU med 4 fysiske kerner og 8 virtuelle (Hyperthreading) viste en reduktion i tiden for udførelse af Intra Procedural GIMPLE-optimeringer fra 7 til 4 sekunder med 2 tråde og til 3 sekunder med 4 tråde, hvilket giver en hastighedsforøgelse af den pågældende byggefase på henholdsvis 1.72 og 2.52 gange. Testene viste også, at brugen af virtuelle kerner ved Hyperthreading ikke medfører en stigning i ydeevnen.
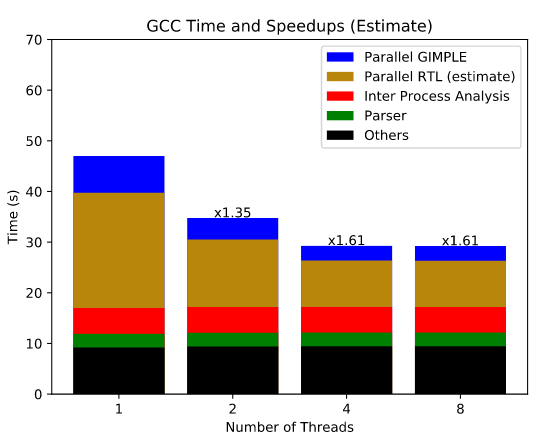
Den samlede byggetid er blevet reduceret med cirka 10%, men ifølge prognoserne vil parallelisering af RTL-optimeringerne muliggøre mere betydningsfulde resultater, da denne fase tager væsentligt længere tid under kompilering. Estimatet er, at efter paralleliseringen af RTL vil den samlede byggetid falde med en faktor på 1,61. Herefter kan byggetiden yderligere reduceres med 5-10% ved at parallelisere IPA-optimeringer.
Kilde: opennet.ru
