

Fortsættelse af oversættelsen af en lille bog:
«Forståelse af beskedbrokers»
forfatter: Jakub Korab, forlag: O’Reilly Media, Inc., udgivelsesdato: Juni 2017, ISBN: 9781492049296.
Den tidligere oversatte del:
KAPITEL 3
Kafka
Kafka blev udviklet hos LinkedIn for at omgå nogle af begrænsningerne ved traditionelle beskedbrokers og for at undgå behovet for at konfigurere flere beskedbrokers til forskellige 'point-to-point' interaktioner, som beskrevet i denne bog i afsnittet 'Vertikal og horisontal skalering' på side 28. Brugsituationerne hos LinkedIn var primært baseret på ensrettet absorption af meget store datamængder, såsom klik på sider og adgangslogfiler, samtidig med at disse data kunne anvendes af flere systemer uden at påvirke ydeevnen for producenter eller andre forbrugere. Faktisk er formålet med Kafka at opnå den arkitektur for beskedudveksling, som beskrives i Universal Data Pipeline.
I betragtning af dette endelige mål opstod der naturligt også andre krav. Kafka skal:
- Være ekstremt hurtig
- Tilbyde høj gennemstrømning ved behandling af beskeder
- Understøtte 'Udgiver-Abonnent' og 'Point-Point' modeller
- Ikke blive langsommere ved tilføjelse af forbrugere. For eksempel forringes ydeevnen for både køer og emner i ActiveMQ, når antallet af forbrugere stiger ved modtageren
- Være horisontalt skalerbar; hvis en broker, der gemmer (persisterer) beskeder, kun kan gøre det med maksimal diskhastighed, giver det mening at overskride én instans af en broker for at øge ydeevnen
- Adskille adgangen til opbevaring og genfindelse af beskeder
For at opnå alt dette har Kafka vedtaget en arkitektur, der omdefinerer rollerne og ansvaret for klienter og message brokers. JMS-modellen er meget broker-orienteret, hvor den er ansvarlig for distributionen af meddelelser, mens klienterne blot skal bekymre sig om at sende og modtage meddelelser. Kafka, derimod, er klient-orienteret, idet klienten påtager sig mange af de funktioner, som en traditionel broker normalt ville have, såsom retfærdig distribution af relevante meddelelser blandt forbrugerne, mens den får en ekstremt hurtig og skalerbar broker til gengæld. For folk, der har arbejdet med traditionelle message systems, kræver arbejdet med Kafka fundamentale ændringer i perspektivet.
Denne ingeniørretning har ført til oprettelsen af en message broker-infrastruktur, der er i stand til at øge throughput med flere størrelsesordner sammenlignet med en almindelig broker. Som vi vil se, er denne tilgang forbundet med kompromiser, hvilket betyder, at Kafka ikke er egnet til bestemte typer belastninger og installeret software.
Unified recipient model
For at opfylde de krav, der er beskrevet ovenfor, har Kafka kombineret publish-subscribe og point-to-point messaging i en enkelt type recipient — topic. Dette forvirrer folk, der har arbejdet med messaging-systemer, hvor ordet "topic" refererer til en broadcast-mekanisme, hvor det (fra emnet) at læse ikke er pålideligt (is nondurable). Kafka-emner bør betragtes som en hybrid type recipient, i overensstemmelse med definitionen givet i introduktionen til denne bog.
I resten af dette kapitel, medmindre vi specifikt angiver andet, vil termen "topic" referere til Kafka-topic.
For fuldt ud at forstå, hvordan topics adfærd, og hvilke garantier de giver, skal vi først se på, hvordan de er implementeret i Kafka.
Hvert topic i Kafka har sin egen log.
Producenter, der sender beskeder til Kafka, skriver til denne journal, mens forbrugere læser fra journalen ved hjælp af pegere, der konstant bevæger sig fremad. Periodisk sletter Kafka de ældste dele af journalen, uanset om beskederne i disse dele er blevet læst eller ej. En central del af designet i Kafka er, at broker ikke bekymrer sig om, hvorvidt beskeder er blevet læst eller ej - det er klientens ansvar.
Termen "journal" og "peger" findes ikke i . Disse velkendte termer bruges her for at hjælpe forståelsen.
Denne model er helt anderledes end ActiveMQ, hvor beskeder fra alle køer gemmes i én journal, og brokeren markerer beskeder som slettede efter, at de er blevet læst.
Lad os nu dykke lidt dybere ned og se nærmere på emnets journal.
Kafka-journalen består af flere partitioner (). Kafka garanterer streng rækkefølge i hver partition. Det betyder, at beskeder, der skrives til en partition i en bestemt rækkefølge, vil blive læst i samme rækkefølge. Hver partition implementeres som en cyklisk (rolling) journalfil, der indeholder et subset (subset) af alle beskeder sendt til emnet af dets producenter. Det oprettede emne indeholder som standard én partition. Ideen med partitioner er den centrale idé i Kafka for horisontal skalering.
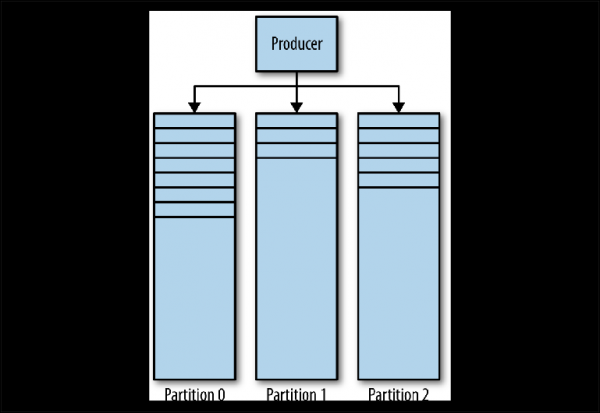
Figur 3-1. Kafka-partitioner
Når en producent sender en besked til et Kafka-emne, bestemmer han, hvilken partition beskeden skal sendes til. Dette vil vi se nærmere på senere.
Læsning af beskeder
Klienten, der ønsker at læse beskeder, styrer en navngivet peger, kaldet forbrugergruppe (consumer group), der peger på offset for beskeden i partitionen. Offset er en position med et stigende nummer, der begynder fra 0 i starten af partitionen. Denne forbrugergruppe, som refereres til i API'et via en brugerdefineret identifikation group_id, svarer til én logisk forbruger eller system.
De fleste systemer, der bruger meddelelsesudveksling, læser data fra adressaten ved hjælp af flere instanser og tråde til parallel behandling af beskeder. Derfor vil der normalt være mange instanser af forbrugere, der deler den samme forbrugergruppe.
Problemet med at læse kan præsenteres på følgende måde:
- Et emne har flere partitioner
- Mange forbrugergrupper kan bruge emnet samtidigt
- En forbrugergruppe kan have flere separate instanser
Dette er et ikke-trivielt "mange til mange" problem. For at forstå, hvordan Kafka håndterer forholdet mellem forbrugergrupper, forbrugerinstanser og partitioner, lad os overveje en række scenarier med gradvist stigende kompleksitet for læsning.
Forbrugere og forbrugergrupper
Lad os tage udgangspunkt i et emne med én partition ().
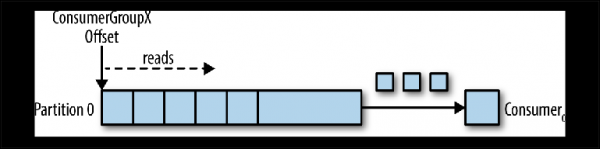
Figur 3-2. Forbruger læser fra partitionen
Når en forbrugerinstans tilsluttes til dette emne med sit eget group_id, tildeles den en partition til at læse fra og et offset i denne partition. Placeringen af dette offset konfigureres i klienten som en pegepind til den seneste position (den nyeste meddelelse) eller den tidligste position (den ældste meddelelse). Forbrugeren anmoder om (polls) meddelelser fra emnet, hvilket resulterer i, at de læses sekventielt fra loggen.
Positionen for offset'et commits regelmæssigt tilbage til Kafka og gemmes som meddelelser i det interne emne _consumer_offsets. Læste meddelelser slettes ikke, i modsætning til en almindelig broker, og klienten kan spole (rewind) offset'et for at genbehandle allerede viste meddelelser.
Når en anden logisk forbruger tilsluttes med et andet group_id, håndterer den en anden pegepind, som ikke er afhængig af den første (). På denne måde fungerer Kafka-emnet som en kø, hvor der eksisterer en forbruger og som et almindeligt udgiver-abonnent (pub-sub) emne, hvor flere forbrugere er tilmeldt, med den ekstra fordel, at alle meddelelser bevares og kan behandles flere gange.
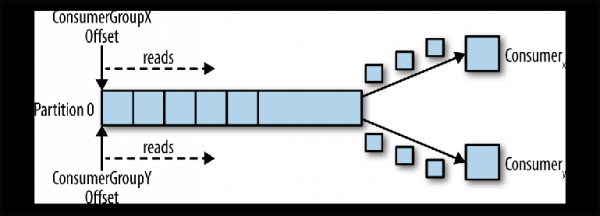
Figur 3-3. To forbrugere i forskellige forbrugergrupper læser fra en partition
Forbrugere i forbrugergruppen
Når en forbrugerinstans læser data fra partitionen, har den fuld kontrol over pegepinden og behandler meddelelserne, som beskrevet i den foregående sektion.
Hvis flere forbrugere er tilsluttet et emne med den samme group_id til én partition, vil den instans, der tilslutter sig sidst, få kontrol over pegeren, og fra det tidspunkt vil den modtage alle meddelelser ().
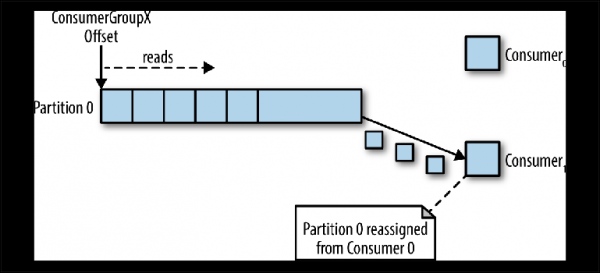
Figur 3-4. To forbrugere i samme gruppe forbrugere læser fra én partition
Denne behandlingsmetode, hvor antallet af forbrugere overstiger antallet af partitioner, kan betragtes som en form for monopol-forbruger. Dette kan være nyttigt, hvis du har brug for «aktivt-passiv» (eller «varm-lun») klustering af dine forbrugerinstanser, selvom parallel drift af flere forbrugere («aktivt-aktiv» eller «varm-varm») er meget mere typisk end forbrugere i ventemodus.
Den beskrevne meddelelsesfordelingsadfærd kan være overraskende i forhold til, hvordan en almindelig JMS-kø opfører sig. I denne model vil meddelelser, der sendes til køen, blive jævnt fordelt mellem to forbrugere.
Ofte, når vi opretter flere forbrugerinstanser, gør vi dette enten for parallel behandling af meddelelser, eller for at øge læsehastigheden, eller for at forbedre stabiliteten af læseprocessen. Da kun én forbrugerinstans kan læse data fra en partition på samme tid, hvordan opnås dette i Kafka?
En af måderne at gøre dette på er at bruge én forbrugerinstans til at læse alle meddelelser og videregive dem til et trådpool. Selvom denne tilgang øger behandlingsgennemstrømningen, øger den kompleksiteten af forbrugernes logik og gør ikke noget for at forbedre stabiliteten i læsesystemet. Hvis én forbrugerinstans går offline på grund af strømafbrydelse eller en lignende hændelse, stopper læsningen.
Den kanoniske metode til at løse dette problem i Kafka er at bruge flere partitioner.OPartitionering
Partitioner er den primære mekanisme til at parallelisere læsning og skalere emnet ud over en enkelt brokers kapacitet. For bedre at forstå det, lad os overveje et scenarie, hvor der findes et emne med to partitioner, og én forbruger abonnerer på dette emne (
Figur 3-5).
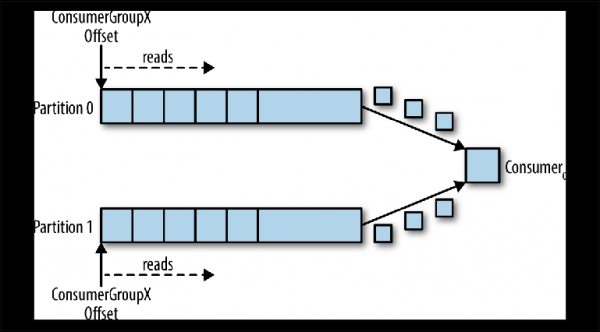
Figur 3-5. En forbruger læser fra flere partitioner
I dette scenarie får forbrugeren kontrol over pointerne, der svarer til hans group_id i begge partitioner, og begynder at læse meddelelser fra begge partitioner.
Når der tilføjes en ekstra forbruger til den samme group_id i dette emne, tildeler Kafka en af partitionerne fra den første til den anden forbruger. Hver instans af forbrugeren vil derefter læse fra én partition af emnet ().
For at sikre parallel behandling af meddelelser i 20 tråde, har du brug for mindst 20 partitioner. Hvis der er færre partitioner, vil du have forbrugere, der ikke har noget at arbejde med, hvilket tidligere er beskrevet i diskussionen om monopol-forbrugere.
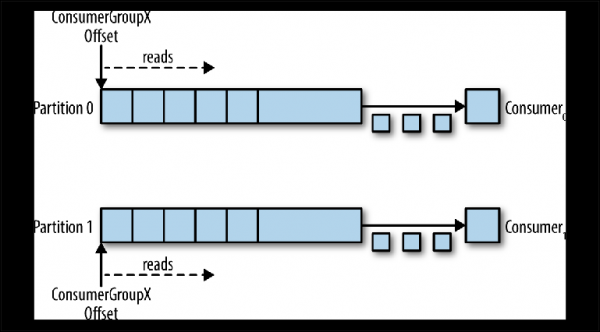
Figur 3-6. To forbrugere i den samme gruppe af forbrugere læser fra forskellige partitioner
Denne konfiguration reducerer betydeligt kompleksiteten af Kafka-brokerens arbejde sammenlignet med den meddelelsesfordeling, der kræves for at understøtte JMS-køer. Her er der ikke behov for at bekymre sig om følgende punkter:
- Hvilken forbruger der skal modtage den næste meddelelse, baseret på rund-robin fordeling, den nuværende kapacitet af forudlæsning buffers eller tidligere meddelelser (som for JMS-meddelelsesgrupper).
- Hvilke meddelelser der er sendt til hvilke forbrugere, og om de skal leveres igen i tilfælde af fejl.
Alt, hvad Kafka-brokeren skal gøre, er at overføre meddelelser til forbrugeren, når sidstnævnte anmoder om dem.
Imidlertid forsvinder kravene til parallel læsning og genlevering af fejlede meddelelser ikke - ansvaret for dem overgår blot fra broker til klient. Det betyder, at de skal tages i betragtning i din kode.
Afsendelse af meddelelser
Ansvarligheden for at beslutte, hvilken partition en meddelelse skal sendes til, påhviler producenten af denne meddelelse. For at forstå mekanismen, hvormed dette gøres, er det først nødvendigt at overveje, hvad vi faktisk sender.
Mens vi i JMS bruger en meddelelsesstruktur med metadata (overskrifter og egenskaber) og en krop, der indeholder nyttelasten (payload), er en meddelelse i Kafka et par "nøgle-værdi". Belastningen af meddelelsen sendes som værdi (value). Nøglen, derimod, bruges hovedsageligt til partitionering og skal indeholde forretningslogik-specifik nøgle, så relaterede meddelelser kan placeres i den samme partition.
I Kapitel 2 diskuterede vi scenariet for online væddemål, hvor relaterede hændelser skal behandles i orden af en enkelt forbruger:
- Brugerkontoen er opsat.
- Pengene indsættes på kontoen.
- Der placeres et væddemål, som trækker penge fra kontoen.
Hvis hver hændelse repræsenterer en meddelelse sendt til emnet, vil den naturlige nøgle i dette tilfælde være kontoen identificator.
Når en meddelelse sendes ved hjælp af Kafka Producer API, sendes den til partitioneringsfunktionen, som, baseret på meddelelsen og den nuværende tilstand af Kafka-klyngen, returnerer identifikatoren for den partition, hvor meddelelsen skal sendes. Denne funktion er implementeret i Java gennem interface Partitioner.
Dette interface ser således ud:
interface Partitioner {
    int partition(String topic,
        Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster);
}
Implementeringen af Partitioner til at bestemme partitionen bruger som standard en hash-algoritme (general-purpose hashing algorithm over the key) eller round-robin, hvis nøglen ikke er angivet. Denne standardværdi fungerer godt i de fleste tilfælde. Men i fremtiden kan du ønske at skrive din egen.
Skrive din egen partitioneringsstrategi
Lad os overveje et eksempel, hvor du vil sende metadata sammen med belastningen af meddelelsen. Belastningen i vores eksempel er en instruktion til at foretage en indbetaling til spillekontoen. Instruktionen er det, vi gerne vil sikre os ikke ændres under transmission og vil være sikre på, at kun et betroet overordnet system kan initiere denne instruktion. I så fald aftaler de sender og modtager systemer at bruge en signatur til at validere meddelelsens autenticitet.
I almindelig JMS definerer vi blot egenskaben "meddelelsessignatur" og tilføjer den til meddelelsen. Imidlertid giver Kafka os ikke en mekanisme til at transmittere metadata — kun nøgle og værdi.
Da værdien er nyttelasten af en bankoverførsel, hvis integritet vi ønsker at bevare, har vi ikke andet valg end at definere datask strukturen til brug i nøglen. Antager vi, at vi har brug for en konto-id til partitionering, da alle meddelelser relateret til kontoen skal behandles i rækkefølge, vil vi finde på følgende JSON-struktur:
{
  "signature": "541661622185851c248b41bf0cea7ad0",
  "accountId": "10007865234"
}
Da værdien af signaturen vil variere afhængigt af nyttelasten, vil standard hash-strategi for Partitioner ikke pålideligt gruppere relaterede meddelelser. Derfor skal vi skrive vores egen strategi, der analyserer denne nøgle og partitionerer værdien af accountId.
Kafka inkluderer kontrolsummer for at opdage beskadigede meddelelser i lageret og har et komplet udvalg af sikkerhedsfunktioner. Selv under disse omstændigheder kan der dog opstå branche-specifikke krav som nævnt ovenfor.
Den brugerdefinerede partitioneringsstrategi skal sikre, at alle relaterede meddelelser placeres i den samme partition. Selvom det virker enkelt, kan kravet kompliceres af vigtigheden af at opretholde rækkefølgen af relaterede meddelelser og hvor fast antallet af partitioner er i emnet.
Antallet af partitioner i emnet kan ændre sig over tid, da de kan tilføjes, hvis trafikken overstiger de oprindelige forventninger. Således kan meddelelsens nøgler være knyttet til den partition, de oprindeligt blev sendt til, hvilket indebærer en del af staten, der skal fordeles mellem producenter.
En anden faktor, som bør tages i betragtning, er jævn fordeling af meddelelser mellem partitionerne. Generelt er nøglerne ikke jævnt fordelt over meddelelserne, og hash-funktioner garanterer ikke en retfærdig fordeling af meddelelser for et lille antal nøgler.
Det er vigtigt at bemærke, at uanset hvordan du beslutter at opdele meddelelserne, kan selve partitioneringen have brug for at blive genbrugt.
Lad os overveje kravet til datasynkronisering mellem Kafka-klynger på forskellige geografiske placeringer. Til dette formål leveres Kafka med et kommandolinjeværktøj kaldet MirrorMaker, som bruges til at læse meddelelser fra én klynge og overføre dem til en anden.
MirrorMaker skal forstå nøglerne til det replikerede emne for at opretholde den relative rækkefølge mellem meddelelserne under replikering mellem klynger, da antallet af partitioner for dette emne muligvis ikke stemmer overens i de to klynger.
Brugerdefinerede partitioneringsstrategier ses relativt sjældent, da de standardmæssige hashing- eller cykliske strategier fungerer tilfredsstillende i de fleste scenarier. Men hvis du har brug for strenge garantier for rækkefølgen, eller hvis du skal udtrække metadata fra nyttelasterne, så er partitionering noget, som du bør se nærmere på.
Fordelene ved skalerbarhed og ydeevne i Kafka skyldes, at nogle af de traditionelle brokeropgaver overflyttes til klienten. I dette tilfælde træffes der en beslutning om at distribuere potentielt relaterede meddelelser til flere forbrugere, der arbejder parallelt.
JMS-brokere skal også tage sådanne krav i betragtning. Interessant nok kræver den mekanisme, der sender relaterede meddelelser til den samme forbruger, implementeret via JMS Message Groups (en variant af balanceringsstrategien sticky load balancing (SLB)), også at afsenderen markerer meddelelserne som relaterede. I tilfælde af JMS er brokeren ansvarlig for at sende denne gruppe af relaterede meddelelser til én forbruger blandt mange og overdrage ejerskabet af gruppen, hvis forbrugeren falder af.
Aftaler fra producenter
Partitionering er ikke det eneste, der skal overvejes, når man sender meddelelser. Lad os se på metoderne send() i Producer-klassen i Java API:
Future  send(ProducerRecord  record);
Future  send(ProducerRecord  record, Callback callback);
Det er vigtigt at bemærke, at begge metoder returnerer Future, hvilket indikerer, at sendingsoperationen ikke udføres straks. Som et resultat skrives meddelelsen (ProducerRecord) til sendingsbufferen for hver aktiv partition og sendes til broker i baggrunden via Kafka-klientbiblioteket. Selvom dette gør arbejdet utrolig hurtigt, betyder det, at et uerfarent skrevet program kan miste meddelelser, hvis dets proces standses.
Som altid er der en måde at gøre sendingsoperationen mere pålidelig på bekostning af ydeevnen. Størrelsen på denne buffer kan indstilles til 0, og sendende applikationsflow vil blive tvunget til at vente, indtil overførslen af meddelelsen til brokeren er afsluttet, som følger:
RecordMetadata metadata = producer.send(record).get();Igen om læsning af meddelelser
Læsning af meddelelser har yderligere kompleksiteter, som det er nødvendigt at overveje. I modsætning til JMS API, som kan starte en meddelelseslytter (message listener) som svar på modtagne meddelelser, er interface Consumer Kafka kun polling. Lad os se nærmere på metoden poll (), der anvendes til dette formål:
ConsumerRecords poll(long timeout);Returværdien af metoden er en containerstruktur, der indeholder flere objekter ConsumerRecord fra potentielt flere partitioner. ConsumerRecord Selve objektet fungerer som en holder for nøgle-værdi par med tilhørende metadata, såsom den partition, som den er hentet fra.
Som diskuteret i Kapitel 2, skal vi konstant huske, hvad der sker med meddelelserne efter deres succesfulde eller mislykkede behandling, for eksempel hvis klienten ikke kan behandle meddelelsen, eller hvis den afbryder arbejdet. I JMS blev dette håndteret gennem bekræftelsesmode (acknowledgement mode). Brokeren sletter enten de succesfuldt behandlede meddelelser eller genleverer de ubehandlede eller fejlede (forudsat at transaktioner blev anvendt).
Kafka fungerer helt anderledes. Meddelelser slettes ikke i broker efter læsningen, og ansvaret for, hvad der sker ved fejl, ligger hos den kode, der læser.
Som vi allerede har nævnt, er en gruppe konsumenter knyttet til offset i loggen. Positionen i loggen, der er knyttet til dette offset, svarer til den næste meddelelse, der vil blive udsendt som svar på poll ()Det afgørende tidspunkt ved læsning er det tidspunkt, hvor denne offset øges.
Når vi vender tilbage til den tidligere nævnte læsemodel, består behandlingen af meddelelsen af tre faser:
- Hente meddelelsen til læsning.
- Behandle meddelelsen.
- Bekræfte meddelelsen.
Kafka-consumeren leveres med en konfigurationsmulighed enable.auto.commit. Dette er ofte en anvendt standardindstilling, som det ofte er tilfældet med indstillinger, der indeholder ordet 'auto'.
Før Kafka 0.10 sendte en klient, der brugte denne parameter, offset for den sidst læste meddelelse ved næste kald poll () efter behandling. Det betød, at enhver meddelelse, der allerede var blevet hentet, kunne behandles igen, hvis klienten allerede havde behandlet dem, men blev uventet stoppet før kaldet. poll (). Da broker ikke gemmer nogen tilstand vedrørende, hvor mange gange en meddelelse er blevet læst, vil den næste consumer, der henter denne meddelelse, ikke vide, at der skete noget galt. Denne adfærd var pseudo-transaktionel. Offset blev kun kommitteret i tilfælde af succesfuld behandling af meddelelsen, men hvis klienten gik ned, sendte broker den samme meddelelse til en anden klient. Denne adfærd svarede til garantien for meddelelseslevering "mindst én gang«.
I Kafka 0.10 blev klientkoden ændret, så kommit blev periodisk initieret af klientbiblioteket, i overensstemmelse med indstillingen auto.commit.interval.ms. Denne adfærd ligger et sted mellem tilstandene JMS AUTO_ACKNOWLEDGE og DUPS_OK_ACKNOWLEDGE. Ved brug af autocommit kunne meddelelserne bekræftes uanset om de faktisk var blevet behandlet — dette kunne ske i tilfælde af en langsom consumer. Hvis consumeren gik ned, blev meddelelser hentet af den næste consumer fra den kommitterede position, hvilket kunne føre til, at meddelelser blev sprunget over. I så fald mistede Kafka ikke meddelelserne; den læsende kode behandlede dem simpelthen ikke.
Denne tilstand har de samme perspektiver som i version 0.9: meddelelser kan blive behandlet, men i tilfælde af et fejl kan offset muligvis ikke blive kommitteret, hvilket potentielt kan føre til duplikeret levering. Jo flere meddelelser du henter under udførelsen poll (), jo større er dette problem.
Som diskuteret i afsnittet "Læsning af meddelelser fra køen" på side 21, findes der ikke noget begreb om engangslevering af meddelelser i messagesystemet, når man tager hensyn til fejlsituationer.
I Kafka er der to måder at bekræfte (committe) offset på: automatisk og manuelt. I begge tilfælde kan meddelelser behandles flere gange, hvis en meddelelse er blevet behandlet, men der opstod en fejl før commit. Du kan også helt undlade at behandle en meddelelse, hvis commit er sket i baggrunden, og din kode blev afsluttet, før den begyndte behandlingen (måske i Kafka 0.9 og tidligere versioner).
Du kan styre commit-processen for offset manuelt i Kafka konsumer API ved at indstille parameteren enable.auto.commit til false og eksplicit kalde en af følgende metoder:
void commitSync();
void commitAsync();
Hvis du stræber efter at behandle meddelelsen "mindst én gang", skal du manuelt committe offset ved hjælp af commitSync (), ved at udføre denne kommando straks efter behandlingen af meddelelserne.
Disse metoder tillader ikke at bekræfte (acknowledged) meddelelser, før de er blevet behandlet, men de gør ikke noget for at undgå potentiel dobbeltbehandling, mens de samtidig skaber en illusion af transaktionalitet. Der er ingen transaktioner i Kafka. Klienten har ikke mulighed for at gøre følgende:
- Automatisk rulle tilbage (roll back) en mislykket meddelelse. Konsumerne skal selv håndtere undtagelser, der opstår på grund af problematiske payloads og backend-afbrydelser, da de ikke kan stole på, at meddelelser returneres af broker.
- Sende meddelelser til flere emner i en atomar operation. Som vi snart vil se, kan kontrol over forskellige emner og partitioner ligge på forskellige maskiner i Kafka-klusteret, som ikke koordinerer transaktioner ved afsendelse. På tidspunktet for denne artikel var der gjort en vis indsats for at gøre dette muligt med KIP-98.
- Knytte læsningen af en meddelelse fra et emne til afsendelsen af en anden meddelelse til et andet emne. Igen afhænger Kafka-arkitekturen af mange uafhængige maskiner, der fungerer som en bus, og der gøres ikke nogen forsøg på at skjule dette. For eksempel findes der ikke API-komponenter, der gør det muligt at knytte Konsumer og Producent i transaktionen. I JMS sikres dette af objektet Session, hvorfra der oprettes MessageProducers og MessageConsumers.
Hvis vi ikke kan stole på transaktioner, hvordan kan vi så sikre en semantik, der er tættere på den, der leveres af traditionelle beskedudvekslingssystemer?
Hvis der er en chance for, at forbrugerens offset kan stige, før meddelelsen er blevet behandlet, for eksempel under et forbrugerfejl, har forbrugeren ingen måde at vide på, om dens forbrugergruppe har overset meddelelser, når den bliver tildelt en partition. En af strategierne er derfor at spole (rewind) offsettet tilbage til en tidligere position. Kafka-forbrugerens API tilbyder følgende metoder til dette:
void seek(TopicPartition partition, long offset);
void seekToBeginning(Collection  partitions);
Metoden seek () kan bruges med metoden
offsetsForTimes (Map timestampsToSearch) til at spole tilbage til en tilstand på et bestemt tidspunkt i fortiden.
Implicit betyder brugen af denne tilgang, at det sandsynligvis vil ske, at nogle meddelelser, der tidligere er blevet behandlet, vil blive læst og behandlet igen. For at undgå dette kan vi bruge idempotent læsning, som beskrevet i Kapitel 4, til at holde styr på tidligere sete meddelelser og udelukke dubletter.
Som et alternativ kan din forbrugers kode være simpel, hvis tab eller duplikering af meddelelser er acceptabelt. Når vi overvejer brugsscenarier, som Kafka typisk bruges til, såsom behandling af loggener, metrics, kliksporing osv., forstår vi, at tab af enkelte meddelelser sandsynligvis ikke vil have en betydelig indvirkning på de omkringliggende applikationer. I sådanne tilfælde er standardværdier helt acceptable. På den anden side, hvis din applikation skal håndtere betalinger, skal du nøje passe på hver enkelt meddelelse. Det hele handler om konteksten.
Personlige observationer viser, at med stigende intensitet af meddelelser, falder værdien af hver enkelt meddelelse. Store mængder meddelelser viser sig generelt at være værdifulde, når de betragtes i aggregeret form.
Høj tilgængelighed (High Availability)
Kafkas tilgang til høj tilgængelighed adskiller sig væsentligt fra ActiveMQs tilgang. Kafka er bygget på horisontalt skalerbare klynger, hvor alle brokerinstanser modtager og distribuerer beskeder samtidigt.
En Kafka-klynge består af flere brokerinstanser, der kører på forskellige servere. Kafka er designet til at arbejde på almindeligt autonomt hardware, hvor hver node har sit eget dedikerede lager. Anvendelse af netværkslager (SAN) frarådes, da flere beregningsnoder kan konkurrere om tidsintervallerne for lagring og skabe konflikter.Åendet.
Kafka er en altid tændt system. Mange store brugere af Kafka slukker aldrig for deres klynger, og softwaren sikrer altid opdatering ved sekventiel genstart. Dette opnås ved at garantere bagudkompatibilitet for beskeder og interaktioner mellem brokers.
Brokers er tilsluttet en klynge af servere , som fungerer som en konfigurationsdatabse og bruges til at koordinere rollerne for hver broker. ZooKeeper selv er et distribueret system, der sikrer høj tilgængelighed ved at replikere information ved at etablere kvorum..
I det grundlæggende tilfælde oprettes et emne i Kafka-klyngen med følgende egenskaber:
- Antallet af partitioner. Som nævnt tidligere afhænger den præcise værdi, der anvendes her, af det ønskede niveau for parallel læsning.
- Replikationsfaktoren bestemmer, hvor mange brokerinstanser i klyngen der skal indeholde logfiler for denne partition.
Ved at bruge ZooKeeper til koordinering forsøger Kafka at fordele nye partitioner retfærdigt mellem brokers i klyngen. Dette gøres af én instans, der fungerer som Controller.
I runtime tildeler hver partition af emnet Controller brokerne roller som leder (leader, master, førende) og medarbejdere. (følgere, slaver, tilhængere). En broker, der fungerer som leder for den pågældende partition, er ansvarlig for at modtage alle meddelelser sendt til ham af producenterne og for at distribuere meddelelserne til forbrugerne. Når meddelelser sendes til partitionen af emnet, bliver de replikeret på alle broker-noder, der fungerer som følgere for denne partition. Hver node, der indeholder logs for partitionen, kaldes en replika. En broker kan fungere som leder for nogle partitioner og som følger for andre.
En følger, der holder alle meddelelser gemt hos lederen, kaldes en synkroniseret replika (. replika, der er i synkroniseret tilstand, in-sync replica). Hvis broker, der fungerer som leder for partitionen, lukker ned, kan enhver broker, der er i актуализированном eller synkroniseret tilstand for denne partition, tage rollen som leder. Dette er et utroligt robust design.
En del af konfigurationen for producenten er parameteren acks, som bestemmer, hvor mange replikaer der skal bekræfte (acknowledge) modtagelsen af en meddelelse, før applikationsstrømmen fortsætter med at sende: 0, 1 eller alle. Hvis værdien angives til alle, så vil lederen sende en bekræftelse (confirmation) tilbage til producenten, så snart han modtager bekræftelser (acknowledgements) for optegnelsen fra flere replikaer (inklusive sig selv), som er specificeret af topic-indstillingen min.insync.replicas (som standard 1). Hvis meddelelsen ikke kan replikeres med succes, vil producenten udløse en undtagelse for applikationen (NotEnoughReplicas eller NotEnoughReplicasAfterAppend).
I en typisk konfiguration oprettes der et emne med en replikeringsfaktor på 3 (1 leder, 2 følgere for hver partition) og parameteren min.insync.replicas sættes til 2. I dette tilfælde vil klustret tillade, at en af brokerne, der varetager partitionen af emnet, kan lukke ned uden at påvirke klientapplikationer.
Det bringer os tilbage til det allerede velkendte kompromis mellem ydeevne og pålidelighed. Replikering sker på bekostning af ekstra ventetid til bekræftelser (acknowledgments) fra følgerne. Selvom, da det udføres parallelt, har replikering, som minimum på tre noder, samme ydeevne som på to (ignorerer den øgede brug af netværksbåndbredde).
Ved at bruge dette replikationsskema undgår Kafka elegant behovet for at sikre fysisk optegnelse af hver besked på disk via operationen sync (). Hver besked sendt af producenter vil blive opført i partitionsjournalen, men som diskuteret i Kapitel 2, udføres den indledende optegnelse i en fil i operativsystemets buffer. Hvis denne besked er blevet replikeret til en anden Kafka-instans og ligger i dens hukommelse, betyder tabet af lederen ikke, at selve beskeden er gået tabt — en synkroniseret replika kan tage over.
At give afkald på behovet for at udføre operationen sync () betyder, at Kafka kan modtage beskeder i det tempo, den kan optage dem i hukommelsen. Omvendt, jo længere man kan undgå at spole (flushing) hukommelsen til disk, desto bedre. Af denne grund er det ikke usædvanligt, at Kafka-brokere tildeles 64 GB hukommelse eller mere. Denne hukommelsesbrug betyder, at én Kafka-instans let kan operere med hastigheder, der er mange tusinde gange hurtigere end traditionelle meddelelsesbrokere.
Kafka kan også konfigureres til at anvende operationen sync () på beskedpakker. Da alt i Kafka er designet til at arbejde med pakker, fungerer dette faktisk ganske godt for mange anvendelsesscenarier og er et nyttigt værktøj for brugere, der kræver meget stærke garantier. Meget af Kafkas rene ydeevne er relateret til de beskeder, der sendes til brokeren i form af pakker, og til hvordan disse beskeder læses fra brokeren i sekventielle blokke ved hjælp af operationer (operationer, hvor der ikke udføres dataoverførsel fra ét hukommelsesområde til et andet). Det sidstnævnte er en stor fordel med hensyn til ydeevne og ressourcer og er kun muligt takket være den underliggende datalogstruktur, der definerer partitionsskemaet.
I et Kafka-kluster er det muligt at opnå meget højere ydeevne end ved brug af én Kafka-broker, da emnets partitioner kan skaleres horisontalt på mange separate maskiner.
Resumé
I dette kapitel har vi set på, hvordan Kafka-arkitekturen genovervejer forholdet mellem klienter og broker for at sikre en utrolig robust messaging pipeline med en kapacitet, der er mange gange større end en almindelig message broker. Vi har diskuteret den funktionalitet, den bruger for at nå dette mål, og kort berørt arkitekturen af de applikationer, der muliggør denne funktionalitet. I det næste kapitel vil vi se på de generelle udfordringer, som messaging-baserede applikationer skal tackle, og diskutere strategier til at løse dem. Vi afslutter kapitlet med at skitsere, hvordan man skal tænke på messaging-teknologier generelt, så du kan vurdere deres egnethed til dine brugsscenarier.
Den tidligere oversatte del:
Oversættelsen er udført:
Fortsætter…
Kun registrerede brugere kan deltage i undersøgelsen. , please.
Bruger din organisation Kafka?
Ja
Nej
Tidligere brugt, nu ikke længere
Planlægger at bruge
38 brugere har stemt. 8 brugere har undladt at stemme.
Kilde: habr.com
