

Hej læsere af Habr. Med denne artikel åbner vi en cyklus, der vil fortælle om vores udviklede hyperkonvergerede system AERODISK vAIR. Oprindeligt havde vi planlagt at fortælle alt om alt i den første artikel, men systemet er ret komplekst, så vi vil tage det i bidder.
Vi starter fortællingen med historien om oprettelsen af systemet, dykker ned i filsystemet ARDFS, som er grundlaget for vAIR, og reflekterer lidt over dette løsnings positionering på det russiske marked.
I de næste artikler vil vi tale mere detaljeret om de forskellige arkitektoniske komponenter (klynge, hypervisor, belastningsfordeler, overvågningssystem osv.), installationsprocessen, vi vil rejse spørgsmål om licensering, vise crash tests og selvfølgelig skrive om belastningstest og sizing. Vi vil også dedikere en separat artikel til community-versionen af vAIR.
AERODISK – er dette ikke en historie om SAN? Eller hvorfor begyndte vi overhovedet at beskæftige os med hyperkonvergens?
Oprindeligt kom ideen om at skabe vores egen hyperkonvergerede løsning til os omkring 2010. Dengang var der hverken AERODISK eller lignende løsninger (kommercielle pakkeløsninger for hyperkonvergerede systemer) på markedet. Vores opgave var følgende: fra et sæt servere med lokale disks, bundet sammen via interconnect med Ethernet-protokollen, måtte der skabes et distribueret lager, hvor virtuelle maskiner og et softwarenetværk kunne køre. Alt dette skulle realiseres uden SAN (da vi simpelthen ikke havde penge til SAN og dens tilslutning, og vi havde endnu ikke opfundet vores egen SAN).
Vi prøvede mange open source-løsninger og løste denne opgave, men løsningen var meget kompleks, og det var svært at gentage den. Desuden var denne løsning af typen 'Virker det? Lad det være!'. Derfor, efter vi havde løst opgaven, besluttede vi ikke at udvikle ideen om at transformere resultatet af vores arbejde til et fuldgyldigt produkt.
Efter den oplevelse bevægede vi os væk fra denne idé, men vi kunne stadig ikke ryste følelsen af, at denne opgave bestemt kunne løses, og at fordelene ved en sådan løsning var mere end åbenlyse. Senere bekræftede de HCI-produkter fra udenlandske virksomheder denne følelse.
Derfor vendte vi i midten af 2016 tilbage til denne opgave som en del af udviklingen af et fuldt produkt. På det tidspunkt havde vi ikke nogen relationer til investorer, så vi måtte købe udviklingsstandet for vores egne, ikke særlig store penge. Vi gik i gang med at købe brugte servere og switche på Avito.
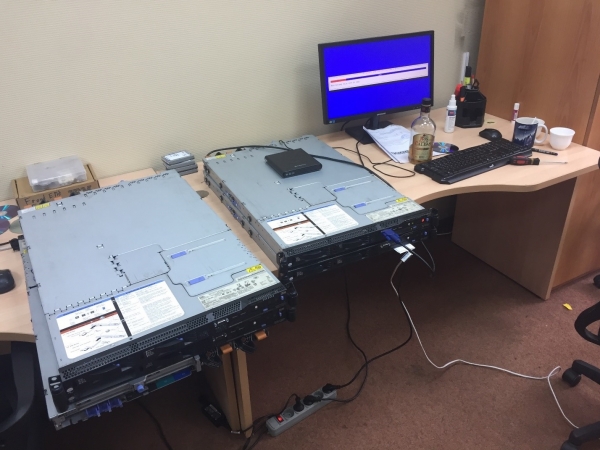
Den primære indledende opgave var at skabe vores egen, omend simple, filsystem, der kunne automatisere og jævnt fordele data i form af virtuelle blokke over et n-model klynge, som var interconnectet via Ethernet. Filsystemet skulle desuden være let at skalere og uafhængigt af tilstødende systemer, altså kunne ses som 'bare en lagerplads' adskilt fra vAIR.
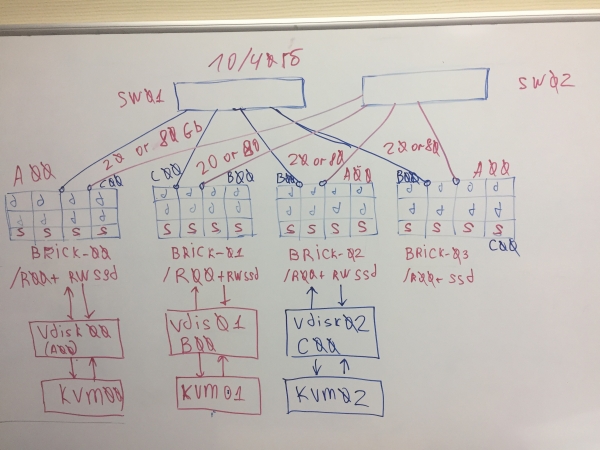
Den første koncept for vAIR
Vi valgte bevidst at undgå at bruge eksisterende open source-løsninger til at organisere udstrakte lager (ceph, gluster, lustre og lignende) til fordel for vores egen udvikling, da vi allerede havde meget projekt erfaring med dem. Disse løsninger er uden tvivl fremragende, og før arbejdet med Aerdisk havde vi allerede implementeret flere integrationsprojekter med dem. Men det er en ting at løse en specifik opgave for én kunde, træne personale og måske købe support fra en stor leverandør, og noget helt andet at skabe et let reproducerbart produkt, der vil blive brugt til forskellige formål, som vi som leverandør muligvis ikke engang selv kender. For dette formål fungerede eksisterende open source-produkter ikke, derfor besluttede vi at udvikle et distribueret filsystem selv.
Efter to år, med indsatsen fra flere udviklere (som kombinerede arbejdet med vAIR med arbejdet på en klassisk storage system Engine), opnåede vi et vist resultat.
I 2018 skrev vi et simpelt filsystem og supplere det med den nødvendige indpakning. Systemet samlede fysiske (lokale) diske fra forskellige servere gennem intern interconnection i en flad pulje og 'skar' dem op i virtuelle blokke, hvorefter der blev oprettet blok enheder fra de virtuelle blokke med en eller anden grad af fejltolerance, hvorpå der med KVM hypervisoren blev oprettet og kørt virtuelle maskiner.
Vi knyttede ikke meget opmærksomhed til filsystemets navn og kaldte det lakonisk ARDFS (gæt selv, hvad det står for))
Denne prototype så godt ud (ikke visuelt, selvfølgelig, der var ikke noget visuelt layout dengang) og viste gode resultater med hensyn til ydeevne og skalerbarhed. Efter det første reelle resultat satte vi projektet i gang, organiserede et fuldt udviklingsmiljø og en separat gruppe, der kun arbejdede med vAIR.
Lige på det tidspunkt var den overordnede arkitektur af løsningen blevet moden, og den har ikke gennemgået nogen væsentlige ændringer siden.
Lad os dykke ned i filsystemet ARDFS
ARDFS udgør fundamentet for vAIR, som sikrer distribueret fejltolerance til datalagring i hele klyngen. Et af (men ikke det eneste) kendetegn ved ARDFS er, at det ikke bruger nogen yderligere dedikerede servere under metafor og administration. Dette blev oprindeligt tænkt for at forenkle løsningens konfiguration og for dens pålidelighed.
Lagringsstruktur
Inden for alle noder i klyngen organiserer ARDFS et logisk pulje af alt tilgængeligt diskplads. Det er vigtigt at forstå, at puljen endnu ikke er data eller formateret plads, men bare en markering, dvs. alle noder med installeret vAIR, der tilføjes til klyngen, tilføjes automatisk til den fælles ARDFS-pulje, og diskressourcerne bliver automatisk fælles for hele klyngen (og tilgængelige for fremtidig lagring af data). Denne tilgang muliggør hurtigt at tilføje og fjerne noder uden alvorlige konsekvenser for det allerede fungerende system. Det vil sige, at systemet er meget let at skalere
ved at tilføje eller fjerne noder i klyngen efter behov. På puljen af ARDFS tilføjes virtuelle diske (lagringsobjekter til virtuelle maskiner), som bygges af virtuelle blokke på 4 megabyte. På de virtuelle diske opbevares dataene direkte. På niveauet for de virtuelle diske defineres også skemaet for fejltolerance.
Som du måske allerede har gættet, bruger vi ikke RAID (Redundant array of independent Disks) konceptet til fejltolerance af disk-systemet, men i stedet RAIN (Redundant array of independent Nodes). Det vil sige, at fejltolerance måles, automatiseres og styres baseret på noder frem for diske. Diskene er selvfølgelig også lagerobjekter, de overvåges ligesom alt andet, og man kan udføre alle standardoperationer med dem, herunder at samle lokal hardware RAID, men clusteret opererer netop med noder.
I situationer, hvor man virkelig ønsker RAID (for eksempel et scenarie, der understøtter multiple fejlsituationer på små clusters), er der intet, der forhindrer brugen af lokale RAID-kontrollere, og oven på dette at skabe et distribueret lager og RAIN-arkitektur. Et sådant scenarie er helt realistisk og understøttes af os, derfor vil vi omtale det i artiklen om typiske anvendelsesscenarier for vAIR.
Fejltolerance-skematikker for lager
Der kan være to typer fejltolerance for virtuelle diske i vAIR:
1) Replikationsfaktor eller blot replikation – denne metode til fejltolerance er simpel «som en stok og et reb». Der udføres synkron replikation mellem noderne med en faktor på 2 (2 kopier pr. cluster) eller 3 (3 kopier, hhv.). RF-2 tillader, at den virtuelle disk kan klare fejlen af én node i clusteren, men «spiser» halvdelen af den nyttige kapacitet, mens RF-3 kan klare fejlen af 2 noder i clusteren, men reserverer allerede 2/3 af den nyttige kapacitet til sine behov. Denne skema minder meget om RAID-1, det vil sige, at en virtuel disk konfigureret i RF-2 er modstandsdygtig over for fejlen af en hvilken som helst node i clusteren. I dette tilfælde vil dataene være sikre, og selv I/O vil ikke stoppe. Når den faldne node vender tilbage i drift, vil automatisk gendannelse/synkronisering af data begynde.
Nedenfor er eksempler på distribution af data RF-2 og RF-3 i normal drift og i tilfælde af fejl.
Vi har en virtuel maskine med 8 MB unikke (nyttige) data, som kører på 4 noder vAIR. Det er klart, at der i virkeligheden næppe vil være et så lille volumen, men til en skema, der afspejler logikken i ARDFS, er dette eksempel det mest forståelige. AB er virtuelle blokke på 4 MB, der indeholder unikke data fra den virtuelle maskine. Ved RF-2 oprettes der to kopier af disse blokke A1+A2 og B1+B2 henholdsvis. Disse blokke
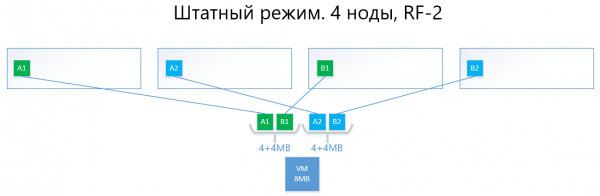
fordeles
på noderne uden at krydse de samme data på en enkelt node, så kopien A1 ikke vil være på samme node som kopien A2. B1 og B2 fungerer på samme måde.
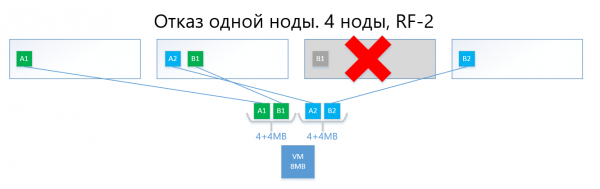
Når en af noderne fejler (for eksempel node nr. 3, hvor kopien B1 findes), aktiveres denne kopie automatisk på den node, hvor der ikke findes en kopi af dens kopi (dvs. kopi B2).
På denne måde kan den virtuelle disk (og VM'en) nemt overleve en nodes fejl i RF-2 schemaet.
Schem nettet med replikation, mens det er simpelt og pålideligt, lider under den samme svaghed som RAID1 - lidt nyttig plads.
Erasure coding eller sletning af kodning (også kendt som 'overskydende kodning', 'sletningskodning' eller 'overskudskode') eksisterer netop for at løse det ovennævnte problem. EC er et overskudsschema, der sikrer høj tilgængelighed af data med lavere omkostninger til diskplads sammenlignet med replikation. Funktionsprincippet for denne mekanisme ligner RAID 5, 6, 6P.
Ved kodning opdele processen EC den virtuelle blok (som standard 4 MB) i flere mindre 'data stykker' afhængigt af EC-skemet (for eksempel deler skemaet 2+1 hver 4 MB blok i 2 stykker på 2 MB). Derefter genererer denne proces 'paritets stykker' på ikke mere end én af de tidligere opdelte dele til 'data stykkerne'. Ved dekodning genererer EC de manglende stykker ved at læse de 'overlevende' data i hele klyngen.
I sidste ende distribueres data og paritet jævnt på alle noder i klyngen. Som ved replikation distribuerer ARDFS automatisk dataene på noderne, så der ikke opbevares ens data (kopier af data og deres paritet) på én node, for at undgå at miste data, hvis dataene og deres paritet pludselig skulle være på én lagringsnode, der fejler.
Nedenfor er et eksempel med den samme virtuelle maskine på 8 MB og 4 noder, men allerede med skemaet EC 2+1.
Blokke A og B opdeles i to stykker hver på 2 MB (i to, fordi 2+1), dvs. delene A1+A2 og B1+B2. I modsætning til en kopi er A1 ikke en kopi af A2; det er en virtuel blok A, der er delt i to dele, og det samme gælder for blok B. Således får vi to sæt på 4 MB, hvor hver indeholder to to-megabyte stykker. Dernæst beregnes pariteten for hvert af disse sæt af et volumen på højst ét stykke (dvs. 2 MB), og vi får yderligere + 2 stykker paritet (A-P og B-P). Så i alt har vi 4×2 data + 2×2 paritet.
Derefter "fordeles" stykkerne på noderne, så dataene ikke overlapper med deres paritet. Dvs. A1 og A2 vil ikke være på den samme node som A-P.
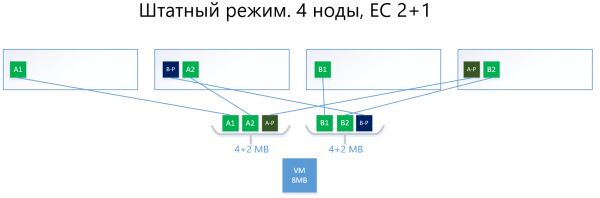
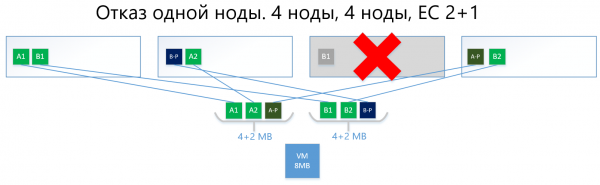
I tilfælde af fejl på én node (lad os sige den tredje) vil den fejlede blok B1 automatisk blive gendannet fra pariteten B-P, som opbevares på node nr. 2, og aktiveres på node, hvor der ikke er B-paritet, dvs. stykket B-P. I dette eksempel er det node nr. 1.
Jeg er sikker på, at læseren stiller spørgsmålet:
"Alt det, du har beskrevet, er allerede implementeret af konkurrenter og i open source-løsninger, hvad er forskellen på jeres implementering af EC i ARDFS?"
Og videre vil de interessante funktioner i ARDFS blive præsenteret.
Erasure coding med fokus på fleksibilitet
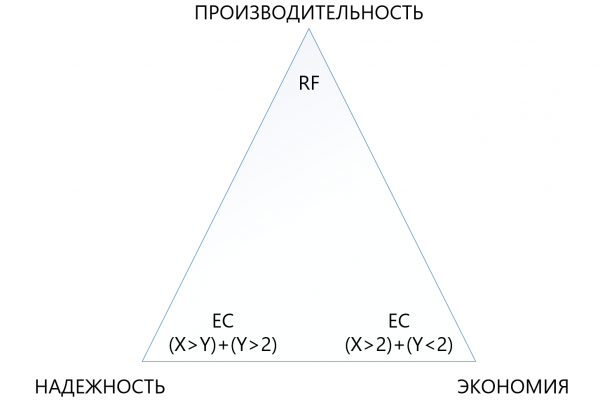
Oprindeligt havde vi en ret fleksibel EC-scheme X+Y, hvor X er et tal fra 2 til 8, og Y er et tal fra 1 til 8, men altid mindre end eller lig med X. Denne ordning er designet til fleksibilitet. En stigning i antallet af datastykker (X), som den virtuelle blok opdeles i, reducerer omkostningerne, hvilket øger det nyttige rum.
En stigning i antallet af paritetsstykker (Y) øger pålideligheden af den virtuelle disk. Jo højere Y-værdien er, desto flere noder i klyngen kan fejle. Selvfølgelig reducerer en stigning i volumen af paritet det nyttige kapacitet, men det er prisen for pålidelighed.
Afhængigheden af ydeevne fra EC-skemaer er næsten direkte: jo flere "klumper", desto lavere ydeevne, her er der behov for et afbalanceret syn.
Denne tilgang gør det muligt for administratorer at konfigurere et distribueret lager så fleksibelt som muligt. Inden for ARDFS-puljen kan man anvende enhver form for fejltolerance og deres kombinationer, hvilket også er meget nyttigt, efter vores mening.
Nedenfor er en sammenligningstabel af flere (ikke alle mulige) RF- og EC-skemaer.
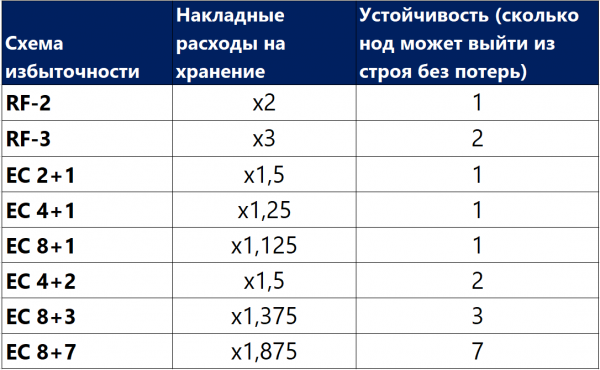
Det fremgår af tabellen, at selv den mest "udviklede" EC-kombination 8+7, der tillader tab af op til 7 noder i klyngen samtidigt, "spiser" mindre nyttig plads (1,875 mod 2) end standard replikation, mens den beskytter 7 gange bedre, hvilket gør denne beskyttelsesmekanisme mere kompleks men betydeligt mere attraktiv i situationer, hvor maksimal pålidelighed kræves under omstændigheder med begrænset diskplads. Det skal dog forstås, at hver "plus" til X eller Y vil medføre yderligere omkostninger for ydeevnen, derfor skal der vælges meget omhyggeligt i trekanter mellem pålidelighed, besparelse og ydeevne. Af denne grund vil vi dedikere en separat artikel til sizing af codering.
Pålidelighed og autonomi i filsystemet
ARDFS kører lokalt på alle noder i klyngen og synkroniserer dem ved hjælp af dedikerede Ethernet-grænseflader. Et vigtigt punkt er, at ARDFS selv synkroniserer ikke kun data men også metadata relateret til opbevaring. Under arbejdet med ARDFS har vi samtidig undersøgt en række eksisterende løsninger, og vi har fundet ud af, at mange bruger en ekstern distribueret DBMS til synkronisering af metadata i filsystemet, hvilket vi også bruger til synkronisering af konfigurationer, men ikke metadata fra FS (om dette og andre beslægtede systemer i den næste artikel).
Samarbejdningen om metadata-synkronisering med en ekstern DBMS er selvfølgelig en funktionel løsning, men så ville datakonsistensen lagret på ARDFS være afhængig af den eksterne DBMS og dens opførsel (som vi må sige er ret lunefuld), hvilket vi anser for problematisk. Hvorfor? Hvis metadataene i FS beskadiges, vil selv dataene i FS også være sagt «farvel», så vi besluttede at tage en mere kompleks, men pålidelig vej.
Vi har selv lavet subsystemet til metadata-synkronisering til ARDFS, og det fungerer helt uafhængigt af nabosystemer. Dvs. ingen andre subsystemer kan beskadige dataene i ARDFS. Efter vores mening er dette den mest pålidelige og korrekte vej, og om det virkelig er sådan, vil tiden vise. Desuden giver denne tilgang en ekstra fordel. ARDFS kan bruges uafhængigt af vAIR, blot som en udvidet lagerløsning, hvilket vi bestemt vil udnytte i fremtidige produkter.
Som resultat af udviklingen af ARDFS har vi fået et fleksibelt og pålideligt filsystem, der giver valgmuligheder for, hvor man kan spare på kapaciteten eller sætte alt ind på ydeevnen, eller gøre lageret ekstremt pålideligt for en moderat pris, men med reducerede ydeevnekrav.
Sammen med en enkel licenspolitik og en fleksibel leveringsmodel (for at forudse, licenseres vAIR pr. node, og leveres enten som software eller som PAK) gør det muligt meget præcist at tilpasse løsningen til forskellige kundekrav og nemt vedligeholde denne balance i fremtiden.
Hvem har brug for dette vidunder?
På den ene side kan man sige, at der allerede er spillere på markedet med seriøse løsninger inden for hyperkonvergens, og at vi egentlig ikke burde blande os. Det virker som en korrekt påstand, MEN...
På den anden side, når vi kommer «ud i marken» og taler med kunder, ser vi, at det helt bestemt ikke er sådan. Der er mange opgaver for hyperkonvergens, nogle mennesker vidste bare ikke, at sådanne løsninger eksisterede, i nogle tilfælde virkede det for dyrt, i andre var der mislykkede tests af alternative løsninger, og i andre er køb endda forbudt på grund af sanktioner. Generelt viste marken sig at være upløjet, og derfor gik vi i gang med at tage fat på det.)
Hvornår er SCS bedre end GCS?
I takt med vores arbejde på markedet får vi ofte spørgsmålet om, hvornår man bedst anvender den klassiske model med SAN, og hvornår man skal bruge hyperkonvergerede løsninger? Mange virksomheder, der producerer HCI (især dem uden SAN i deres portefølje), siger: "SAN er ved at dø ud, hyperkonvergeret er vejen frem!". Dette er en dristig påstand, men den afspejler ikke helt virkeligheden.
For at være ærlig bevæger SAN-markedet sig virkelig mod hyperkonvergerede løsninger, men der er altid et 'men'.
For det første er det ikke så let at ombygge eksisterende datacentre og IT-infrastrukturer, der er bygget med den klassiske model med SAN, så opgradering og udvidelse af sådanne infrastrukturer er stadig en arv i 5-7 år.
For det andet bygger de infrastrukturer, der i øjeblikket etableres i massevis (her menes Rusland), overvejende efter den klassiske model med brug af SAN, ikke fordi folk ikke kender til hyperkonvergerede løsninger, men fordi markedet for hyperkonvergerede løsninger er nyt, løsninger og standarder er endnu ikke etableret, IT-specialisterne er ikke tilstrækkeligt uddannede, erfaringen er lille, og datacentre skal bygges her og nu. Denne tendens vil vare i yderligere 3-5 år (og så er der stadig arv, jf. punkt 1).
For det tredje er der en rent teknisk begrænsning i de ekstra små forsinkelser på 2 millisekunder ved skrivning (uden hensyntagen til lokal cache, selvfølgelig), som er prisen for distribueret lagring.
Og lad os ikke glemme brugen af store fysiske servere, som elsker vertikal scaling af disk-undersystemet.
Der er mange nødvendige og populære opgaver, hvor SAN præsterer bedre end HCI. Selvfølgelig vil producenter uden SAN i deres produktportefølje ikke være enige i dette, men vi er klar til at argue vores sag. Som udviklere af begge produkter vil vi i en af de kommende publikationer bestemt sammenligne SAN og HCI, hvor vi tydeligt vil demonstrere, hvornår hvilke forhold er bedst.
Og hvor vil hyperkonvergerede løsninger fungere bedre end SAN?
Baseret på de tidligere nævnte punkter kan der drages tre åbenlyse konklusioner:
- Der, hvor de ekstra 2 millisekunders forsinkelse ved skrivning, som regelmæssigt opstår i al produktionsmiljø (denne diskussion omhandler ikke syntetisk tester, da disse kan vise nanosekunders forskelle), ikke er kritiske, er hyperkonvergerede løsninger velegnede.
- Der, hvor belastningen fra store fysiske servere kan omdannes til mange små virtuelle og distribueres over noder, vil hyperkonvergerede løsninger også finde godt fodfæste.
- Der, hvor horisontal skalering er mere prioriteret end vertikal, vil hyperkonvergerede systemer også fungere fremragende.
Hvilke løsninger er der?
- Alle standardinfrastrukturtjenester (katalogtjeneste, e-mail, DMS, filservere, små eller mellemstore ERP- og BI-systemer osv.). Vi kalder det "fælles beregninger".
- Infrastrukturen hos cloududbydere, hvor det er nødvendigt at skaler hurtigt og standardiseret horisontalt og nemt "skære" mange virtuelle maskiner til kunder.
- Infrastruktur for virtuelle skriveborde (VDI), hvor mange små bruger-virtualer starter op og frit "svømmer" inden for et enhedligt cluster.
- Filialnetværk, hvor hver filial har brug for en standard, fejltolerance, men samtidig prisvenlig infrastruktur bestående af 15-20 virtuelle maskiner.
- Enhver distribueret beregning (big data-tjenester, for eksempel). Der, hvor belastningen går ikke "nedad", men "udad".
- Testmiljøer, hvor der kan være små yderligere forsinkelser, men der er budgetmæssige begrænsninger, da det er tests.
I øjeblikket har vi udviklet AERODISK vAIR specifikt til disse opgaver, og vi fokuserer netop på dem (indtil videre med succes). Det er muligt, at dette snart vil ændre sig, da verden ikke står stille.
Så...
Med dette er den første del af en stor cyklus af artikler afsluttet; i den næste artikel vil vi fortælle om arkitekturen af løsningen og de anvendte komponenter.
Vi ser frem til spørgsmål, forslag og konstruktive diskussioner.
Kilde: habr.com
