

Hej, Habr! Tidligere har jeg klaget over livet i paradigmet Infrastructure as code og ikke tilbudt løsninger på den eksisterende situation. I dag er jeg tilbage for at fortælle, hvilke tilgange og praksisser der kan hjælpe med at bryde fri fra afgrundens fortvivlelse og styre situationen i den rigtige retning.
I den tidligere artikel Jeg delte mine indtryk af dette område, forsøgte at reflektere over den nuværende situation og endda foreslog, at de standardpraksisser, som alle udviklere kender, kunne hjælpe. Det kunne virke som om, der var mange klager over livet, men der manglede forslag til, hvordan man kunne komme ud af den vanskelige situation.
Hvem er vi, hvor er vi, og hvilke problemer har vi
I øjeblikket er vi i SRE Onboarding Team, som består af seks programmører og tre infrastrukturingenører. Vi forsøger alle at skrive Infrastructure as code (IaC). Vi gør det, fordi vi grundlæggende kan skrive kode og har en baggrund som udviklere af "over gennemsnittet" niveau.
- Vi har et sæt fordele: en bestemt baggrund, kendskab til praksis, evne til at skrive kode, og lysten til at lære nyt.
- Og der er den svage side, også kendt som ulempe: mangel på viden om infrastrukturens materie.
Teknologistekken, vi bruger i vores IaC.
- Terraform til at oprette ressourcer.
- Packer til at bygge billeder. Det er Windows, CentOS 7 billeder.
- Jsonnet til at lave kraftige builds i drone.io, samt til at generere packer json og vores Terraform moduler.
- Azure.
- Ansible til klargøring af billeder.
- Python til støtteværktøjer og provisioneringsscripts.
- Og alt dette i VSCode med plugins delt mellem teammedlemmerne.
Min konklusion var, at jeg forsøgte at indgyde (først og fremmest i mig selv) optimisme, jeg ville sige, at vi vil prøve de tilgange og praksisser, vi kender, for at kæmpe med de vanskeligheder og kompleksiteter, der findes i dette område.
I øjeblikket kæmper vi med følgende IaC-problemer:
- Ufuldkommenhed i værktøjerne, redskaber til kodning.
- Langsom udrulning. Infrastruktur er en del af den virkelige verden, og den kan være langsom.
- Mangel på tilgange og praksisser.
- Vi er nye og ved ikke meget.
Ekstrem programmering (XP) kommer til undsætning.
Alle udviklere er godt bekendt med ekstrem programmering (XP) og de praksisser, der ligger bag. Mange af os har arbejdet med denne tilgang, og den har været vellykket. Så hvorfor ikke udnytte de principper og praksisser, der er etableret der, for at overvinde infrastrukturs udfordringer? Vi har besluttet at anvende denne tilgang og se, hvad der kommer ud af det.
Vurdering af anvendeligheden af XP-tilgangen i dit feltJeg præsenterer beskrivelsen af det miljø, hvor XP er velegnet, og hvordan det relaterer sig til os:
1. Dynamisk ændrende softwarekrav. Vi var klar over, hvad det endelige mål var. Men i detaljerne kunne der varieres. Vi bestemmer selv, hvor vi skal dreje hen, så kravene ændrer sig fra tid til anden (primært af os selv). Hvis vi ser på SRE-teamet, der selv laver automatisering og samtidig begrænser kravene og omfanget af arbejdet, så passer dette punkt godt.
2. Risici forbundet med faste tidsprojekter, der bruger ny teknologi. Vi kan stå overfor risici ved brugen af nogle ukendte ting for os. Og det er 100 % vores tilfælde. Hele vores projekt er brugen af teknologier, som vi ikke helt har været bekendt med. Det er generelt et konstant problem, da der hele tiden dukker mange nye teknologier op inden for infrastrukturen.
3,4. Lille, co-lokation udvidet udviklingsteam. Den teknologi, du bruger, muliggør automatiserede enheds- og funktionelle tests. Disse to punkter passer ikke helt til os. For det første er vi ikke et co-lokationsteam, for det andet er vi ni personer, hvilket kan betragtes som et stort team. Selvom, ifølge nogle definitioner af et „stort“ team, er mange over 14 personer.
Lad os se på nogle praktikker fra XP og hvordan de påvirker hastigheden og kvaliteten af feedback.
Princippet om feedback-loopet i XP
Efter min opfattelse er feedback et svar på spørgsmålet, om jeg gør det rigtigt, om vi bevæger os i den rigtige retning? I XP er der en guddommelig skema til dette: feedback-loopet over tid. Det interessante er, at jo lavere vi er, jo hurtigere har vi mulighed for at få feedback til at besvare de nødvendige spørgsmål.
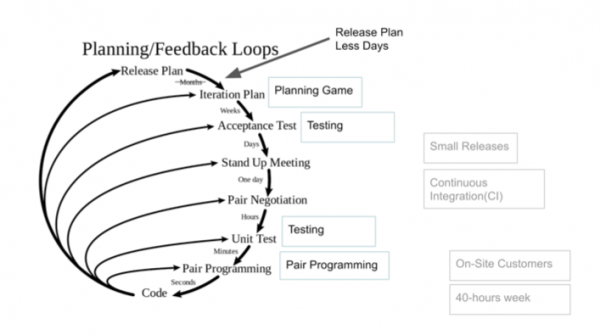
Det er et ret interessant emne til diskussion, hvordan vi i IT-industrien hurtigt kan få feedback. Forestil dig, hvor smertefuldt det er at udføre et projekt i et halvt år og først derefter finde ud af, at der i starten blev lagt en fejl. Sådan noget sker både i design og i opbygningen af komplekse systemer.
I vores tilfælde hjælper IaC os med feedback. Jeg laver straks en mindre justering i ovenstående skema: udgivelsesplanen har ikke en månedlig cykel, men finder sted flere gange om dagen. Til denne cyklus er der knyttet nogle praksisser, som vi vil se nærmere på.
Vigtigt: feedback kan blive løsningen på alle ovenstående problemer. I kombination med XP-praksisserne kan det trække os op fra afgrundens desperation.
Sådan trækker du dig selv op fra afgrundens desperation: tre praksisser
Tests
Tests nævnes to gange i XP-feedbackcyklussen. Det er ikke uden grund. De er ekstremt vigtige for hele teknikken bag ekstrem programmering.
Det forudsættes, at du har Unit- og Acceptance-tests. Nogle giver dig feedback på et par minutter, andre på et par dage, da de skrives længere og køres sjældnere.
Der er en klassisk testpyramide, der viser, at der bør være flere af nogle tests.
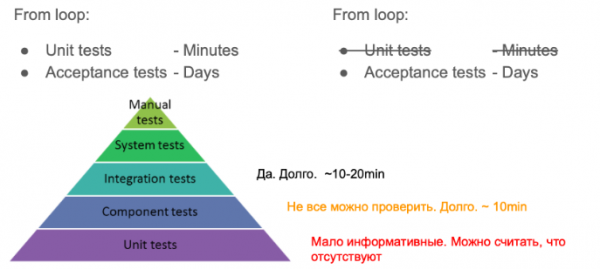
Hvordan er dette schema anvendeligt for os i IaC-projektet? Faktisk… på ingen måde.
- Selvom vi bør have mange Unit-tests, kan vi ikke have for mange. Enten tester de noget meget indirekte. Faktisk kan man sige, at vi slet ikke skriver dem. Men her er et par anvendelser for sådanne tests, som vi alligevel har formået at lave:
- Test af kode på jsonnet. Det er for eksempel vores build-pipeline i drone, som er ret kompleks. Koden på jsonnet er godt dækket af tests.
Vi bruger denne . - Tests på scripts, der udføres ved opstart af ressourcen. Scripts i Python, og derfor kan tests skrives til dem.
- Test af kode på jsonnet. Det er for eksempel vores build-pipeline i drone, som er ret kompleks. Koden på jsonnet er godt dækket af tests.
- Der er potentielt mulighed for at teste konfigurationen i tests, men vi gør det ikke. Der er også mulighed for at konfigurere validering af ressourcekonfigurationsregler gennem . Men for Terraform er der simpelthen for grundlæggende kontroller, men mange testscenarier er skrevet til AWS. Og vi er på Azure, så det passer ikke igen.
- Komponent- og integrations tests: her afhænger det af, hvordan du klassificerer dem og hvor du placerer dem. Men de fungerer grundlæggende.
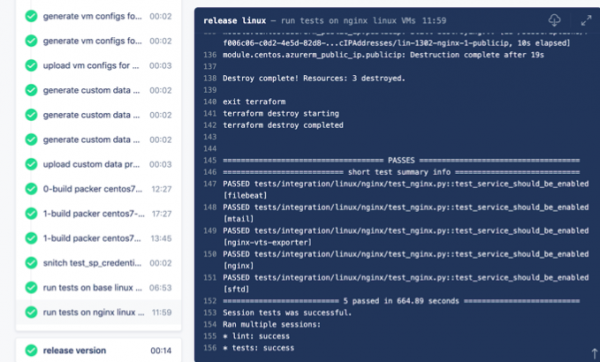
Sådan ser integrations tests ud.

Dette er et eksempel fra opbygning af billeder i Drone CI. For at nå dem, skal man vente 30 minutter, mens Packer-billedet opbygges, og derefter yderligere 15 minutter, mens de køres. Men de eksisterer!Algoritme til billedkontrol
- Først skal Packer forberede billedet helt.
- Ved siden af testen er der terraform med lokal tilstand, som vi bruger til at implementere dette image.
- Under implementeringen bruges en lille modul, der ligger ved siden af, for at gøre det nemmere at arbejde med billedet.
- Når VM'en er blevet implementeret fra billedet, kan vi begynde at udføre tests. Primært udføres testene på maskinen. Vi kontrollerer, hvordan skripterne kørte ved opstart, og hvordan dæmonerne fungerer. For dette logger vi ind på den netop oprettede maskine via ssh eller winrm og kontrollerer konfigurationens tilstand eller om tjenesterne er startet.
- En lignende situation gælder for integrationstests og moduler til terraform. Her er en kort tabel, der forklarer karakteristikaene ved sådanne tests.

Feedback på pipelinen tager cirka 40 minutter. Alt sker meget langsomt. Det kan bruges til regression, men til ny udvikling er det slet ikke realistisk. Hvis man forbereder sig meget, forbereder running, skripter, kan det forkortes til 10 minutter. Men det er stadig ikke unit-tests, der tager 5 sekunder for 100 tests.
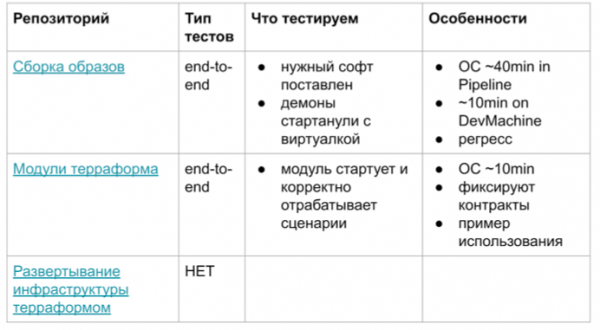
Manglen på unit-tests ved opbygning af billeder eller terraform-moduler tvinger os til at overføre arbejdet til separate tjenester, som vi bare kan kalde via REST eller til Python-scripts.
For eksempel havde vi brug for at få det til at fungere, så når den virtuelle maskine starter, registrerer den sig i tjenesten , og når den virtuelle maskine slettes, fjerner den sig selv.
Da ScaleFT fungerer som en tjeneste, er vi nødt til at arbejde med det via API. Der blev skrevet en wrapper, som vi kan kalde og sige: "Gå ind og slet dette, dette". Den gemmer alle nødvendige indstillinger og adgangsoplysninger.
Vi kan nu skrive normale tests på dette, da det ikke adskiller sig fra almindelig software: en API mockes, du kalder det, og vi ser hvad der sker.
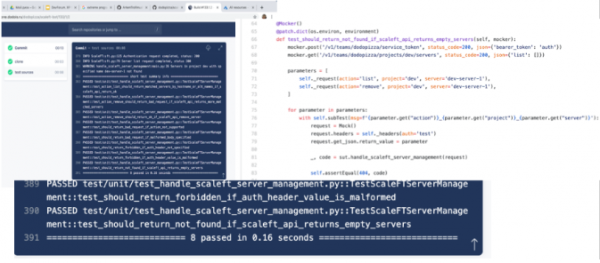
Resultaterne af testene: Unit-testning, som burde give OS på et minut, giver det ikke. Andre højere tests på pyramiden giver effekt, men dækker kun en del af problemerne.
Parprogrammering
Tests are certainly good. You can write many of them, and they can come in different types. They will operate at their levels and provide us with feedback. However, the issue with poor unit tests that yield the quickest OS still remains. Yet, we still desire a fast OS, as it is easy and pleasant to work with. Not to mention the quality of the resulting solution. Fortunately, there are techniques that allow for even faster feedback than unit tests. This is where pair programming comes in.
When writing code, you want to receive feedback on its quality as quickly as possible. Yes, you can write everything in a feature branch (so as not to break anything for anyone), make a pull request on GitHub, assign someone whose opinion carries weight, and wait for a response.
But the wait can be long. People are all busy, and the response, even if it comes, may not be of the highest quality. Let's assume the answer arrives immediately, and the reviewer instantly understands the entire intention, but the feedback still comes with a delay, post-factum. What you want is earlier feedback. This is exactly what pair programming aims for – to get immediate feedback while writing.
Next, I present the styles of pair programming and their applicability in working on IaC:
1. Classic, Experienced + Experienced, change by timer. Two roles – driver and navigator. Two people. They work on the same code and switch roles after a predetermined time interval.
Let's consider the compatibility of our problems with this style:
- Problem: imperfection of tools and means for code development.
Negative impact: longer development time, we slow down, disrupting the pace/rhythm of work.
How we cope: we apply different tooling, a common IDE, and we also learn shortcuts. - Problem: slow deployment.
Negative impact: increases the time to create a working piece of code. We get bored while waiting, our hands reach for something else to do while we wait.
How we cope: we have not overcome this. - Problem: lack of approaches and practices.
Negative impact: no knowledge of what is good or bad. This prolongs the feedback process.
How we cope: exchanging opinions and practices in pair work nearly resolves the issue.
Hovedproblemet med at anvende denne stil i IaC er det ujævne arbejde tempo. I traditionel softwareudvikling har man en meget jævn fremdrift. Man kan bruge fem minutter på at skrive N. Bruge ti minutter på at skrive 2N, 15 minutter – 3N. Her kan man bruge fem minutter på at skrive N og derefter bruge yderligere 30 minutter på at skrive en tiendedel af N. Her ved man ikke noget, man står stille, og det tager tid at finde ud af tingene, hvilket distraherer fra selve programmeringen.
Konklusion: I sin rene form passer det ikke til os.
2. Ping-pong. Denne tilgang indebærer, at én deltager skriver en test, mens en anden implementerer den. Da det er kompliceret med unit-tests, og man er nødt til at skrive en langvarig integreringstest, forsvinder al lethed ved ping-pong.
Jeg kan sige, at vi har forsøgt at adskille ansvarsområderne for design af testscenarier og implementering af koden under dem. Én deltager opfandt scenariet, og i denne del af arbejdet var han ansvarlig, han havde det sidste ord. Den anden var ansvarlig for implementeringen. Det fungerede godt. Kvaliteten af scenariet øges med denne tilgang.
Konklusion: Desværre tillader arbejdstempoet ikke at bruge ping-pong som en praksis for parprogrammering i IaC.
3. Strong Style. Idéen er, at én deltager fungerer som en styrende navigator, mens den anden har rollen som udførende driver. Navigatoren har det fulde beslutningsret. Driveren skriver kun og kan med ord påvirke det, der sker. Roller skifter ikke i lang tid.
Godt til læring, men kræver stærke bløde kompetencer. Her stødte vi på problemer. Teknikken gik svært. Og det handler ikke engang om infrastrukturen.
Konklusion: Potentialet for anvendelse er der, vi giver ikke op på forsøget.
4. Mobbing, swarming og alle kendte, men ikke nævnte stilarter. overvejes ikke, da vi ikke har prøvet dem, og vi kan ikke sige noget om dem i konteksten af vores arbejde.
Generelle resultater af brugen af pair programming:
- Vi har et ujævnt arbejdstempo, som forstyrrer.
- Vi er stødt ind i ikke tilstrækkelige gode bløde færdigheder. Og emneområdet bidrager ikke til at overvinde disse mangler.
- Lange tests og problemer med værktøjerne gør parudvikling besværlig.
5. På trods af dette var der også succeser. Vi opfandt vores egen metode "Sammenkomst - Adskillelse". Lad mig kort beskrive, hvordan den fungerer.
Vi har faste partnere i flere dage (mindre end en uge). Vi arbejder sammen om en opgave. I et stykke tid sidder vi sammen: en skriver, den anden sidder og observerer som supportteam. Så adskiller vi os i et stykke tid, hver især laver uafhængige ting, og så mødes vi igen, synkroniserer os meget hurtigt, laver noget sammen og adskiller os igen.
Planlægning og kommunikation
Den sidste blok af praksis, hvor problemer i OS løses, er organiseringen af arbejdet med selve opgaverne. Dette inkluderer også erfaringsudveksling, der ligger uden for pararbejde. Lad os se på tre praksisser:
1. Opgaver gennem målsystem. Den overordnede projektledelse organiserede vi gennem et træ, der uendeligt strækker sig ind i fremtiden. Teknisk set udføres ledelsen i Miro. Der er en opgave - den er en mellemindstilling. Fra den går der enten mindre mål eller grupper af opgaver. Fra dem kommer selve opgaverne. Alle opgaver oprettes og håndteres på denne tavle.
Denne ordning giver også feedback, som sker én gang om dagen, når vi synkroniserer os på møderne. Tilstedeværelsen af en fælles plan foran alle, som samtidig er struktureret og helt åben, gør, at alle er opdaterede på, hvad der foregår, og hvor langt vi er kommet med fremskridtene.
Fordele ved visuel opfattelse af opgaver:
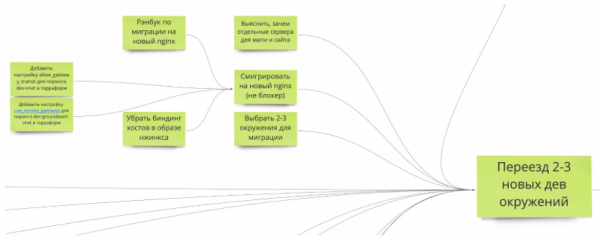
- Årsagssammenhæng. Hver opgave fører til et eller andet globalt mål. Opgaver grupperes efter mindre mål. Infrastrukturens domæne er i sig selv ret teknisk. Det er ikke altid tydeligt med det samme, hvilken konkret indvirkning for eksempel skrivningen af en ranbook om migration til en anden nginx har på virksomheden. Tilstedeværelsen af et mål-kort i nærheden gør det mere forståeligt.

Årsagssammenhæng er en vigtig egenskab ved opgaver. Den svarer direkte på spørgsmålet: "Gør jeg det rette?" - Parallellitet. Vi er ni personer, og det er fysisk umuligt for os alle at kaste os over én opgave. Opgaver fra ét område er heller ikke altid tilstrækkelige. Vi er tvunget til at parallelisere arbejdet mellem små arbejdsgrupper. Disse grupper fokuserer et stykke tid på deres opgave, og de kan få ekstra ressourcer. Der kan også ske ændringer i gruppen; nogle kan tage ferie, andre forbereder et oplæg til DevOps-conf, eller skriver en artikel til Habr. At vide, hvilke mål og opgaver der kan udføres parallelt, bliver meget vigtigt.
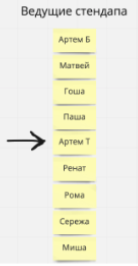
2. Skiftende facilitatorer for morgenmøder. Der er opstået et problem i stand-up møderne – mange opgaver udføres parallelt. Nogle gange er opgaverne svagt relaterede, og der er ikke klarhed over, hvem der laver hvad. Men meningen fra en anden teammedlem er meget vigtig. Det er en ekstra information, som kan ændre tilgangen til opgaveløsningen. Selvfølgelig har du normalt en partner, men råd og vejledning er aldrig overflødige.
For at forbedre denne situation anvendte vi teknikken "Skiftende facilitator for stand-up". Nu roterer de efter en bestemt liste, og det har en effekt. Når din tur kommer, er du nødt til at dykke ned i og forstå, hvad der sker for at kunne lede scrum-mødet ordentligt.
3. Intern demo. Hjælp til at løse opgaver gennem parprogrammering, visualisering af opgavedræet og støtte på scrum-møderne om morgenen er godt, men ikke perfekt. I et par er man kun begrænset af sine egne viden. Opgavedræet hjælper med at få et overblik over, hvem der laver hvad. Men facilitator og kolleger ved morgenmødet vil ikke dykke dybt ned i dine problemer. De kan helt sikkert overse noget.
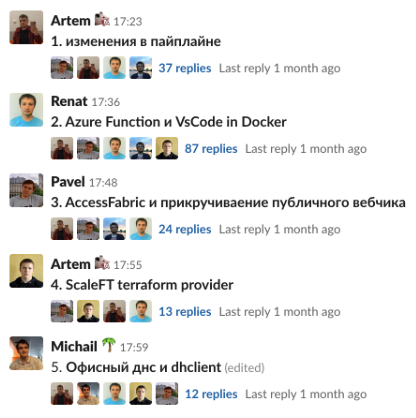
Løsningen blev fundet i at fremvise de udførte arbejder for hinanden og efterfølgende diskutere dem. Vi mødes en gang om ugen i en time og viser detaljerne i løsningerne på opgaverne, vi har arbejdet på i den forgangne uge.
Under demonstrationen skal man afsløre detaljerne om opgaven og sørge for at vise, hvordan det fungerer.
Oplægget kan følges på en tjekliste.1. Indfør konteksten. Hvor kom opgaven fra, og hvorfor var den overhovedet nødvendig?
2. Hvordan blev opgaven løst tidligere? For eksempel, var der behov for masser af musklik eller var det helt umuligt at gøre noget?
3. Hvordan forbedrer vi dette? For eksempel: "Se, nu er der et lille script, her er readme.'
4. Vis, hvordan det fungerer. Det er ønskeligt at gennemføre et brugerflow direkte. Jeg ønsker X, gør Y, ser Z (eller Z). For eksempel, jeg deployer NGINX, tjekker url, får 200 OK. Hvis handlingen tager lang tid, forbered det på forhånd, så det kan vises. Ideelt set bør der ikke være nedbrud en time før demoen, især hvis systemet er skrøbeligt.
5. Forklar, hvor godt problemet er løst, hvilke udfordringer der stadig er, hvad der ikke er færdigt, og hvilke forbedringer der kan komme senere. For eksempel, nu er det CLI, senere vil der være fuld automatik i CI.
Det er ønskeligt, at hver taler holder sig inden for 5-10 minutter. Hvis dit indlæg er væsentligt og vil tage længere tid, skal det aftales på forhånd i kanalen sre-takeover.
Efter den fysiske del følger der en diskussion i tråden. Her kommer den nødvendige feedback på vores opgaver frem.
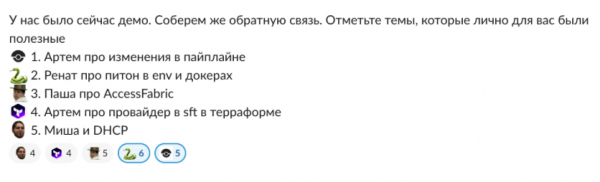
I slutningen gennemføres en afstemning for at afdække hvor nyttig begivenheden har været. Dette er allerede feedback om indlæggets essens og opgavens vigtighed.
Lange konklusioner og hvad der så skal ske
Det kan synes, at tonen i artiklen er noget pessimistisk. Sådan er det ikke. De to lavpraktiske niveauer for at få feedback, nemlig tests og parprogrammering, fungerer. Ikke helt som i traditionel udvikling, men der er en positiv effekt.
Tests, i deres nuværende form, giver kun delvis dækning af koden. Mange konfigurationsfunktioner forbliver utestet. Deres indflydelse på det direkte arbejde ved kodning er lav. Men der er en effekt fra integrationstests, og det er dem, der gør det muligt at udføre refactoring uden frygt. Det er en stor præstation. Desuden forsvinder problemet med at flytte fokus til udvikling i højniveau sprog (hos os python, go). Der er mange checks på 'klæbemidlet', og der er ikke behov for det, kun netop den generelle integration.
Pararbejde afhænger mere af de konkrete mennesker. Der er faktoren af opgaven og vores bløde færdigheder. Nogle gange fungerer det rigtig godt, andre gange mindre godt. Der er bestemt en fordel ved det. Det er klart, at selv med utilstrækkelig overholdelse af reglerne for pararbejde, påvirker selve faktum af fælles opgaveløsning positivt kvaliteten af resultatet. Personligt er det lettere og mere behageligt for mig at arbejde i par.
Mere højniveaus måder at påvirke OS på - planlægning og arbejde med opgaver giver bestemt resultater: kvalitetsvidensudveksling og forbedring af udviklingskvaliteten.
Korte opsummeringer i én sætning
- XP-praksisser fungerer i IaC, men med lavere effektivitet.
- Styrk det, der fungerer.
- Opfind dine egne kompensationsmekanismer og praksisser.
Kilde: habr.com
