

Zabbix er et overvågningssystem. Ligesom ethvert andet system står det over for tre hovedproblemer, som alle overvågningssystemer har: indsamling og behandling af data, opbevaring af historik samt oprydning af denne.
Faserne for indsamling, behandling og lagring af data tager tid. En smule, men for et stort system kan det føre til betydelige forsinkelser. Problemet med opbevaring handler om adgangen til data. De bruges til rapporter, kontroller og triggere. Forsinkelser i adgangen til data påvirker også ydeevnen. Når databaser vokser, skal forældede data slettes. Sletning er en ressourcekrævende operation, som også bruger en del af systemressourcerne.
Problemerne med forsinkelser ved indsamling og opbevaring i Zabbix løses med caching: flere typer caches, caching i databasen. For at løse det tredje problem er caching ikke tilstrækkeligt, derfor har Zabbix implementeret TimescaleDB. Det vil blive præsenteret af Andrej Gushchin — supportingeniør . Andrej har arbejdet i Zabbix-supporten i over 6 år og har direkte erfaring med ydeevne.
Hvordan fungerer TimescaleDB, hvilken ydeevne kan det give sammenlignet med almindelig PostgreSQL? Hvilken rolle spiller Zabbix for TimescaleDB? Hvordan starter man fra bunden, og hvordan migrerer man fra PostgreSQL, og hvilken konfiguration giver bedre ydeevne? Alt dette finder du nedenfor.

Ydelsesudfordringer
Hvert overvågningssystem står over for visse ydelsesudfordringer. Jeg vil tale om tre af dem: indsamling og behandling af data, lagring og oprydning af historik.
Hurtig indsamling og behandling af data. Et godt overvågningssystem skal hurtigt indsamle alle data og behandle dem i henhold til triggerbetingelserne — efter sine egne kriterier. Efter behandling skal systemet også hurtigt gemme disse data i databasen, så de senere kan anvendes.
Opbevaring af historik. Et godt overvågningssystem skal opbevare historik i databasen og give nem adgang til metrikker. Historik er nødvendig for at kunne anvende den i rapporter, grafer, triggere, tærskelværdier og beregnede datapotentialer til advarsler.
Oprydning af historik. Nogle gange kommer der en dag, hvor du ikke behøver at opbevare metrikker. Hvorfor have data indsamlet for 5 år siden, et måned eller to: nogle noder er fjernet, nogle værter eller metrikker er ikke længere nødvendige, fordi de er forældede og ikke længere indsamles. Et godt monitoreringssystem bør bevare historiske data og med jævne mellemrum fjerne dem, så databasen ikke vokser unødigt.
Rydning af forældede data er et kritisk spørgsmål, der har stor indvirkning på databaseydelsen.
Caching i Zabbix
I Zabbix løses den første og anden kald ved hjælp af caching. RAM bruges til indsamling og behandling af data. Historikken opbevares i triggere, diagrammer og beregnede dataelementer. På databasesiden er der et bestemt cache for de primære forespørgsler, såsom diagrammer.
Caching på Zabbix-serverens side er:
- ConfigurationCache;
- ValueCache;
- HistoryCache;
- TrendsCache.
Lad os se nærmere på dem.
ConfigurationCache
Dette er den primære cache, hvor vi opbevarer metrikker, værter, dataelementer, triggere - alt, hvad der er nødvendigt for PreProcessing og dataindsamling.
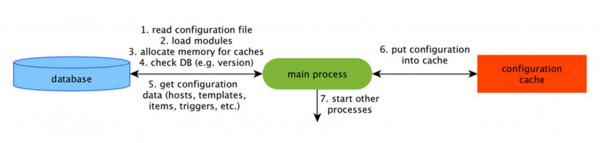
Alt dette gemmes i ConfigurationCache for at undgå unødvendige forespørgsler til databasen. Efter serverens opstart opdaterer vi denne cache, opretter og opdaterer konfigurationerne regelmæssigt.
Dataindsamling
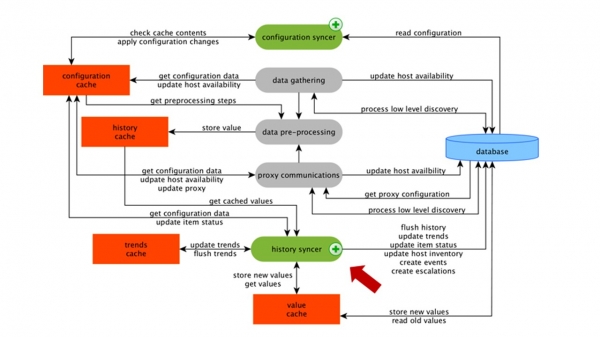
Skemaet er temmelig stort, men det vigtigste i det er indsamlerne. Dette er forskellige "pollers" - indsamling processer. De er ansvarlige for forskellige typer indsamling: de indsamler data via SNMP, IPMI og sender alt dette til PreProcessing.
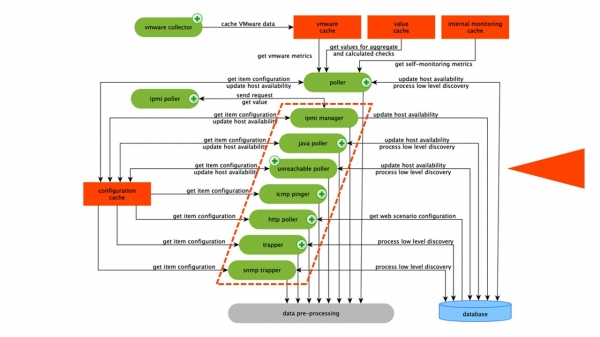 Indsamlerne er indrammet med orange linje.
I Zabbix findes der beregnede aggregationsdataelementer, der er nødvendige for at aggregere tjek. Hvis vi har dem, henter vi data til dem direkte fra ValueCache.
PreProcessing HistoryCache
Alle indsamlerne bruger ConfigurationCache for at få opgaver. Derefter sender de dem til PreProcessing.
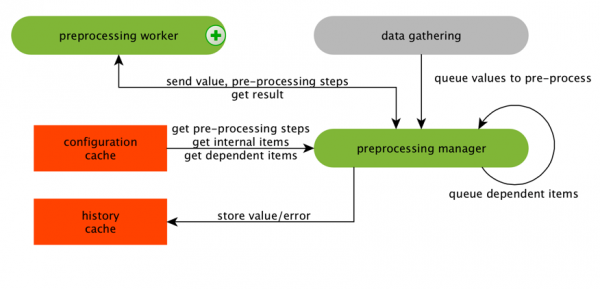
PreProcessing bruger ConfigurationCache for at få PreProcessing-trin. Den behandler disse data på forskellige måder.
Efter databehandling med PreProcessing, gemmer vi dem i HistoryCache for at kunne bearbejde dem. På dette tidspunkt slutter datainsamlingen, og vi går videre til den primære proces i Zabbix - history syncer, da det er en monolitisk arkitektur.
Bemærk: PreProcessing er en ret ressourcekrævende operation. Fra v 4.2 er den flyttet til proxy. Hvis du har en meget stor Zabbix med mange dataelementer og indsamling frekvenser, så letter det arbejdet betydeligt.
ValueCache, history & trends cache
Historik synkronisator - det er den primære proces, der atomisk behandler hvert dataværdi, det vil sige hver værdi.
Historik synkronisator henter værdier fra HistoryCache og tjekker konfigurationen for triggere til beregninger. Hvis der er nogle - beregner den.
Historik synkronisator skaber et event, en eskalering, for at generere alarm, hvis det kræves af konfigurationen, og skriver det ned. Hvis der er triggere til efterfølgende behandling, gemmer den denne værdi i ValueCache, så den ikke skal tilgå historiktabellen. Sådan fyldes ValueCache med de data, der er nødvendige for beregning af triggere og beregnede elementer.
Historik synkronisator skriver alle data til databasen, og den skriver til disken. Behandlingsprocessen afsluttes her.
Caching i databasen
På databasesiden findes der forskellige caches, når du ønsker at se grafer eller rapporter om begivenheder:
Innodb_buffer_poolpå MySQL-siden;shared_bufferspå PostgreSQL-siden;effective_cache_sizepå Oracle-siden;shared_poolpå DB2-siden.
Der er mange andre caches, men disse er de vigtigste for alle databaser. De tillader at holde de data, der ofte er nødvendige for forespørgsler, i RAM. De har deres egne teknologier til dette.
Databasens ydeevne er kritisk
Zabbix-serveren indsamler konstant data og skriver dem. Ved genstart læser den også fra historikken for at fylde ValueCache. Den bruger Zabbix API, som er bygget på webgrænsefladen. Zabbix API tilgår databasen og henter de nødvendige data til grafer, rapporter, begivenhedslister og seneste problemer.
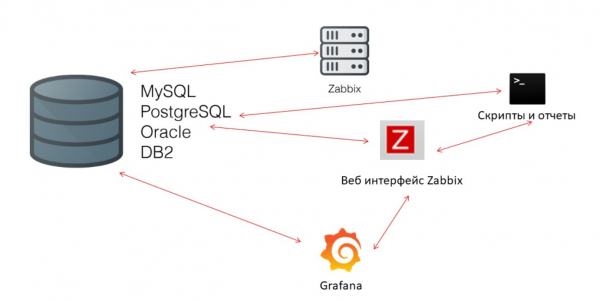
Til visualisering - Grafana. Blandt vores brugere er dette en populær løsning. Den er i stand til direkte at sende forespørgsler via Zabbix API og til databasen, hvilket skaber en vis konkurrence for at hente data. Derfor kræves der en finere og bedre opsætning af databasen for at opfylde hurtige resultater og tests.
Housekeeper
Den tredje præstationsudfordring i Zabbix er oprydning af historikken ved hjælp af Housekeeper. Den overholder alle indstillinger - i dataelementerne er det angivet, hvor mange dage dynamikændringer (trends) skal opbevares.
Vi beregner TrendsCache i realtid. Når dataene kommer ind, aggregerer vi dem i timen og skriver dem til tabeller for dynamikændringer af trends.
Housekeeper startes og fjerner information fra databasen med almindelige 'selects'. Dette er ikke altid effektivt, hvilket kan ses på præstationsgraferne for interne processer.
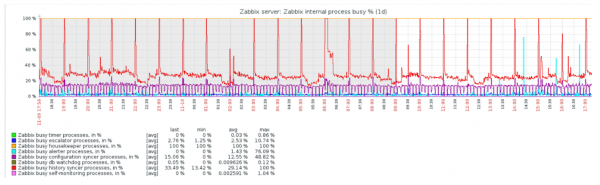
Den røde graf viser, at History syncer konstant er aktiv. Den orange graf ovenfor er Housekeeper, som konstant kører. Den venter på databasen med at slette alle de rækker, den har anmodet om.
Hvornår skal man deaktivere Housekeeper? For eksempel, hvis der er et 'Item ID', og man indser, at de sidste 5.000 rækker skal slettes i en bestemt periode. Dette sker selvfølgelig efter indekserne. Men normalt er datasættet meget stort, og databasen læser stadig fra disken og henter det i cache. Dette er altid en meget dyr operation for databasen og kan, afhængigt af databasens størrelse, føre til præstationsproblemer.
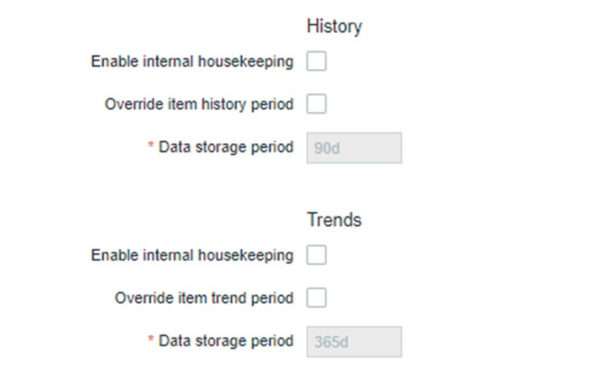
Housekeeper kan helt enkelt deaktiveres. I webgrænsefladen er der en indstilling i 'Administration general' for Housekeeper. Vi deaktiverer den interne housekeeping for den interne trendhistorik, og den styrer ikke dette længere.
Housekeeper er deaktiveret, grafikerne er blevet justeret — hvilke problemer kan opstå i dette tilfælde, og hvad kan hjælpe med at løse tredje gang præstationsproblemet?
Partitionering — sektionering eller parcellering
Partitionering konfigureres normalt på forskellige måder i hver relationel database, som jeg har nævnt. Hver har sin egen teknologi, men de ligner generelt set hinanden. Oprettelse af en ny partition fører ofte til bestemte problemer.
Partitioner konfigureres normalt afhængigt af 'setup' — hvor meget data der genereres på en dag. Som regel sættes partitioneringen til en dag, det er minimum. For trends er den nye partition typisk sat til 1 måned.
Værdierne kan ændre sig i tilfælde af et meget stort 'setup'. Hvis et lille 'setup' er op til 5.000 nvps (nye værdier per sekund), er det gennemsnitlige fra 5.000 til 25.000, og stort er over 25.000 nvps. Det er store og meget store installationer, som kræver grundig konfiguration af selve databasen.
For meget store installationer kan intervallet på en dag ikke være optimalt. Jeg har set MySQL-partitioner på 40 GB eller mere om dagen. Det er en meget stor mængde data, der kan føre til problemer, og det skal reduceres.
Hvad giver partitionering?
Partitionering af tabeller. Ofte er det separate filer på disken. Spørgselsplaner vælger mere optimalt én partition. Partitionering bruges normalt efter interval — det gælder også for Zabbix. Vi bruger 'timestamp' — tid siden epoken. Her er det almindelige tal. Du angiver starten og slutningen på dagen — det er partitionen.
Hurtig sletning — DELETEEn enkelt fil/subtabel vælges, og ikke en rækkeudtræk til sletning.
Afgørende hurtigere dataudtræk. SELECT — bruger en eller flere partitioner og ikke hele tabellen. Hvis du henter data fra for to dage siden, hentes de hurtigere fra databasen, fordi man kun skal indlæse én fil i cachen og ikke en stor tabel.
Ofte forbedrer mange databaser også hastigheden. INSERT — indsættelser i child-tabellen.
TimescaleDB
For version 4.2 har vi set på TimescaleDB. Dette er en udvidelse til PostgreSQL med et nativt interface. Udvidelsen fungerer effektivt med tidsserie data, samtidig med at den bevarer fordelene ved relationelle databaser. TimescaleDB partitionerer også automatisk.
I TimescaleDB findes begrebet hypertabel som du opretter. Denne indeholder chunks — partitioner. Chunks er automatisk styrede fragmenter af hypertabellen, som ikke påvirker andre fragmenter. Hver chunk har sit eget tidsinterval.
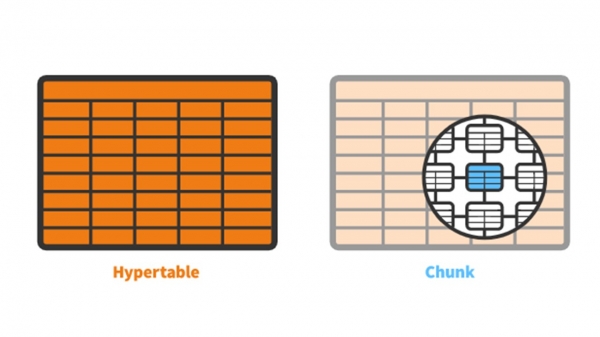
TimescaleDB vs PostgreSQL
TimescaleDB fungerer faktisk effektivt. Producenterne af udvidelsen påstår, at de bruger en mere korrekt algoritme til forespørgselsbehandling, specielt for indsættelser. Når størrelsen på dataset-indlæsninger stiger, opretholder algoritmen konstant ydeevne.
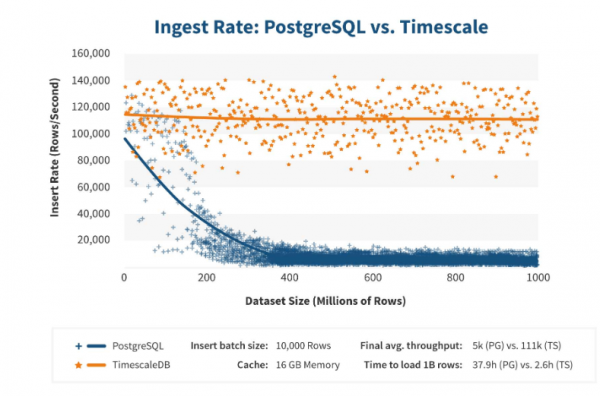
Efter 200 millioner rækker begynder PostgreSQL typisk at falde meget ned og mister ydeevne til 0. TimescaleDB muliggør effektiv indsættelse af "indsættelser" uanset datastørrelse.
Installation
At installere TimescaleDB er ret enkelt for alle pakker. I er alt beskrevet i detaljer — det afhænger af de officielle PostgreSQL-pakker. TimescaleDB kan også samles og kompilere manuelt.
For Zabbix databasen aktiverer vi blot udvidelsen:
echo "CREATE EXTENSION IF NOT EXISTS timescaledb CASCADE;" | sudo -u postgres psql zabbix Du aktiverer udvidelsen og opretter den for Zabbix databasen. Det sidste skridt er at oprette hypertabellen.
Migration af historietabeller til TimescaleDB
Der er en særlig funktion til dette. create_hypertable:
SELECT create_hypertable('history', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_unit', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_log', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_text', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_str', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('trends', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('trends_unit', 'clock', chunk_time_interval => 86400, migrate_data => true);
UPDATE config SET db_extension='timescaledb', hk_history_global=1, hk_trends_global=1
Funktionen har tre parametre. Den første — tabellen i databasen, som skal have oprettet en hypertabel. Den anden — feltet, efter hvilken det skal oprettes chunk_time_interval — intervallet for de chunks, der skal bruges. I mit tilfælde er intervallet én dag — 86 400.
Den tredje parameter — migrere_data. Hvis du sætter true, så overføres alle nuværende data til de forudoprettede chunks. Jeg brugte selv migrere_data. Jeg havde omkring 1 TB, hvilket tog mere end en time. Selv i nogle tilfælde under testning fjernede jeg unødvendige historiske data af tegntype for ikke at overføre dem.
Det sidste trin — OPDATERING: i db_extension sætter vi timescaledb, så databasen forstår, at denne udvidelse findes. Zabbix aktiverer det og bruger den rigtige syntaks og forespørgsler til databasen — de funktioner, der er nødvendige for TimescaleDB.
Hardwarekonfiguration
Jeg brugte to servere. Den første — VMware-maskine. Den er ret lille: 20 processorer Intel® Xeon® CPU E5-2630 v 4 @ 2.20GHz, 16 GB RAM og en SSD-disk på 200 GB.
Jeg installerede PostgreSQL 10.8 på den med Debian 10.8-1.pgdg90+1 og filsystemet xfs. Jeg lavede minimale indstillinger for at bruge netop denne database, bortset fra hvad Zabbix selv vil bruge.
På denne maskine var der også en Zabbix-server, PostgreSQL og belastningsagenter. Jeg havde 50 aktive agenter, der brugte LoadableModule, til hurtigt at generere forskellige resultater: tal, strenge. Jeg fyldte databasen med store mængder data.
Oprindeligt indeholdt konfigurationen 5 000 datategn pr. vært. Næsten hvert element havde en trigger for at gøre det mere ligesom virkelige installationer. I nogle tilfælde var der mere end én trigger. På én netværksnode kom der 3 000-7 000 triggers.
Opdateringsintervallet for datategn — 4-7 sekunderJeg regulerede belastningen ved ikke kun at bruge 50 agenter, men også ved at tilføje flere. Derudover regulerede jeg belastningen dynamisk ved hjælp af datavariabler og reducerede opdateringsintervallet til 4 sekunder.
PostgreSQL. 35.000 nvps
Den første opstart på dette hardware var med en ren PostgreSQL - 35.000 værdier per sekund. Som det ses, tager indsættelse af data brøkdele af et sekund - alt går hurtigt og godt. Den eneste ting er, at SSD-disket på 200 GB hurtigt bliver fyldt.
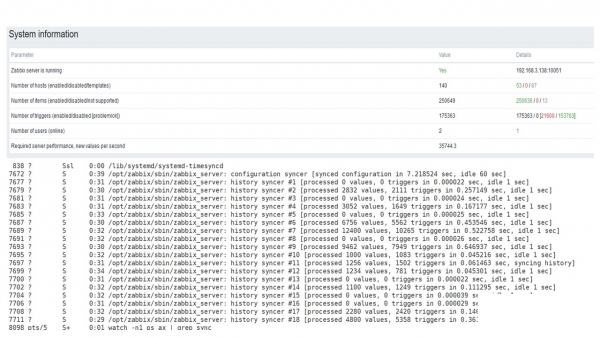
Dette er den standard præstationsdashboard for Zabbix - servere.
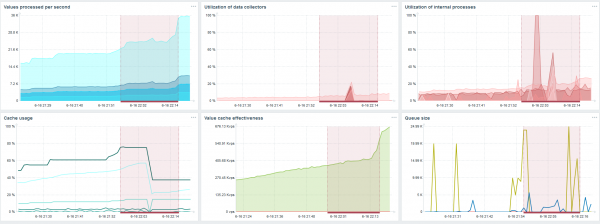
Den første blå graf - antallet af værdier per sekund. Den anden graf til højre - belastningen på opbyggelsesprocesserne. Den tredje - belastningen på de interne opbyggelsesprocesser: history syncers og Housekeeper, som her har været aktiv i noget tid.
Den fjerde graf viser brugen af HistoryCache. Dette er en slags buffer før indsættelse i databasen. Den grønne femte graf viser brugen af ValueCache, altså hvor mange hits ValueCache for triggere - det er flere tusinde værdier per sekund.
PostgreSQL. 50.000 nvps
Derefter øgede jeg belastningen til 50.000 værdier per sekund på det samme hardware.
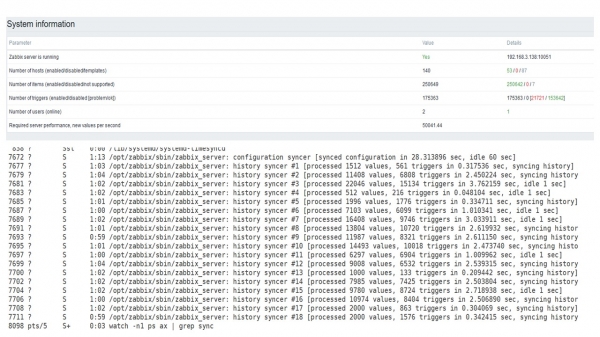
Ved indlæsning med Housekeeper blev 10.000 værdier indsat på 2-3 sekunder.
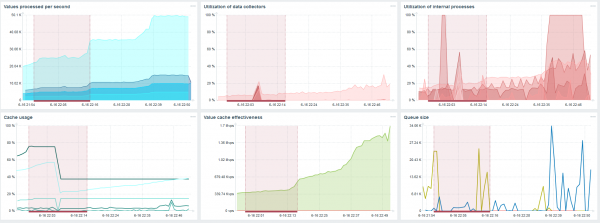
Housekeeper begynder allerede at forstyrre arbejdet.
Af den tredje graf kan vi se, at den samlede belastning af trapperne og history syncers stadig er på 60%. På den fjerde graf begynder HistoryCache, mens Housekeeper arbejder, at blive fyldt ret aktivt. Den blev fyldt op til 20% - det er omkring 0,5 GB.
PostgreSQL. 80.000 nvps
Herefter øgede jeg belastningen til 80.000 værdier per sekund. Det svarer til cirka 400.000 datavaerter og 280.000 triggere.
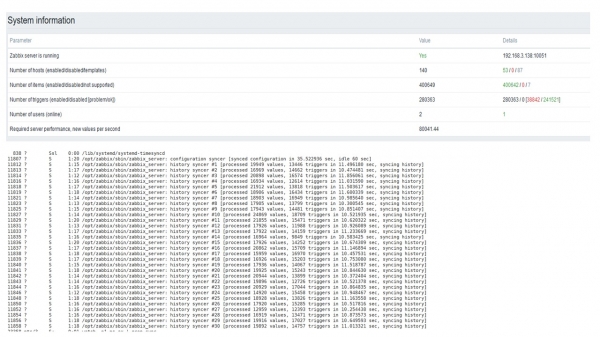
Indsættelsen ved belastning af tretti history syncers er allerede ret høj.
Jeg har også øget forskellige parametre: history syncers, caches.
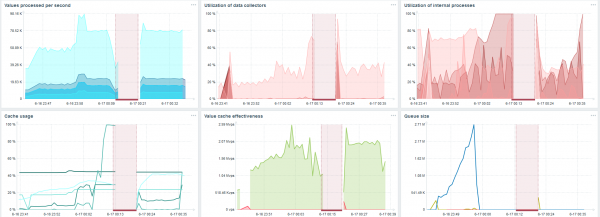
På mit hardware blev belastningen på history syncers øget til maksimum. HistoryCache blev hurtigt fyldt med data - bufferen har opsamlet data til behandling.
Hele tiden overvågede jeg, hvordan CPU, RAM og andre systemparametre blev brugt, og opdagede, at diskudnyttelsen var maksimal.
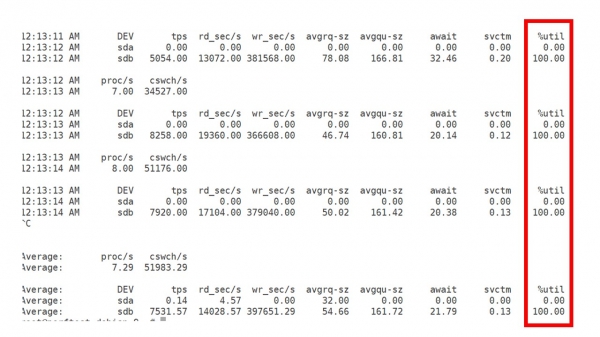
Jeg opnåede udnyttelse af diskens maksimale kapacitet på dette hardware og på denne virtuelle maskine. Ved så høj intensitet begyndte PostgreSQL aktivt at smide data, og disken kunne ikke følge med til skrivning og læsning.
Anden server
Jeg tog en anden server, som allerede havde 48 processorer og 128 GB RAM. Jeg tunede den — satte 60 history syncer op, og opnåede en acceptabel ydelse.
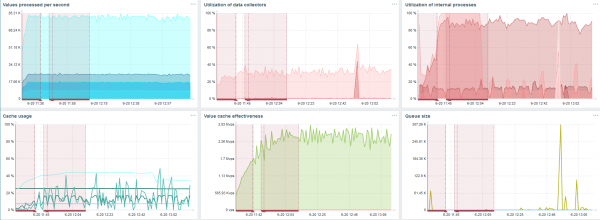
Faktisk, dette er allerede grænsen for ydeevne, hvor der skal gøres noget.
TimescaleDB. 80.000 nvps
Min primære opgave er at teste TimescaleDB's kapacitet under Zabbix-belastning. 80.000 værdier pr. sekund — det er meget, og frekvensen for indsamling af metrics (undtagen Yandex, selvfølgelig) og et ret stort 'setup'.
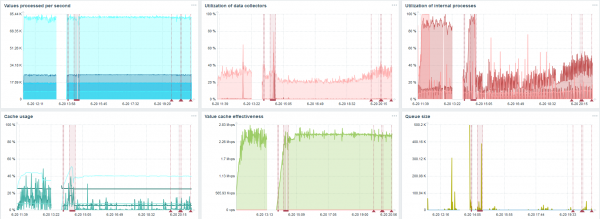
På hver graf er der et hul — det er netop data migrationen. Efter hullerne i Zabbix-serveren ændrede profilen for belastning af history syncer sig meget — faldt med tre gange.
TimescaleDB tillader indsættelse af data næsten tre gange hurtigere og bruger mindre HistoryCache.
Derfor vil data blive leveret rettidigt.
TimescaleDB. 120.000 nvps
Derefter øgede jeg antallet af dataelementer til 500.000. Den primære opgave var at teste TimescaleDB's kapacitet — jeg fik et beregnet resultat på 125.000 værdier pr. sekund.
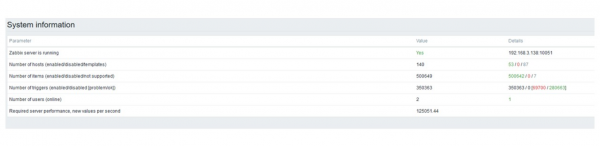
Dette er et arbejds 'setup', der kan fungere i lang tid. Men da min disk kun var 1,5 TB, fyldte jeg den op på et par dage.
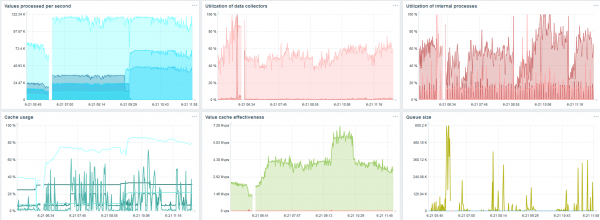
Det vigtigste er, at nye partitioner i TimescaleDB også blev oprettet på samme tid.
For ydeevnen er det helt usynligt. Når partitioner oprettes i MySQL, for eksempel, er alt anderledes. Dette sker normalt om natten, fordi det blokerer for den samlede indsættelse, arbejdet med tabellerne og kan skabe serviceforringelse. I tilfælde af TimescaleDB er det ikke tilfældet.
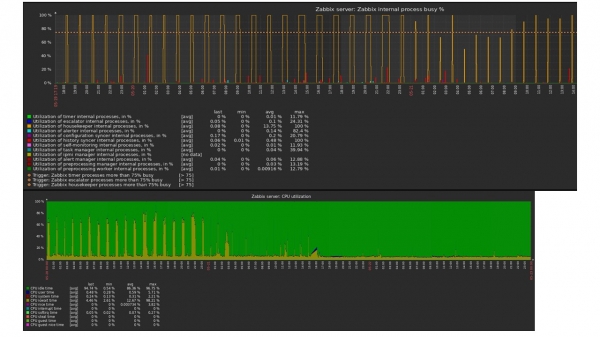
Som eksempel vil jeg vise én graf ud af mange i community. På billedet er TimescaleDB aktiveret, hvilket har fået belastningen af io.weight på processoren til at falde. Brugen af interne proceselementer er også faldet. Faktisk er dette en almindelig virtuel maskine med almindelige bælte-diske, ikke SSD.
Konklusioner
TimescaleDB er en god løsning for små 'setup', som støder på diskens ydeevne. Det vil tillade at fortsætte arbejdet indtil opgradering af databasen til hurtigere hardware.
TimescaleDB er nem at konfigurere, giver ydelsesforbedringer, fungerer godt med Zabbix, og har fordele i forhold til PostgreSQL..
Hvis du bruger PostgreSQL og ikke planlægger at skifte, anbefaler jeg at bruge PostgreSQL med TimescaleDB som en udvidelse i forbindelse med Zabbix.Denne løsning fungerer effektivt indtil middelstore 'setup'.
Når vi taler om 'høj ydelse' — mener vi . Det er ikke længe til, at vi vil præsentere teknologier og metoder, der gør det muligt for tjenester at betjene millioner af brugere. Listen til den 7. og 8. november er allerede lavet, men kan der stadig foreslås.
Tilmeld dig vores og , hvor vi afslører tips til den kommende konference, og lær hvordan du får det maksimale ud af det.
Kilde: habr.com
