

Dette er en myte, der er ret udbredt inden for serverhardware. I praksis er hyperkonvergerende løsninger (hvor alt er samlet i én) nødvendige til mange formål. Historisk set blev de første arkitekturer udviklet af Amazon og Google til deres tjenester. Ideen dengang var at lave en beregningsfarmen af ensartede noder, hvor hver enkelt havde sine egne diske. Alt dette blev samlet af en form for systemdannende software (hypervisor) og opdelt i virtuelle maskiner. Hovedopgaven var minimum indsats til vedligeholdelse af en node og minimum problemer ved skalering: man kunne simpelthen købe endnu et tusinde eller to af de samme servere og tilslutte dem ved siden af. I praksis er dette dog enestående tilfælde, og langt oftere handler det om færre noder og en lidt anden arkitektur.
Men fordelen forbliver den samme - utrolig enkelhed i skalering og administration. Ulempen er, at forskellige opgaver forbruger ressourcer forskelligt, og der vil være mange lokale diske et sted, men lidt RAM et andet sted, og så videre, hvilket betyder, at udnyttelsen af ressourcerne vil falde med forskellige typer opgaver.
Det endte med, at du betalte 10–15% mere for bekvemmeligheden ved opsætningen. Det er det, der skabte myten fra overskriften. Vi har længe ledt efter, hvor teknologien ville blive anvendt optimalt, og vi fandt det. Faktisk havde Cisco ikke deres egne SAN-løsninger, men de ønskede hele servermarkedet. Og de lavede Cisco Hyperflex - en løsning med lokale lagre på noderne.
Og pludselig viste det sig at være en meget god løsning til backup datacentre (Disaster Recovery). Hvorfor og hvordan - det vil jeg nu fortælle. Og jeg vil vise cluster-tests.
Hvor det er nødvendigt
Hyperkonvergens er:
- Flytning af diske til beregningsnoder.
- Fuldstændig integration af lagringssystemet med virtualiseringssystemet.
- Flytning/integration med netværkssystemet.
Denne kombination muliggør realisering af mange funktioner ved SAN-niveauet i virtualiseringen, alt sammen fra én administrationsgrænseflade.
I vores virksomhed er projekter til design af backup datacentre meget eftertragtede, og der vælges ofte netop hyperkonvergerende løsninger på grund af de mange muligheder for replikation (helt ned til metrokluster) lige ud af boksen.
I tilfælde af backup datacentre taler man normalt om en fjernlokation, der ligger på den anden side af byen eller endda i en anden by. Det gør det muligt at gendanne kritiske systemer i tilfælde af delvis eller total svigt af det primære datacenter. Data fra produktionen replikeres konstant til dette sted, og denne replikering kan finde sted på applikationsniveau eller på blokniveau (Lagringssystem).
Derfor vil jeg nu fortælle om systemets opbygning og tests, og derefter om et par scenarier for praktisk anvendelse med data om omkostningsbesparelser.
Tests
Vores implementering består af fire servere, hver med 10 SSD-diske på 960 GB. Der er en dedikeret disk til caching af skriveoperationer og opbevaring af en service virtuel maskine. Selve løsningen er i fjerde version. Den første var åbenlyst ustabil (ifølge anmeldelser), den anden var stadig lidt rå, den tredje er allerede ret stabil, og denne kan betragtes som en udgivelse efter afslutningen af beta-testning på et bredere publikum. I løbet af testningen har jeg ikke oplevet problemer, alt fungerer som en drøm.
Ændringer i v4En masse fejl er blevet rettet.
Oprindeligt kunne platformen kun arbejde med hypervisoren VMware ESXi og understøttede et lille antal noder. Udrulningsprocessen var heller ikke altid vellykket og krævede nogle gange genstart af flere trin, der var problemer med opdatering fra gamle versioner, og data i GUI'en blev ikke altid vist korrekt (selvom jeg stadig ikke er begejstret for visningen af præstationsgrafer), nogle gange opstod der problemer i relation til virtualisering.
Nu er alle børnesygdomme blevet rettet, HyperFlex understøtter både ESXi og Hyper-V, plus muligheden for:
- Oprettelse af et udvidet cluster.
- Oprettelse af et cluster til kontorer uden brug af Fabric Interconnect, fra to til fire noder (vi køber kun serverne).
- Mulighed for at arbejde med eksterne lagringssystemer.
- Understøttelse af containere og Kubernetes.
- Oprettelse af tilgængelighedszoner.
- Integration med VMware SRM, hvis den indbyggede funktionalitet ikke er tilfredsstillende.
Arkitekturen adskiller sig ikke væsentligt fra løsningerne fra de store konkurrenter, og vi har ikke genopfundet hjulet. Alt dette kører på virtualiseringsplatformen VMware eller Hyper-V. Det er hardwaremæssigt placeret på servere, der er udviklet af Cisco UCS. Der er dem, der hader platformen på grund af den relativt komplekse indledende opsætning, de mange knapper, det ikke-trivielle skabelonsystem og afhængigheder, men der er også dem, der har opnået zen, har taget ideen til sig og ikke længere ønsker at arbejde med andre servere.
Vi vil fokusere på løsningen til VMware, da løsningen oprindeligt blev udviklet til dette og har en større funktionalitet, mens Hyper-V er blevet tilpasset undervejs for at indhente konkurrenterne og imødekomme markedets forventninger.
Der er et cluster af servere, som er fyldt med diske. Der er diske til datalagring (SSD eller HDD — efter dit valg og behov), og der er én SSD-disk til caching. Når data skrives til datastoret, gemmes dataene på cache-laget (den dedikerede SSD-disk og RAM i service-VM'en). Samtidig sendes datablokken til noderne i clusteret (antallet af noder afhænger af replikationsfaktor for clusteret). Efter bekræftelse fra alle noder om succesfuld skrivning sendes bekræftelse af skrivningen til hypervisoren og videre til VM'en. De skrevne data dedupliceres, komprimeres og skrives til lagerdiske i baggrunden. I denne proces skrives der altid store blokke til lagerdiskene i rækkefølge, hvilket reducerer belastningen på lagerdiskene.
Deduplication og kompression er konstant aktiveret og kan ikke deaktiveres. Læsning af data sker direkte fra lagerdiskene eller fra RAM-cachen. Hvis der benyttes en hybridkonfiguration, caches læsningen også på SSD-disken.
Dataene er ikke knyttet til den nuværende placering af den virtuelle maskine og fordeles jævnt mellem noderne. Denne tilgang gør det muligt at belastning af alle diske og netværksgrænseflader ensartet. En åbenlys ulempe opstår: vi kan ikke maksimalt reducere læsningslatenstiden, da der ikke er nogen garanti for, at dataene er tilgængelige lokalt. Men jeg mener, at det er en ubetydelig pris at betale i forhold til de opnåede fordele. Desuden er latenstiderne i netværket nået til niveauer, som næsten ikke påvirker det samlede resultat.
Hele logikken for diskunderstøttelsen varetages af en speciel service-VM, Cisco HyperFlex Data Platform controller, som oprettes på hver lagringsnode. I vores konfiguration blev der tildelt otte vCPU og 72 GB RAM til service-VM'en, hvilket ikke er så lidt. Husk, at selve værtsystemet har 28 fysiske kerner og 512 GB RAM.
Service-VM'en har direkte adgang til de fysiske diske ved hjælp af SAS-controller bypass i VM'en. Kommunikation med hypervisoren foregår gennem en speciel IOVisor-modul, som opsnapper input-output-operationer, og via en agent, der muliggør kommandooverførsel til hypervisorens API. Agenten er ansvarlig for arbejde med HyperFlex-snapshots og kloner.
I hypervisoren monteres diskressourcer som NFS- eller SMB-deling (afhængigt af typen af hypervisor, gæt hvilken der er hvilken). Under motorhjelmen er det et distribueret filsystem, der muliggør tilføjelse af funktioner til mere avancerede SAN-løsninger: fin tildeling af volumener, komprimering og deduplisering, snapshots ved hjælp af Redirect-on-Write teknologi, synkron/ asynkron replikation.
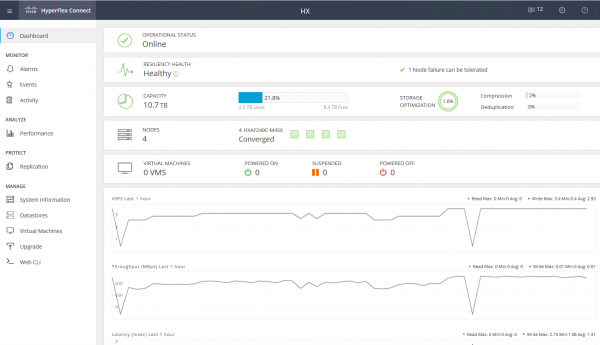
Service-VM'en giver adgang til WEB-grænsefladen for styring af HyperFlex-understøttelsen. Der er integration med vCenter, og de fleste daglige opgaver kan udføres derfra, men datalagre er for eksempel lettere at opdele fra en særskilt webgrænseflade, hvis du allerede er skiftet til det hurtige HTML5-interface, eller du kan bruge en fuld Flash-klient med komplet integration. I service-webgrænsefladen kan du se systemets ydeevne og detaljeret status.
Der findes også en anden type node i klyngen - compute nodes. Dette kan være rack- eller blade-servere uden indbyggede diske. På disse servere kan der køres VM'er, hvis data opbevares på servere med diske. Fra et datatilgangsperspektiv er der ingen forskel mellem nodetyperne, da arkitekturen forudsætter abstraktion fra den fysiske placering af dataene. Det maksimale forhold mellem compute nodes og storage nodes er 2:1.
Brugen af compute nodes øger fleksibiliteten ved skalering af klyngens ressourcer: Vi behøver ikke nødvendigvis at købe noder med diske, hvis vi kun har behov for CPU/RAM. Desuden kan vi tilføje en blade-skuffe og opnå besparelser ved placering af servere i rack.
Som resultat har vi en hyperkonvergeret platform med følgende funktioner:
- Op til 64 noder i klyngen (op til 32 lagringsnoder).
- Det minimale antal noder i klyngen er tre (to for Edge-klyngen).
- Mekanisme til dat redundans: spejling med replikationsfaktor 2 og 3.
- Metro-klynge.
- Asynkron replikation af VM til en anden HyperFlex-klynge.
- Orkestrering af VM-skift til et eksternt datacenter.
- Native snapshots ved hjælp af Redirect-on-Write teknologi.
- Op til 1 PB nyttigt rum ved replikationsfaktor 3 og uden at tage højde for deduplication. Replikationsfaktor 2 tages ikke i betragtning, da det ikke er en mulighed for seriøs salg.
En anden stor fordel er enkelheden i administration og deployment. Alle kompleksiteterne ved konfigurationen af UCS-serverne håndteres af en specialiseret VM, forberedt af ingeniører fra Cisco.
Konfiguration af testmiljøet:
- 2 x Cisco UCS Fabric Interconnect 6248UP som styringsklynge og netværkskomponenter (48 porte, der arbejder i Ethernet 10G/FC 16G-tilstand).
- Fire Cisco UCS HXAF240 M4 servere.
Server specifikationer:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM/PC4-19200/dual rank/x4/1.2v
Netværk
UCSC-MLOM-CSC-02 (VIC 1227). 2 porte 10G Ethernet
Storage HBA
Cisco 12G Modular SAS Pass-through Controller
Lagringsdiske
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
Flere konfigurationsmulighederUdover det valgte hardware er følgende muligheder tilgængelige i øjeblikket:
- HXAF240c M5.
- En eller to CPU’er fra Intel Silver 4110 til Intel Platinum I8260Y. Anden generation er tilgængelig.
- 24 hukommelsessloths, moduler fra 16 GB RDIMM 2600 til 128 GB LRDIMM 2933.
- Fra 6 til 23 diske til data, en cache-disk, en systemdisk og en bootdisk.
Kapacitetsdrev
- HX-SD960G61X-EV 960GB 2.5 tommer Enterprise Value 6G SATA SSD (1X udholdenhed) SAS 960 GB.
- HX-SD38T61X-EV 3.8TB 2.5 tommer Enterprise Value 6G SATA SSD (1X udholdenhed) SAS 3.8 TB.
- Cache-drev
- HX-NVMEXPB-I375 375GB 2.5 tommer Intel Optane Drev, Extreme Perf & Endurance.
- HX-NVMEHW-H1600* 1.6TB 2.5 tommer Ent. Perf. NVMe SSD (3X udholdenhed) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400GB 2.5 tommer Ent. Perf. 12G SAS SSD (10X udholdenhed) SAS 400 GB.
- HX-SD800GBENK9** 800GB 2.5 tommer Ent. Perf. 12G SAS SED SSD (10X udholdenhed) SAS 800 GB.
- HX-SD16T123X-EP 1.6TB 2.5 tommer Enterprise performance 12G SAS SSD (3X udholdenhed).
System / Log Drev
- HX-SD240GM1X-EV 240GB 2.5 tommer Enterprise Value 6G SATA SSD (kræver opgradering).
Boot Drev
- HX-M2-240GB 240GB SATA M.2 SSD SATA 240 GB.
Netværksforbindelse via 40G, 25G eller 10G Ethernet porte.
Som FI kan være HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G).
Selve testen
Til test af lagersystemet brugte jeg HCIBench 2.2.1. Dette er et gratis værktøj, der gør det muligt at automatisere belastningen fra flere virtuelle maskiner. Selve belastningen genereres med almindelig fio.
Vores klynge består af fire noder, replikationsfaktor 3, alle diske er Flash.
For testing, I created four data stores and eight virtual machines. The write tests assume a scenario where the caching disk does not overflow.
The test results are as follows:
100 % Read 100 % Random
0 % Read 100% Random
Block/Queue Depth
128
256
512
1024
2048
128
256
512
1024
2048
4K
0.59 ms 213804 IOPS
0.84 ms 303540 IOPS
1.36 ms 374348 IOPS
2.47 ms 414116 IOPS
4.86 ms 420180 IOPS
2.22 ms 57408 IOPS
3.09 ms 82744 IOPS
5.02 ms 101824 IOPS
8.75 ms 116912 IOPS
17.2 ms 118592 IOPS
8K
0.67 ms 188416 IOPS
0.93 ms 273280 IOPS
1.7 ms 299932 IOPS
2.72 ms 376484 IOPS
5.47 ms 373176 IOPS
3.1 ms 41148 IOPS
4.7 ms 54396 IOPS
7.09 ms 72192 IOPS
12.77 ms 80132 IOPS
16K
0.77 ms 164116 IOPS
1.12 ms 228328 IOPS
1.9 ms 268140 IOPS
3.96 ms 258480 IOPS
3.8 ms 33640 IOPS
6.97 ms 36696 IOPS
11.35 ms 45060 IOPS
32K
1.07 ms 119292 IOPS
1.79 ms 142888 IOPS
3.56 ms 143760 IOPS
7.17 ms 17810 IOPS
11.96 ms 21396 IOPS
64K
1.84 ms 69440 IOPS
3.6 ms 71008 IOPS
7.26 ms 70404 IOPS
11.37 ms 11248 IOPS
Bold values indicate levels beyond which there is no increase in performance, sometimes even degradation. This is due to being limited by network/controller/disk performance.
- Sequential read 4432 MB/s.
- Sequential write 804 MB/s.
- In the event of a controller failure (virtual machine or host failure), performance drops by half.
- In the event of a storage disk failure, performance drops by a third. Rebuilding the disk takes 5% of each controller's resources.
With a small block, we are limited by the performance of the controller (virtual machine), which is at 100% CPU load; when increasing the block size, we are limited by port throughput. 10 Gbps is insufficient to unlock the potential of AllFlash systems. Unfortunately, the provided demo stand does not allow testing at 40 Gbps.
From my impressions of the tests and studying the architecture, due to the algorithm distributing data among all hosts, we achieve scalable predictable performance, but this also poses a limitation in reading, as more could be squeezed from local disks; a higher performance network could help, for example, FI is available at 40 Gbps.
Also, one disk for caching and deduplication can be a limitation; effectively, in this setup, we can write to four SSDs. It would be great to have the ability to increase the number of caching disks and see the difference.
Real usage
For organizing a backup data center, two approaches can be used (we are not considering placing backups at a remote site):
- Active-Passive. Alle applikationer er placeret i det primære datacenter. Replikationen er synkron eller asynkron. I tilfælde af at det primære datacenter falder ned, skal vi aktivere det sekundære. Dette kan gøres manuelt / via scripts / orkestreringsapplikationer. Her får vi RPO, der er proportional med replikationsfrekvensen, og RTO afhænger af reaktionen og evnerne hos administratoren samt kvaliteten af planlægning / test af failover-planen.
- Active-Active. I dette tilfælde er der kun synkron replikation, og tilgængeligheden af datacentrene bestemmes af quorum / en dommer, der strengt er placeret på en tredje lokation. RPO = 0, og RTO kan nå 0 (hvis applikationen tillader det) eller være lig med tiden til at håndtere fejlen på en node i virtualiseringsklassen. På virtualiseringsniveauet oprettes der en strakt (Metro) klynge, der kræver Active-Active SAN.
Normalt ser vi hos kunderne allerede implementerede arkitekturer med klassisk SAN i det primære datacenter, så vi designer en yderligere til replikation. Som jeg nævnte, tilbyder Cisco HyperFlex asynkron replikation og oprettelse af en strakt virtualiseringsklynge. I dette tilfælde har vi ikke brug for et dedikeret SAN på niveauet Midrange og op med dyre replikationsfunktioner og Active-Active adgang til data på to SAN.
Scenario 1: Vi har et primært og et sekundært datacenter, virtualiseringsplatformen er VMware vSphere. Alle produktionssystemer er placeret i det primære datacenter, og replikationen af virtuelle maskiner udføres på hypervisor niveau, så vi behøver ikke holde VM'er tændt i det sekundære datacenter. Databaser og specielle applikationer replikeres ved hjælp af indbyggede værktøjer, og vi holder VM'er tændt. Ved nedbrud af det primære datacenter starter vi systemerne i det sekundære datacenter. Vi antager, at vi har cirka 100 virtuelle maskiner. Så længe det primære datacenter er aktivt, kan vi køre testmiljøer og andre systemer i det sekundære datacenter, som kan slukkes i tilfælde af failover af det primære datacenter. Der er også en mulighed for tovejsreplikation. Hvad angår udstyret, ændrer der sig ikke noget.
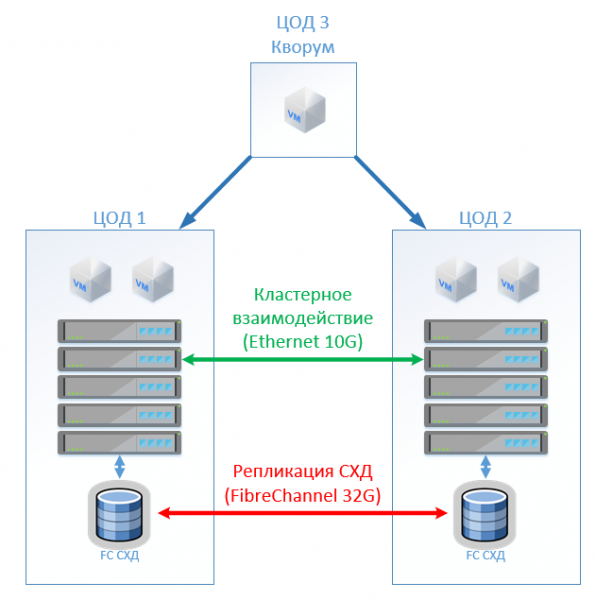
I tilfælde af klassisk arkitektur vil vi installere en hybrid SAN i hvert datacenter med adgang via FibreChannel, tiering, deduplikerings- og komprimeringsfunktioner (dog ikke online), 8 servere pr. sted, samt 2 FibreChannel og 10G Ethernet switches. Til replikation og styring af failover i den klassiske arkitektur kan vi anvende VMware-værktøjer (Replication + SRM) eller tredjepartsløsninger, der vil være lidt billigere og undertiden mere praktiske.
Illustrationen viser diagrammet.
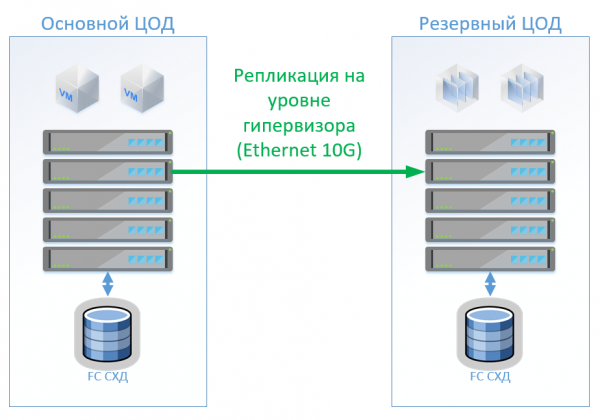
I tilfælde af brug af Cisco HyperFlex får vi følgende arkitektur:
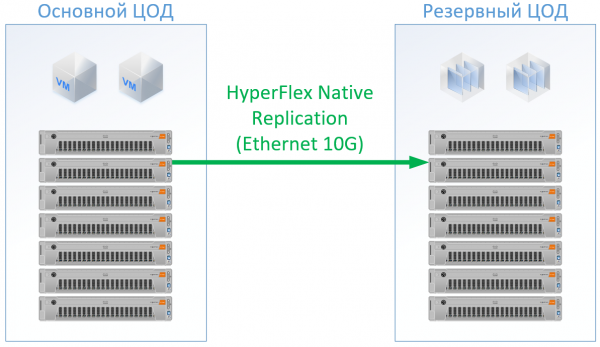
Til HyperFlex har jeg brugt servere med store CPU/RAM ressourcer, da en del af ressourcerne går til VM'en for HyperFlex-controlleren. På CPU og hukommelse har jeg oven i købet lidt overdimensioneret konfigurationen for HyperFlex for ikke at favorisere Cisco og sikre ressourcer til de øvrige VMs. Dermed kan vi undvære FibreChannel switches, og vi behøver ikke Ethernet-porte til hver server, da lokal trafik switches internt i FI.
Resultatet blev følgende konfiguration for hvert datacenter:
Servere
8 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
SAN
Hybrid SAN med FC Front-End (20TB SSD, 130 TB NL-SAS)
—
LAN
2 x Ethernet switch 10G med 12 porte
—
SAN
2 x FC switch 32/16Gb med 24 porte
2 x Cisco UCS FI 6332
Licenser
VMware Ent Plus
Replikation og/eller orkestrering af VM-failover
VMware Ent Plus
For Hyperflex inkluderede jeg ikke licenser til replikationssoftware, da dette er tilgængeligt out-of-the-box.
Til den klassiske arkitektur valgte jeg en leverandør, der har bevist at være en kvalitets- og omkostningseffektiv producent. Jeg anvendte standard rabat for hver specifik løsning og opnåede reelle priser.
Løsningen på Cisco HyperFlex viste sig at være 13% billigere.
Scenario 2: oprettelse af to aktive datacentre. I dette scenario designer vi et strakt cluster på VMware.
Den klassiske arkitektur består af virtualiseringsservere, SAN (FC-protokol) og to SAN-enheder, der kan læse og skrive til det, der strækkes mellem dem. På hver SAN tager vi højde for nyttig kapacitet til lokationen.
Med HyperFlex opretter vi blot et Stretch Cluster med det samme antal noder på begge placeringer. I dette tilfælde anvendes en replikationsfaktor på 2+2.
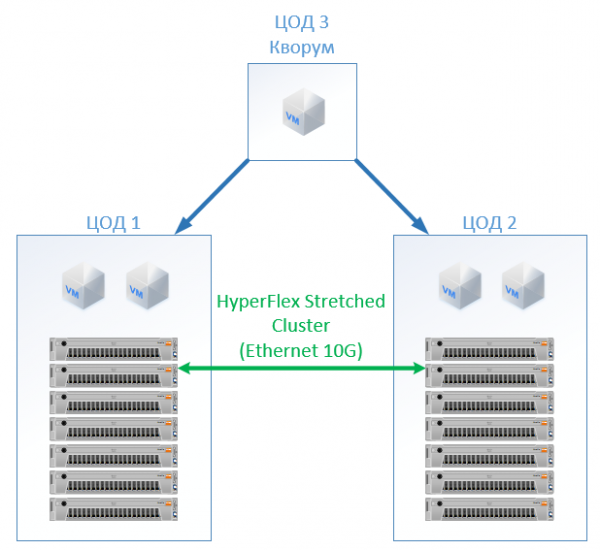
Resultatet blev følgende konfiguration:
Klassisk arkitektur
HyperFlex
Servere
16 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
SAN
2 x AllFlash SAN (150 TB SSD)
—
LAN
4 x Ethernet switch 10G med 24 porte
—
SAN
4 x FC switch 32/16Gb med 24 porte
4 x Cisco UCS FI 6332
Licenser
VMware Ent Plus
VMware Ent Plus
I mine medregninger har jeg ikke taget netværksinfrastrukturen, omkostningerne ved datacenter osv. med i betragtning: de vil være de samme for den klassiske arkitektur og for HyperFlex-løsningen.
Med hensyn til omkostningerne er HyperFlex blevet 5% dyrere. Det er værd at bemærke, at for ressourcerne CPU/RAM har jeg haft en skævvridning for Cisco, da jeg fyldte hukommelsescontrollerkanalerne jævnt i konfigurationen. Omkostningerne er lidt højere, men ikke uforholdsmæssigt, hvilket tydeligt indikerer, at hyperkonvergens ikke nødvendigvis er en „leg“ for de rige, men kan konkurrere med den standard tilgang til opbygning af datacentre. Det kan også være interessant for dem, der allerede har Cisco UCS-servere og den nødvendige infrastruktur til dem.
Fordelene inkluderer ingen omkostninger til administration af SAN og SANS, online-komprimering og deduplikation, et enkelt supportpunkt (virtualisering, servere, de samme - SANS), pladsbesparelse (men ikke i alle scenarier), forenkling af driften.
Med hensyn til support får du den fra én leverandør - Cisco. Hvis man skal dømme ud fra erfaringen med Cisco UCS-servere, kan jeg godt lide den, da jeg aldrig har været nødt til at åbne HyperFlex; alt fungerede som det skulle. Ingeniørerne svarer hurtigt og kan løse ikke kun standardproblemer, men også komplekse grænsetilfælde. Nogle gange henvender jeg mig til dem med spørgsmål som: „Kan man gøre dette, vedhæfte det?“ eller „Jeg har konfigureret noget, og det vil ikke fungere. Hjælp mig!“ - de finder tålmodigt den nødvendige vejledning og viser de rigtige handlinger, de vil ikke svare: „Vi løser kun hardwareproblemer“.
Links
- Min e-mail — StGeneralov@croc.ru
Kilde: habr.com
