

Det online anbefalingssystem for videoinhold, som vi arbejder på, er et lukket kommercielt udviklingsprojekt og består teknisk af en flerkomponent cluster bestående af både egne og open source komponenter. Formålet med denne artikel er at beskrive implementeringen af en Docker Swarm klustersystem til staging-miljøet, uden at forstyrre den etablerede workflow af vores processer under begrænset tid. Denne fortælling er opdelt i to dele. Den første del beskriver CI/CD før brugen af Docker Swarm, mens den anden del omhandler processen for dens implementering. For dem, der ikke er interesserede i at læse første del, kan de roligt springe til anden del.
Del I
I et fjernt år var det nødvendigt at opsætte CI/CD-processen så hurtigt som muligt. Et af betingelserne var ikke at bruge Docker til deployment af de udviklede komponenter af flere grunde:
- for at sikre mere pålidelig og stabil drift af komponenter i produktion (dvs., det var i realiteten en krav om ikke at bruge virtualisering)
- de førende udviklere ønskede ikke at arbejde med Docker (mærkeligt, men sådan var det)
- af ideologiske grunde fra R&D ledelsen
Infrastrukturen, stakken og de omtrentlige indledende krav til MVP var som følger:
- 4 servere Intel® X5650 med Debian (en mere kraftfuld maskine til udvikling)
- Udviklingen af egne specialbyggede komponenter foregår i C++, Python3
- De primære 3rd party værktøjer der anvendes: Kafka, Clickhouse, Airflow, Redis, Grafana, Postgresql, Mysql, …
- Pipelines til opbygning og test af komponenter separat for debug og release
Et af de første spørgsmål, der skal besvares i den indledende fase, er, hvordan de specialbyggede komponenter vil blive rullet ud i et givent miljø (CI/CD).
Tredjeparts komponenter besluttede at installere og opdatere systemisk. Custom-apps, der udvikles i C++ eller Python, kan implementeres på flere måder. Blandt dem er for eksempel: oprettelse af systempakker, afsendelse til et repository af sammensatte billeder og derefter installation på servere. Af en eller anden grund blev der valgt en anden metode, nemlig: med CI kompilere de eksekverbare filer til applikationerne, oprette et virtuelt projektmiljø, installere py-moduler fra requirements.txt, og alle disse artefakter sendes sammen med konfigurationer, scripts og det tilhørende applikationsmiljø til serverne. Derefter startes applikationerne af en virtuel bruger uden administratorrettigheder.
Gitlab-CI blev valgt som CI/CD-system. Den resulterende pipeline så omtrent sådan ud:
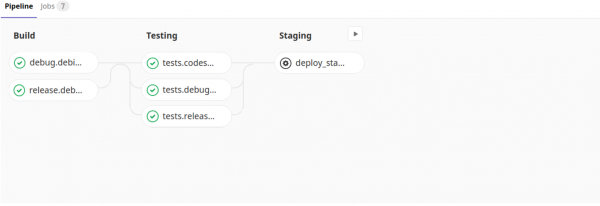
Strukturelt så gitlab-ci.yml således ud
---
variables:
  # Minimum CPU-version på serverne, hvor klyngen implementeres
  CMAKE_CPUTYPE: "westmere"

  DEBIAN: "MYREGISTRY:5000/debian:latest"

before_script:
  - eval $(ssh-agent -s)
  - ssh-add  ~/.ssh/config

stages:
  - build
  - testing
  - deploy

debug.debian:
  stage: build
  image: $DEBIAN
  script:
    - cd builds/release && ./build.sh
    paths:
      - bin/
      - builds/release/bin/
    when: always
release.debian:
  stage: build
  image: $DEBIAN
  script:
    - cd builds/release && ./build.sh
    paths:
      - bin/
      - builds/release/bin/
    when: always

## testing stage
tests.codestyle:
  stage: testing
  image: $DEBIAN
  dependencies:
    - release.debian
  script:
    - /bin/bash run_tests.sh -t codestyle -b "${CI_COMMIT_REF_NAME}_codestyle"
tests.debug.debian:
  stage: testing
  image: $DEBIAN
  dependencies:
    - debug.debian
  script:
    - /bin/bash run_tests.sh -e codestyle/test_pylint.py -b "${CI_COMMIT_REF_NAME}_debian_debug"
  artifacts:
    paths:
      - run_tests/username/
    when: always
    expire_in: 1 week
tests.release.debian:
  stage: testing
  image: $DEBIAN
  dependencies:
    - release.debian
  script:
    - /bin/bash run_tests.sh -e codestyle/test_pylint.py -b "${CI_COMMIT_REF_NAME}_debian_release"
  artifacts:
    paths:
      - run_tests/username/
    when: always
    expire_in: 1 week

## staging stage
deploy_staging:
  stage: deploy
  environment: staging
  image: $DEBIAN
  dependencies:
    - release.debian
  script:
    - cd scripts/deploy/ &&
        python3 createconfig.py -s $CI_ENVIRONMENT_NAME &&
        /bin/bash install_venv.sh -d -r ../../requirements.txt &&
        python3 prepare_init.d.py &&
        python3 deploy.py -s $CI_ENVIRONMENT_NAME
  when: manual
Det skal bemærkes, at bygning og testning udføres på sit eget billede, hvor alle nødvendige systempakker allerede er installeret, og andre indstillinger er blevet udført.
Selvom hver af disse scripts i jobberne er interessante på sin egen måde, vil jeg selvfølgelig ikke beskrive dem, da det ville tage betydelig tid, og det er ikke formålet med artiklen. Jeg vil blot påpege, at deploy-stadiet består af en sekvens af scriptopkald:
- createconfig.py — opretter en fil settings.ini med komponentindstillinger i forskellige miljøer til efterfølgende deployment (Preproduction, Production, Testing, …)
- install_venv.sh — opretter et virtuelt miljø for py-komponenter i en bestemt mappe og kopierer det til fjernservere
- prepare_init.d.py — forbereder start-stop scripts for komponenter baseret på en skabelon
- deploy.py — placer og genstart nye komponenter
Tiden gik. Staging-fasen blev erstattet af preproduction og production. Der kom support til produktet på endnu en distribution (CentOS). Der kom yderligere 5 kraftige fysiske servere og et dusin virtuelle. Det blev gradvist mere udfordrende for udviklere og testere at køre deres opgaver i et miljø, der var nogenlunde tæt på en driftssituation. I den tid blev det klart, at det var umuligt at klare sig uden det...
Del II
Så, vores cluster er et imponerende syn – et system af et par dusiner separate komponenter, der ikke er beskrevet med Dockerfiles. At konfigurere det til deployment i et bestemt miljø kan kun gøres samlet. Vores opgave er at deploye clustret i staging-miljøet for at teste det før pre-release test.
Teoretisk set kan der være flere kørende clustre: så mange som der er opgaver i afsluttet eller næsten afsluttet tilstand. Kapaciteten på de servere, vi har til rådighed, tillader opstart af flere clustre på hver server. Hver staging-cluster skal være isoleret (der må ikke være overlap i porte, mapper osv.).
Den mest værdifulde ressource er vores tid, og vi havde ikke meget af den.
For at få en hurtigere start valgte vi Docker Swarm på grund af dets enkelhed og fleksible arkitektur. Det første, vi gjorde, var at oprette en manager og flere noder på de fjernservere:
$ docker node ls
ID                            HOSTNAME            STATUS              AVAILABILITY        MANAGER STATUS      ENGINE VERSION
kilqc94pi2upzvabttikrfr5d     nop-test-1     Klar               Aktiv                                  19.03.2
jilwe56pl2zvabupryuosdj78     nop-test-2     Klar               Aktiv                                  19.03.2
j5a4yz1kr2xke6b1ohoqlnbq5 *   nop-test-3     Klar               Aktiv              Leder              19.03.2
Herefter oprettede vi et netværk:
$ docker network create --driver overlay --subnet 10.10.10.0/24 nw_swarm
Herefter forbinde vi Gitlab-CI og Swarm noderne med hensyn til fjernstyring af noder fra CI: installation af certifikater, opsætning af hemmelige variabler samt konfiguration af Docker-tjenesten på administratorserveren. Dette sparede os betydelig tid.
Herefter tilføjede vi job til oprettelse og sletning af stakken i .gitlab-ci.yml.
Der er tilføjet flere job i .gitlab-ci.yml
## staging stage
deploy_staging:
  stage: testing
  before_script:
    - echo "override global 'before_script'"
  image: "REGISTRY:5000/docker:latest"
  environment: staging
  dependencies: []
  variables:
    DOCKER_CERT_PATH: "/certs"
    DOCKER_HOST: tcp://10.50.173.107:2376
    DOCKER_TLS_VERIFY: 1
    CI_BIN_DEPENDENCIES_JOB: "release.centos.7"
  script:
    - mkdir -p $DOCKER_CERT_PATH
    - echo "$TLSCACERT" > $DOCKER_CERT_PATH/ca.pem
    - echo "$TLSCERT" > $DOCKER_CERT_PATH/cert.pem
    - echo "$TLSKEY" > $DOCKER_CERT_PATH/key.pem
    - docker stack deploy -c docker-compose.yml ${CI_ENVIRONMENT_NAME}_${CI_COMMIT_REF_NAME} --with-registry-auth
    - rm -rf $DOCKER_CERT_PATH
  when: manual

## stop staging stage
stop_staging:
  stage: testing
  before_script:
    - echo "override global 'before_script'"
  image: "REGISTRY:5000/docker:latest"
  environment: staging
  dependencies: []
  variables:
    DOCKER_CERT_PATH: "/certs"
    DOCKER_HOST: tcp://10.50.173.107:2376
    DOCKER_TLS_VERIFY: 1
  script:
    - mkdir -p $DOCKER_CERT_PATH
    - echo "$TLSCACERT" > $DOCKER_CERT_PATH/ca.pem
    - echo "$TLSCERT" > $DOCKER_CERT_PATH/cert.pem
    - echo "$TLSKEY" > $DOCKER_CERT_PATH/key.pem
    - docker stack rm ${CI_ENVIRONMENT_NAME}_${CI_COMMIT_REF_NAME}
    # TODO: need check that stopped
  when: manual
Fra det ovenstående kodeudsnit kan vi se, at der er tilføjet to knapper (deploy_staging, stop_staging) i Pipelines, som kræver manuel interaktion.
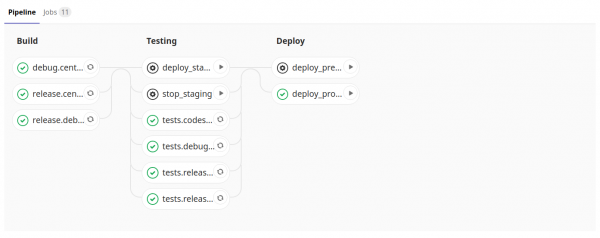
Stakens navn svarer til navnene på grenen, og denne unikke identitet bør være tilstrækkelig. Tjenester i stakken får unikke IP-adresser, og porte, mapper osv. vil være isolerede, men ens fra stak til stak (da konfigurationsfilen er identisk for alle stakke) — dette var vores mål. Stak (klynge) ruller vi ud med hjælp af docker-compose.yml, der beskriver vores klynge.
docker-compose.yml
---
version: '3'

services:
  userprop:
    image: redis:alpine
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:
  celery_bcd:
    image: redis:alpine
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:

  schedulerdb:
    image: mariadb:latest
    environment:
      MYSQL_ALLOW_EMPTY_PASSWORD: 'yes'
      MYSQL_DATABASE: schedulerdb
      MYSQL_USER: ****
      MYSQL_PASSWORD: ****
    command: ['--character-set-server=utf8mb4', '--collation-server=utf8mb4_unicode_ci', '--explicit_defaults_for_timestamp=1']
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:

  celerydb:
    image: mariadb:latest
    environment:
      MYSQL_ALLOW_EMPTY_PASSWORD: 'yes'
      MYSQL_DATABASE: celerydb
      MYSQL_USER: ****
      MYSQL_PASSWORD: ****
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:

  cluster:
    image: $CENTOS7
    environment:
      - CENTOS
      - CI_ENVIRONMENT_NAME
      - CI_API_V4_URL
      - CI_REPOSITORY_URL
      - CI_PROJECT_ID
      - CI_PROJECT_URL
      - CI_PROJECT_PATH
      - CI_PROJECT_NAME
      - CI_COMMIT_REF_NAME
      - CI_BIN_DEPENDENCIES_JOB
    command: >
      sudo -u myusername -H /bin/bash -c ". /etc/profile &&
        mkdir -p /storage1/$CI_COMMIT_REF_NAME/$CI_PROJECT_NAME &&
        cd /storage1/$CI_COMMIT_REF_NAME/$CI_PROJECT_NAME &&
            git clone -b $CI_COMMIT_REF_NAME $CI_REPOSITORY_URL . &&
            curl $CI_API_V4_URL/projects/$CI_PROJECT_ID/jobs/artifacts/$CI_COMMIT_REF_NAME/download?job=$CI_BIN_DEPENDENCIES_JOB -o artifacts.zip &&
            unzip artifacts.zip ;
        cd /storage1/$CI_COMMIT_REF_NAME/$CI_PROJECT_NAME/scripts/deploy/ &&
            python3 createconfig.py -s $CI_ENVIRONMENT_NAME &&
            /bin/bash install_venv.sh -d -r ../../requirements.txt &&
            python3 prepare_init.d.py &&
            python3 deploy.py -s $CI_ENVIRONMENT_NAME"
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    tty: true
    stdin_open: true
    networks:
      nw_swarm:

networks:
  nw_swarm:
    external: true
Her kan man se, at komponenterne er forbundet via et netværk (nw_swarm) og kan tilgå hinanden.
Systemkomponenter (baseret på redis, mysql) er adskilt fra det almindelige pool af brugerdefinerede komponenter (planer om også at segmentere brugerdefinerede som tjenester). Deploy-stadiet af vores klynge ser ud som overførsel af CMD til vores store konfigurerede image og adskiller sig næsten ikke fra den deploy, der er beskrevet i Del I. Jeg vil understrege forskellene:
- git clone … — vi henter de nødvendige filer for at gennemføre deploy (createconfig.py, install_venv.sh osv.)
- curl… && unzip … — vi downloader og udpakker byggearteen (de kompilerede værktøjer)
Der er kun ét problem tilbage, som endnu ikke er beskrevet: komponenter, der har et webinterface, er ikke tilgængelige fra udviklernes browsere. Vi løser dette problem ved hjælp af en reverse proxy, således:
I .gitlab-ci.yml, efter deployment af klyngens stack, tilføjer vi en linje til deployment af load-balancer (som kun opdaterer sin konfiguration ved commits (skaber nye konfigurationsfiler for nginx efter skabelonen: /etc/nginx/conf.d/${CI_COMMIT_REF_NAME}.conf) — se koden docker-compose-nginx.yml)
- docker stack deploy -c docker-compose-nginx.yml ${CI_ENVIRONMENT_NAME} --with-registry-auth
docker-compose-nginx.yml
---
version: '3'

services:
  nginx:
    image: nginx:latest
    environment:
      CI_COMMIT_REF_NAME: ${CI_COMMIT_REF_NAME}
      NGINX_CONFIG: |-
            server {
                listen 8080;
                server_name staging_${CI_COMMIT_REF_NAME}_cluster.dev;

                location / {
                    proxy_pass http://staging_${CI_COMMIT_REF_NAME}_cluster:8080;
                }
            }
            server {
                listen 5555;
                server_name staging_${CI_COMMIT_REF_NAME}_cluster.dev;

                location / {
                    proxy_pass http://staging_${CI_COMMIT_REF_NAME}_cluster:5555;
                }
            }
    volumes:
      - /tmp/staging/nginx:/etc/nginx/conf.d
    command:
      /bin/bash -c "echo -e "$$NGINX_CONFIG" > /etc/nginx/conf.d/${CI_COMMIT_REF_NAME}.conf;
        nginx -g "daemon off;";
        /etc/init.d/nginx reload"
    ports:
      - 8080:8080
      - 5555:5555
      - 3000:3000
      - 443:443
      - 80:80
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:

networks:
  nw_swarm:
    external: true
På udviklernes computere opdaterer vi /etc/hosts; vi skriver URL'en til nginx:
10.50.173.106 staging_BRANCH-1831_cluster.dev
Så deployment af isolerede staging-klynger er implementeret, og udviklerne kan nu starte dem i det antal, der er tilstrækkeligt til at teste deres opgaver.
Fremtidige planer:
- At opdele vores komponenter som tjenester
- At oprette en Dockerfile for hver
- At automatisk identificere mindre belastede noder i stacken
- At angive noder efter navneskabelon (i stedet for at bruge id som i artiklen)
- At tilføje kontrol, så stacken er destrueret
- …
En særlig tak for .
Kilde: habr.com
