

Fremtiden er kommet, teknologier inden for kunstig intelligens og maskinlæring bliver allerede med succes anvendt af dine yndlingsbutikker, transportselskaber og endda gårde, der opdrætter kalkuner.
Og hvis noget eksisterer, så er der allerede noget om det på internettet… et åbent projekt! Se hvordan Open Data Hub hjælper med at skalere nye teknologier og undgå vanskeligheder ved implementeringen.
På trods af alle fordelene ved kunstig intelligens (AI) og maskinlæring (ML) har organisationer ofte problemer med at skalere disse teknologier. De primære udfordringer er som regel følgende:
- Informationsudveksling og samarbejde – det er praktisk talt umuligt at udveksle information uden unødvendige anstrengelser og samarbejde i hurtige iterationer.
- Adgang til data – for hver opgave skal det bygges op fra bunden og manuelt, hvilket tager meget tid.
- Adgang on-demand – der er ikke mulighed for at få on-demand adgang til værktøjer og platforme for maskinlæring samt til beregningsinfrastrukturen.
- Produktion – modeller forbliver på prototype-niveau og når ikke produktionsstadiet.
- Overvågning og forklaring af AI's resultater – reproducerbarhed, overvågning og forklaring af resultaterne fra AI/ML er vanskelige.
Hvis disse problemer ikke løses, påvirker det negativt hastigheden, effektiviteten og produktiviteten hos værdifulde databehandlere og analytikere. Dette fører til frustration, arbejdsmæssig skuffelse, og i sidste ende går forventningerne fra virksomheden til AI/ML i glemmebogen.
Ansvarligheden for at løse disse problemer påhviler IT-specialister, der skal levere en slags sky til dataanalytikere. Mere detaljeret er der brug for en platform, der giver frihed til valg og har nem, enkel adgang. Samtidig skal den være hurtig, nemt omkonfigurerbar, skalerbar efter behov og modstandsdygtig over for nedbrud. At bygge en sådan platform baseret på open source-teknologier hjælper med at undgå afhængighed af leverandører og opretholde en langsigtet strategisk fordel med hensyn til omkostningskontrol.
For flere år siden skete noget lignende i udviklingen af applikationer, hvilket førte til fremkomsten af mikrotjenester, hybride cloud-miljøer, IT-automatisering og agile processer. For at håndtere dette begyndte IT-specialister at bruge containere, Kubernetes og åbne hybride cloud-løsninger.
Nu anvendes den erfaring til at imødekomme udfordringerne fra AI. Derfor skaber IT-specialister platforme, der er baseret på containere, muliggør opbygning af AI/ML-tjenester inden for agile processer, fremskynder innovation og er designet med fokus på hybrid cloud.
Vi vil starte opbygningen af en sådan platform med Red Hat OpenShift, vores Kubernetes-containerplatform til hybrid cloud, som har et hurtigt voksende økosystem af software- og hardware-ML-løsninger (NVIDIA, H2O.ai, Starburst, PerceptiLabs osv.). Nogle af Red Hats kunder, såsom BMW Group, ExxonMobil og andre, har allerede implementeret containeriserede ML-værktøjs-kæder og DevOps-processer baseret på denne platform og dens økosystem for at bringe deres ML-arkitekturer til industrielt driftsniveau og fremskynde arbejdet for dataanalytikere.
Endnu en grund til, at vi lancerede Open Data Hub Projektet er at demonstrere et eksempel på en arkitektur baseret på flere open source-projekter og vise, hvordan man implementerer hele livscyklussen for en ML-løsning baseret på OpenShift-platformen.
Open Data Hub Projektet
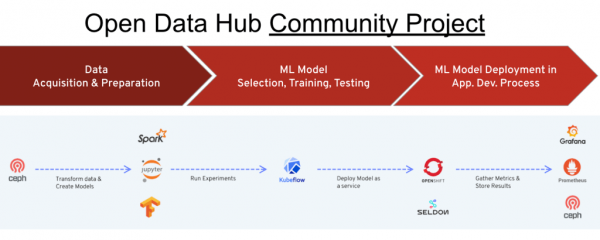
Dette er et open source-projekt, der udvikles inden for det relevante udviklingsfællesskab og implementerer hele cyklussen af operationer – fra indlæsning og transformation af rådata til modellens opbygning, træning og vedligeholdelse – når man løser AI/ML-opgaver ved hjælp af containere og Kubernetes på OpenShift-platformen. Dette projekt kan betragtes som en referenceimplementering, et eksempel på, hvordan man bygger en åben løsning af typen 'AI/ML som en service' baseret på OpenShift og relevante open source-værktøjer som Tensorflow, JupyterHub, Spark og andre. Det er vigtigt at bemærke, at Red Hat selv bruger dette projekt til at levere sine AI/ML-tjenester. Desuden integreres OpenShift med nøglesoftware- og hardware-ML-løsninger fra NVIDIA, Seldon, Starburst og andre leverandører, hvilket gør det lettere at bygge og implementere egne systemer til maskinlæring.
Open Data Hub Projektet er rettet mod følgende brugergrupper og anvendelsesscenarier:
- Dataanalytiker, der har brug for en skybaseret løsning til implementering af ML-projekter med selvbetjeningsfunktioner.
- Dataanalytiker, der har brug for det største udvalg af de nyeste AI/ML-værktøjer og platforme med open source.
- Dataanalytiker, der har brug for adgang til datakilder ved træning af modeller.
- Dataanalytiker, der har brug for adgang til compute-ressourcer (CPU, GPU, hukommelse).
- Dataanalytiker, der har brug for mulighed for at samarbejde og dele resultater med kolleger, få feedback og implementere forbedringer gennem hurtige iterationer.
- Dataanalytiker, der ønsker at interagere med udviklere (og devops-teams), så hans ML-modeller og resultater kan implementeres i produktion.
- Dataingeniør, der skal give dataanalytikere adgang til forskellige datakilder, mens de overholder sikkerhedsstandarder og krav.
- Administrator/operatør af IT-systemer, der har brug for at kunne overvåge livscyklussen (installation, konfiguration, opdatering) af open source-komponenter og -teknologier uden besvær. Derudover er der behov for de relevante administrations- og kvoteringsværktøjer.
Open Data Hub-projektet samler en række open source-værktøjer til at realisere hele cyklussen af AI/ML-operationer. Jupyter Notebook bruges som det primære arbejdsredskab for dataanalytikeren. Dette værktøj er i dag meget populært blandt specialister i datahåndtering og -analyse, og Open Data Hub giver dem mulighed for nemt at oprette og administrere arbejdsområder for Jupyter Notebook ved hjælp af den indbyggede JupyterHub. Udover at oprette og importere Jupyter-notebooks indeholder Open Data Hub-projektet også en række allerede klarlagte notebooks i form af et AI-bibliotek.
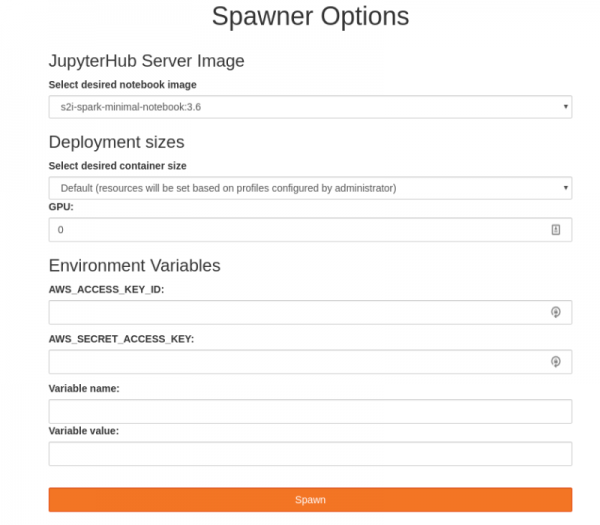
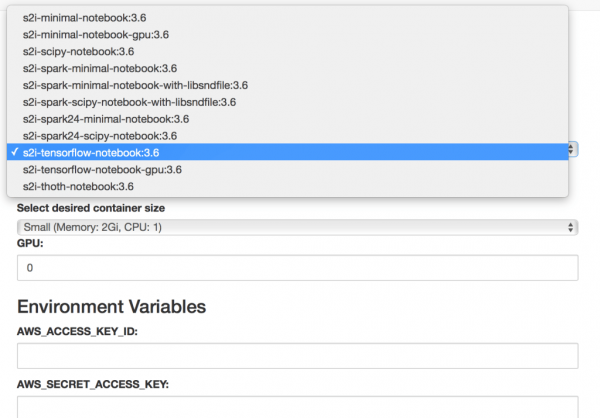
Dette bibliotek er en samling af open-source maskinlæringskomponenter og løsninger til typiske scenarier, der forenkler hurtig prototyping. JupyterHub er integreret med OpenShifts RBAC-adgangsmodel, hvilket giver mulighed for at bruge eksisterende OpenShift-konti og implementere single sign-on. Derudover tilbyder JupyterHub et brugervenligt interface kaldet spawner, som gør det nemt for brugeren at justere mængden af regnekraft (CPU-kerner, hukommelse, GPU) til den valgte Jupyter Notebook.
Når dataanalytikeren har oprettet og konfigureret sin notebook, tager Kubernetes-scheduler, som er en del af OpenShift, sig af alle de øvrige opgaver. Brugerne kan nu udføre deres eksperimenter, gemme og dele resultaterne af deres arbejde. Desuden kan avancerede brugere henvende sig direkte til OpenShift CLI-skal fra Jupyter-notebooks for at bruge Kubernetes-primitiver som Job eller OpenShift-funktionalitet som Tekton eller Knative. Alternativt kan man bruge den brugervenlige OpenShift GUI kaldet "OpenShift-webkonsol".
Når vi går videre til næste fase, gør Open Data Hub det muligt at styre datapipelines. Dette gøres ved hjælp af Ceph-objekter, som tilbydes som S3-kompatibel objektlager. Apache Spark sørger for streaming af data fra eksterne kilder eller det indbyggede Ceph S3-lager, og muliggør også forbehandling af data. Apache Kafka tilbyder avanceret styring af datapipelines (hvor der kan udføres flere indlæsninger samt transformations-, analyse- og lagringsoperationer).
Så dataanalytikeren har fået adgang til data og bygget en model. Nu ønsker han at dele de opnåede resultater med kollegerne eller app-udviklerne og give dem sin model som en tjeneste. For dette kræves en output-server, og Open Data Hub har en sådan server, kaldet Seldon, som muliggør offentliggørelse af modellen som en RESTful-tjeneste.
På et tidspunkt bliver der oprettet flere af sådanne modeller på Seldon-serveren, og der opstår et behov for at overvåge, hvordan de anvendes. For dette tilbyder Open Data Hub en samling relevante metrikker og en rapporteringsmotor baseret på de udbredte overvågningsværktøjer Prometheus og Grafana. Resultatet er, at vi får feedback til at overvåge brugen af AI-modeller, især i produktionsmiljøer.
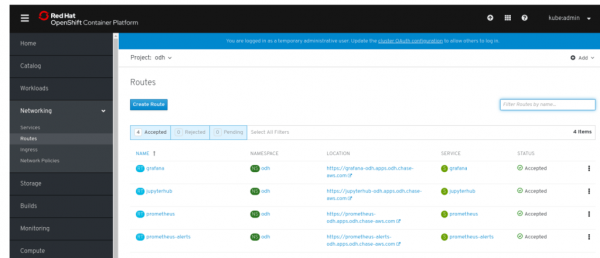
Dermed sikrer Open Data Hub en sky-lignende tilgang gennem hele livscyklussen for AI/ML-operationer, fra adgang til og forberedelse af data til træning og industriel implementering af modellen.
Vi samler det hele
Nu opstår spørgsmålet om, hvordan alt dette organiseres af OpenShift-administratoren. Her kommer en specialiseret Kubernetes-operator til projekter i Open Data Hub ind i billedet.
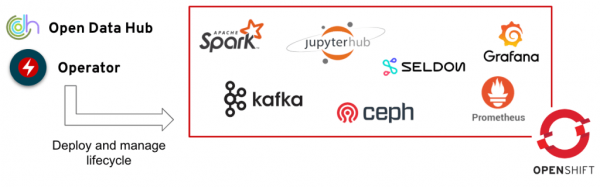
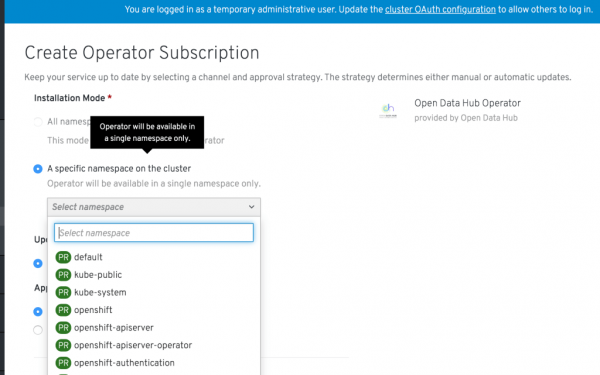
Denne operator styrer installationen, konfigurationen og livscyklussen for Open Data Hub-projektet, herunder implementeringen af de nævnte værktøjer som JupyterHub, Ceph, Spark, Kafka, Seldon, Prometheus og Grafana. Open Data Hub-projektet kan findes i OpenShift's webkonsol under community-operatører. På denne måde kan OpenShift-administratoren angive, at de relevante OpenShift-projekter hører til kategorien 'Open Data Hub-projekt'. Dette gøres én gang. Herefter logger dataanalytikeren ind i sit projektområde via OpenShift's webkonsol og kan se, at den relevante Kubernetes-operator er installeret og tilgængelig for hans projekter. Derefter opretter han et eksempel på Open Data Hub-projektet med et enkelt klik og får straks adgang til de ovenfor beskrevne værktøjer. Og alt dette kan konfigureres i høj tilgængelighed og fejltolerance.
Hvis du selv vil prøve Open Data Hub-projektet, skal du begynde med . Tekniske detaljer om Open Data Hubs arkitektur kan findes , projektudviklingsplanerne – . I fremtiden planlægges der yderligere integration med Kubeflow, løsning af en række spørgsmål vedrørende datastyring og sikkerhed, samt organisering af integration med regelsystemer som Drools og Optaplanner. Du kan ytre din mening og blive en del af projektet på siden .
Sammenfattende: Alvorlige skaleringsproblemer forhindrer organisationer i at udnytte potentialet af kunstig intelligens og maskinlæring fuldt ud. Red Hat OpenShift har længe været anvendt med succes til at løse lignende udfordringer i softwarebranchen. Open Data Hub-projektet, implementeret inden for open source udviklingssamfundet, tilbyder en referencearkitektur til organisering af hele AI/ML-operationer baseret på hybrid cloud OpenShift. Vi har en klar og gennemtænkt udviklingsplan for dette projekt, og vi er fast besluttede på at skabe et aktivt og frugtbart udviklingssamfund for åbne AI-løsninger på OpenShift-platformen.
Kilde: habr.com
